
R入門
最終更新日:2026-11-07 | ページの編集
概要
質問
- Rでの最初のコマンド
目的
- Rに関連する以下の用語を定義してください。オブジェクト、代入、呼び出し、関数、引数、オプション。
- Rでオブジェクトに値を代入します。
- オブジェクトの命名方法を学びましょう。
- コメントを用いてスクリプトに説明を添えてください。
- Rで簡単な算術演算を行います。
- 関数を呼び出し、引数を用いてデフォルトオプションを変更します。
- ベクトルの内容を確認し、その内容を操作します。
- ベクトルから部分集合を抽出し、値を取得します。
- 欠損値を含むベクトルを解析します。
このエピソードは、Data Carpentriesの「生態学者のためのRによるデータ分析と可視化」レッスンに基づいています。
Rでのオブジェクトの作成
コンソールに数式を入力するだけで、Rから出力を得ることができます。
R
3 + 5
出力
[1] 8R
12 / 7
出力
[1] 1.714286しかし、有用で興味深いことを行うには、オブジェクトに値を代入する必要があります。オブジェクトを作成するには、名前に続けて代入演算子
<- と、代入したい値を指定します:
R
weight_kg <- 55
<-
は代入演算子です。右側の値を左側のオブジェクトに代入します。したがって、x <- 3
を実行した後、x の値は 3
となります。この矢印は、3 が x
に入る
と読み解くことができます。歴史的な経緯から、代入に =
を使用することもできますが、あらゆる文脈で使用できるわけではありません。構文にわずかな違いがあるため、代入には常に
<- を使用するのが望ましい慣行です。
RStudioでは、Alt +
-(-キーと同時にAltを押す)と入力すると、PCでは1回のキー操作で<-が入力されます。一方、MacではOption
+
-(-キーと同時にOptionを押す)と入力することで同様の操作が可能です。
変数の命名
オブジェクトには、x、current_temperature、subject_id
などの任意の名前を付けられます。オブジェクト名は明示的で、長すぎないようにしてください。数字で始めることはできません(2x
は無効ですが、x2
は有効です)。Rは大文字と小文字を区別します(例:weight_kg
は Weight_kg
とは異なります)。Rの基本関数の名前であるため、使用できない名前もあります(例:if、else、for。完全なリストについては
Rの予約語
のマニュアルページを参照してください)。一般的に、許可されていても、他の関数名(例:c、T、mean、data、df、weights)は使用しないのが最善です。判断に迷う場合は、ヘルプを確認してその名前が既に使用されていないか調べてください。また、my.dataset
のようにオブジェクト名の中にドット(.)を含めることも避けるのが最善です。歴史的な理由から、Rには名前にドットを含む関数が多く存在しますが、ドットはR(メソッド用)や他のプログラミング言語において特別な意味を持つため、避けるのが最善です。また、オブジェクト名には名詞を、関数名には動詞を使用することが推奨されます。コードのスタイル(スペースの配置やオブジェクトの命名方法など)を一貫させることが重要です。一貫したコーディングスタイルを採用することで、将来の自分や共同作業者にとってコードがより読みやすくなります。Rでは、Google
のスタイルガイド、tidyverse
のスタイル、および Bioconductor
スタイルガイド などが一般的です。tidyverse
のガイドは非常に包括的で、最初は圧倒されるかもしれません。lintr
パッケージをインストールすれば、コードのスタイルに関する問題を自動的にチェックできます。
オブジェクトと変数:
Rでobjectsと呼ばれるものは、他の多くのプログラミング言語ではvariablesと呼ばれます。文脈によっては、objectとvariableは大きく異なる意味を持つことがあります。ただし、本レッスンでは、これら2つの用語は同義語として使用されます。詳細については、こちらをご覧ください。
オブジェクトに値を代入する際、Rは何も出力しません。括弧を使うか、オブジェクト名を入力することで、Rに値を強制的に出力させることができます。
R
weight_kg <- 55    # doesn't print anything
(weight_kg <- 55)  # but putting parenthesis around the call prints the value of `weight_kg`
出力
[1] 55R
weight_kg # and so does typing the name of the object
出力
[1] 55Rのメモリにweight_kgが格納されたので、これを使って計算を行うことができます。例えば、この重量をポンドに変換したい場合が考えられます(ポンドでの重量はkgでの重量の2.2倍です):
R
2.2 * weight_kg
出力
[1] 121また、オブジェクトに新しい値を代入することで、その値を変更することもできます。
R
weight_kg <- 57.5
2.2 * weight_kg
出力
[1] 126.5つまり、あるオブジェクトに値を代入しても、他のオブジェクトの値は変わりません。例えば、動物の体重(ポンド)を新しいオブジェクト
weight_lb に格納してみましょう。
R
weight_lb <- 2.2 * weight_kg
次に、weight_kgを100に変更してください。
R
weight_kg <- 100
課題:
オブジェクト weight_lb
の現在の内容は、何だと思いますか? 126.5 でしょうか、それとも 220
でしょうか?
コメント
Rにおけるコメント記号は#です。スクリプト内で#より右側にある記述は、Rによって無視されます。スクリプトにメモや説明を残しておくと便利です。
RStudioでは、段落のコメントアウトやコメント解除を簡単に行えます。コメントアウトしたい行を選択した後、キーボードの Ctrl + Shift + C を同時に押してください。1行だけをコメントアウトしたい場合は、その行の任意の位置にカーソルを置き(つまり、行全体を選択する必要はありません)、Ctrl + Shift + C を押してください。
課題
以下において、各文の後の値は何になりますか?
R
mass <- 47.5            # mass?
age  <- 122             # age?
mass <- mass * 2.0      # mass?
age  <- age - 20        # age?
mass_index <- mass/age  # mass_index?
関数とその引数
関数とは、代入操作などを含むより複雑な一連のコマンドを自動化する「定型スクリプト」のことです。多くの関数はあらかじめ定義されているか、あるいはRのパッケージをインポートすることで利用可能になります(これについては後述します)。関数は通常、引数と呼ばれる1つ以上の入力を受け取ります。関数は多くの場合(必ずしもそうとは限りませんが)、値を返します。典型的な例は関数
sqrt()
です。入力(引数)は数値である必要があり、戻り値(実質的には出力)はその数値の平方根となります。関数を実行すること(「動かす」こと)を、関数を呼び出すと言います。関数呼び出しの例は以下の通りです:
R
b <- sqrt(a)
ここでは、aの値がsqrt()関数に渡され、sqrt()関数が平方根を計算してその値を返し、それがオブジェクトbに代入されます。この関数は引数を1つしか取らないため、非常にシンプルです。
関数の戻り値「value」は、必ずしも数値(sqrt()のように)である必要はありません。また、単一の要素である必要もなく、複数の要素の集合や、データセットであることも可能です。これについては、データファイルをRに読み込む際に見ていきましょう。
引数には、数値やファイル名だけでなく、その他のオブジェクトも含め、あらゆるものを指定できます。各引数が具体的に何を意味するかは関数によって異なり、ドキュメント(以下参照)で確認する必要があります。一部の関数では、ユーザーが指定できる引数のほか、指定しなかった場合にデフォルト値が適用される引数があります。これらは「オプション」と呼ばれます。オプションは通常、「不正な値」を無視するかどうかや、プロットで使用する記号など、関数の動作を変更するために用いられます。ただし、特定の値を指定したい場合は、デフォルト値の代わりに任意の値を指定することができます。
複数の引数を受け取れる関数を試してみましょう。round()。
R
round(3.14159)
出力
[1] 3ここでは、round()を引数3.14159のみで呼び出しており、3という値が返されました。これは、デフォルトで最近接の整数に丸められるためです。より多くの桁数が必要な場合は、round関数に関する情報を取得することでその方法を確認できます。args(round)を使用するか、?roundを使ってこの関数のヘルプを参照することができます。
R
args(round)
出力
function (x, digits = 0, ...)
NULL
R
?round
桁数を変更したい場合は、digits=2
や任意の桁数を入力すればよいことがわかります。
R
round(3.14159, digits = 2)
出力
[1] 3.14引数を定義時と全く同じ順序で指定すれば、名前を付ける必要はありません。
R
round(3.14159, 2)
出力
[1] 3.14また、引数に名前を付けておけば、その順序を入れ替えることもできます。
R
round(digits = 2, x = 3.14159)
出力
[1] 3.14関数呼び出しの際には、必須の引数(丸め処理を行う数値など)を最初に配置し、すべてのオプション引数の名前を指定するのが良い習慣です。そうしないと、コードを読む人が、馴染みのない引数を持つ関数の定義を調べて、何を行っているのかを理解しなければならない場合があります。また、引数の名前を指定することで、将来的に関数インターフェースに変更が加えられ、既存の引数の間に新しい引数が追加される可能性に対する備えにもなります。
ベクトルとデータ型
ベクトルはRで最も一般的かつ基本的なデータ型であり、実質的にRの主力となるデータ型です。ベクトルは、数値や文字などの一連の値で構成されます。c()関数を使用して、一連の値をベクトルに代入できます。例えば、動物の体重のベクトルを作成し、それを新しいオブジェクトweight_gに代入することができます:
R
weight_g <- c(50, 60, 65, 82)
weight_g
出力
[1] 50 60 65 82ベクトルには文字を含めることもできます。
R
molecules <- c("dna", "rna", "protein")
molecules
出力
[1] "dna" "rna" "protein"ここでは「dna」や「rna」などの引用符が不可欠です。引用符がないと、Rはdna、rna、proteinというオブジェクトが存在すると判断します。これらのオブジェクトはRのメモリ上に存在しないため、エラーメッセージが表示されます。
ベクトルの内容を確認できる関数が数多く用意されています。length()
を使うと、特定のベクトルにいくつの要素が含まれているかが分かります。
R
length(weight_g)
出力
[1] 4R
length(molecules)
出力
[1] 3ベクトルの重要な特徴は、すべての要素が同じデータ型であることです。関数
class()
は、オブジェクトのクラス(要素の型)を示します。
R
class(weight_g)
出力
[1] "numeric"R
class(molecules)
出力
[1] "character"str()関数は、オブジェクトの構造とその要素の概要を提供します。大規模で複雑なオブジェクトを扱う際に有用な関数です。
R
str(weight_g)
出力
num [1:4] 50 60 65 82R
str(molecules)
出力
chr [1:3] "dna" "rna" "protein"c()関数を使えば、ベクトルに他の要素を追加できます。
R
weight_g <- c(weight_g, 90) # add to the end of the vector
weight_g <- c(30, weight_g) # add to the beginning of the vector
weight_g
出力
[1] 30 50 60 65 82 901行目では、元のベクトル weight_g の末尾に値
90 を追加し、その結果を weight_g
に保存します。次に、先頭に値 30 を追加し、同様にその結果を
weight_g に保存します。
これを繰り返すことで、ベクトルを拡張したり、データセットを構築したりできます。プログラミングを進める中で、収集や計算を行っている結果を追加する際にも役立つでしょう。
アトミックベクトルはRで最も単純なデータ型であり、単一の型からなる線形ベクトルです。上記では、Rが使用する主要な6種類のアトミックベクトル型のうち、"character"と"numeric"(または"double")の2つを確認しました。これらは、すべてのRオブジェクトを構成する基本的な構成要素です。その他の4種類のアトミックベクトル型は以下の通りです。
-
TRUEおよびFALSE用の"logical"(論理型データ) - 整数には
"integer"を使用します(例:2L。ここでLはRに対してそれが整数であることを示します)。 -
"complex"は実部と虚部を持つ複素数(例:1 + 4i)を表します。これらについては以上です。 -
"raw"以降では触れないビットストリーム用
typeof()関数にベクトルを引数として渡すことで、その型を確認できます。
ベクトルは、Rが使用する数多くのデータ構造のひとつです。その他の重要なものには、リスト
(list)、行列 (matrix)、データフレーム
(data.frame)、因子 (factor)、配列
(array) があります。
課題:
アトミックベクトルには、文字型、数値型(またはdouble型)、整数型、論理型があることを確認しました。では、これらの異なる型を一つのベクトルに混在させようとすると、どうなるでしょうか。
Rはこれらを暗黙的にすべて同じ型に変換します。
課題:
それぞれの例で何が起こるでしょうか?(ヒント:class()
を使ってオブジェクトのデータ型を確認し、その名前を入力して何が起こるか確かめてみてください):
R
num_char <- c(1, 2, 3, "a")
num_logical <- c(1, 2, 3, TRUE, FALSE)
char_logical <- c("a", "b", "c", TRUE)
tricky <- c(1, 2, 3, "4")
R
class(num_char)
出力
[1] "character"R
num_char
出力
[1] "1" "2" "3" "a"R
class(num_logical)
出力
[1] "numeric"R
num_logical
出力
[1] 1 2 3 1 0R
class(char_logical)
出力
[1] "character"R
char_logical
出力
[1] "a" "b" "c" "TRUE"R
class(tricky)
出力
[1] "character"R
tricky
出力
[1] "1" "2" "3" "4"課題:
なぜそうなると思いますか?
ベクトルは単一のデータ型しか持つことができません。Rは、このベクトルの内容を変換(coerce)し、情報を一切損なわない共通の型を見つけ出そうとします。
課題:
次の例において、combined_logical
に含まれる値のうち、"TRUE"(文字列として)となるものはいくつありますか?
R
num_logical <- c(1, 2, 3, TRUE)
char_logical <- c("a", "b", "c", TRUE)
combined_logical <- c(num_logical, char_logical)
1つだけです。過去のデータ型の記憶はなく、型変換はベクトルが最初に評価される際に行われます。したがって、num_logical
内の TRUE は、combined_logical で
"1" に変換される前に、まず 1
に変換されます。
R
combined_logical
出力
[1] "1" "2" "3" "1" "a" "b" "c" "TRUE"課題:
Rでは、あるクラスのオブジェクトを別のクラスに変換することを「強制変換」と呼びます。これらの変換は階層構造に基づいて行われ、一部の型は他の型へ優先的に強制変換されます。これらのデータ型がどのように強制変換されるか、その階層構造を示す図を描いていただけますか?
論理型 → 数値型 → 文字列型 ← 論理型
ベクトルの部分抽出
ベクトルから1つまたは複数の値を抽出したい場合は、角括弧で1つまたは複数のインデックスを指定する必要があります。例えば:
R
molecules <- c("dna", "rna", "peptide", "protein")
molecules[2]
出力
[1] "rna"R
molecules[c(3, 2)]
出力
[1] "peptide" "rna" また、インデックスを繰り返すことで、元のオブジェクトよりも要素数の多いオブジェクトを作成することもできます。
R
more_molecules <- molecules[c(1, 2, 3, 2, 1, 4)]
more_molecules
出力
[1] "dna" "rna" "peptide" "rna" "dna" "protein"Rのインデックスは1から始まります。Fortran、MATLAB、Julia、Rなどのプログラミング言語が1から数えるのは、それが人間にとって一般的だからです。C系言語(C++、Java、Perl、Pythonを含む)が0から数えるのは、コンピュータにとってその方が処理が簡単だからです。
最後に、負のインデックスを用いることで、ベクトルの指定した要素を除くすべての要素を取得することも可能です。
R
molecules ## all molecules
出力
[1] "dna" "rna" "peptide" "protein"R
molecules[-1] ## all but the first one
出力
[1] "rna" "peptide" "protein"R
molecules[-c(1, 3)] ## all but 1st/3rd ones
出力
[1] "rna" "protein"R
molecules[c(-1, -3)] ## all but 1st/3rd ones
出力
[1] "rna" "protein"条件付きサブセット抽出
サブセットを抽出するもう一つの一般的な方法は、論理ベクトルを使用することです。TRUEは同じインデックスを持つ要素を選択しますが、FALSEは選択しません。
R
weight_g <- c(21, 34, 39, 54, 55)
weight_g[c(TRUE, FALSE, TRUE, TRUE, FALSE)]
出力
[1] 21 39 54通常、これらの論理ベクトルは手動で入力されるものではなく、他の関数や論理判定の結果として得られるものです。例えば、50を超える値のみを選択したい場合は、次のようにします。
R
## will return logicals with TRUE for the indices that meet
## the condition
weight_g > 50
出力
[1] FALSE FALSE FALSE TRUE TRUER
## so we can use this to select only the values above 50
weight_g[weight_g > 50]
出力
[1] 54 55&(両方の条件が真、AND)または|(少なくとも一方の条件が真、OR)を使用して、複数のテストを組み合わせることができます。
R
weight_g[weight_g < 30 | weight_g > 50]
出力
[1] 21 54 55R
weight_g[weight_g >= 30 & weight_g == 21]
出力
numeric(0)ここで、<は「未満」、>は「より大きい」、>=は「以上」、==は「等しい」を表します。二重等号==は左辺と右辺の数値的な等価性を判定するもので、変数への代入を行う単一の=記号(<-と同様)と混同しないようご注意ください。
ベクトル内で特定の文字列を検索することは、よくある作業です。複数の値との等価性を判定するには「or」演算子
| を使用できますが、すぐに煩雑になります。関数
%in%
を使用すると、検索ベクトルの要素のいずれかが見つかるかどうかを判定できます:
R
molecules <- c("dna", "rna", "protein", "peptide")
molecules[molecules == "rna" | molecules == "dna"] # returns both rna and dna
出力
[1] "dna" "rna"R
molecules %in% c("rna", "dna", "metabolite", "peptide", "glycerol")
出力
[1] TRUE TRUE FALSE TRUER
molecules[molecules %in% c("rna", "dna", "metabolite", "peptide", "glycerol")]
出力
[1] "dna" "rna" "peptide"課題:
なぜ "four" > "five" が TRUE
を返すのか、分かりますか?
R
"four" > "five"
出力
[1] TRUE文字列に対して > や <
を使用する場合、R はそれらのアルファベット順を比較します。ここでは
"four" が "five"
の後に来るため、前者の方が後者よりも大きいと判断されます。
名称
ベクトルの各要素に名前を付けることができます。以下のコードチャンクでは、名前が付与されていない初期のベクトルと、名前の設定方法および取得方法を示しています。
R
x <- c(1, 5, 3, 5, 10)
names(x) ## no names
出力
NULLR
names(x) <- c("A", "B", "C", "D", "E")
names(x) ## now we have names
出力
[1] "A" "B" "C" "D" "E"ベクトルに名前が付いている場合、インデックスに加えて名前で要素にアクセスすることができます。
R
x[c(1, 3)]
出力
A C
1 3
R
x[c("A", "C")]
出力
A C
1 3
欠損データ
Rはデータセットの解析を目的として設計されているため、欠損データという概念を備えています(他のプログラミング言語では一般的ではありません)。欠損データは、ベクトル内でNAとして表現されます。
数値演算を行う際、扱うデータに欠損値が含まれていると、ほとんどの関数はNAを返します。この仕様により、欠損値を扱うケースを見落とすことが難しくなります。引数na.rm = TRUEを指定することで、欠損値を無視して結果を算出できます。
R
heights <- c(2, 4, 4, NA, 6)
mean(heights)
出力
[1] NAR
max(heights)
出力
[1] NAR
mean(heights, na.rm = TRUE)
出力
[1] 4R
max(heights, na.rm = TRUE)
出力
[1] 6データに欠損値が含まれている場合は、is.na()、na.omit()、complete.cases()
の各関数に慣れておくとよいでしょう。例については以下をご覧ください。
R
## Extract those elements which are not missing values.
heights[!is.na(heights)]
出力
[1] 2 4 4 6R
## Returns the object with incomplete cases removed.
## The returned object is an atomic vector of type `"numeric"`
## (or `"double"`).
na.omit(heights)
出力
[1] 2 4 4 6
attr(,"na.action")
[1] 4
attr(,"class")
[1] "omit"
R
## Extract those elements which are complete cases.
## The returned object is an atomic vector of type `"numeric"`
## (or `"double"`).
heights[complete.cases(heights)]
出力
[1] 2 4 4 6課題:
- このインチ単位の身長のベクトルを用いて、NAを除去した新しいベクトルを作成してください。
R
heights <- c(63, 69, 60, 65, NA, 68, 61, 70, 61, 59, 64, 69, 63, 63, NA, 72, 65, 64, 70, 63, 65)
- 関数
median()を使用して、ベクトルheightsの中央値を計算してください。 - Rを使って、集合の中で67インチより背が高い人が何人いるか調べてください。
R
heights_no_na <- heights[!is.na(heights)]
## or
heights_no_na <- na.omit(heights)
R
median(heights, na.rm = TRUE)
出力
[1] 64R
heights_above_67 <- heights_no_na[heights_no_na > 67]
length(heights_above_67)
出力
[1] 6ベクトルの生成
コンストラクタ
さまざまな型のベクトルを生成するための関数がいくつか用意されています。数値型のベクトルを生成するには、出力ベクトルの長さを引数として指定するnumeric()コンストラクタを使用できます。値は0で初期化されます。
R
numeric(3)
出力
[1] 0 0 0R
numeric(10)
出力
[1] 0 0 0 0 0 0 0 0 0 0なお、長さ0の数値ベクトルを要求すると、まさにそれが得られます。
R
numeric(0)
出力
numeric(0)文字型と論理型に対しても、それぞれcharacter()およびlogical()という同様のコンストラクタが用意されています。
課題:
文字型および論理型ベクトルのデフォルト値は何ですか?
R
character(2) ## the empty character
出力
[1] "" ""R
logical(2) ## FALSE
出力
[1] FALSE FALSE要素を複製します
rep
関数を使用すると、値を指定した回数だけ繰り返すことができます。例えば、値
-1 で長さ 5
の数値ベクトルを初期化したい場合は、次のように記述できます。
R
rep(-1, 5)
出力
[1] -1 -1 -1 -1 -1同様に、収集するデータに前提条件を設けず、まずは欠損値を含むベクトルを生成する方法もよく用いられます。
R
rep(NA, 5)
出力
[1] NA NA NA NA NArepは、任意の長さのベクトル(上記では長さ1のベクトルを使用しました)および任意の型を入力として受け付けます。例えば、値1、2、3を5回繰り返したい場合は、次のように記述します。
R
rep(c(1, 2, 3), 5)
出力
[1] 1 2 3 1 2 3 1 2 3 1 2 3 1 2 3課題:
値 1、2、3 をそれぞれ 5 回繰り返しつつ、その順に 1 が 5 個、2 が 5
個、3 が 5 個得たい場合はどうすればよいでしょうか。方法は 2
通りあります。詳細は ?rep または ?sort
を参照してください。
R
rep(c(1, 2, 3), each = 5)
出力
[1] 1 1 1 1 1 2 2 2 2 2 3 3 3 3 3R
sort(rep(c(1, 2, 3), 5))
出力
[1] 1 1 1 1 1 2 2 2 2 2 3 3 3 3 3数列の生成
もう一つ非常に便利な関数に、数値列を生成するseqがあります。例えば、1から20まで2刻みで整数列を生成するには、次のように記述します。
R
seq(from = 1, to = 20, by = 2)
出力
[1] 1 3 5 7 9 11 13 15 17 19byのデフォルト値は1です。1刻みで値を順次生成する操作は頻繁に用いられるため、ショートカットが用意されています。
R
seq(1, 5, 1)
出力
[1] 1 2 3 4 5R
seq(1, 5) ## default by
出力
[1] 1 2 3 4 5R
1:5
出力
[1] 1 2 3 4 51から20までの数値を、最終的に長さ3となるように生成するには、次のようにします。
R
seq(from = 1, to = 20, length.out = 3)
出力
[1] 1.0 10.5 20.0無作為抽出と置換
最後に、有用な関数群として、ランダムデータを生成するものがあります。最初のsampleは、別のベクトルのランダムな順列を生成します。例えば、10人の学生の口頭試験のランダムな順序を決めるには、まず各学生に1から10までの番号を割り当て(例えば名前のアルファベット順に基づいて)、次に次のようにします:
R
sample(1:10)
出力
[1] 9 4 7 1 2 5 3 10 6 8追加の引数を指定しない場合、sampleはベクトルの全要素の順列を返します。特定のサイズのランダムサンプルを取得したい場合は、この値を第2引数として指定します。以下では、あらかじめ定義されたlettersベクトルに含まれるアルファベットから5文字をランダムに抽出します。
R
sample(letters, 5)
出力
[1] "s" "a" "u" "x" "j"入力ベクトルよりも大きな出力を得たい場合や、一部の要素を複数回抽出したい場合は、replace引数をTRUEに設定する必要があります:
R
sample(1:5, 10, replace = TRUE)
出力
[1] 2 1 5 5 1 1 5 5 2 2課題:
上記の関数を試してみると、サンプルが確かにランダムに抽出されており、同じ順列が二度現れることはないことに気づいたはずです。こうしたランダム抽出を再現するには、ランダムサンプルを抽出する前に、set.seed()
を用いて乱数生成のシード値を手動で設定することができます。
隣の人と一緒にこの機能を試してみましょう。まず、1:10のランダムな順列を2つ独立して作成し、結果が異なることを確認してください。
次に、例えば set.seed(123)
でシード値を設定し、ランダム抽出を再度行います。これで、同じランダム抽出結果が得られることが確認できます。
別のシード値を設定して繰り返してください。
さまざまな順列
R
sample(1:10)
出力
[1] 9 1 4 3 6 2 5 8 10 7R
sample(1:10)
出力
[1] 4 9 7 6 1 10 8 3 2 5シード値 123 での同一の順列
R
set.seed(123)
sample(1:10)
出力
[1] 3 10 2 8 6 9 1 7 5 4R
set.seed(123)
sample(1:10)
出力
[1] 3 10 2 8 6 9 1 7 5 4別のシード値
R
set.seed(1)
sample(1:10)
出力
[1] 9 4 7 1 2 5 3 10 6 8R
set.seed(1)
sample(1:10)
出力
[1] 9 4 7 1 2 5 3 10 6 8正規分布からの標本抽出
最後に見ていく関数はrnormで、正規分布から無作為標本を抽出します。平均0と100、標準偏差1と5の2つの正規分布(N(0,
1)およびN(100, 5)と表記)を以下に示します。
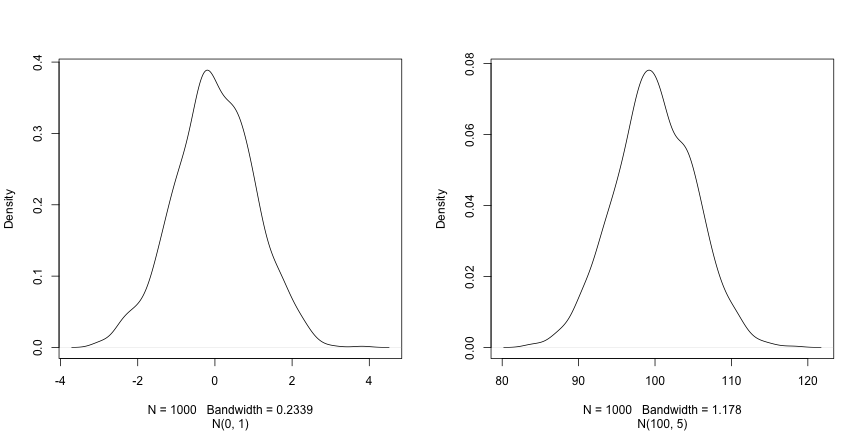
3つの引数 n、mean、sd
は、標本サイズと、正規分布のパラメータ(すなわち平均とその標準偏差)を指定します。後者のデフォルト値は
0 と 1 です。
R
rnorm(5)
出力
[1] 0.69641761 0.05351568 -1.31028350 -2.12306606 -0.20807859R
rnorm(5, 2, 2)
出力
[1] 1.3744268 -0.1164714 2.8344472 1.3690969 3.6510983R
rnorm(5, 100, 5)
出力
[1] 106.45636 96.87448 95.62427 100.71678 107.12595スクリプトの書き方とRのデータ構造の基礎を学んだところで、いよいよより大規模なデータを扱い、データフレームについて学んでいきましょう。
- Rの操作方法