
Visualisation des données
Last updated on 2026-11-07 | Edit this page
Overview
Questions
- Visualisation dans R
Objectives
- Créer des nuages de points, des boîtes à moustaches, des graphiques en courbes, etc., à l’aide de ggplot.
- Définir les paramètres globaux des graphiques.
- Décrire le facettage et l’appliquer dans ggplot.
- Modifier l’aspect visuel d’un graphique ggplot existant (y compris les libellés d’axes et la couleur).
- Créer des graphiques complexes et personnalisés à partir de données contenues dans un tableau de données.
Cet épisode est basé sur la leçon Data Analysis and Visualisation in R for Ecologists de Data Carpentries.
Visualisation des données
Nous commençons par charger les packages nécessaires.
ggplot2 est inclus dans le package
tidyverse.
R
library("tidyverse")
Si les données enregistrées lors de la leçon précédente ne sont plus présentes dans l’espace de travail, chargez-les.
R
rna <- read.csv("data/rnaseq.csv")
La fiche
pratique de visualisation de données couvrira les bases et les
fonctionnalités plus avancées de ggplot2, et permettra, en
plus de servir de rappel, d’obtenir un aperçu des nombreuses
représentations de données disponibles dans le package. Les tutoriels
vidéo suivants (partie 1 et partie 2) de
Thomas Lin Pedersen sont également très instructifs.
Graphiques avec ggplot2
ggplot2 est une bibliothèque de graphisme qui permet de
créer facilement des graphiques complexes à partir de données contenues
dans un tableau de données. Elle offre une interface plus programmatique
pour spécifier les variables à tracer, la manière dont elles sont
affichées ainsi que les propriétés visuelles générales. Le fondement
théorique qui sous-tend ggplot2 est la Grammar of
Graphics ( Wilkinson (2005) ). En
utilisant cette approche, nous n’avons besoin que de modifications
minimales si les données sous-jacentes changent ou si nous décidons de
passer d’un graphique en barres à un graphique à dispersion. Cela permet
de créer des graphiques de qualité publication avec un minimum
d’ajustements et de peaufinage.
Il existe un ouvrage sur ggplot2 ( Wickham (2016) ) qui offre un bon aperçu, mais
il est obsolète. La 3e édition est en préparation et sera disponible gratuitement en ligne.
La page web ggplot2 (https://ggplot2.tidyverse.org)
propose une documentation complète.
ggplot2 fonctionne avec des données au format « long »,
c’est-à-dire une colonne pour chaque dimension et une ligne pour chaque
observation. Des données bien structurées vous feront gagner beaucoup de
temps lors de la création de figures avec ggplot2.
Les graphiques ggplot sont construits étape par étape en ajoutant de nouveaux éléments. L’ajout de couches de cette manière permet une grande flexibilité et une personnalisation approfondie des graphiques.
Le principe de la Grammaire des graphiques est que l’on peut construire tout graphique à partir des mêmes 3 composants : (1) un jeu de données, (2) un système de coordonnées et (3) des geoms — c’est-à-dire des marques visuelles qui représentent des points de données 1
Pour créer un ggplot, nous utiliserons le modèle de base suivant, applicable à différents types de graphiques :
ggplot(data = <DATA>, mapping = aes(<MAPPINGS>)) + <GEOM_FUNCTION>()- utilisez la fonction
ggplot()et liez le graphique à un tableau de données spécifique à l’aide de l’argumentdata
R
ggplot(data = rna)
- définissez une correspondance (avec la fonction
esthétique (
aes)), en sélectionnant les variables à tracer et en précisant comment les représenter dans le graphique, par exemple par les positions x/y ou par des caractéristiques telles que la taille, la forme, la couleur, etc.
R
ggplot(data = rna, mapping = aes(x = expression))
-
ajoutez des « geoms » — géométries, ou représentations graphiques des données dans le graphique (points, lignes, barres).
ggplot2propose de nombreuses geoms différentes ; nous utiliserons aujourd’hui quelques-unes des plus courantes, notamment :* `geom_point()` for scatter plots, dot plots, etc. * `geom_histogram()` for histograms * `geom_boxplot()` for, well, boxplots! * `geom_line()` for trend lines, time series, etc.
Pour ajouter un geom(etry) au graphique, utilisez l’opérateur
+. Utilisons d’abord geom_histogram() :
R
ggplot(data = rna, mapping = aes(x = expression)) +
  geom_histogram()
OUTPUT
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.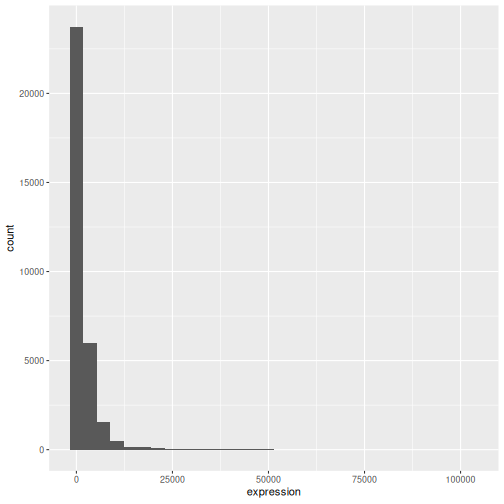
Le + du package ggplot2 est
particulièrement utile car il permet de modifier des objets
ggplot existants. Cela signifie que vous pouvez facilement
configurer des modèles de graphiques et explorer commodément différents
types de graphiques ; ainsi, le graphique ci-dessus peut également être
généré avec un code comme celui-ci :
R
# Assign plot to a variable
rna_plot <- ggplot(data = rna,
                   mapping = aes(x = expression))

# Draw the plot
rna_plot + geom_histogram()
Défi
Vous avez probablement remarqué un message automatique qui s’affiche lors du tracé de l’histogramme :
OUTPUT
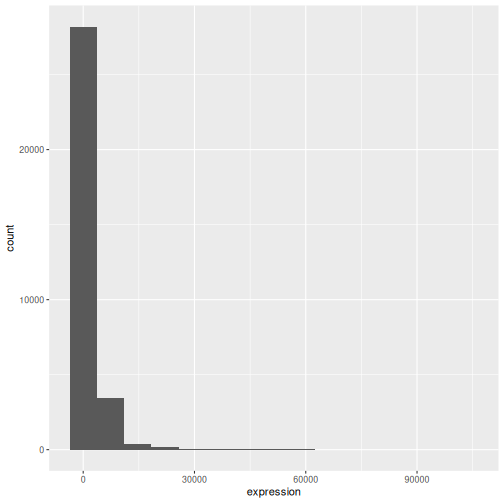
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.Modifiez les arguments bins ou binwidth de
geom_histogram() pour modifier le nombre ou la largeur des
intervalles.
R
# change bins
ggplot(rna, aes(x = expression)) +
    geom_histogram(bins = 15)
R
# change binwidth
ggplot(rna, aes(x = expression)) +
    geom_histogram(binwidth = 2000)
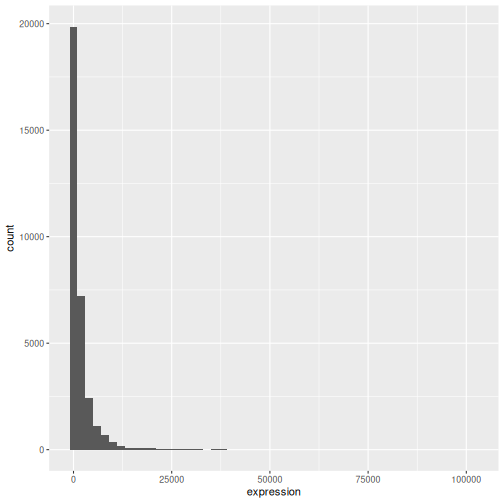
On constate ici que les données sont asymétriques vers la droite.
Nous pouvons appliquer une transformation logarithmique en base 2 pour
obtenir une distribution plus symétrique. Notons que nous ajoutons ici
une petite valeur constante (+1) afin d’éviter que des
valeurs -Inf ne soient renvoyées pour des valeurs
d’expression égales à 0.
R
rna <- rna |>
  mutate(expression_log = log2(expression + 1))
Si nous traçons maintenant l’histogramme des expressions transformées en logarithme en base 2, la distribution est effectivement plus proche d’une distribution normale.
R
ggplot(rna, aes(x = expression_log)) + geom_histogram()
OUTPUT
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.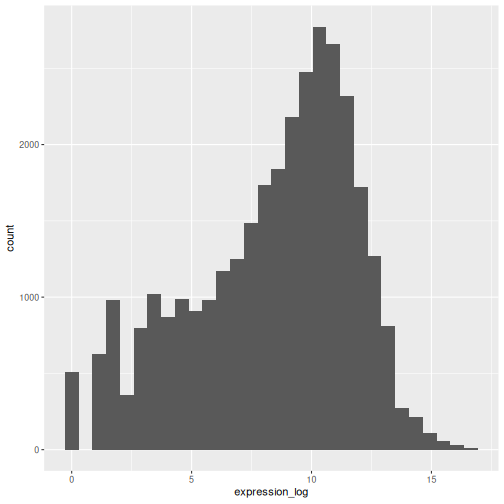
Désormais, nous travaillerons sur les valeurs d’expression transformées par logarithme.
Défi
Une autre façon de visualiser cette transformation consiste à examiner l’échelle des observations. Par exemple, il peut être utile de modifier l’échelle de l’axe afin de mieux répartir les observations dans l’espace du graphique. La modification de l’échelle des axes s’effectue de la même manière que l’ajout ou la modification d’autres composants (c’est-à-dire en ajoutant des commandes progressivement). Essayez d’effectuer cette modification :
- Représentez l’expression non transformée à l’échelle log10 ; voir
scale_x_log10(). Comparez-la au graphique précédent. Pourquoi des messages d’avertissement s’affichent-ils désormais ?
R
ggplot(data = rna,mapping = aes(x = expression))+
  geom_histogram() +
  scale_x_log10()
WARNING
Warning in scale_x_log10(): log-10 transformation introduced infinite values.OUTPUT
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.WARNING
Warning: Removed 507 rows containing non-finite outside the scale range
(`stat_bin()`).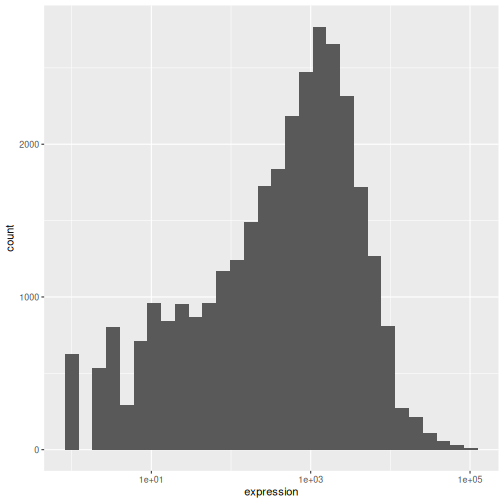
Notes
- Tout ce que vous insérez dans la fonction
ggplot()est visible par toutes les couches geom que vous ajoutez (c’est-à-dire qu’il s’agit de paramètres de tracé globaux). Cela inclut la correspondance des axes x et y que vous configurez dansaes(). - Vous pouvez également spécifier des correspondances pour un geom
donné, indépendamment des correspondances définies globalement dans la
fonction
ggplot(). - Le signe
+utilisé pour ajouter de nouvelles couches doit être placé à la fin de la ligne contenant la couche précédente. Si, en revanche, le signe+est ajouté au début de la ligne contenant la nouvelle couche,ggplot2n’ajoutera pas la nouvelle couche et renvoiera un message d’erreur.
R
# This is the correct syntax for adding layers
rna_plot +
  geom_histogram()

# This will not add the new layer and will return an error message
rna_plot
  + geom_histogram()
Création itérative de vos graphiques
Nous allons maintenant tracer un nuage de points avec deux variables
continues et la fonction geom_point(). Ce graphique
représentera les log2 des rapports d’expression (log2 fold changes), en
comparant le temps 8 au temps 0 et le temps 4 au temps 0. Pour cela,
nous devons d’abord calculer les moyennes des valeurs d’expression
transformées en log2, par gène et par temps. Nous calculons ensuite les
log2 des rapports d’expression en soustrayant la moyenne au temps 0 de
celle au temps 8, puis de celle au temps 4. Notez que nous incluons
également le biotype des gènes, que nous utiliserons plus tard pour
représenter les gènes. Nous enregistrerons ces log2 des rapports
d’expression dans un nouveau tableau de données appelé
rna_fc..
R
rna_fc <- rna |> select(gene, time,
                         gene_biotype, expression_log) |>
  group_by(gene, time, gene_biotype) |>
  summarize(mean_exp = mean(expression_log)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  mutate(time_8_vs_0 = `8` - `0`, time_4_vs_0 = `4` - `0`)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, time, and gene_biotype.
ℹ Output is grouped by gene and time.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time, gene_biotype))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
Nous pouvons ensuite créer un ggplot avec le jeu de données
rna_fc nouvellement créé. La création de graphiques avec
ggplot2 est généralement un processus itératif. Nous
commençons par définir le jeu de données que nous utiliserons, disposer
les axes et choisir un geom :
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_point()
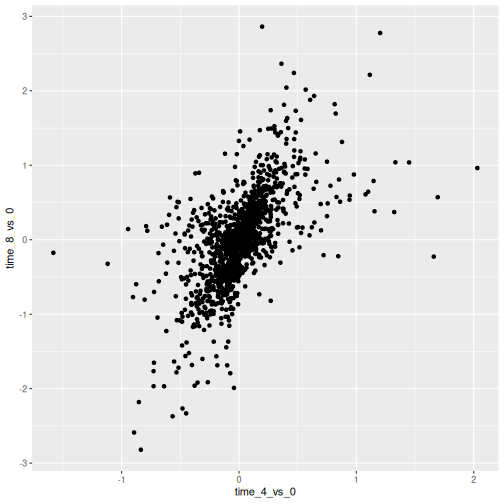
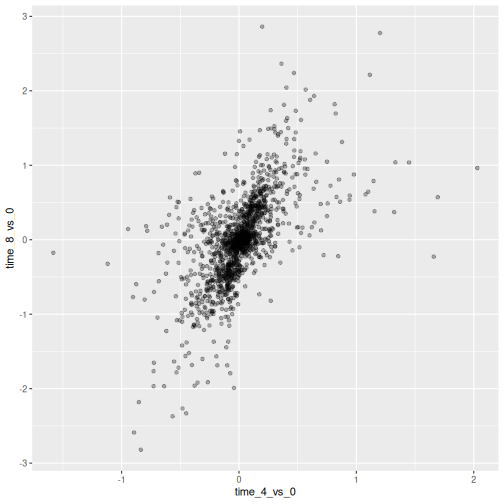
Ensuite, nous commençons à modifier ce graphique pour en extraire
davantage d’informations. Par exemple, nous pouvons ajouter de la
transparence (alpha) afin d’éviter la superposition des
points :
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_point(alpha = 0.3)
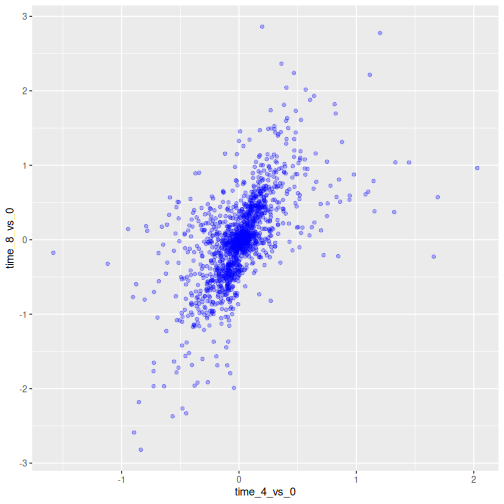
Nous pouvons également ajouter des couleurs pour tous les points :
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_point(alpha = 0.3, color = "blue")
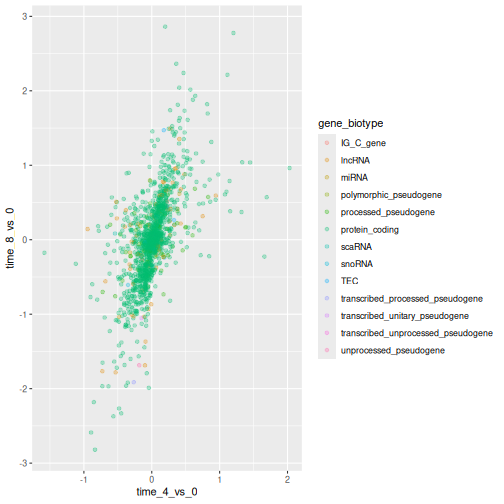
Ou encore, pour colorer chaque gène du graphique différemment, vous
pourriez utiliser un vecteur comme entrée pour l’argument
color. ggplot2 fournira une couleur
différente correspondant à différentes valeurs du vecteur. Voici un
exemple où nous colorions avec gene_biotype :
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_point(alpha = 0.3, aes(color = gene_biotype))
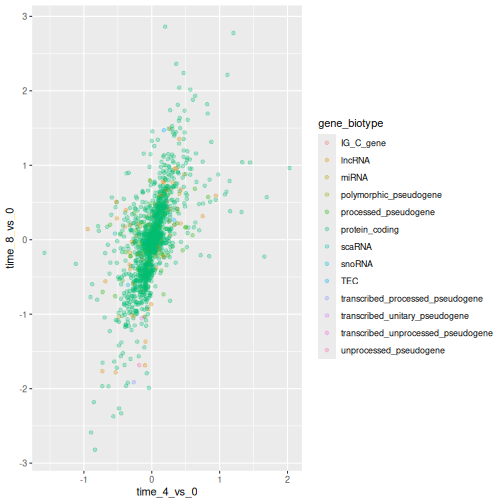
Nous pouvons également spécifier les couleurs directement au sein de
la correspondance fournie dans la fonction ggplot().
Celles-ci seront prises en compte par toutes les couches geom, et la
correspondance sera déterminée par les axes x et y configurés dans
aes().
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0,
                                color = gene_biotype)) +
  geom_point(alpha = 0.3)
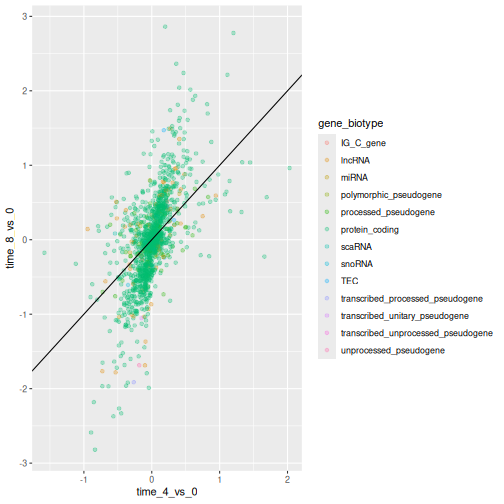
Enfin, nous pourrions également ajouter une ligne diagonale avec la
fonction geom_abline() :
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0,
                                color = gene_biotype)) +
  geom_point(alpha = 0.3) +
  geom_abline(intercept = 0)
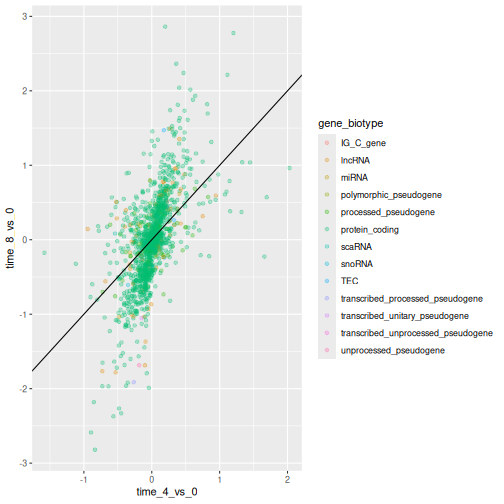
Notons que nous pouvons modifier la couche geom de
geom_point à geom_jitter et que les couleurs
resteront déterminées par gene_biotype.
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0,
                                color = gene_biotype)) +
  geom_jitter(alpha = 0.3) +
  geom_abline(intercept = 0)
Défi
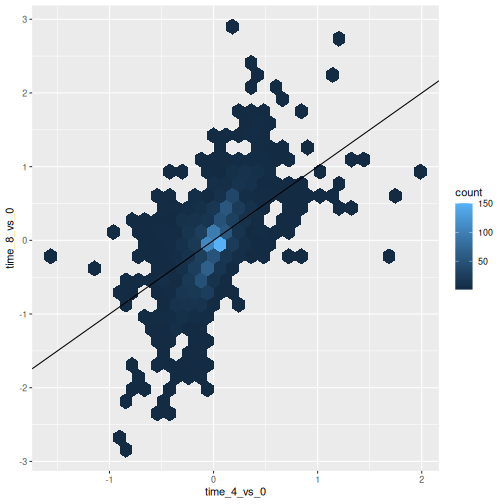
Les nuages de points peuvent être des outils exploratoires utiles
pour de petits jeux de données. Pour les jeux de données comportant un
grand nombre d’observations, comme le jeu de données
rna_fc, la superposition des points peut constituer une
limite. Une stratégie pour gérer de tels cas consiste à regrouper les
observations dans des cellules hexagonales. L’espace du graphique est
pavé d’hexagones. Une couleur est attribuée à chaque hexagone en
fonction du nombre d’observations qu’il contient.
Pour regrouper les observations dans des cellules hexagonales avec
ggplot2, installez d’abord le package Rhexbindepuis CRAN et chargez-le.Utilisez ensuite la fonction
geom_hex()pour générer la figure hexbin.Quels sont les avantages et les inconvénients d’un graphique à cellules hexagonales par rapport à un nuage de points ? Examinez le nuage de points ci-dessus et comparez-le au graphique à cellules hexagonales que vous avez créé.
R
install.packages("hexbin")
R
library("hexbin")

ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_hex() +
  geom_abline(intercept = 0)
Défi
Utilisez ce que vous venez d’apprendre pour créer un graphique de
dispersion de expression_log en fonction de
sample à partir du jeu de données rna, en
affichant le temps dans différentes couleurs. Est-ce un bon moyen de
présenter ce type de données ?
R
ggplot(data = rna, mapping = aes(y = expression_log, x = sample)) +
    geom_point(aes(color = time))
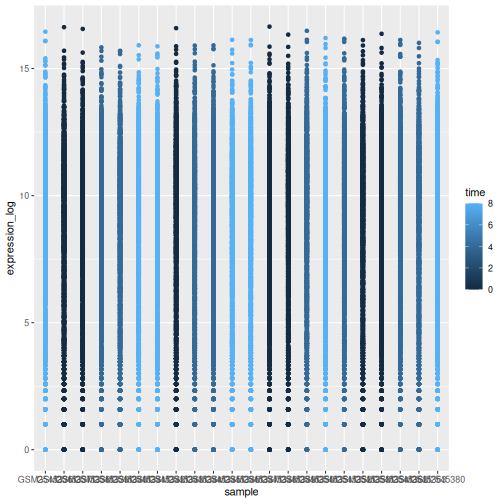
Diagramme en boîtes
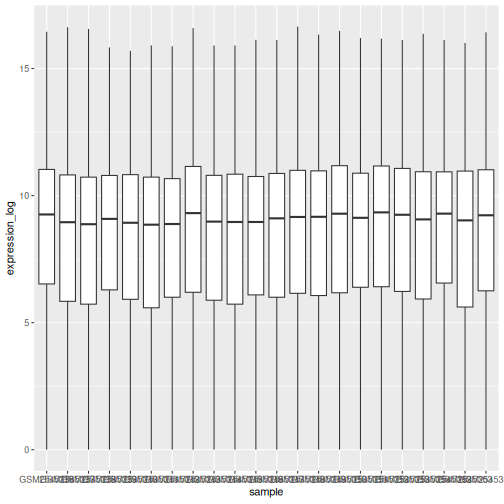
Nous pouvons utiliser des boîtes à moustaches pour visualiser la distribution des expressions géniques au sein de chaque échantillon :
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_boxplot()
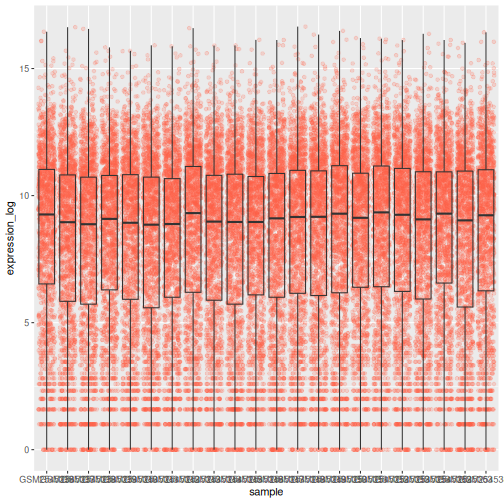
En ajoutant des points au graphique en boîtes, nous pouvons mieux appréhender le nombre de mesures et leur répartition :
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_jitter(alpha = 0.2, color = "tomato") +
  geom_boxplot(alpha = 0)
Défi
Remarquez que la couche du boxplot se trouve devant la couche du jitter. Que faut-il modifier dans le code pour placer le boxplot sous les points ?
Nous devrions inverser l’ordre de ces deux geoms :
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_boxplot(alpha = 0) +
  geom_jitter(alpha = 0.2, color = "tomato")
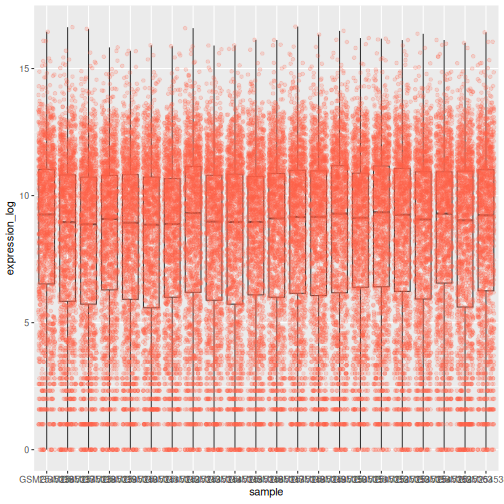
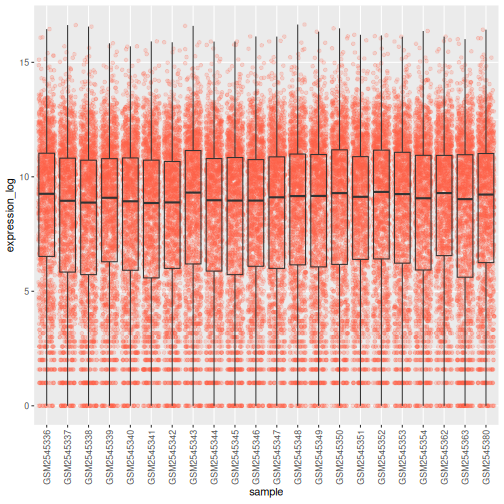
Vous remarquerez peut-être que les valeurs sur l’axe des abscisses sont toujours mal lisibles. Modifions l’orientation des étiquettes et ajustons-les verticalement et horizontalement pour qu’elles ne se chevauchent pas. Vous pouvez utiliser un angle de 90 degrés, ou expérimenter pour trouver l’angle approprié pour des étiquettes orientées en diagonale :
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_jitter(alpha = 0.2, color = "tomato") +
  geom_boxplot(alpha = 0) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
Défi
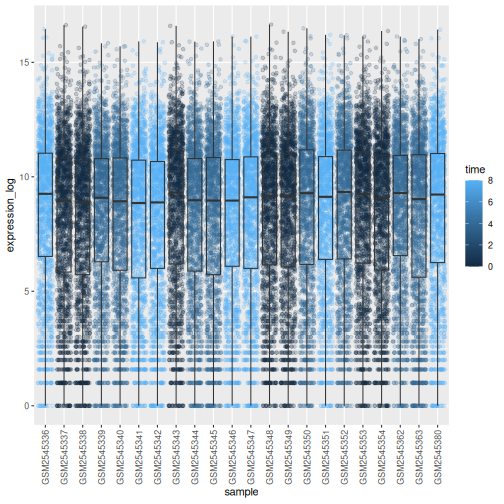
Ajoutez de la couleur aux points de votre graphique en boîtes en
fonction de la durée de l’infection (time).
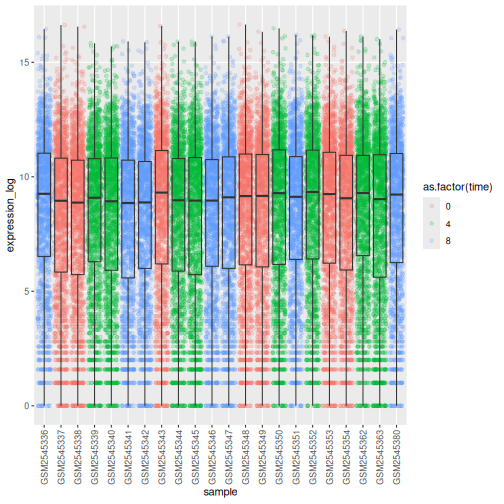
Indice : Vérifiez la classe de time. Envisagez
de modifier la classe de time, passant de nombre entier à
facteur, directement dans la correspondance ggplot. Pourquoi ce
changement modifie-t-il la façon dont R crée le graphique ?
R
# time as integer
ggplot(data = rna,
         mapping = aes(y = expression_log,
                       x = sample)) +
  geom_jitter(alpha = 0.2, aes(color = time)) +
  geom_boxplot(alpha = 0) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
R
# time as factor
ggplot(data = rna,
         mapping = aes(y = expression_log,
                       x = sample)) +
  geom_jitter(alpha = 0.2, aes(color = as.factor(time))) +
  geom_boxplot(alpha = 0) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
Défi
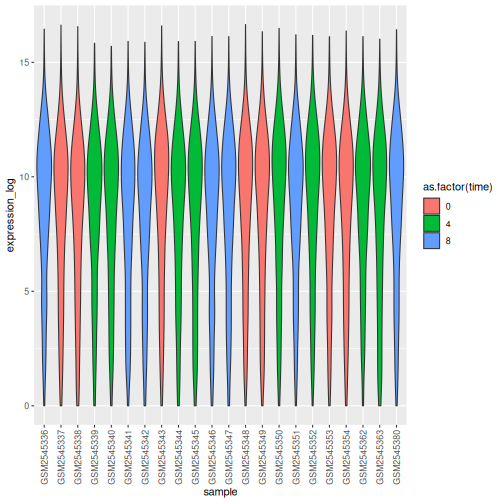
Les boîtes à moustaches sont des résumés utiles, mais masquent la forme de la distribution. Par exemple, si la distribution est bimodale, nous ne la verrions pas dans une boîte à moustaches. Une alternative à la boîte à moustaches est le graphique en violon, où la forme (de la densité des points) est tracée.
- Remplacez le graphique en boîtes par un graphique en violons ; voir
geom_violin(). Remplissez les violons en fonction du temps à l’aide de l’argumentfill.
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_violin(aes(fill = as.factor(time))) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
Défi
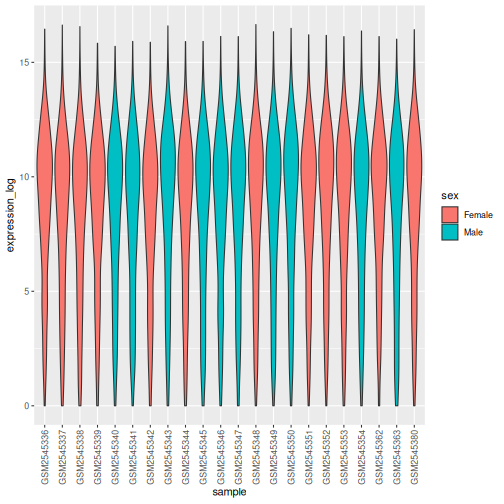
- Modifiez le graphique en violons pour remplir les violons par
sex.
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_violin(aes(fill = sex)) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
Graphiques en courbes
Calculons l’expression moyenne par durée d’infection pour les 10
gènes présentant les log2 des rapports d’expression les plus élevés
entre le temps 8 et le temps 0. Tout d’abord, nous devons sélectionner
les gènes et créer un sous-ensemble de rna appelé
sub_rna contenant les 10 gènes sélectionnés, puis regrouper
les données et calculer l’expression génique moyenne au sein de chaque
groupe :
R
rna_fc <- rna_fc |> arrange(desc(time_8_vs_0))

genes_selected <- rna_fc$gene[1:10]

sub_rna <- rna |>
    filter(gene %in% genes_selected)

mean_exp_by_time <- sub_rna |>
  group_by(gene,time) |>
    summarize(mean_exp = mean(expression_log))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
mean_exp_by_time
OUTPUT
# A tibble: 30 × 3
# Groups:   gene [10]
   gene   time mean_exp
   <chr> <int>    <dbl>
 1 Acr       0     5.07
 2 Acr       4     5.54
 3 Acr       8     7.31
 4 Aipl1     0     3.70
 5 Aipl1     4     3.89
 6 Aipl1     8     6.56
 7 Bst1      0     3.20
 8 Bst1      4     3.77
 9 Bst1      8     5.22
10 Chil3     0     4.00
# ℹ 20 more rows
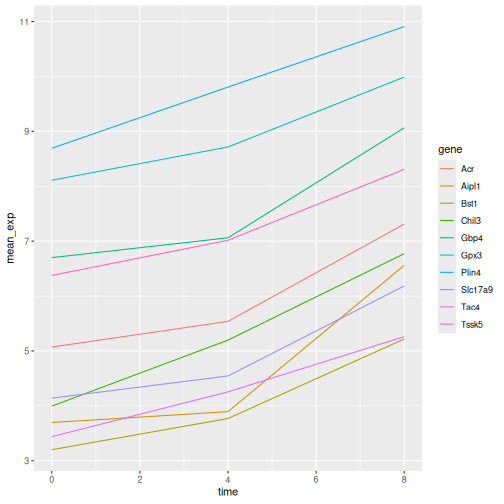
Nous pouvons créer le graphique en courbes avec la durée de l’infection sur l’axe des abscisses et l’expression moyenne sur l’axe des ordonnées :
R
ggplot(data = mean_exp_by_time, mapping = aes(x = time, y = mean_exp)) +
  geom_line()
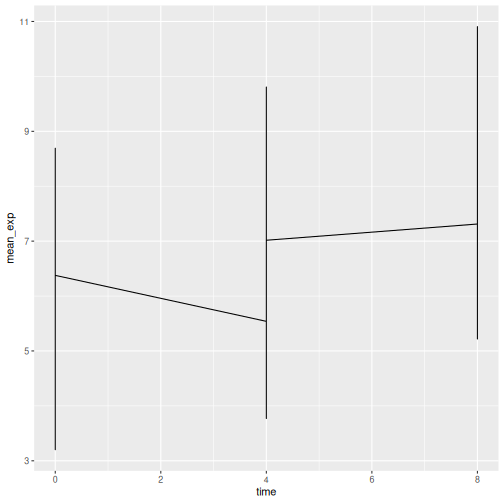
Malheureusement, cela ne fonctionne pas car nous avons tracé les
données de tous les gènes ensemble. Nous devons indiquer à ggplot de
tracer une ligne pour chaque gène en modifiant la fonction esthétique
pour y inclure group = gene :
R
ggplot(data = mean_exp_by_time,
       mapping = aes(x = time, y = mean_exp, group = gene)) +
  geom_line()
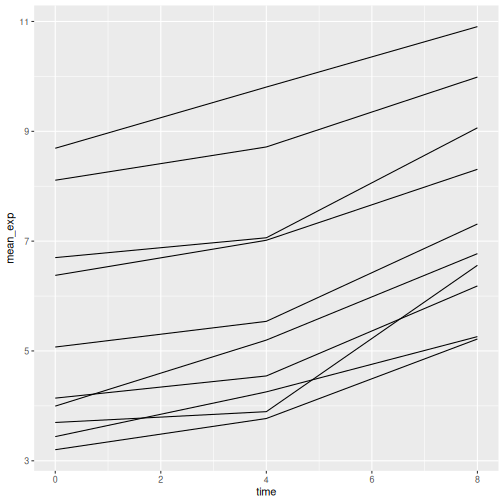
Nous pourrons distinguer les gènes dans le graphique si nous ajoutons
des couleurs (l’utilisation de color regroupe également
automatiquement les données) :
R
ggplot(data = mean_exp_by_time,
       mapping = aes(x = time, y = mean_exp, color = gene)) +
  geom_line()
Facettage
ggplot2 dispose d’une technique appelée
facettage qui permet de diviser un graphique en plusieurs
sous-graphiques selon un facteur du jeu de données. Ces différents
sous-graphiques héritent des mêmes propriétés (limites des axes,
graduations, etc.) afin de faciliter leur comparaison directe. Nous
l’utiliserons pour créer un graphique en courbes au fil du temps pour
chaque gène :
R
ggplot(data = mean_exp_by_time,
       mapping = aes(x = time, y = mean_exp)) + geom_line() +
  facet_wrap(~ gene)
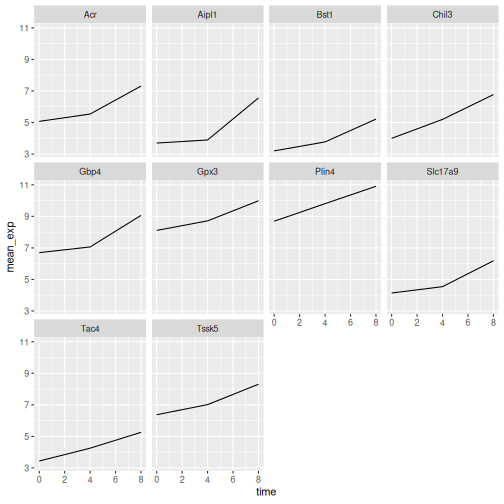
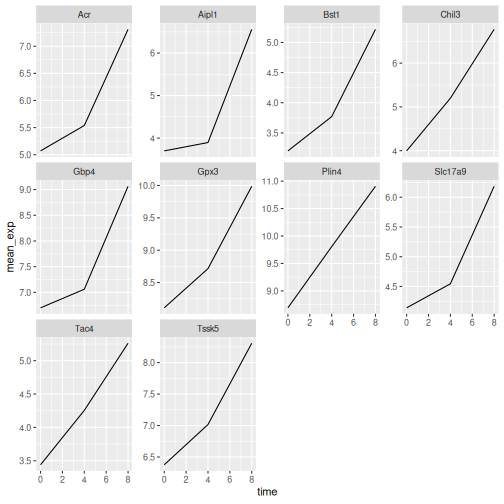
Ici, les axes x et y ont tous deux la même échelle pour tous les
sous-graphiques. Vous pouvez modifier ce comportement par défaut en
modifiant scales afin de permettre une échelle libre pour
l’axe y :
R
ggplot(data = mean_exp_by_time,
       mapping = aes(x = time, y = mean_exp)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y")
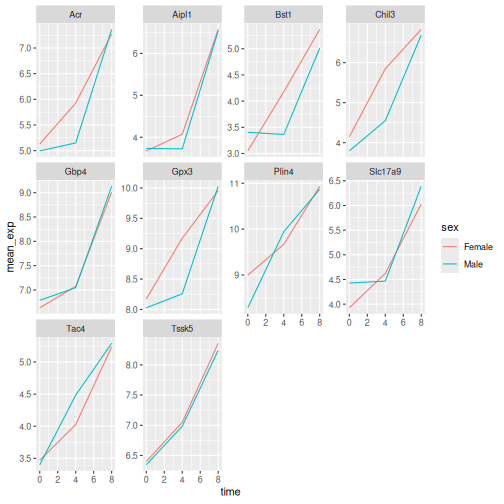
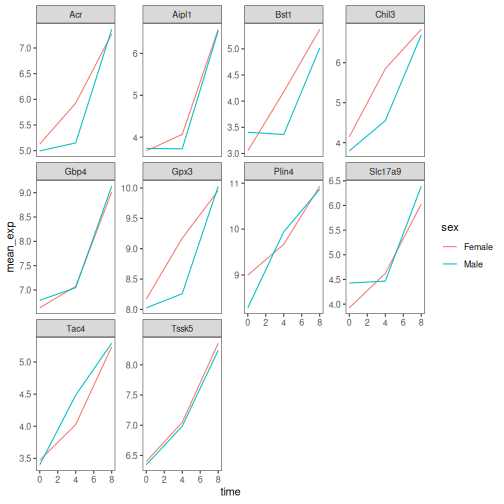
Nous souhaitons maintenant séparer la ligne dans chaque graphique
selon le sexe des souris. Pour ce faire, nous devons calculer
l’expression moyenne dans le tableau de données, regroupé par
gene, time et sex :
R
mean_exp_by_time_sex <- sub_rna |>
  group_by(gene, time, sex) |>
    summarize(mean_exp = mean(expression_log))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, time, and sex.
ℹ Output is grouped by gene and time.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time, sex))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
mean_exp_by_time_sex
OUTPUT
# A tibble: 60 × 4
# Groups:   gene, time [30]
   gene   time sex    mean_exp
   <chr> <int> <chr>     <dbl>
 1 Acr       0 Female     5.13
 2 Acr       0 Male       5.00
 3 Acr       4 Female     5.93
 4 Acr       4 Male       5.15
 5 Acr       8 Female     7.27
 6 Acr       8 Male       7.36
 7 Aipl1     0 Female     3.67
 8 Aipl1     0 Male       3.73
 9 Aipl1     4 Female     4.07
10 Aipl1     4 Male       3.72
# ℹ 50 more rows
Nous pouvons désormais créer le graphique facetté en effectuant un
nouveau découpage selon le sexe à l’aide de color (au sein
d’un même graphique) :
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y")
En général, les graphiques à fond blanc sont plus lisibles une fois
imprimés. Nous pouvons régler le fond sur blanc à l’aide de la fonction
theme_bw(). De plus, nous pouvons supprimer la grille :
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank())
Défi
Utilisez ce que vous venez d’apprendre pour créer un graphique illustrant l’évolution de l’expression moyenne de chaque chromosome au cours de l’infection.
R
mean_exp_by_chromosome <- rna |>
  group_by(chromosome_name, time) |>
  summarize(mean_exp = mean(expression_log))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by chromosome_name and time.
ℹ Output is grouped by chromosome_name.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(chromosome_name, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
ggplot(data = mean_exp_by_chromosome, mapping = aes(x = time,
                                y = mean_exp)) +
  geom_line() +
  facet_wrap(~ chromosome_name, scales = "free_y")
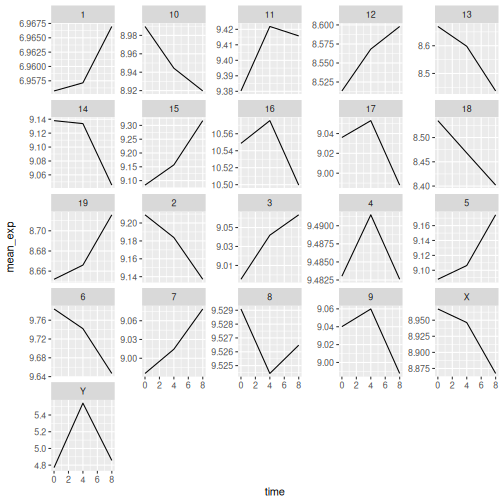
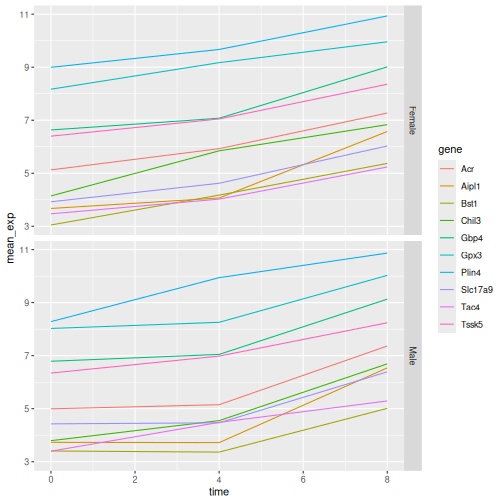
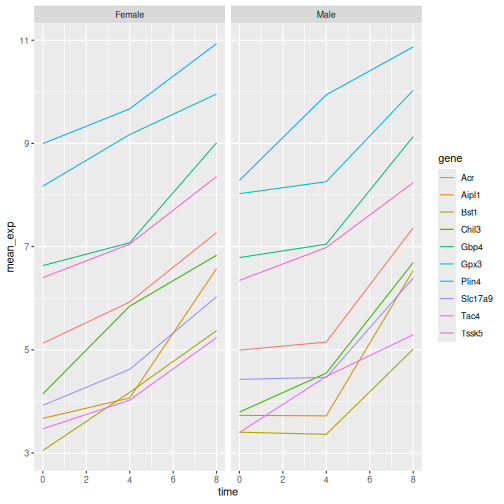
La fonction facet_wrap répartit les facettes sur
plusieurs lignes et colonnes afin qu’elles tiennent clairement sur une
seule page. La fonction facet_grid permet, quant à elle, de
spécifier explicitement la disposition des facettes à l’aide d’une
formule (rows ~ columns ; un . peut servir de
marqueur pour indiquer une seule ligne ou une seule colonne).
Modifions le graphique précédent pour comparer l’évolution de la moyenne de l’expression génique chez les mâles et les femelles au fil du temps :
R
# One column, facet by rows
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = gene)) +
  geom_line() +
  facet_grid(sex ~ .)
R
# One row, facet by column
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = gene)) +
  geom_line() +
  facet_grid(. ~ sex)
Thèmes de ggplot2
En plus de theme_bw(), qui change l’arrière-plan du
graphique en blanc, ggplot2 propose plusieurs autres thèmes
qui peuvent s’avérer utiles pour modifier rapidement l’aspect de votre
visualisation. La liste complète des thèmes est disponible à https://ggplot2.tidyverse.org/reference/ggtheme.html.
theme_minimal() et theme_light() sont
populaires, et theme_void() peut être utile comme point de
départ pour créer un nouveau thème personnalisé.
Le package ggthemes
propose une grande variété d’options (dont un thème Excel 2003). Le site web des extensions
ggplot2 propose une liste de packages qui étendent les
fonctionnalités de ggplot2, notamment des thèmes
supplémentaires.
Personnalisation
Revenons au graphique facetté de l’expression moyenne selon le temps et le gène, coloré par sexe.
Jetez un coup d’œil à la fiche
pratique ggplot2, et réfléchissez à des moyens
d’améliorer le graphique.
Désormais, nous pouvons remplacer les noms des axes par des appellations plus informatives que « time » et « mean_exp », et ajouter un titre à la figure :
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  labs(title = "Mean gene expression by duration of the infection",
       x = "Duration of the infection (in days)",
       y = "Mean gene expression")
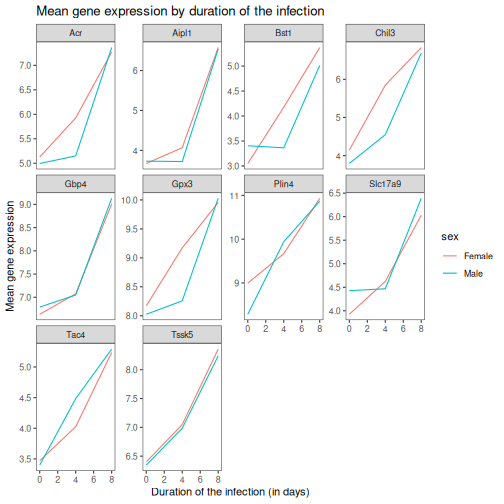
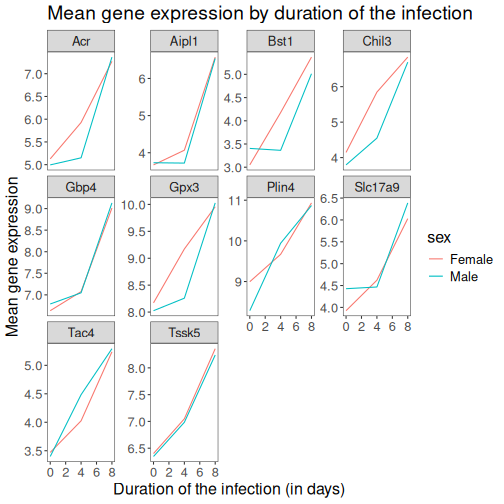
Les axes possèdent des noms plus explicites, mais leur lisibilité peut être améliorée en augmentant la taille de la police :
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  labs(title = "Mean gene expression by duration of the infection",
       x = "Duration of the infection (in days)",
       y = "Mean gene expression")  +
  theme(text = element_text(size = 16))
Notez qu’il est également possible de modifier les polices de vos
graphiques. Si vous utilisez Windows, vous devrez peut-être installer le
package
extrafont.
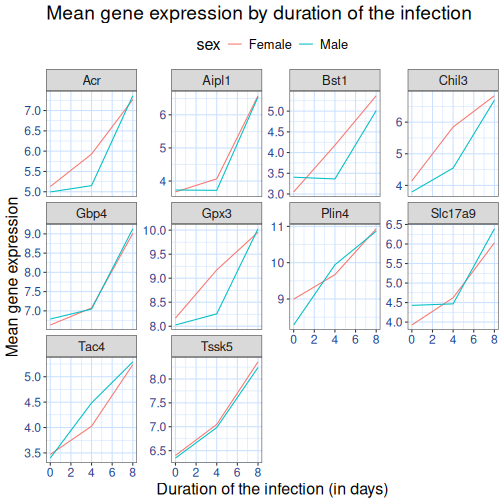
Nous pouvons encore personnaliser la couleur du texte des axes X et
Y, la couleur de la grille, etc. Nous pouvons également, par exemple,
déplacer la légende en haut en définissant legend.position
à "top".
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  labs(title = "Mean gene expression by duration of the infection",
       x = "Duration of the infection (in days)",
       y = "Mean gene expression")  +
  theme(text = element_text(size = 16),
        axis.text.x = element_text(colour = "royalblue4", size = 12),
        axis.text.y = element_text(colour = "royalblue4", size = 12),
        panel.grid = element_line(colour="lightsteelblue1"),
        legend.position = "top")
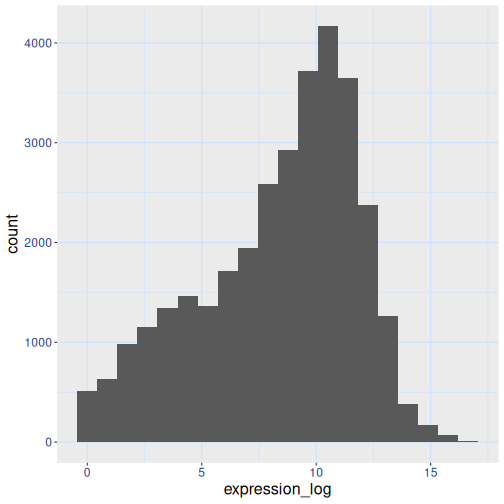
Si vous préférez votre personnalisation au thème par défaut, vous pouvez l’enregistrer sous la forme d’un objet afin de l’appliquer facilement à d’autres graphiques. Voici un exemple avec l’histogramme que nous avons créé précédemment.
R
blue_theme <- theme(axis.text.x = element_text(colour = "royalblue4",
                                               size = 12),
                    axis.text.y = element_text(colour = "royalblue4",
                                               size = 12),
                    text = element_text(size = 16),
                    panel.grid = element_line(colour="lightsteelblue1"))

ggplot(rna, aes(x = expression_log)) +
  geom_histogram(bins = 20) +
    blue_theme
Défi
Avec toutes ces informations en main, prenez encore cinq minutes pour
soit améliorer l’un des graphiques générés dans cet exercice, soit créer
votre propre graphique esthétique. Consultez la fiche
de référence ggplot2 de RStudio pour vous inspirer.
Voici quelques idées :
- Voyez si vous pouvez modifier l’épaisseur des lignes.
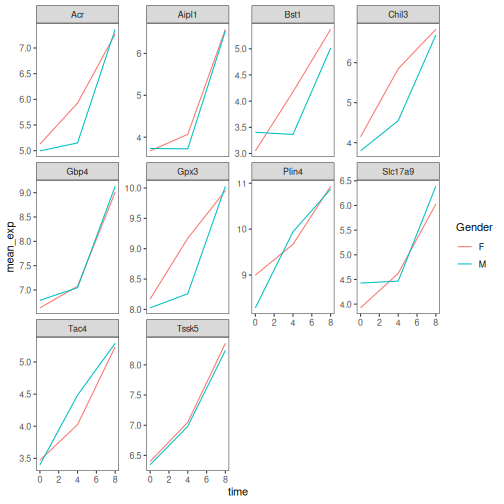
- Pouvez-vous trouver un moyen de modifier le nom de la légende ? Et
pour ses étiquettes ? (indice : cherchez une fonction ggplot commençant
par
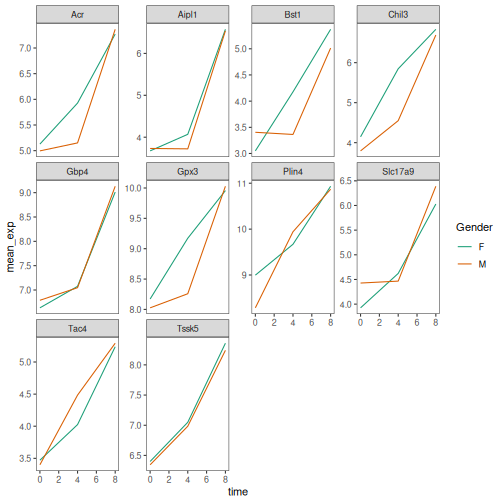
scale_) - Essayez d’utiliser une autre palette de couleurs ou de spécifier manuellement les couleurs des lignes (voir https://www.cookbook-r.com/Graphs/Colors_(ggplot2)/).
Par exemple, en se basant sur ce graphique :
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank())
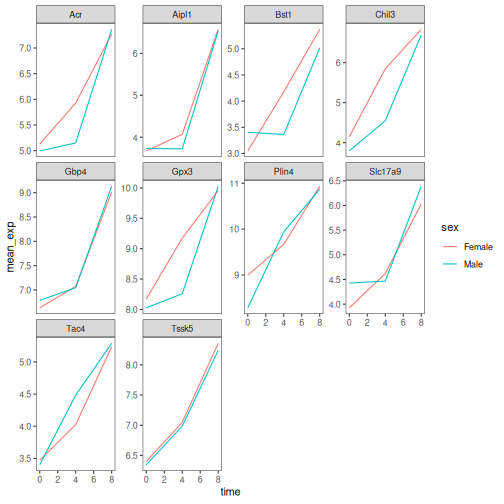
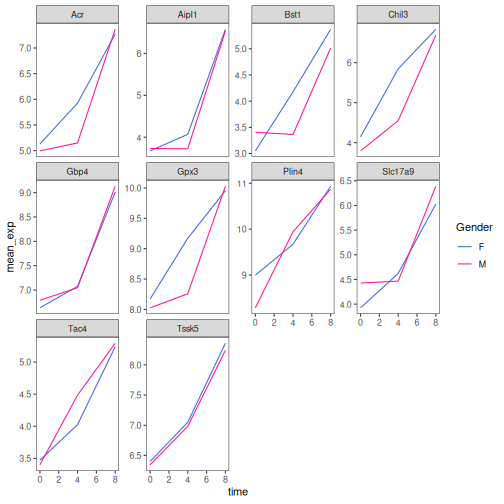
Nous pouvons le personnaliser de la manière suivante :
R
# change the thickness of the lines
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line(size=1.5) +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank())
WARNING
Warning: Using `size` aesthetic for lines was deprecated in ggplot2 3.4.0.
ℹ Please use `linewidth` instead.
This warning is displayed once per session.
Call `lifecycle::last_lifecycle_warnings()` to see where this warning was
generated.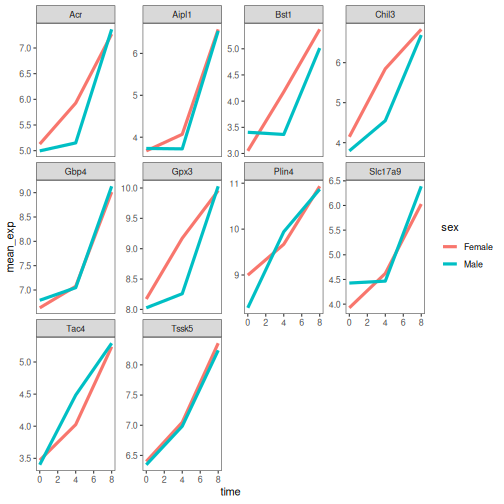
R
# change the name of the legend and the labels
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  scale_color_discrete(name = "Gender", labels = c("F", "M"))
R
# using a different color palette
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  scale_color_brewer(name = "Gender", labels = c("F", "M"), palette = "Dark2")
R
# manually specifying the colors
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  scale_color_manual(name = "Gender",  labels = c("F", "M"),
                     values = c("royalblue", "deeppink"))
Composer des graphiques
Le facettage est un excellent outil pour diviser un graphique en plusieurs sous-graphiques, mais il arrive que vous souhaitiez créer une seule figure contenant plusieurs graphiques indépendants, c’est-à-dire fondés sur des variables différentes ou même sur des tableaux de données distincts.
Commençons par créer les deux graphiques que nous souhaitons disposer côte à côte :
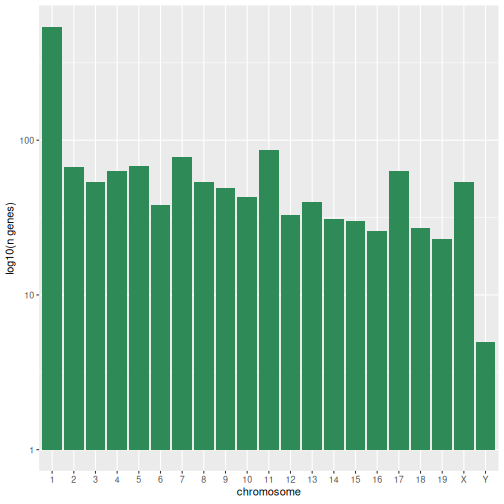
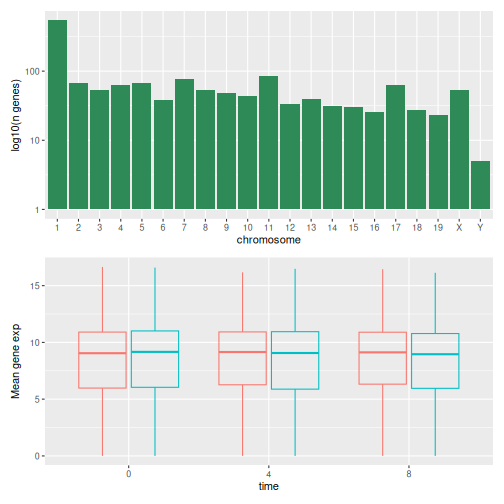
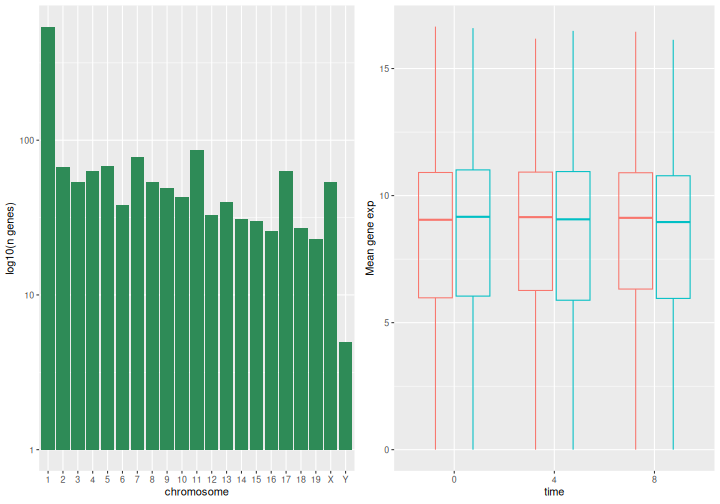
Le premier graphique compte le nombre de gènes uniques par
chromosome. Nous devons d’abord réordonner les niveaux de
chromosome_name et filtrer les gènes uniques par
chromosome. Nous modifions également l’échelle de l’axe des ordonnées
pour passer à une échelle logarithmique en base 10, afin d’améliorer la
lisibilité.
R
rna$chromosome_name <- factor(rna$chromosome_name,
                               levels = c(1:19,"X","Y"))

count_gene_chromosome <- rna |>
  select(chromosome_name, gene) |>
  distinct() |> ggplot() +
  geom_bar(aes(x = chromosome_name), fill = "seagreen",
           position = "dodge", stat = "count") +
  labs(y = "log10(n genes)", x = "chromosome") +
  scale_y_log10()

count_gene_chromosome
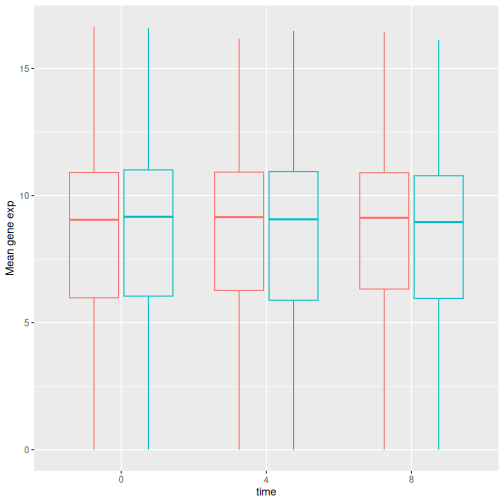
Ci-dessous, nous supprimons également entièrement la légende en
définissant legend.position à "none".
R
exp_boxplot_sex <- ggplot(rna, aes(y=expression_log, x = as.factor(time),
                 color=sex)) +
   geom_boxplot(alpha = 0) +
  labs(y = "Mean gene exp",
       x = "time") + theme(legend.position = "none")

exp_boxplot_sex
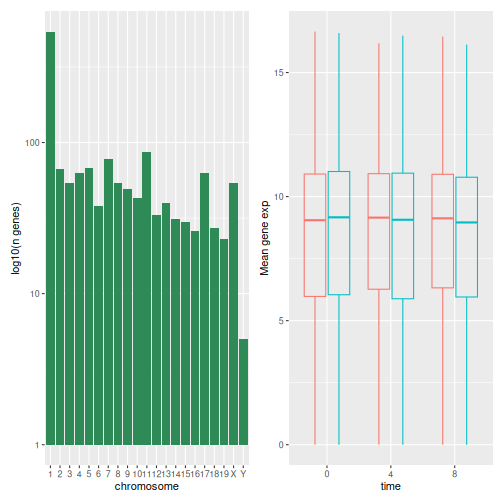
Le package patchwork
propose une approche élégante pour combiner des figures en utilisant
+ pour les disposer (généralement côte à côte). Plus
précisément, | les dispose explicitement côte à côte et
/ les empile les uns sur les autres.
R
install.packages("patchwork")
R
library("patchwork")
count_gene_chromosome + exp_boxplot_sex
R
## or count_gene_chromosome | exp_boxplot_sex
R
count_gene_chromosome / exp_boxplot_sex
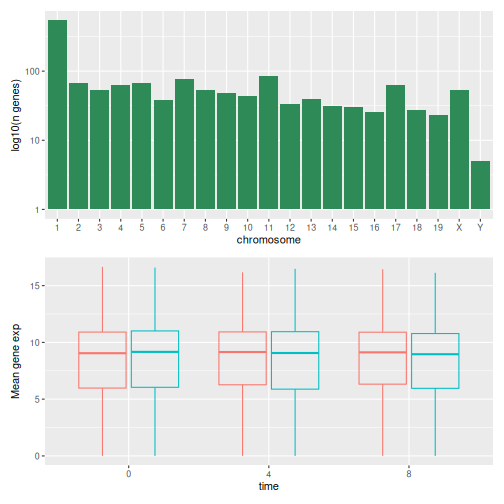
Nous pouvons affiner davantage le contrôle de la mise en page de la
composition finale à l’aide de plot_layout pour créer des
mises en page plus complexes :
R
count_gene_chromosome + exp_boxplot_sex + plot_layout(ncol = 1)
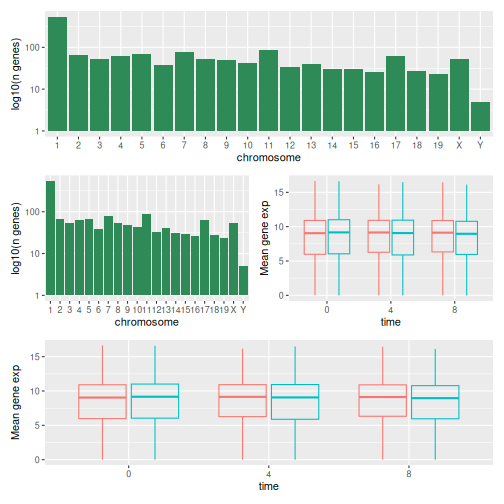
R
count_gene_chromosome +
 (count_gene_chromosome + exp_boxplot_sex) +
 exp_boxplot_sex +
 plot_layout(ncol = 1)
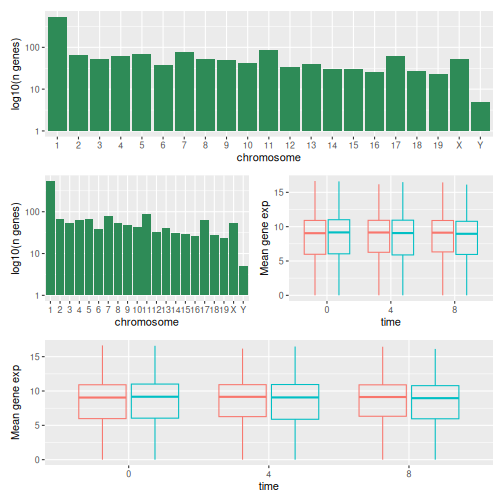
Le dernier graphique peut également être créé à l’aide des composants
| et / :
R
count_gene_chromosome /
 (count_gene_chromosome | exp_boxplot_sex) /
 exp_boxplot_sex
Pour en savoir plus sur patchwork, consultez sa page web ou cette vidéo.
Une autre option est le package
gridExtra, qui permet de combiner des
ggplots distincts en une seule figure à l’aide de
grid.arrange() :
R
install.packages("gridExtra")
R
library("gridExtra")
grid.arrange(count_gene_chromosome, exp_boxplot_sex, ncol = 2)
En plus des arguments ncol et nrow,
utilisés pour réaliser des dispositions simples, il existe des outils
permettant de construire
des mises en page plus complexes.
Exportation de graphiques
Une fois votre graphique créé, vous pouvez l’enregistrer dans un fichier au format de votre choix. L’onglet Exportation du volet Plot dans RStudio enregistre vos graphiques à faible résolution, ce qui ne sera pas accepté par de nombreuses revues et ne sera pas adapté aux posters.
Utilisez plutôt la fonction ggsave(), qui vous permet de
modifier facilement la dimension et la résolution de votre graphique en
ajustant les arguments correspondants (width,
height et dpi).
Assurez-vous d’avoir le dossier fig_output/ dans votre
répertoire de travail.
R
my_plot <- ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  labs(title = "Mean gene expression by duration of the infection",
         x = "Duration of the infection (in days)",
         y = "Mean gene expression") +
  guides(color=guide_legend(title="Gender")) +
  theme_bw() +
  theme(axis.text.x = element_text(colour = "royalblue4", size = 12),
        axis.text.y = element_text(colour = "royalblue4", size = 12),
        text = element_text(size = 16),
        panel.grid = element_line(colour="lightsteelblue1"),
        legend.position = "top")
ggsave("fig_output/mean_exp_by_time_sex.png", my_plot, width = 15,
       height = 10)

# This also works for grid.arrange() plots
combo_plot <- grid.arrange(count_gene_chromosome, exp_boxplot_sex,
                           ncol = 2, widths = c(4, 6))
ggsave("fig_output/combo_plot_chromosome_sex.png", combo_plot,
       width = 10, dpi = 300)
Remarque : Les paramètres width et height
déterminent également la taille de la police dans le graphique
enregistré.
Autres packages de visualisation
ggplot2 est un package très puissant qui s’intègre
parfaitement à notre pipeline de données ordonnées et
d’outils ordonnés. Il existe d’autres packages de visualisation
dans R qu’il ne faut pas négliger.
Graphismes de base
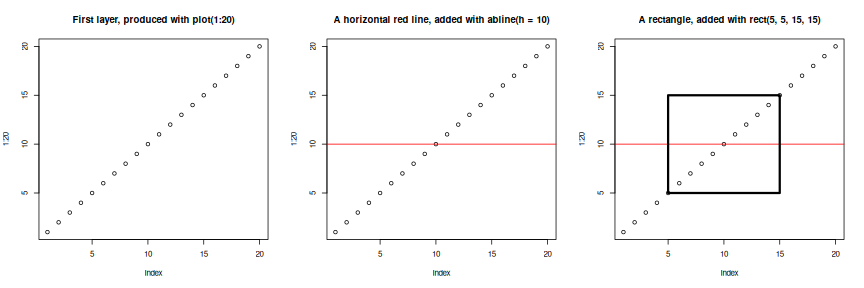
Le système graphique par défaut fourni avec R, souvent appelé
graphismes R de base, est simple et rapide. Il repose sur le
modèle du peintre ou de la toile, où différentes sorties sont
superposées directement les unes aux autres (voir figure ci-dessous ). C’est une différence
fondamentale avec ggplot2 (et avec lattice,
décrit ci-dessous), qui renvoie des objets dédiés, rendus à l’écran ou
dans un fichier, et qui peuvent même être mis à jour.
R
par(mfrow = c(1, 3))
plot(1:20, main = "First layer, produced with plot(1:20)")

plot(1:20, main = "A horizontal red line, added with abline(h = 10)")
abline(h = 10, col = "red")

plot(1:20, main = "A rectangle, added with rect(5, 5, 15, 15)")
abline(h = 10, col = "red")
rect(5, 5, 15, 15, lwd = 3)
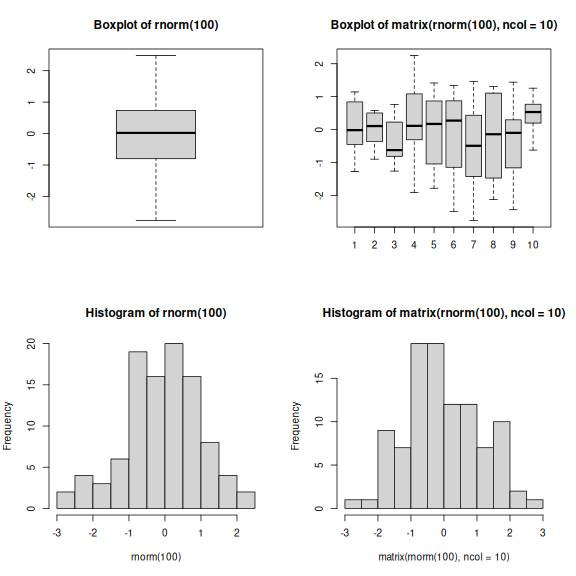
Une autre différence majeure est que la fonction de tracé des
graphiques de base tente de faire la bonne chose en fonction du
type d’entrée, c’est-à-dire qu’elle adapte son comportement en fonction
de la classe de son entrée. Cela diffère encore grandement de ce que
l’on trouve dans ggplot2, qui n’accepte que les tableaux de
données en entrée et nécessite que les graphiques soient construits
petit à petit.
R
par(mfrow = c(2, 2))
boxplot(rnorm(100),
        main = "Boxplot of rnorm(100)")
boxplot(matrix(rnorm(100), ncol = 10),
        main = "Boxplot of matrix(rnorm(100), ncol = 10)")
hist(rnorm(100))
hist(matrix(rnorm(100), ncol = 10))
L’approche par défaut des graphiques de base peut s’avérer très
efficace pour des figures simples et standard, qui peuvent être
produites très rapidement avec une seule ligne de code et une seule
fonction telle que plot, ou hist, ou
boxplot, … Les paramètres par défaut ne sont cependant pas
toujours les plus attrayants, et le réglage des figures, surtout
lorsqu’elles deviennent plus complexes (par exemple pour produire des
facettes), peut s’avérer long et fastidieux.
Le package lattice
Le package lattice ressemble à
ggplot2 en ce qu’il utilise des tableaux de données en
entrée, restitue des objets graphiques et prend en charge le facettage.
lattice, en revanche, ne repose pas sur la grammaire
graphique et possède une interface plus complexe.
Une bonne référence pour le package lattice est Deepayan (2008).
- Visualisation dans R
Source : Data Visualization Cheat Sheet.↩︎