
Manipulation et analyse de données avec dplyr
Last updated on 2026-11-07 | Edit this page
Estimated time: 150 minutes
Overview
Questions
- Analyse de données en R à l’aide du méta-package tidyverse
Objectives
- Décrivez l’objectif des packages
dplyrettidyr. - Décrivez plusieurs de leurs fonctions extrêmement utiles pour manipuler les données.
- Décrivez les concepts de format large et de format long, et voyez comment restructurer un tableau de données d’un format à l’autre.
- Démontrer comment joindre des tables.
Cet épisode est basé sur la leçon Data Analysis and Visualisation in R for Ecologists de Data Carpentries.
Manipulation des données à l’aide de
dplyr et
tidyr
L’extraction de sous-ensembles à l’aide de crochets est pratique, mais elle peut s’avérer fastidieuse et difficile à lire, surtout pour des opérations complexes.
Certains packages peuvent grandement faciliter notre tâche lors de la
manipulation de données. Les packages dans R sont essentiellement des
ensembles de fonctions supplémentaires qui vous permettent d’en faire
davantage. Les fonctions que nous avons utilisées jusqu’à présent, comme
str() ou data.frame(), sont intégrées à R ; le
chargement de packages peut vous donner accès à d’autres fonctions
spécifiques. Avant d’utiliser un package pour la première fois, vous
devez l’installer sur votre machine, puis vous devez l’importer à chaque
session R ultérieure lorsque vous en avez besoin.
Le package
dplyrpropose des outils puissants pour les tâches de manipulation de données. Il est conçu pour fonctionner directement avec des tableaux de données, avec de nombreuses opérations de manipulation optimisées.Comme nous le verrons plus loin, il arrive que nous souhaitions restructurer un tableau de données afin de pouvoir effectuer certaines analyses spécifiques ou pour la visualisation. Le package
tidyrrépond à ce problème courant de restructuration des données et propose des outils pour manipuler les données de manière ordonnée.
Pour en savoir plus sur dplyr et
tidyr après l’atelier, vous souhaiterez
peut-être consulter cette fiche
pratique sur la transformation de données avec
dplyr et celle-ci sur
tidyr.
- Le package
tidyverseest un « package parapluie » qui installe plusieurs packages utiles pour l’analyse de données qui fonctionnent bien ensemble, tels quetidyr,dplyr,ggplot2,tibble, etc. Ces packages nous aident à travailler avec les données et à interagir avec elles. Ils nous permettent d’effectuer de nombreuses opérations sur vos données, telles que la sous-sélection, la transformation, la visualisation, etc.
Si vous avez effectué la configuration, vous devriez déjà avoir installé le package tidyverse. Vérifiez si vous l’avez en essayant de le charger depuis la bibliothèque :
R
## load the tidyverse packages, incl. dplyr
library("tidyverse")
Si vous avez reçu un message d’erreur
there is no package called ‘tidyverse’, c’est que vous
n’avez pas encore installé le package pour cette version de R. Pour
installer le package tidyverse, saisissez
:
R
BiocManager::install("tidyverse")
Si vous avez dû installer le package
tidyverse, n’oubliez pas de le charger
dans cette session R en utilisant la commande library()
ci-dessus !
Chargement de données avec tidyverse
Au lieu de read.csv(), nous lirons nos données à l’aide
de la fonction read_csv() (notez le _ au lieu
du .), issue du package tidyverse
readr.
R
rna <- read_csv("data/rnaseq.csv")

## view the data
rna
OUTPUT
# A tibble: 32,428 × 19
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…       1170 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 Apod    GSM254…      36194 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 3 Cyp2d22 GSM254…       4060 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 4 Klk6    GSM254…        287 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 5 Fcrls   GSM254…         85 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 6 Slc2a4  GSM254…        782 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 7 Exd2    GSM254…       1619 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 Gjc2    GSM254…        288 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 9 Plp1    GSM254…      43217 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
10 Gnb4    GSM254…       1071 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
Notez que la classe des données est désormais appelée « tibble ».
Les tibbles modifient certains comportements des objets tableau de données que nous avons présentés précédemment. La structure de données est très similaire à celle d’un tableau de données. Pour nos besoins, les seules différences sont les suivantes :
Il affiche le type de données de chaque colonne sous son nom. Notez que <
dbl> est un type de données défini pour contenir des valeurs numériques avec des décimales.Il n’affiche que les premières lignes de données et seulement autant de colonnes que celles qui tiennent sur un écran.
Nous allons maintenant découvrir certaines des fonctions
dplyr les plus courantes :
-
select(): sélectionner des colonnes -
filter(): sélectionner des lignes selon des conditions -
mutate(): créer de nouvelles colonnes en utilisant des informations provenant d’autres colonnes -
group_by()etsummarise(): créer des statistiques de synthèse sur des données regroupées -
arrange(): trier les résultats -
count(): compter les valeurs discrètes
Sélection de colonnes et filtrage de lignes
Pour sélectionner des colonnes d’un tableau de données, utilisez
select(). Le premier argument de cette fonction est le
tableau de données (rna), et les arguments suivants sont
les colonnes à conserver.
R
select(rna, gene, sample, tissue, expression)
OUTPUT
# A tibble: 32,428 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545336 Cerebellum       1170
 2 Apod    GSM2545336 Cerebellum      36194
 3 Cyp2d22 GSM2545336 Cerebellum       4060
 4 Klk6    GSM2545336 Cerebellum        287
 5 Fcrls   GSM2545336 Cerebellum         85
 6 Slc2a4  GSM2545336 Cerebellum        782
 7 Exd2    GSM2545336 Cerebellum       1619
 8 Gjc2    GSM2545336 Cerebellum        288
 9 Plp1    GSM2545336 Cerebellum      43217
10 Gnb4    GSM2545336 Cerebellum       1071
# ℹ 32,418 more rows
Pour sélectionner toutes les colonnes sauf certaines, placez un « - » devant la variable pour l’exclure.
R
select(rna, -tissue, -organism)
OUTPUT
# A tibble: 32,428 × 17
   gene    sample   expression   age sex   infection strain  time mouse ENTREZID
   <chr>   <chr>         <dbl> <dbl> <chr> <chr>     <chr>  <dbl> <dbl>    <dbl>
 1 Asl     GSM2545…       1170     8 Fema… Influenz… C57BL…     8    14   109900
 2 Apod    GSM2545…      36194     8 Fema… Influenz… C57BL…     8    14    11815
 3 Cyp2d22 GSM2545…       4060     8 Fema… Influenz… C57BL…     8    14    56448
 4 Klk6    GSM2545…        287     8 Fema… Influenz… C57BL…     8    14    19144
 5 Fcrls   GSM2545…         85     8 Fema… Influenz… C57BL…     8    14    80891
 6 Slc2a4  GSM2545…        782     8 Fema… Influenz… C57BL…     8    14    20528
 7 Exd2    GSM2545…       1619     8 Fema… Influenz… C57BL…     8    14    97827
 8 Gjc2    GSM2545…        288     8 Fema… Influenz… C57BL…     8    14   118454
 9 Plp1    GSM2545…      43217     8 Fema… Influenz… C57BL…     8    14    18823
10 Gnb4    GSM2545…       1071     8 Fema… Influenz… C57BL…     8    14    14696
# ℹ 32,418 more rows
# ℹ 7 more variables: product <chr>, ensembl_gene_id <chr>,
#   external_synonym <chr>, chromosome_name <chr>, gene_biotype <chr>,
#   phenotype_description <chr>, hsapiens_homolog_associated_gene_name <chr>
Cela sélectionnera toutes les variables de rna, à
l’exception de tissue et de organism.
Pour sélectionner des lignes en fonction d’un critère spécifique,
utilisez filter() :
R
filter(rna, sex == "Male")
OUTPUT
# A tibble: 14,740 × 19
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…        626 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 2 Apod    GSM254…      13021 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 3 Cyp2d22 GSM254…       2171 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 4 Klk6    GSM254…        448 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 5 Fcrls   GSM254…        180 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 6 Slc2a4  GSM254…        313 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 7 Exd2    GSM254…       2366 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 8 Gjc2    GSM254…        310 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 9 Plp1    GSM254…      53126 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
10 Gnb4    GSM254…       1355 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
# ℹ 14,730 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
R
filter(rna, sex == "Male" & infection == "NonInfected")
OUTPUT
# A tibble: 4,422 × 19
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…        535 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 2 Apod    GSM254…      13668 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 3 Cyp2d22 GSM254…       2008 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 4 Klk6    GSM254…       1101 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 5 Fcrls   GSM254…        375 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 6 Slc2a4  GSM254…        249 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 7 Exd2    GSM254…       3126 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 8 Gjc2    GSM254…        791 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 9 Plp1    GSM254…      98658 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
10 Gnb4    GSM254…       2437 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
# ℹ 4,412 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
Imaginons maintenant que nous soyons intéressés par les homologues
humains des gènes de souris analysés dans cet ensemble de données. Ces
informations se trouvent dans la dernière colonne du tibble
rna, nommée
hsapiens_homolog_associated_gene_name. Pour les visualiser
facilement, nous créerons un nouveau tableau contenant uniquement les 2
colonnes gene et
hsapiens_homolog_associated_gene_name.
R
genes <- select(rna, gene, hsapiens_homolog_associated_gene_name)
genes
OUTPUT
# A tibble: 32,428 × 2
   gene    hsapiens_homolog_associated_gene_name
   <chr>   <chr>
 1 Asl     ASL
 2 Apod    APOD
 3 Cyp2d22 CYP2D6
 4 Klk6    KLK6
 5 Fcrls   FCRL2
 6 Slc2a4  SLC2A4
 7 Exd2    EXD2
 8 Gjc2    GJC2
 9 Plp1    PLP1
10 Gnb4    GNB4
# ℹ 32,418 more rows
Certains gènes de souris n’ont pas d’homologues humains. Ceux-ci
peuvent être récupérés à l’aide de filter() et de la
fonction is.na(), qui détermine si un élément est un
NA.
R
filter(genes, is.na(hsapiens_homolog_associated_gene_name))
OUTPUT
# A tibble: 4,290 × 2
   gene     hsapiens_homolog_associated_gene_name
   <chr>    <chr>
 1 Prodh    <NA>
 2 Tssk5    <NA>
 3 Vmn2r1   <NA>
 4 Gm10654  <NA>
 5 Hexa     <NA>
 6 Sult1a1  <NA>
 7 Gm6277   <NA>
 8 Tmem198b <NA>
 9 Adam1a   <NA>
10 Ebp      <NA>
# ℹ 4,280 more rows
Si nous voulons ne conserver que les gènes de souris possédant un
homologue humain, nous pouvons insérer un symbole « ! » qui nie le
résultat ; nous demandons ainsi toutes les lignes pour lesquelles
hsapiens_homolog_associated_gene_name n’est pas un
NA.
R
filter(genes, !is.na(hsapiens_homolog_associated_gene_name))
OUTPUT
# A tibble: 28,138 × 2
   gene    hsapiens_homolog_associated_gene_name
   <chr>   <chr>
 1 Asl     ASL
 2 Apod    APOD
 3 Cyp2d22 CYP2D6
 4 Klk6    KLK6
 5 Fcrls   FCRL2
 6 Slc2a4  SLC2A4
 7 Exd2    EXD2
 8 Gjc2    GJC2
 9 Plp1    PLP1
10 Gnb4    GNB4
# ℹ 28,128 more rows
Pipes
Et si vous vouliez sélectionner et filtrer simultanément ? Il existe trois façons d’y parvenir : utiliser des étapes intermédiaires, des fonctions imbriquées ou des pipes.
Avec des étapes intermédiaires, vous créez un tableau de données temporaire et vous l’utilisez comme entrée pour la fonction suivante, comme ceci :
R
rna2 <- filter(rna, sex == "Male")
rna3 <- select(rna2, gene, sample, tissue, expression)
rna3
OUTPUT
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rows
C’est lisible, mais cela peut encombrer votre espace de travail avec de nombreux objets intermédiaires que vous devez nommer individuellement. Avec plusieurs étapes, cela peut s’avérer difficile à suivre.
Vous pouvez également imbriquer des fonctions (c’est-à-dire une fonction à l’intérieur d’une autre), comme ceci :
R
rna3 <- select(filter(rna, sex == "Male"), gene, sample, tissue, expression)
rna3
OUTPUT
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rows
C’est pratique, mais cela peut s’avérer difficile à lire si trop de fonctions sont imbriquées, car R évalue l’expression de l’intérieur vers l’extérieur (dans ce cas, le filtrage, puis la sélection).
La dernière option, les pipes, est un ajout récent à R. Les pipes permettent de prendre la sortie d’une fonction et de la transmettre directement à la suivante, ce qui est utile lorsque l’on doit effectuer plusieurs opérations sur le même jeu de données.
Les pipes dans R ressemblent à %>% (disponible via le
package magrittr) ou à |>
(via R de base). Si vous utilisez RStudio, vous pouvez saisir le pipe
avec Ctrl + Shift + M si vous avez un
PC, ou Cmd + Shift + M si vous avez un
Mac.
Dans le code ci-dessus, nous utilisons le pipe pour envoyer d’abord
le jeu de données rna via filter() afin de
conserver les lignes où sex est Male, puis via
select() pour ne conserver que les colonnes
gene, sample, tissue et
expression.
Le pipe |> prend l’objet à sa gauche et le transmet
directement comme premier argument à la fonction à sa droite ; nous
n’avons plus besoin d’inclure explicitement le tableau de données comme
argument des fonctions filter() et
select().
R
rna |>
  filter(sex == "Male") |>
  select(gene, sample, tissue, expression)
OUTPUT
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rows
Certains trouvent utile de lire le pipe comme le mot « puis ». Par
exemple, dans l’exemple ci-dessus, nous avons pris le tableau de données
rna, puis filtré avec filter les
lignes contenant sex == "Male", puis sélectionné
avec select les colonnes gene,
sample, tissue et expression.
Les fonctions dplyr sont en soi assez
simples, mais en les combinant dans des flux de travail linéaires à
l’aide du pipe, nous pouvons effectuer des manipulations plus complexes
de tableaux de données.
Si nous souhaitons créer un nouvel objet avec cette version réduite des données, nous pouvons lui attribuer un nouveau nom :
R
rna3 <- rna |>
  filter(sex == "Male") |>
  select(gene, sample, tissue, expression)

rna3
OUTPUT
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rowsDéfi :
À l’aide de pipes, sélectionnez les données rna pour
conserver les observations de souris femelles au temps 0, pour
lesquelles l’expression du gène est supérieure à 50000, et ne conservez
que les colonnes gene, sample,
time, expression et age.
R
rna |>
  filter(expression > 50000,
         sex == "Female",
         time == 0 ) |>
  select(gene, sample, time, expression, age)
OUTPUT
# A tibble: 9 × 5
  gene   sample      time expression   age
  <chr>  <chr>      <dbl>      <dbl> <dbl>
1 Plp1   GSM2545337     0     101241     8
2 Atp1b1 GSM2545337     0      53260     8
3 Plp1   GSM2545338     0      96534     8
4 Atp1b1 GSM2545338     0      50614     8
5 Plp1   GSM2545348     0     102790     8
6 Atp1b1 GSM2545348     0      59544     8
7 Plp1   GSM2545353     0      71237     8
8 Glul   GSM2545353     0      52451     8
9 Atp1b1 GSM2545353     0      61451     8
Créer ou modifier des colonnes (mutate)
Il vous arrivera souvent de vouloir créer de nouvelles colonnes à
partir des valeurs de colonnes existantes, par exemple pour effectuer
des conversions d’unités ou pour déterminer le rapport entre des valeurs
dans deux colonnes. Pour ce faire, nous utiliserons
mutate().
Pour créer une nouvelle colonne de temps en heures :
R
rna |>
  mutate(time_hours = time * 24) |>
  select(time, time_hours)
OUTPUT
# A tibble: 32,428 × 2
    time time_hours
   <dbl>      <dbl>
 1     8        192
 2     8        192
 3     8        192
 4     8        192
 5     8        192
 6     8        192
 7     8        192
 8     8        192
 9     8        192
10     8        192
# ℹ 32,418 more rows
Vous pouvez également créer une deuxième nouvelle colonne en fonction
de la première nouvelle colonne au sein d’un même appel à
mutate() :
R
rna |>
  mutate(time_hours = time * 24,
         time_mn = time_hours * 60) |>
  select(time, time_hours, time_mn)
OUTPUT
# A tibble: 32,428 × 3
    time time_hours time_mn
   <dbl>      <dbl>   <dbl>
 1     8        192   11520
 2     8        192   11520
 3     8        192   11520
 4     8        192   11520
 5     8        192   11520
 6     8        192   11520
 7     8        192   11520
 8     8        192   11520
 9     8        192   11520
10     8        192   11520
# ℹ 32,418 more rowsDéfi
Créez un nouveau tableau de données à partir des données
rna qui répond aux critères suivants : il ne doit contenir
que les colonnes gene, chromosome_name,
phenotype_description, sample et
expression. Les valeurs d’expression doivent être
transformées par logarithme. Ce tableau de données ne doit contenir que
des gènes situés sur les chromosomes sexuels, associés à un
phenotype_description et présentant une expression logarithmique
supérieure à 5.
Indice : réfléchissez à l’ordre des commandes pour générer ce tableau de données !
R
rna |>
  mutate(expression = log(expression)) |>
  select(gene, chromosome_name, phenotype_description, sample, expression) |>
  filter(chromosome_name == "X" | chromosome_name == "Y") |>
  filter(!is.na(phenotype_description)) |>
  filter(expression > 5)
OUTPUT
# A tibble: 649 × 5
   gene   chromosome_name phenotype_description                sample expression
   <chr>  <chr>           <chr>                                <chr>       <dbl>
 1 Plp1   X               abnormal CNS glial cell morphology   GSM25…      10.7
 2 Slc7a3 X               decreased body length                GSM25…       5.46
 3 Plxnb3 X               abnormal coat appearance             GSM25…       6.58
 4 Rbm3   X               abnormal liver morphology            GSM25…       9.32
 5 Cfp    X               abnormal cardiovascular system phys… GSM25…       6.18
 6 Ebp    X               abnormal embryonic erythrocyte morp… GSM25…       6.68
 7 Cd99l2 X               abnormal cellular extravasation      GSM25…       8.04
 8 Piga   X               abnormal brain development           GSM25…       6.06
 9 Pim2   X               decreased T cell proliferation       GSM25…       7.11
10 Itm2a  X               no abnormal phenotype detected       GSM25…       7.48
# ℹ 639 more rows
Analyse de données selon le principe « séparer, appliquer, combiner »
De nombreuses tâches d’analyse de données peuvent être abordées selon
le paradigme split-apply-combine : diviser les données en
groupes, appliquer une analyse à chaque groupe, puis combiner les
résultats. dplyr rend cela très simple
grâce à l’utilisation de la fonction group_by().
R
rna |>
  group_by(gene)
OUTPUT
# A tibble: 32,428 × 19
# Groups:   gene [1,474]
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…       1170 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 Apod    GSM254…      36194 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 3 Cyp2d22 GSM254…       4060 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 4 Klk6    GSM254…        287 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 5 Fcrls   GSM254…         85 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 6 Slc2a4  GSM254…        782 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 7 Exd2    GSM254…       1619 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 Gjc2    GSM254…        288 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 9 Plp1    GSM254…      43217 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
10 Gnb4    GSM254…       1071 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
La fonction group_by() n’effectue aucun traitement des
données ; elle les regroupe en sous-ensembles : dans l’exemple
ci-dessus, notre tibble initial de 32428 observations est
divisé en 1474 groupes en fonction de la variable gene.
Nous pourrions également décider de regrouper le tibble selon les échantillons :
R
rna |>
  group_by(sample)
OUTPUT
# A tibble: 32,428 × 19
# Groups:   sample [22]
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…       1170 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 Apod    GSM254…      36194 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 3 Cyp2d22 GSM254…       4060 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 4 Klk6    GSM254…        287 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 5 Fcrls   GSM254…         85 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 6 Slc2a4  GSM254…        782 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 7 Exd2    GSM254…       1619 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 Gjc2    GSM254…        288 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 9 Plp1    GSM254…      43217 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
10 Gnb4    GSM254…       1071 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
Ici, notre ensemble initial tibble de 32428 observations
est divisé en 22 groupes en fonction de la variable
sample.
Une fois les données regroupées, les opérations suivantes s’appliqueront indépendamment à chaque groupe.
La fonction summarise()
group_by() est souvent utilisé avec
summarise(), lequel condense chaque groupe en un résumé à
une seule ligne pour ce groupe.
group_by() prend en arguments les noms de colonnes
contenant les variables catégorielles pour lesquelles
vous souhaitez calculer les statistiques de synthèse. Ainsi, pour
calculer la moyenne expression par gène :
R
rna |>
  group_by(gene) |>
  summarise(mean_expression = mean(expression))
OUTPUT
# A tibble: 1,474 × 2
   gene     mean_expression
   <chr>              <dbl>
 1 AI504432         1053.
 2 AW046200          131.
 3 AW551984          295.
 4 Aamp             4751.
 5 Abca12              4.55
 6 Abcc8            2498.
 7 Abhd14a           525.
 8 Abi2             4909.
 9 Abi3bp           1002.
10 Abl2             2124.
# ℹ 1,464 more rows
Nous pourrions également vouloir calculer les niveaux d’expression moyens de tous les gènes dans chaque échantillon :
R
rna |>
  group_by(sample) |>
  summarise(mean_expression = mean(expression))
OUTPUT
# A tibble: 22 × 2
   sample     mean_expression
   <chr>                <dbl>
 1 GSM2545336           2062.
 2 GSM2545337           1766.
 3 GSM2545338           1668.
 4 GSM2545339           1696.
 5 GSM2545340           1682.
 6 GSM2545341           1638.
 7 GSM2545342           1594.
 8 GSM2545343           2107.
 9 GSM2545344           1712.
10 GSM2545345           1700.
# ℹ 12 more rows
Mais nous pouvons également regrouper par plusieurs colonnes :
R
rna |>
  group_by(gene, infection, time) |>
  summarise(mean_expression = mean(expression))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, infection, and time.
ℹ Output is grouped by gene and infection.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, infection, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 4,422 × 4
# Groups:   gene, infection [2,948]
   gene     infection    time mean_expression
   <chr>    <chr>       <dbl>           <dbl>
 1 AI504432 InfluenzaA      4           1104.
 2 AI504432 InfluenzaA      8           1014
 3 AI504432 NonInfected     0           1034.
 4 AW046200 InfluenzaA      4            152.
 5 AW046200 InfluenzaA      8             81
 6 AW046200 NonInfected     0            155.
 7 AW551984 InfluenzaA      4            302.
 8 AW551984 InfluenzaA      8            342.
 9 AW551984 NonInfected     0            238
10 Aamp     InfluenzaA      4           4870
# ℹ 4,412 more rows
Une fois les données regroupées, vous pouvez également résumer
plusieurs variables simultanément (et pas nécessairement sur la même
variable). Par exemple, nous pourrions ajouter une colonne indiquant la
médiane de expression par gène et par condition :
R
rna |>
  group_by(gene, infection, time) |>
  summarise(mean_expression = mean(expression),
            median_expression = median(expression))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, infection, and time.
ℹ Output is grouped by gene and infection.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, infection, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 4,422 × 5
# Groups:   gene, infection [2,948]
   gene     infection    time mean_expression median_expression
   <chr>    <chr>       <dbl>           <dbl>             <dbl>
 1 AI504432 InfluenzaA      4           1104.             1094.
 2 AI504432 InfluenzaA      8           1014               985
 3 AI504432 NonInfected     0           1034.             1016
 4 AW046200 InfluenzaA      4            152.              144.
 5 AW046200 InfluenzaA      8             81                82
 6 AW046200 NonInfected     0            155.              163
 7 AW551984 InfluenzaA      4            302.              245
 8 AW551984 InfluenzaA      8            342.              287
 9 AW551984 NonInfected     0            238               265
10 Aamp     InfluenzaA      4           4870              4708
# ℹ 4,412 more rowsDéfi
Calculez le niveau d’expression moyen du gène « Dok3 » par points temporels.
R
rna |>
  filter(gene == "Dok3") |>
  group_by(time) |>
  summarise(mean = mean(expression))
OUTPUT
# A tibble: 3 × 2
   time  mean
  <dbl> <dbl>
1     0  169
2     4  156.
3     8   61
Comptage
Lors du travail avec des données, nous souhaitons souvent connaître
le nombre d’observations pour chaque facteur ou combinaison de facteurs.
Pour cette tâche, dplyr propose
count(). Par exemple, si nous voulions compter le nombre de
lignes de données pour chaque échantillon infecté et non infecté, nous
procéderions comme suit :
R
rna |>
    count(infection)
OUTPUT
# A tibble: 2 × 2
  infection       n
  <chr>       <int>
1 InfluenzaA  22110
2 NonInfected 10318
La fonction count() est une abréviation de ce que nous
avons déjà vu : regrouper par variable, puis résumer en comptant le
nombre d’observations dans ce groupe. En d’autres termes,
rna |> count(infection) équivaut à :
R
rna |>
    group_by(infection) |>
    summarise(n = n())
OUTPUT
# A tibble: 2 × 2
  infection       n
  <chr>       <int>
1 InfluenzaA  22110
2 NonInfected 10318
L’exemple précédent montre l’utilisation de count() pour
compter le nombre de lignes/observations pour un facteur
(c’est-à-dire infection). Si nous voulions compter une
combinaison de facteurs, telle que infection et
time, nous spécifierions le premier et le second facteur
comme arguments de count() :
R
rna |>
    count(infection, time)
OUTPUT
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      4 11792
2 InfluenzaA      8 10318
3 NonInfected     0 10318
ce qui équivaut à ceci :
R
rna |>
  group_by(infection, time) |>
  summarise(n = n())
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by infection and time.
ℹ Output is grouped by infection.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(infection, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 3 × 3
# Groups:   infection [2]
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      4 11792
2 InfluenzaA      8 10318
3 NonInfected     0 10318
Il est parfois utile de trier le résultat pour faciliter les
comparaisons. Nous pouvons utiliser arrange() pour trier le
tableau. Par exemple, nous pourrions vouloir classer le tableau
ci-dessus par temps :
R
rna |>
  count(infection, time) |>
  arrange(time)
OUTPUT
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 NonInfected     0 10318
2 InfluenzaA      4 11792
3 InfluenzaA      8 10318
ou par nombres :
R
rna |>
  count(infection, time) |>
  arrange(n)
OUTPUT
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      8 10318
2 NonInfected     0 10318
3 InfluenzaA      4 11792
Pour trier par ordre décroissant, nous devons ajouter la fonction
desc() :
R
rna |>
  count(infection, time) |>
  arrange(desc(n))
OUTPUT
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      4 11792
2 InfluenzaA      8 10318
3 NonInfected 0 10318Défi
- Combien de gènes ont été analysés dans chaque échantillon ?
- Utilisez
group_by()etsummarise()pour évaluer la profondeur de séquençage (la somme de tous les comptages) dans chaque échantillon. Quel échantillon présente la profondeur de séquençage la plus élevée ? - Choisissez un échantillon et évaluez le nombre de gènes par biotype.
- Identifiez les gènes associés à la description du phénotype « abnormal DNA methylation », et calculez leur expression moyenne (en log) aux moments 0, 4 et 8.
R
## 1.
rna |>
  count(sample)
OUTPUT
# A tibble: 22 × 2
   sample         n
   <chr>      <int>
 1 GSM2545336  1474
 2 GSM2545337  1474
 3 GSM2545338  1474
 4 GSM2545339  1474
 5 GSM2545340  1474
 6 GSM2545341  1474
 7 GSM2545342  1474
 8 GSM2545343  1474
 9 GSM2545344  1474
10 GSM2545345  1474
# ℹ 12 more rows
R
## 2.
rna |>
  group_by(sample) |>
  summarise(seq_depth = sum(expression)) |>
  arrange(desc(seq_depth))
OUTPUT
# A tibble: 22 × 2
   sample     seq_depth
   <chr>          <dbl>
 1 GSM2545350   3255566
 2 GSM2545352   3216163
 3 GSM2545343   3105652
 4 GSM2545336   3039671
 5 GSM2545380   3036098
 6 GSM2545353   2953249
 7 GSM2545348   2913678
 8 GSM2545362   2913517
 9 GSM2545351   2782464
10 GSM2545349   2758006
# ℹ 12 more rows
R
## 3.
rna |>
  filter(sample == "GSM2545336") |>
  count(gene_biotype) |>
  arrange(desc(n))
OUTPUT
# A tibble: 13 × 2
   gene_biotype                           n
   <chr>                              <int>
 1 protein_coding                      1321
 2 lncRNA                                69
 3 processed_pseudogene                  59
 4 miRNA                                  7
 5 snoRNA                                 5
 6 TEC                                    4
 7 polymorphic_pseudogene                 2
 8 unprocessed_pseudogene                 2
 9 IG_C_gene                              1
10 scaRNA                                 1
11 transcribed_processed_pseudogene       1
12 transcribed_unitary_pseudogene         1
13 transcribed_unprocessed_pseudogene     1
R
## 4.
rna |>
  filter(phenotype_description == "abnormal DNA methylation") |>
  group_by(gene, time) |>
  summarise(mean_expression = mean(log(expression))) |>
  arrange()
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 6 × 3
# Groups:   gene [2]
  gene   time mean_expression
  <chr> <dbl>           <dbl>
1 Xist      0            6.95
2 Xist      4            6.34
3 Xist      8            7.13
4 Zdbf2     0            6.27
5 Zdbf2     4            6.27
6 Zdbf2     8            6.19
Restructuration des données
Dans le tableau rna, les lignes contiennent des valeurs
d’expression (l’unité) associées à une combinaison de 2 autres variables
: gene et sample.
Toutes les autres colonnes correspondent à des variables décrivant soit l’échantillon (organisme, âge, sexe, …), soit le gène (gene_biotype, ENTREZ_ID, product, …). Les variables qui ne varient pas selon les gènes ou les échantillons auront la même valeur dans toutes les lignes.
R
rna |>
  arrange(gene)
OUTPUT
# A tibble: 32,428 × 19
   gene     sample expression organism   age sex   infection strain  time tissue
   <chr>    <chr>       <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 AI504432 GSM25…       1230 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 AI504432 GSM25…       1085 Mus mus…     8 Fema… NonInfec… C57BL…     0 Cereb…
 3 AI504432 GSM25…        969 Mus mus…     8 Fema… NonInfec… C57BL…     0 Cereb…
 4 AI504432 GSM25…       1284 Mus mus…     8 Fema… Influenz… C57BL…     4 Cereb…
 5 AI504432 GSM25…        966 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 6 AI504432 GSM25…        918 Mus mus…     8 Male  Influenz… C57BL…     8 Cereb…
 7 AI504432 GSM25…        985 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 AI504432 GSM25…        972 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 9 AI504432 GSM25…       1000 Mus mus…     8 Fema… Influenz… C57BL…     4 Cereb…
10 AI504432 GSM25…        816 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
Cette structure est appelée long-format, car une seule
colonne contient toutes les valeurs, et une ou plusieurs autres colonnes
décrivent le contexte de chaque valeur.
Dans certains cas, le long-format n’est pas vraiment «
lisible par l’humain », et un autre format, le wide-format,
est préféré, car il permet de représenter les données de manière plus
compacte. C’est généralement le cas pour les valeurs d’expression
génique, que les scientifiques ont l’habitude de consulter sous forme de
matrices, où les lignes représentent les gènes et les colonnes les
échantillons.
Dans ce format, il deviendrait donc simple d’explorer la relation entre les niveaux d’expression génique au sein des échantillons, ainsi qu’entre eux.
OUTPUT
# A tibble: 1,474 × 23
   gene    GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
   <chr>        <dbl>      <dbl>      <dbl>      <dbl>      <dbl>      <dbl>
 1 Asl           1170        361        400        586        626        988
 2 Apod         36194      10347       9173      10620      13021      29594
 3 Cyp2d22       4060       1616       1603       1901       2171       3349
 4 Klk6           287        629        641        578        448        195
 5 Fcrls           85        233        244        237        180         38
 6 Slc2a4         782        231        248        265        313        786
 7 Exd2          1619       2288       2235       2513       2366       1359
 8 Gjc2           288        595        568        551        310        146
 9 Plp1         43217     101241      96534      58354      53126      27173
10 Gnb4          1071       1791       1867       1430       1355        798
# ℹ 1,464 more rows
# ℹ 16 more variables: GSM2545342 <dbl>, GSM2545343 <dbl>, GSM2545344 <dbl>,
#   GSM2545345 <dbl>, GSM2545346 <dbl>, GSM2545347 <dbl>, GSM2545348 <dbl>,
#   GSM2545349 <dbl>, GSM2545350 <dbl>, GSM2545351 <dbl>, GSM2545352 <dbl>,
#   GSM2545353 <dbl>, GSM2545354 <dbl>, GSM2545362 <dbl>, GSM2545363 <dbl>,
#   GSM2545380 <dbl>
Pour convertir les valeurs d’expression génique de rna
en format large, nous devons créer un nouveau tableau où les valeurs de
la colonne sample deviendraient les noms des variables de
colonne.
Le point clé ici est que nous suivons toujours une structure de données ordonnée, mais que nous avons reformaté les données en fonction des observations d’intérêt : les niveaux d’expression par gène, au lieu de les enregistrer par gène et par échantillon.
La transformation inverse consisterait à transformer les noms de colonnes en valeurs d’une nouvelle variable.
Nous pouvons effectuer ces deux transformations à l’aide de deux
fonctions tidyr, pivot_longer() et
pivot_wider() (voir l’article sur les pivots sur le
site web de tidyr pour plus de détails).
Conversion des données vers un format plus large
Sélectionnons les 3 premières colonnes de rna et
utilisons pivot_wider() pour transformer les données en
format large.
R
rna_exp <- rna |>
  select(gene, sample, expression)
rna_exp
OUTPUT
# A tibble: 32,428 × 3
   gene    sample     expression
   <chr>   <chr>           <dbl>
 1 Asl     GSM2545336       1170
 2 Apod    GSM2545336      36194
 3 Cyp2d22 GSM2545336       4060
 4 Klk6    GSM2545336        287
 5 Fcrls   GSM2545336         85
 6 Slc2a4  GSM2545336        782
 7 Exd2    GSM2545336       1619
 8 Gjc2    GSM2545336        288
 9 Plp1    GSM2545336      43217
10 Gnb4    GSM2545336       1071
# ℹ 32,418 more rows
pivot_wider prend trois arguments principaux :
- les données à transformer ;
- le
names_from: la colonne dont les valeurs deviendront de nouveaux noms de colonnes ; - le
values_from: la colonne dont les valeurs rempliront les nouvelles colonnes.
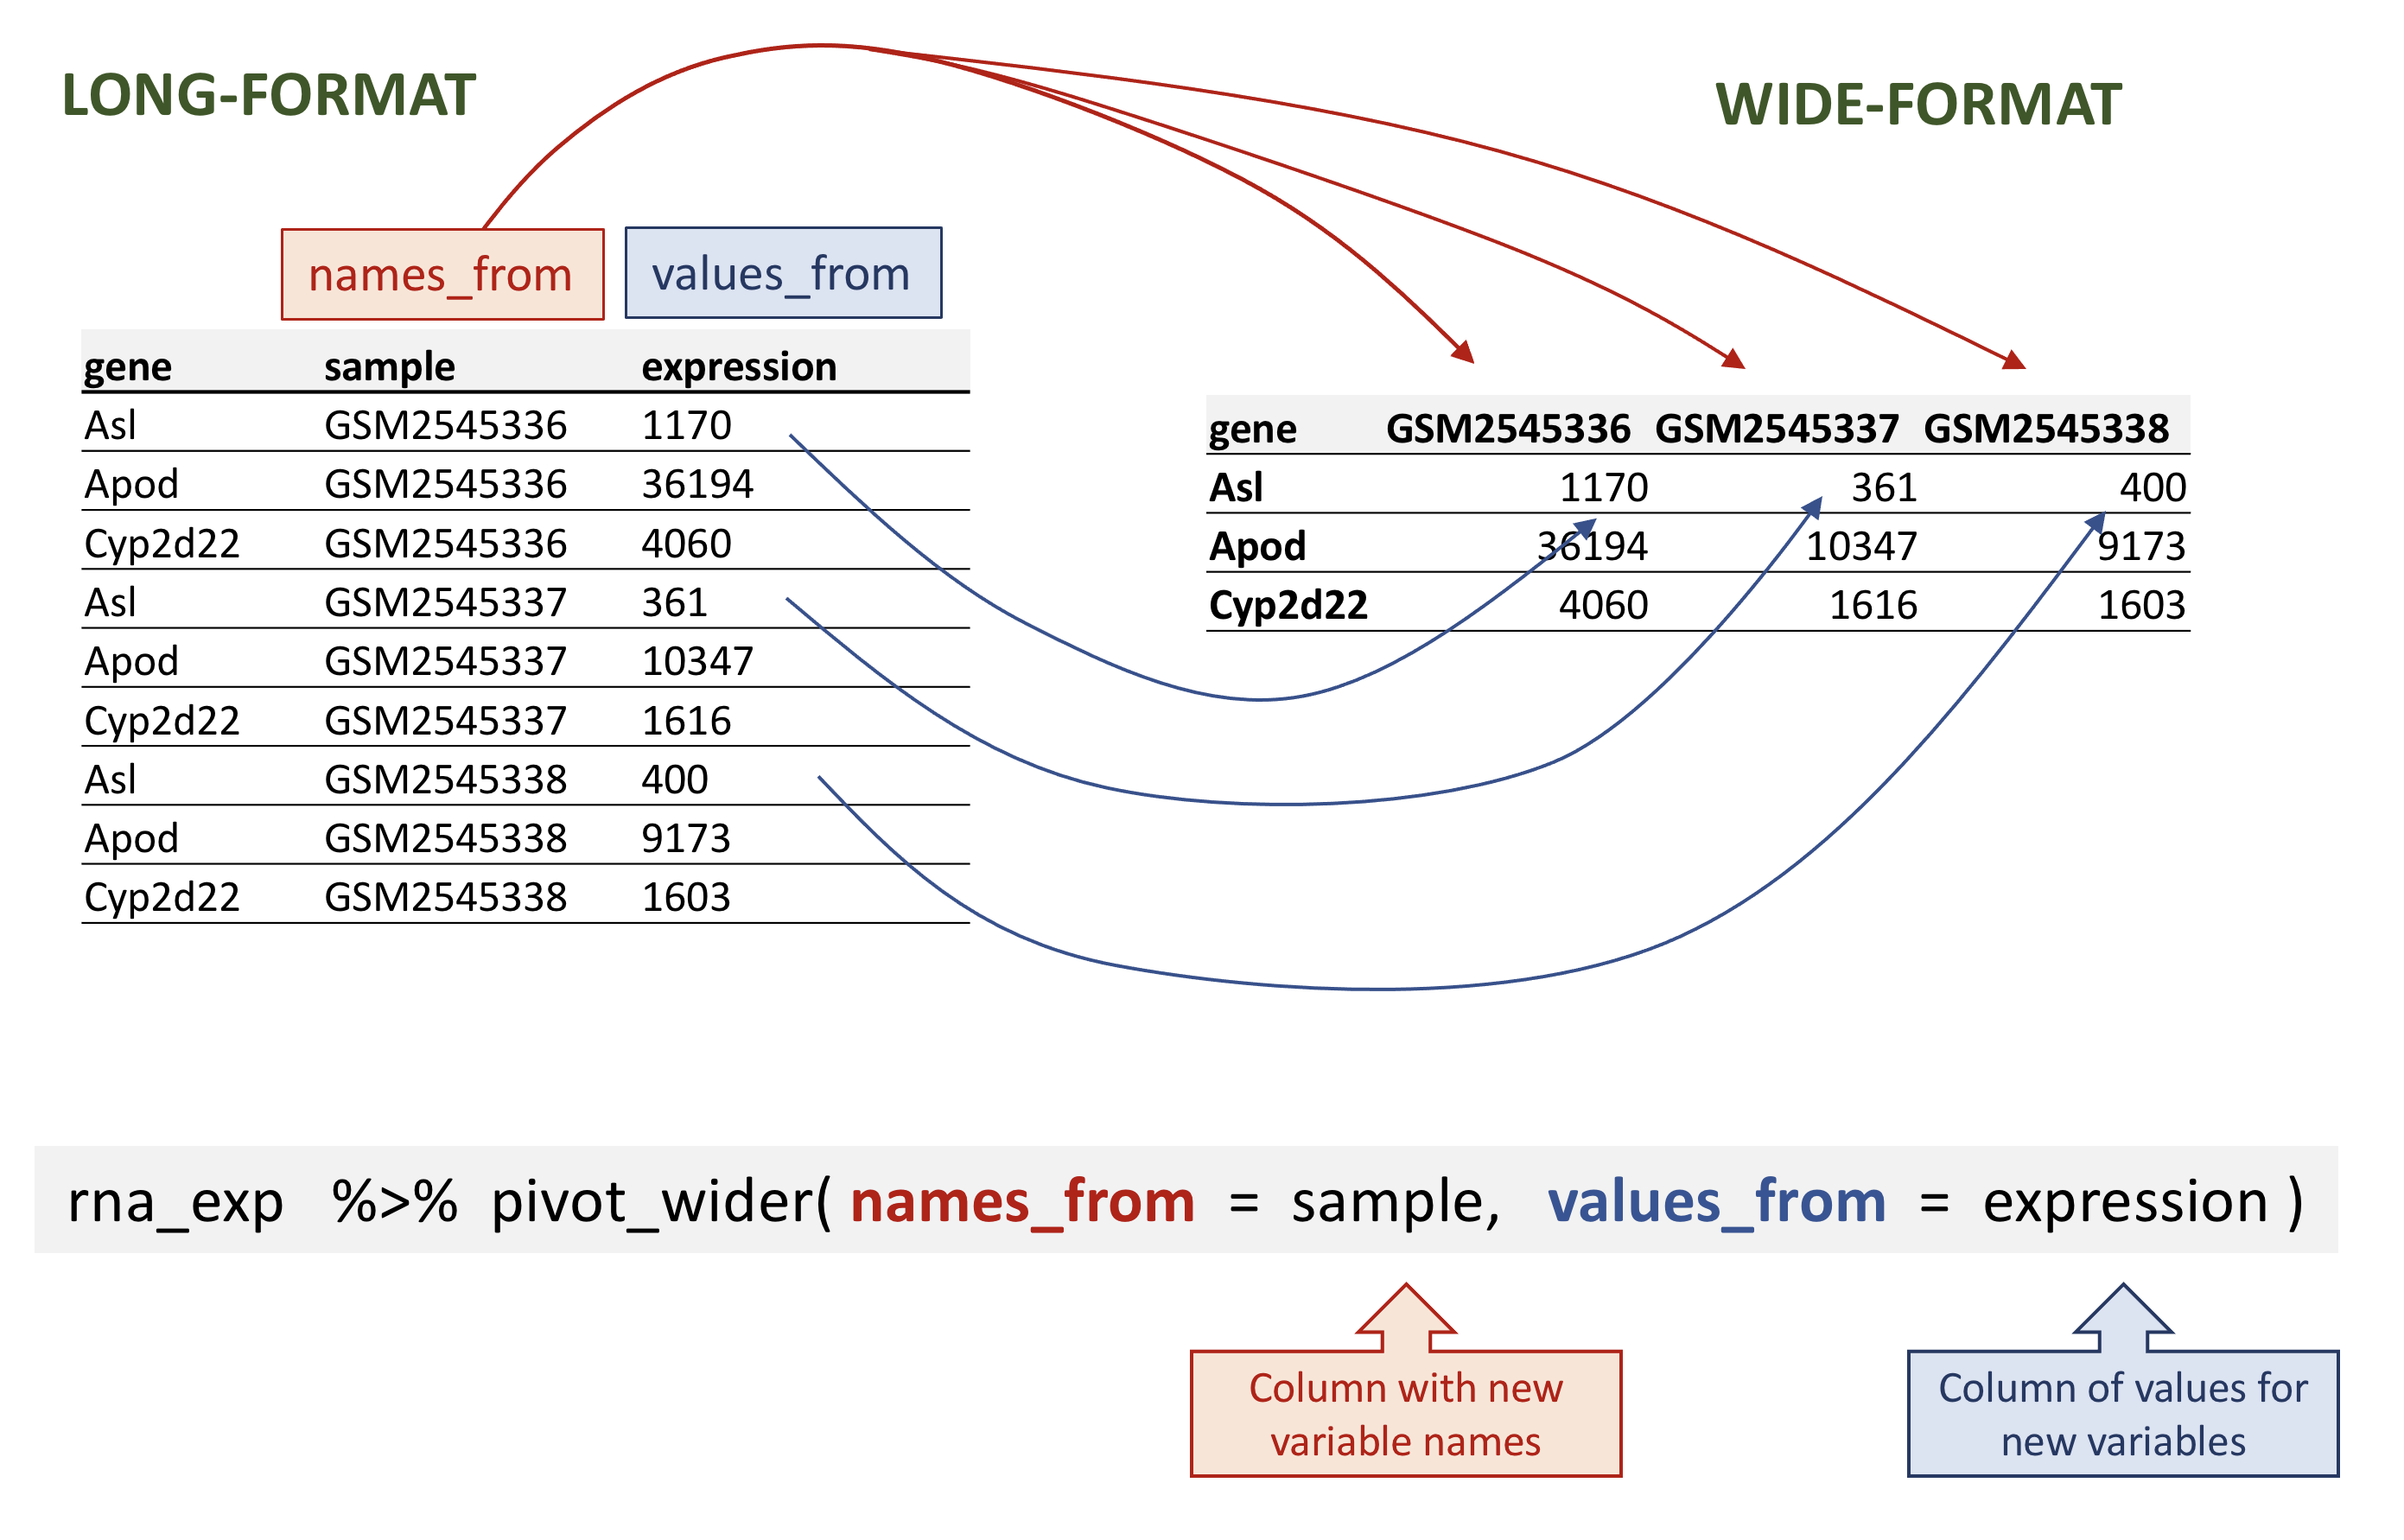
rna data.
R
rna_wide <- rna_exp |>
  pivot_wider(names_from = sample,
              values_from = expression)
rna_wide
OUTPUT
# A tibble: 1,474 × 23
   gene    GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
   <chr>        <dbl>      <dbl>      <dbl>      <dbl>      <dbl>      <dbl>
 1 Asl           1170        361        400        586        626        988
 2 Apod         36194      10347       9173      10620      13021      29594
 3 Cyp2d22       4060       1616       1603       1901       2171       3349
 4 Klk6           287        629        641        578        448        195
 5 Fcrls           85        233        244        237        180         38
 6 Slc2a4         782        231        248        265        313        786
 7 Exd2          1619       2288       2235       2513       2366       1359
 8 Gjc2           288        595        568        551        310        146
 9 Plp1         43217     101241      96534      58354      53126      27173
10 Gnb4          1071       1791       1867       1430       1355        798
# ℹ 1,464 more rows
# ℹ 16 more variables: GSM2545342 <dbl>, GSM2545343 <dbl>, GSM2545344 <dbl>,
#   GSM2545345 <dbl>, GSM2545346 <dbl>, GSM2545347 <dbl>, GSM2545348 <dbl>,
#   GSM2545349 <dbl>, GSM2545350 <dbl>, GSM2545351 <dbl>, GSM2545352 <dbl>,
#   GSM2545353 <dbl>, GSM2545354 <dbl>, GSM2545362 <dbl>, GSM2545363 <dbl>,
#   GSM2545380 <dbl>
Notez que, par défaut, la fonction pivot_wider()
ajoutera NA pour les valeurs manquantes.
Imaginons que, pour une raison quelconque, nous ayons des valeurs d’expression manquantes pour certains gènes dans certains échantillons. Dans l’exemple fictif suivant, le gène Cyp2d22 ne possède qu’une seule valeur d’expression, dans l’échantillon GSM2545338.
R
rna_with_missing_values <- rna |>
  select(gene, sample, expression) |>
  filter(gene %in% c("Asl", "Apod", "Cyp2d22")) |>
  filter(sample %in% c("GSM2545336", "GSM2545337", "GSM2545338")) |>
  arrange(sample) |>
  filter(!(gene == "Cyp2d22" & sample != "GSM2545338"))
rna_with_missing_values
OUTPUT
# A tibble: 7 × 3
  gene    sample     expression
  <chr>   <chr>           <dbl>
1 Asl     GSM2545336       1170
2 Apod    GSM2545336      36194
3 Asl     GSM2545337        361
4 Apod    GSM2545337      10347
5 Asl     GSM2545338        400
6 Apod    GSM2545338       9173
7 Cyp2d22 GSM2545338       1603
Par défaut, la fonction pivot_wider() ajoute
NA pour les valeurs manquantes. Cela peut être paramétré
via l’argument values_fill de la fonction
pivot_wider().
R
rna_with_missing_values |>
  pivot_wider(names_from = sample,
              values_from = expression)
OUTPUT
# A tibble: 3 × 4
  gene    GSM2545336 GSM2545337 GSM2545338
  <chr>        <dbl>      <dbl>      <dbl>
1 Asl           1170        361        400
2 Apod         36194      10347       9173
3 Cyp2d22         NA         NA       1603
R
rna_with_missing_values |>
  pivot_wider(names_from = sample,
              values_from = expression,
              values_fill = 0)
OUTPUT
# A tibble: 3 × 4
  gene    GSM2545336 GSM2545337 GSM2545338
  <chr>        <dbl>      <dbl>      <dbl>
1 Asl           1170        361        400
2 Apod         36194      10347       9173
3 Cyp2d22          0          0       1603
Conversion des données vers un format plus long
Dans le cas inverse, nous utilisons les noms de colonnes pour les transformer en une paire de nouvelles variables. L’une des variables représente les noms de colonnes sous forme de valeurs, et l’autre contient les valeurs précédemment associées aux noms de colonnes.
pivot_longer() prend quatre arguments principaux :
- les données à transformer ;
- le
names_to: le nouveau nom de colonne que nous souhaitons créer et remplir avec les noms actuels des colonnes ; - le
values_to: le nouveau nom de colonne que nous souhaitons créer et remplir avec les valeurs actuelles ; - les noms des colonnes à utiliser pour remplir les variables
names_toetvalues_to(ou à supprimer).
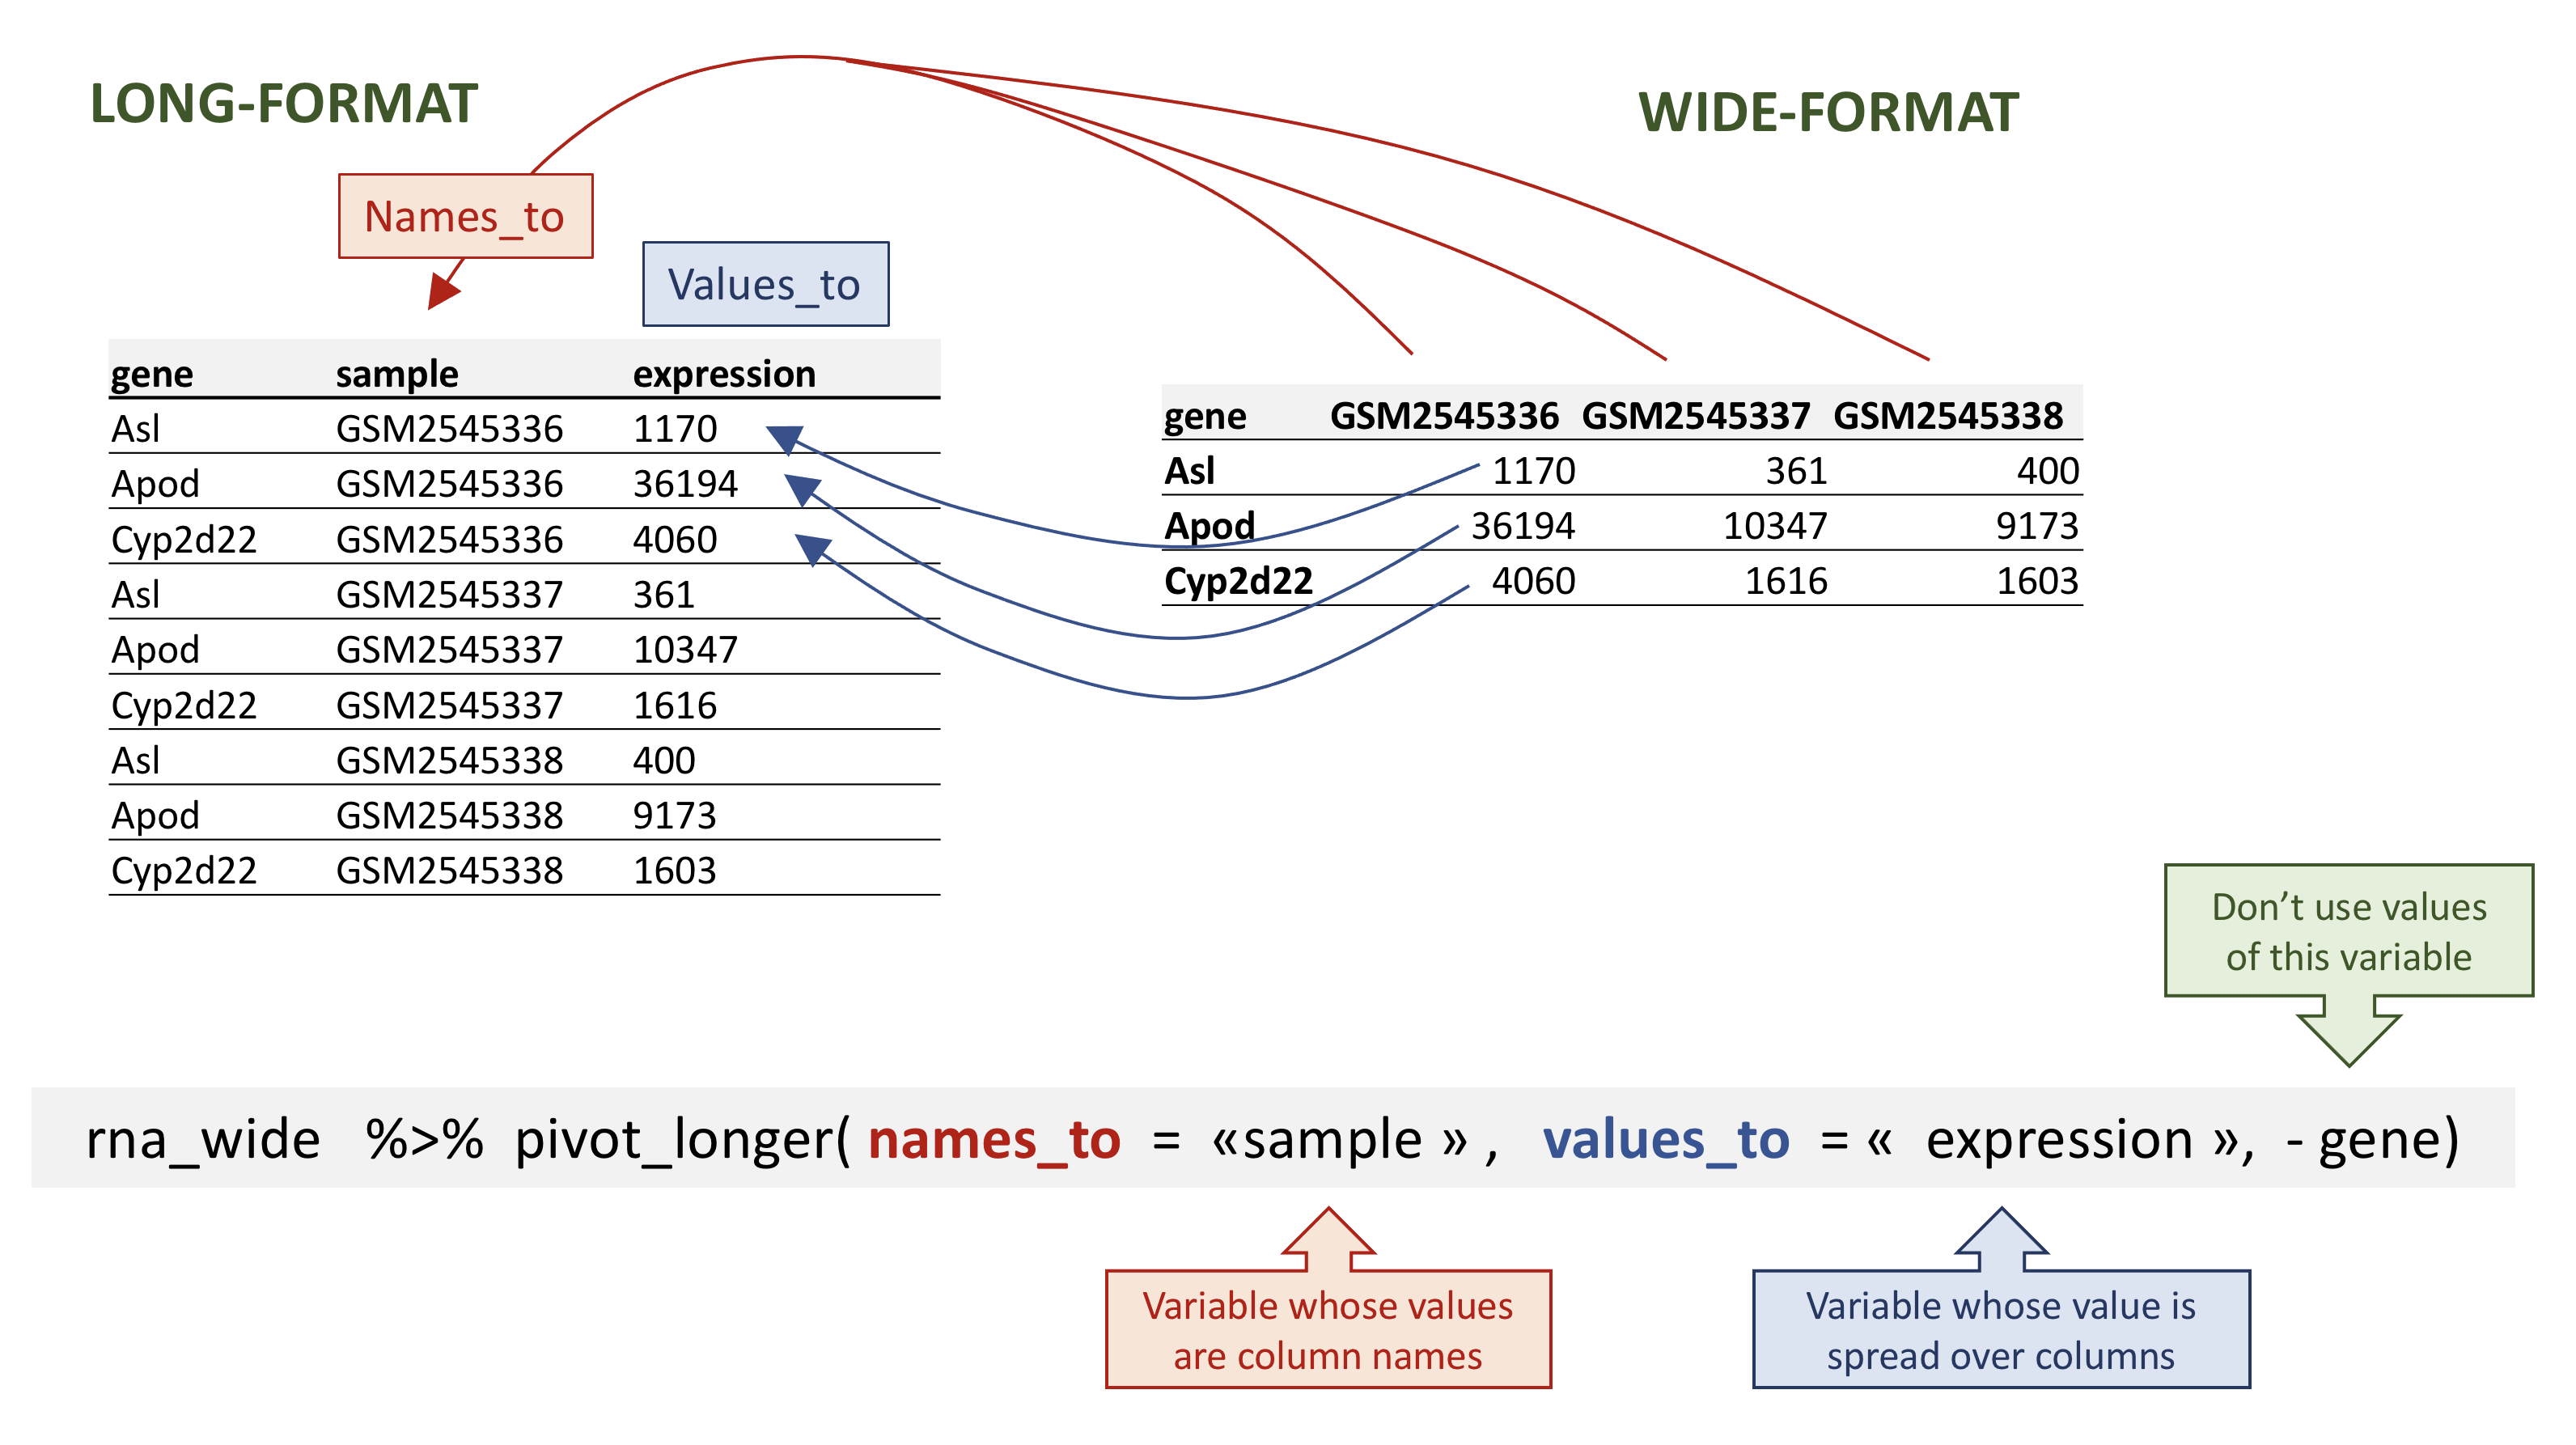
rna data.
Pour recréer rna_long à partir de rna_wide,
nous créerions une clé appelée sample et une valeur appelée
expression, et utiliserions toutes les colonnes sauf
gene pour la variable clé. Ici, nous supprimons la colonne
gene avec un signe moins.
Notez comment les nouveaux noms de variables doivent être entourés de guillemets ici.
R
rna_long <- rna_wide |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 -gene)
rna_long
OUTPUT
# A tibble: 32,428 × 3
   gene  sample     expression
   <chr> <chr>           <dbl>
 1 Asl   GSM2545336       1170
 2 Asl   GSM2545337        361
 3 Asl   GSM2545338        400
 4 Asl   GSM2545339        586
 5 Asl   GSM2545340        626
 6 Asl   GSM2545341        988
 7 Asl   GSM2545342        836
 8 Asl   GSM2545343        535
 9 Asl   GSM2545344        586
10 Asl   GSM2545345        597
# ℹ 32,418 more rows
Nous aurions également pu utiliser une spécification pour déterminer
les colonnes à inclure. Cela peut s’avérer utile si vous disposez d’un
grand nombre de colonnes d’identification, et il est plus simple de
spécifier ce qu’il faut récupérer que ce qu’il faut laisser de côté.
Ici, la fonction starts_with() peut aider à récupérer les
noms d’échantillons sans avoir à tous les énumérer ! Une autre
possibilité serait d’utiliser l’opérateur : !
R
rna_wide |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 cols = starts_with("GSM"))
OUTPUT
# A tibble: 32,428 × 3
   gene  sample     expression
   <chr> <chr>           <dbl>
 1 Asl   GSM2545336       1170
 2 Asl   GSM2545337        361
 3 Asl   GSM2545338        400
 4 Asl   GSM2545339        586
 5 Asl   GSM2545340        626
 6 Asl   GSM2545341        988
 7 Asl   GSM2545342        836
 8 Asl   GSM2545343        535
 9 Asl   GSM2545344        586
10 Asl   GSM2545345        597
# ℹ 32,418 more rows
R
rna_wide |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 GSM2545336:GSM2545380)
OUTPUT
# A tibble: 32,428 × 3
   gene  sample     expression
   <chr> <chr>           <dbl>
 1 Asl   GSM2545336       1170
 2 Asl   GSM2545337        361
 3 Asl   GSM2545338        400
 4 Asl   GSM2545339        586
 5 Asl   GSM2545340        626
 6 Asl   GSM2545341        988
 7 Asl   GSM2545342        836
 8 Asl   GSM2545343        535
 9 Asl   GSM2545344        586
10 Asl   GSM2545345        597
# ℹ 32,418 more rows
Notez que si nous avions des valeurs manquantes dans le format large,
le NA serait inclus dans le nouveau format long.
Rappelons notre tibble fictif précédent contenant des valeurs manquantes :
R
rna_with_missing_values
OUTPUT
# A tibble: 7 × 3
  gene    sample     expression
  <chr>   <chr>           <dbl>
1 Asl     GSM2545336       1170
2 Apod    GSM2545336      36194
3 Asl     GSM2545337        361
4 Apod    GSM2545337      10347
5 Asl     GSM2545338        400
6 Apod    GSM2545338       9173
7 Cyp2d22 GSM2545338       1603
R
wide_with_NA <- rna_with_missing_values |>
  pivot_wider(names_from = sample,
              values_from = expression)
wide_with_NA
OUTPUT
# A tibble: 3 × 4
  gene    GSM2545336 GSM2545337 GSM2545338
  <chr>        <dbl>      <dbl>      <dbl>
1 Asl           1170        361        400
2 Apod         36194      10347       9173
3 Cyp2d22         NA         NA       1603
R
wide_with_NA |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 -gene)
OUTPUT
# A tibble: 9 × 3
  gene    sample     expression
  <chr>   <chr>           <dbl>
1 Asl     GSM2545336       1170
2 Asl     GSM2545337        361
3 Asl     GSM2545338        400
4 Apod    GSM2545336      36194
5 Apod    GSM2545337      10347
6 Apod    GSM2545338       9173
7 Cyp2d22 GSM2545336         NA
8 Cyp2d22 GSM2545337         NA
9 Cyp2d22 GSM2545338       1603
Le passage aux formats large et long peut être un moyen utile d’équilibrer un jeu de données afin que chaque réplicat ait la même composition.
Question
À partir du tableau rna, utilisez la fonction
pivot_wider() pour créer un tableau au format large
présentant les niveaux d’expression génique dans chaque souris. Ensuite,
utilisez la fonction pivot_longer() pour restaurer un
tableau au format long.
R
rna1 <- rna |>
select(gene, mouse, expression) |>
pivot_wider(names_from = mouse, values_from = expression)
rna1
OUTPUT
# A tibble: 1,474 × 23
   gene     `14`    `9`  `10`  `15`  `18`   `6`   `5`  `11`  `22`  `13`  `23`
   <chr>   <dbl>  <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
 1 Asl      1170    361   400   586   626   988   836   535   586   597   938
 2 Apod    36194  10347  9173 10620 13021 29594 24959 13668 13230 15868 27769
 3 Cyp2d22  4060   1616  1603  1901  2171  3349  3122  2008  2254  2277  2985
 4 Klk6      287    629   641   578   448   195   186  1101   537   567   327
 5 Fcrls      85    233   244   237   180    38    68   375   199   177    89
 6 Slc2a4    782    231   248   265   313   786   528   249   266   357   654
 7 Exd2     1619   2288  2235  2513  2366  1359  1474  3126  2379  2173  1531
 8 Gjc2      288    595   568   551   310   146   186   791   454   370   240
 9 Plp1    43217 101241 96534 58354 53126 27173 28728 98658 61356 61647 38019
10 Gnb4     1071   1791  1867  1430  1355   798   806  2437  1394  1554   960
# ℹ 1,464 more rows
# ℹ 11 more variables: `24` <dbl>, `8` <dbl>, `7` <dbl>, `1` <dbl>, `16` <dbl>,
#   `21` <dbl>, `4` <dbl>, `2` <dbl>, `20` <dbl>, `12` <dbl>, `19` <dbl>
R
rna1 |>
pivot_longer(names_to = "mouse_id", values_to = "counts", -gene)
OUTPUT
# A tibble: 32,428 × 3
   gene  mouse_id counts
   <chr> <chr>     <dbl>
 1 Asl   14         1170
 2 Asl   9           361
 3 Asl   10          400
 4 Asl   15          586
 5 Asl   18          626
 6 Asl   6           988
 7 Asl   5           836
 8 Asl   11          535
 9 Asl   22          586
10 Asl   13          597
# ℹ 32,418 more rowsQuestion
Extrayez les gènes situés sur les chromosomes X et Y du tableau de
données rna et étalez le tableau de données avec
sex comme colonnes, chromosome_name comme
lignes, et la moyenne de l’expression des gènes situés sur chaque
chromosome comme valeurs, comme dans le tibble suivant :
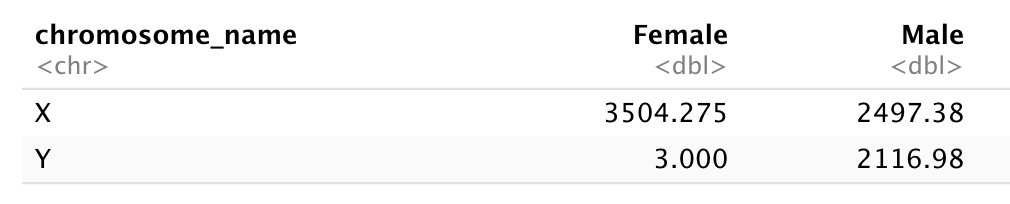
Vous devrez effectuer un résumé avant de restructurer !
Calculons d’abord le niveau d’expression moyen des gènes liés aux chromosomes X et Y dans les échantillons provenant de souris mâles et femelles…
R
 rna |>
  filter(chromosome_name == "Y" | chromosome_name == "X") |>
  group_by(sex, chromosome_name) |>
  summarise(mean = mean(expression))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by sex and chromosome_name.
ℹ Output is grouped by sex.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(sex, chromosome_name))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 4 × 3
# Groups:   sex [2]
  sex    chromosome_name  mean
  <chr>  <chr>           <dbl>
1 Female X               3504.
2 Female Y                  3
3 Male   X               2497.
4 Male   Y               2117.
Et pivoter la table au format large
R
rna_1 <- rna |>
  filter(chromosome_name == "Y" | chromosome_name == "X") |>
  group_by(sex, chromosome_name) |>
  summarise(mean = mean(expression)) |>
  pivot_wider(names_from = sex,
              values_from = mean)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by sex and chromosome_name.
ℹ Output is grouped by sex.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(sex, chromosome_name))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
rna_1
OUTPUT
# A tibble: 2 × 3
  chromosome_name Female  Male
  <chr>            <dbl> <dbl>
1 X                3504. 2497.
2 Y                   3  2117.
Prenez maintenant ce tableau de données et transformez-le avec
pivot_longer() afin que chaque ligne représente une
combinaison unique chromosome_name par
gender.
R
rna_1 |>
  pivot_longer(names_to = "gender",
               values_to = "mean",
               -chromosome_name)
OUTPUT
# A tibble: 4 × 3
  chromosome_name gender  mean
  <chr>           <chr>  <dbl>
1 X               Female 3504.
2 X               Male   2497.
3 Y               Female    3
4 Y Male 2117.Question
Utilisez le jeu de données rna pour créer une matrice
d’expression où chaque ligne représente les niveaux d’expression moyens
des gènes et chaque colonne représente les différents moments
temporels.
Calculons d’abord l’expression moyenne par gène et par moment
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 4,422 × 3
# Groups:   gene [1,474]
   gene      time mean_exp
   <chr>    <dbl>    <dbl>
 1 AI504432     0    1034.
 2 AI504432     4    1104.
 3 AI504432     8    1014
 4 AW046200     0     155.
 5 AW046200     4     152.
 6 AW046200     8      81
 7 AW551984     0     238
 8 AW551984     4     302.
 9 AW551984     8     342.
10 Aamp         0    4603.
# ℹ 4,412 more rows
avant d’utiliser la fonction pivot_wider()
R
rna_time <- rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
rna_time
OUTPUT
# A tibble: 1,474 × 4
# Groups:   gene [1,474]
   gene         `0`     `4`     `8`
   <chr>      <dbl>   <dbl>   <dbl>
 1 AI504432 1034.   1104.   1014
 2 AW046200  155.    152.     81
 3 AW551984  238     302.    342.
 4 Aamp     4603.   4870    4763.
 5 Abca12      5.29    4.25    4.14
 6 Abcc8    2576.   2609.   2292.
 7 Abhd14a   591.    547.    432.
 8 Abi2     4881.   4903.   4945.
 9 Abi3bp   1175.   1061.    762.
10 Abl2     2170.   2078.   2131.
# ℹ 1,464 more rows
Notez que cela génère un tibble dont certains noms de colonnes commencent par un chiffre. Si nous voulions sélectionner la colonne correspondant aux temps, nous ne pourrions pas utiliser les noms de colonnes directement… Que se passe-t-il lorsque nous sélectionnons la colonne 4 ?
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  select(gene, 4)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 1,474 × 2
# Groups:   gene [1,474]
   gene         `8`
   <chr>      <dbl>
 1 AI504432 1014
 2 AW046200   81
 3 AW551984  342.
 4 Aamp     4763.
 5 Abca12      4.14
 6 Abcc8    2292.
 7 Abhd14a   432.
 8 Abi2     4945.
 9 Abi3bp    762.
10 Abl2     2131.
# ℹ 1,464 more rows
Pour sélectionner le temps 4, nous devrions entourer le nom de la colonne d’accents graves « ` ».
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  select(gene, `4`)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 1,474 × 2
# Groups:   gene [1,474]
   gene         `4`
   <chr>      <dbl>
 1 AI504432 1104.
 2 AW046200  152.
 3 AW551984  302.
 4 Aamp     4870
 5 Abca12      4.25
 6 Abcc8    2609.
 7 Abhd14a   547.
 8 Abi2     4903.
 9 Abi3bp   1061.
10 Abl2     2078.
# ℹ 1,464 more rows
Une autre possibilité consisterait à renommer la colonne, en choisissant un nom qui ne commence pas par un chiffre :
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  rename("time0" = `0`, "time4" = `4`, "time8" = `8`) |>
  select(gene, time4)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 1,474 × 2
# Groups:   gene [1,474]
   gene       time4
   <chr>      <dbl>
 1 AI504432 1104.
 2 AW046200  152.
 3 AW551984  302.
 4 Aamp     4870
 5 Abca12      4.25
 6 Abcc8    2609.
 7 Abhd14a   547.
 8 Abi2     4903.
 9 Abi3bp   1061.
10 Abl2     2078.
# ℹ 1,464 more rowsQuestion
Utilisez le tableau de données précédent contenant les niveaux d’expression moyens par temps et créez une nouvelle colonne contenant les rapports d’expression (fold changes) entre le temps 8 et le temps 0, ainsi qu’entre le temps 8 et le temps 4. Convertissez ce tableau au format long en rassemblant les rapports d’expression calculés.
À partir du tibble rna_time :
R
rna_time
OUTPUT
# A tibble: 1,474 × 4
# Groups:   gene [1,474]
   gene         `0`     `4`     `8`
   <chr>      <dbl>   <dbl>   <dbl>
 1 AI504432 1034.   1104.   1014
 2 AW046200  155.    152.     81
 3 AW551984  238     302.    342.
 4 Aamp     4603.   4870    4763.
 5 Abca12      5.29    4.25    4.14
 6 Abcc8    2576.   2609.   2292.
 7 Abhd14a   591.    547.    432.
 8 Abi2     4881.   4903.   4945.
 9 Abi3bp   1175.   1061.    762.
10 Abl2     2170.   2078.   2131.
# ℹ 1,464 more rows
Calculez les rapports d’expression (fold changes) :
R
rna_time |>
  mutate(time_8_vs_0 = `8` / `0`, time_8_vs_4 = `8` / `4`)
OUTPUT
# A tibble: 1,474 × 6
# Groups:   gene [1,474]
   gene         `0`     `4`     `8` time_8_vs_0 time_8_vs_4
   <chr>      <dbl>   <dbl>   <dbl>       <dbl>       <dbl>
 1 AI504432 1034.   1104.   1014          0.981       0.918
 2 AW046200  155.    152.     81          0.522       0.532
 3 AW551984  238     302.    342.         1.44        1.13
 4 Aamp     4603.   4870    4763.         1.03        0.978
 5 Abca12      5.29    4.25    4.14       0.784       0.975
 6 Abcc8    2576.   2609.   2292.         0.889       0.878
 7 Abhd14a   591.    547.    432.         0.731       0.791
 8 Abi2     4881.   4903.   4945.         1.01        1.01
 9 Abi3bp   1175.   1061.    762.         0.649       0.719
10 Abl2     2170.   2078.   2131.         0.982       1.03
# ℹ 1,464 more rows
Et utilisez la fonction pivot_longer() :
R
rna_time |>
  mutate(time_8_vs_0 = `8` / `0`, time_8_vs_4 = `8` / `4`) |>
  pivot_longer(names_to = "comparisons",
               values_to = "Fold_changes",
               time_8_vs_0:time_8_vs_4)
OUTPUT
# A tibble: 2,948 × 6
# Groups:   gene [1,474]
   gene         `0`     `4`     `8` comparisons Fold_changes
   <chr>      <dbl>   <dbl>   <dbl> <chr>              <dbl>
 1 AI504432 1034.   1104.   1014    time_8_vs_0        0.981
 2 AI504432 1034.   1104.   1014    time_8_vs_4        0.918
 3 AW046200  155.    152.     81    time_8_vs_0        0.522
 4 AW046200  155.    152.     81    time_8_vs_4        0.532
 5 AW551984  238     302.    342.   time_8_vs_0        1.44
 6 AW551984  238     302.    342.   time_8_vs_4        1.13
 7 Aamp     4603.   4870    4763.   time_8_vs_0        1.03
 8 Aamp     4603.   4870    4763.   time_8_vs_4        0.978
 9 Abca12      5.29    4.25    4.14 time_8_vs_0        0.784
10 Abca12      5.29    4.25    4.14 time_8_vs_4        0.975
# ℹ 2,938 more rows
Jointure de tableaux
Dans de nombreuses situations concrètes, les données sont réparties sur plusieurs tables. Cela se produit généralement parce que différents types d’informations sont recueillis à partir de sources distinctes.
Pour certaines analyses, il peut être souhaitable de combiner les données de deux tables ou plus dans un seul tableau de données, en s’appuyant sur une colonne commune à toutes les tables.
Le package dplyr propose un ensemble de fonctions de
jointure permettant de combiner deux tableaux de données en fonction de
correspondances dans des colonnes spécifiées. Nous présentons ici une
brève introduction aux jointures. Pour en savoir plus, veuillez vous
référer au chapitre sur les jointures
de tableaux. La fiche
pratique sur la transformation des données propose également un bref
aperçu des jointures de tableaux.
Nous allons illustrer la jointure à l’aide d’un petit tableau,
rna_mini, que nous créerons en extrayant un sous-ensemble
du tableau d’origine rna, en ne gardant que 3 colonnes et
10 lignes.
R
rna_mini <- rna |>
   select(gene, sample, expression) |>
   head(10)
rna_mini
OUTPUT
# A tibble: 10 × 3
   gene    sample     expression
   <chr>   <chr>           <dbl>
 1 Asl     GSM2545336       1170
 2 Apod    GSM2545336      36194
 3 Cyp2d22 GSM2545336       4060
 4 Klk6    GSM2545336        287
 5 Fcrls   GSM2545336         85
 6 Slc2a4  GSM2545336        782
 7 Exd2    GSM2545336       1619
 8 Gjc2    GSM2545336        288
 9 Plp1    GSM2545336      43217
10 Gnb4    GSM2545336       1071
La deuxième table, annot1, contient 2 colonnes, gene et
gene_description. Vous pouvez soit télécharger
annot1.csv en cliquant sur le lien puis en le déplaçant dans le
dossier data/, soit utiliser le code R ci-dessous pour le
télécharger directement dans le dossier.
R
download.file(url = "https://carpentries-incubator.github.io/bioc-intro/data/annot1.csv",
              destfile = "data/annot1.csv")
annot1 <- read_csv(file = "data/annot1.csv")
annot1
OUTPUT
# A tibble: 10 × 2
   gene    gene_description
   <chr>   <chr>
 1 Cyp2d22 cytochrome P450, family 2, subfamily d, polypeptide 22 [Source:MGI S…
 2 Klk6    kallikrein related-peptidase 6 [Source:MGI Symbol;Acc:MGI:1343166]
 3 Fcrls   Fc receptor-like S, scavenger receptor [Source:MGI Symbol;Acc:MGI:19…
 4 Plp1    proteolipid protein (myelin) 1 [Source:MGI Symbol;Acc:MGI:97623]
 5 Exd2    exonuclease 3'-5' domain containing 2 [Source:MGI Symbol;Acc:MGI:192…
 6 Apod    apolipoprotein D [Source:MGI Symbol;Acc:MGI:88056]
 7 Gnb4    guanine nucleotide binding protein (G protein), beta 4 [Source:MGI S…
 8 Slc2a4  solute carrier family 2 (facilitated glucose transporter), member 4 …
 9 Asl     argininosuccinate lyase [Source:MGI Symbol;Acc:MGI:88084]
10 Gjc2    gap junction protein, gamma 2 [Source:MGI Symbol;Acc:MGI:2153060]
Nous souhaitons maintenant joindre ces deux tables en une seule
contenant toutes les variables à l’aide de la fonction
full_join() du package dplyr. La fonction
trouvera automatiquement la variable commune pour faire correspondre les
colonnes de la première et de la seconde table. Dans ce cas,
gene est la variable commune. De telles variables sont
appelées clés. Les clés sont utilisées pour faire correspondre des
observations à travers différentes tables.
R
full_join(rna_mini, annot1)
OUTPUT
Joining with `by = join_by(gene)`OUTPUT
# A tibble: 10 × 4
   gene    sample     expression gene_description
   <chr>   <chr>           <dbl> <chr>
 1 Asl     GSM2545336       1170 argininosuccinate lyase [Source:MGI Symbol;Acc…
 2 Apod    GSM2545336      36194 apolipoprotein D [Source:MGI Symbol;Acc:MGI:88…
 3 Cyp2d22 GSM2545336       4060 cytochrome P450, family 2, subfamily d, polype…
 4 Klk6    GSM2545336        287 kallikrein related-peptidase 6 [Source:MGI Sym…
 5 Fcrls   GSM2545336         85 Fc receptor-like S, scavenger receptor [Source…
 6 Slc2a4  GSM2545336        782 solute carrier family 2 (facilitated glucose t…
 7 Exd2    GSM2545336       1619 exonuclease 3'-5' domain containing 2 [Source:…
 8 Gjc2    GSM2545336        288 gap junction protein, gamma 2 [Source:MGI Symb…
 9 Plp1    GSM2545336      43217 proteolipid protein (myelin) 1 [Source:MGI Sym…
10 Gnb4    GSM2545336       1071 guanine nucleotide binding protein (G protein)…
En pratique, les annotations géniques sont parfois étiquetées de manière différente.
Le tableau annot2 est exactement identique au tableau
annot1, sauf que la variable contenant les noms de gènes
est nommée différemment. Encore une fois, vous pouvez soit télécharger
annot2.csv vous-même et le déplacer dans data/, soit
utiliser le code R ci-dessous.
R
download.file(url = "https://carpentries-incubator.github.io/bioc-intro/data/annot2.csv",
              destfile = "data/annot2.csv")
annot2 <- read_csv(file = "data/annot2.csv")
annot2
OUTPUT
# A tibble: 10 × 2
   external_gene_name description
   <chr>              <chr>
 1 Cyp2d22            cytochrome P450, family 2, subfamily d, polypeptide 22 [S…
 2 Klk6               kallikrein related-peptidase 6 [Source:MGI Symbol;Acc:MGI…
 3 Fcrls              Fc receptor-like S, scavenger receptor [Source:MGI Symbol…
 4 Plp1               proteolipid protein (myelin) 1 [Source:MGI Symbol;Acc:MGI…
 5 Exd2               exonuclease 3'-5' domain containing 2 [Source:MGI Symbol;…
 6 Apod               apolipoprotein D [Source:MGI Symbol;Acc:MGI:88056]
 7 Gnb4               guanine nucleotide binding protein (G protein), beta 4 [S…
 8 Slc2a4             solute carrier family 2 (facilitated glucose transporter)…
 9 Asl                argininosuccinate lyase [Source:MGI Symbol;Acc:MGI:88084]
10 Gjc2               gap junction protein, gamma 2 [Source:MGI Symbol;Acc:MGI:…
Si aucun des noms de variables ne correspond, nous pouvons définir
manuellement les variables à utiliser pour le rapprochement. Ces
variables peuvent être définies à l’aide de l’argument by,
comme illustré ci-dessous avec les tables rna_mini et
annot2.
R
full_join(rna_mini, annot2, by = c("gene" = "external_gene_name"))
OUTPUT
# A tibble: 10 × 4
   gene    sample     expression description
   <chr>   <chr>           <dbl> <chr>
 1 Asl     GSM2545336       1170 argininosuccinate lyase [Source:MGI Symbol;Acc…
 2 Apod    GSM2545336      36194 apolipoprotein D [Source:MGI Symbol;Acc:MGI:88…
 3 Cyp2d22 GSM2545336       4060 cytochrome P450, family 2, subfamily d, polype…
 4 Klk6    GSM2545336        287 kallikrein related-peptidase 6 [Source:MGI Sym…
 5 Fcrls   GSM2545336         85 Fc receptor-like S, scavenger receptor [Source…
 6 Slc2a4  GSM2545336        782 solute carrier family 2 (facilitated glucose t…
 7 Exd2    GSM2545336       1619 exonuclease 3'-5' domain containing 2 [Source:…
 8 Gjc2    GSM2545336        288 gap junction protein, gamma 2 [Source:MGI Symb…
 9 Plp1    GSM2545336      43217 proteolipid protein (myelin) 1 [Source:MGI Sym…
10 Gnb4    GSM2545336       1071 guanine nucleotide binding protein (G protein)…
Comme on peut le voir ci-dessus, le nom de la variable de la première table est conservé dans celle qui a été jointe.
Défi :
Téléchargez le tableau annot3 en cliquant
sur ce lien et placez le tableau dans votre répertoire data/. À
l’aide de la fonction full_join(), joignez les tableaux
rna_mini et annot3. Qu’est-il arrivé aux gènes
Klk6, mt-Tf, mt-Rnr1, mt-Tv,
mt-Rnr2 et mt-Tl1 ?
R
annot3 <- read_csv("data/annot3.csv")
full_join(rna_mini, annot3)
OUTPUT
# A tibble: 15 × 4
   gene    sample     expression gene_description
   <chr>   <chr>           <dbl> <chr>
 1 Asl     GSM2545336       1170 argininosuccinate lyase [Source:MGI Symbol;Acc…
 2 Apod    GSM2545336      36194 apolipoprotein D [Source:MGI Symbol;Acc:MGI:88…
 3 Cyp2d22 GSM2545336       4060 cytochrome P450, family 2, subfamily d, polype…
 4 Klk6    GSM2545336        287 <NA>
 5 Fcrls   GSM2545336         85 Fc receptor-like S, scavenger receptor [Source…
 6 Slc2a4  GSM2545336        782 solute carrier family 2 (facilitated glucose t…
 7 Exd2    GSM2545336       1619 exonuclease 3'-5' domain containing 2 [Source:…
 8 Gjc2    GSM2545336        288 gap junction protein, gamma 2 [Source:MGI Symb…
 9 Plp1    GSM2545336      43217 proteolipid protein (myelin) 1 [Source:MGI Sym…
10 Gnb4    GSM2545336       1071 guanine nucleotide binding protein (G protein)…
11 mt-Tf   <NA>               NA mitochondrially encoded tRNA phenylalanine [So…
12 mt-Rnr1 <NA>               NA mitochondrially encoded 12S rRNA [Source:MGI S…
13 mt-Tv   <NA>               NA mitochondrially encoded tRNA valine [Source:MG…
14 mt-Rnr2 <NA>               NA mitochondrially encoded 16S rRNA [Source:MGI S…
15 mt-Tl1  <NA>               NA mitochondrially encoded tRNA leucine 1 [Source…
Le gène Klk6 n’est présent que dans rna_mini,
tandis que les gènes mt-Tf, mt-Rnr1, mt-Tv,
mt-Rnr2 et mt-Tl1 ne figurent que dans le tableau
annot3. Leurs valeurs respectives pour les variables du
tableau ont été codées comme manquantes.
Exportation de données
Maintenant que vous avez appris à utiliser dplyr pour
extraire des informations de vos données brutes ou les résumer, vous
souhaiterez peut-être exporter ces nouveaux jeux de données pour les
partager avec vos collaborateurs ou pour les archiver.
À l’instar de la fonction read_csv() utilisée pour lire
des fichiers CSV dans R, il existe une fonction write_csv()
qui génère des fichiers CSV à partir de tableaux de données.
Avant d’utiliser write_csv(), nous allons créer un
nouveau dossier, data_output, dans notre répertoire de
travail pour y stocker cet ensemble de données généré. Nous ne voulons
pas écrire les ensembles de données générés dans le même répertoire que
nos données brutes. Il est bon de les garder séparés. Le dossier
data ne doit contenir que les données brutes et non
modifiées, et doit rester intouché pour s’assurer que nous ne le
supprimons ni ne le modifions. En revanche, notre script générera le
contenu du répertoire data_output, de sorte que même si les
fichiers qu’il contient sont supprimés, nous pourrons toujours les
régénérer.
Utilisons write_csv() pour enregistrer le tableau
rna_wide que nous avons créé précédemment.
R
write_csv(rna_wide, file = "data_output/rna_wide.csv")
- Données tabulaires en R à l’aide du méta-package tidyverse