
Prochaines étapes
Last updated on 2026-11-07 | Edit this page
Estimated time: 90 minutes
Overview
Questions
- Qu’est-ce qu’un
SummarizedExperiment? - Qu’est-ce que Bioconductor ?
Objectives
- Présentez le projet Bioconductor.
- Présenter la notion de conteneurs de données.
- Présentez un aperçu du
SummarizedExperiment, largement utilisé dans les analyses omiques.
Prochaines étapes
Les données en bioinformatique sont souvent complexes. Pour y remédier, les développeurs définissent des conteneurs de données spécialisés (appelés classes) qui correspondent aux propriétés des données qu’ils doivent traiter.
Cet aspect est central pour le projet Bioconductor1, qui utilise la même infrastructure de données de base à travers ses différents packages. Cela a certainement contribué au succès de Bioconductor. Les développeurs de packages Bioconductor sont invités à utiliser l’infrastructure existante afin d’assurer la cohérence, l’interopérabilité et la stabilité du projet dans son ensemble.
Pour illustrer un tel conteneur de données omiques, nous présenterons
la classe SummarizedExperiment.
SummarizedExperiment
La figure ci-dessous représente l’architecture de la classe SummarizedExperiment.

Les objets de la classe SummarizedExperiment contiennent :
Un ou plusieurs tableaux de mesures (assays) contenant les données omiques quantitatives (données d’expression), stockées sous la forme d’un objet de type matrice. Les caractéristiques mesurées (gènes, transcrits, protéines, etc.) correspondent aux lignes, et les échantillons aux colonnes.
Un emplacement (slot) de métadonnées des échantillons contenant leurs covariables, stockées sous la forme d’un tableau de données. Les lignes de ce tableau représentent les échantillons et correspondent exactement aux colonnes des données d’expression.
Un emplacement (slot) de métadonnées des caractéristiques mesurées contenant leurs covariables, stockées sous la forme d’un tableau de données. Les lignes de ce tableau correspondent exactement aux lignes des données d’expression.
La nature coordonnée de SummarizedExperiment garantit
que les dimensions des différents emplacements (slots) restent
cohérentes lors de la manipulation des données : les colonnes des
données d’expression correspondent aux lignes des métadonnées des
échantillons, tandis que les lignes des données d’expression
correspondent aux lignes des métadonnées des caractéristiques mesurées.
Par exemple, si nous excluons un échantillon du tableau de mesures, il
est automatiquement supprimé des métadonnées des échantillons lors de la
même opération.
Les slots de métadonnées peuvent accueillir des covariables (colonnes) supplémentaires sans affecter les autres structures.
Création d’un SummarizedExperiment
Afin de créer un SummarizedExperiment, nous créerons les
composants individuels, à savoir la matrice de comptage, ainsi que les
métadonnées des échantillons et des gènes à partir de fichiers CSV.
C’est généralement ainsi que les données RNA-Seq sont fournies (après
traitement des données brutes).
-
Une matrice d’expression : nous chargeons la
matrice de comptage en précisant que la première colonne contient les
noms des lignes (les gènes), puis convertissons le
data.frameenmatrix. Vous pouvez la télécharger en cliquant sur ce lien.
R
count_matrix <- read.csv("data/count_matrix.csv",
                         row.names = 1) |>
    as.matrix()

count_matrix[1:5, ]
OUTPUT
        GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
Asl           1170        361        400        586        626        988
Apod         36194      10347       9173      10620      13021      29594
Cyp2d22       4060       1616       1603       1901       2171       3349
Klk6           287        629        641        578        448        195
Fcrls           85        233        244        237        180         38
        GSM2545342 GSM2545343 GSM2545344 GSM2545345 GSM2545346 GSM2545347
Asl            836        535        586        597        938       1035
Apod         24959      13668      13230      15868      27769      34301
Cyp2d22       3122       2008       2254       2277       2985       3452
Klk6           186       1101        537        567        327        233
Fcrls           68        375        199        177         89         67
        GSM2545348 GSM2545349 GSM2545350 GSM2545351 GSM2545352 GSM2545353
Asl            494        481        666        937        803        541
Apod         11258      11812      15816      29242      20415      13682
Cyp2d22       1883       2014       2417       3678       2920       2216
Klk6           742        881        828        250        798        710
Fcrls          300        233        231         81        303        285
        GSM2545354 GSM2545362 GSM2545363 GSM2545380
Asl            473        748        576       1192
Apod         11088      15916      11166      38148
Cyp2d22       1821       2842       2011       4019
Klk6           894        501        598        259
Fcrls          248        179        184         68
R
dim(count_matrix)
OUTPUT
[1] 1474 22- Une table décrivant les échantillons, disponible à ce lien.
R
sample_metadata <- read.csv("data/sample_metadata.csv")
sample_metadata
OUTPUT
       sample     organism age    sex   infection  strain time     tissue mouse
1  GSM2545336 Mus musculus   8 Female  InfluenzaA C57BL/6    8 Cerebellum    14
2  GSM2545337 Mus musculus   8 Female NonInfected C57BL/6    0 Cerebellum     9
3  GSM2545338 Mus musculus   8 Female NonInfected C57BL/6    0 Cerebellum    10
4  GSM2545339 Mus musculus   8 Female  InfluenzaA C57BL/6    4 Cerebellum    15
5  GSM2545340 Mus musculus   8   Male  InfluenzaA C57BL/6    4 Cerebellum    18
6  GSM2545341 Mus musculus   8   Male  InfluenzaA C57BL/6    8 Cerebellum     6
7  GSM2545342 Mus musculus   8 Female  InfluenzaA C57BL/6    8 Cerebellum     5
8  GSM2545343 Mus musculus   8   Male NonInfected C57BL/6    0 Cerebellum    11
9  GSM2545344 Mus musculus   8 Female  InfluenzaA C57BL/6    4 Cerebellum    22
10 GSM2545345 Mus musculus   8   Male  InfluenzaA C57BL/6    4 Cerebellum    13
11 GSM2545346 Mus musculus   8   Male  InfluenzaA C57BL/6    8 Cerebellum    23
12 GSM2545347 Mus musculus   8   Male  InfluenzaA C57BL/6    8 Cerebellum    24
13 GSM2545348 Mus musculus   8 Female NonInfected C57BL/6    0 Cerebellum     8
14 GSM2545349 Mus musculus   8   Male NonInfected C57BL/6    0 Cerebellum     7
15 GSM2545350 Mus musculus   8   Male  InfluenzaA C57BL/6    4 Cerebellum     1
16 GSM2545351 Mus musculus   8 Female  InfluenzaA C57BL/6    8 Cerebellum    16
17 GSM2545352 Mus musculus   8 Female  InfluenzaA C57BL/6    4 Cerebellum    21
18 GSM2545353 Mus musculus   8 Female NonInfected C57BL/6    0 Cerebellum     4
19 GSM2545354 Mus musculus   8   Male NonInfected C57BL/6    0 Cerebellum     2
20 GSM2545362 Mus musculus   8 Female  InfluenzaA C57BL/6    4 Cerebellum    20
21 GSM2545363 Mus musculus   8   Male  InfluenzaA C57BL/6    4 Cerebellum    12
22 GSM2545380 Mus musculus   8 Female  InfluenzaA C57BL/6    8 Cerebellum    19
R
dim(sample_metadata)
OUTPUT
[1] 22 9- Une table décrivant les gènes, disponible à ce lien.
R
gene_metadata <- read.csv("data/gene_metadata.csv")
gene_metadata[1:10, 1:4]
OUTPUT
      gene ENTREZID
1      Asl   109900
2     Apod    11815
3  Cyp2d22    56448
4     Klk6    19144
5    Fcrls    80891
6   Slc2a4    20528
7     Exd2    97827
8     Gjc2   118454
9     Plp1    18823
10    Gnb4    14696
                                                                         product
1                                 argininosuccinate lyase, transcript variant X1
2                                         apolipoprotein D, transcript variant 3
3   cytochrome P450, family 2, subfamily d, polypeptide 22, transcript variant 2
4                           kallikrein related-peptidase 6, transcript variant 2
5                  Fc receptor-like S, scavenger receptor, transcript variant X1
6            solute carrier family 2 (facilitated glucose transporter), member 4
7                                          exonuclease 3'-5' domain containing 2
8                            gap junction protein, gamma 2, transcript variant 1
9                           proteolipid protein (myelin) 1, transcript variant 1
10 guanine nucleotide binding protein (G protein), beta 4, transcript variant X2
      ensembl_gene_id
1  ENSMUSG00000025533
2  ENSMUSG00000022548
3  ENSMUSG00000061740
4  ENSMUSG00000050063
5  ENSMUSG00000015852
6  ENSMUSG00000018566
7  ENSMUSG00000032705
8  ENSMUSG00000043448
9  ENSMUSG00000031425
10 ENSMUSG00000027669
R
dim(gene_metadata)
OUTPUT
[1] 1474 9Nous créerons un SummarizedExperiment à partir de ces
tableaux :
La matrice de comptage qui sera utilisée comme
assayLe tableau décrivant les échantillons sera utilisé comme slot métadonnées des échantillons
Le tableau décrivant les gènes sera utilisé comme slot métadonnées des caractéristiques
Pour ce faire, nous pouvons assembler les différentes parties à
l’aide du constructeur SummarizedExperiment :
R
## BiocManager::install("SummarizedExperiment")
library("SummarizedExperiment")
Tout d’abord, nous nous assurons que les échantillons sont dans le même ordre dans la matrice de comptage et l’annotation des échantillons, et de même pour les gènes dans la matrice de comptage et l’annotation des gènes.
R
stopifnot(rownames(count_matrix) == gene_metadata$gene)
stopifnot(colnames(count_matrix) == sample_metadata$sample)
R
se <- SummarizedExperiment(assays = list(counts = count_matrix),
                           colData = sample_metadata,
                           rowData = gene_metadata)
se
OUTPUT
class: SummarizedExperiment
dim: 1474 22
metadata(0):
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(9): sample organism ... tissue mouse
Sauvegarde des données
L’exportation de données vers une feuille de calcul, comme nous
l’avons fait dans un épisode précédent, présente plusieurs limites,
telles que celles décrites dans le premier chapitre : incohérences
possibles entre , et . comme séparateurs
décimaux, et absence de définition des types des variables. De plus,
l’exportation vers une feuille de calcul n’est pertinente que pour des
données rectangulaires, telles que les tableaux de données et les
matrices.
Une méthode plus générale de sauvegarde des données, spécifique à R
et garantie sur tout système d’exploitation, consiste à utiliser la
fonction saveRDS. La sauvegarde d’objets de ce type génère
une représentation binaire sur le disque (en utilisant ici l’extension
de fichier rds), laquelle peut être chargée à nouveau dans
R à l’aide de la fonction readRDS.
R
saveRDS(se, file = "data_output/se.rds")
rm(se)
se <- readRDS("data_output/se.rds")
head(se)
En conclusion, lorsqu’il s’agit de sauvegarder des données depuis R
qui seront à nouveau chargées dans R, la méthode préférée consiste à
utiliser saveRDS et readRDS. Si des données
tabulaires doivent être partagées avec quelqu’un qui n’utilise pas R,
l’exportation vers une feuille de calcul textuelle constitue une bonne
alternative.
À l’aide de cette structure de données, nous pouvons accéder à la
matrice d’expression avec la fonction assay :
R
head(assay(se))
OUTPUT
        GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
Asl           1170        361        400        586        626        988
Apod         36194      10347       9173      10620      13021      29594
Cyp2d22       4060       1616       1603       1901       2171       3349
Klk6           287        629        641        578        448        195
Fcrls           85        233        244        237        180         38
Slc2a4         782        231        248        265        313        786
        GSM2545342 GSM2545343 GSM2545344 GSM2545345 GSM2545346 GSM2545347
Asl            836        535        586        597        938       1035
Apod         24959      13668      13230      15868      27769      34301
Cyp2d22       3122       2008       2254       2277       2985       3452
Klk6           186       1101        537        567        327        233
Fcrls           68        375        199        177         89         67
Slc2a4         528        249        266        357        654        693
        GSM2545348 GSM2545349 GSM2545350 GSM2545351 GSM2545352 GSM2545353
Asl            494        481        666        937        803        541
Apod         11258      11812      15816      29242      20415      13682
Cyp2d22       1883       2014       2417       3678       2920       2216
Klk6           742        881        828        250        798        710
Fcrls          300        233        231         81        303        285
Slc2a4         271        304        349        715        513        320
        GSM2545354 GSM2545362 GSM2545363 GSM2545380
Asl            473        748        576       1192
Apod         11088      15916      11166      38148
Cyp2d22       1821       2842       2011       4019
Klk6           894        501        598        259
Fcrls          248        179        184         68
Slc2a4         248        350        317        796
R
dim(assay(se))
OUTPUT
[1] 1474 22Nous pouvons accéder aux métadonnées de l’échantillon à l’aide de la
fonction colData :
R
colData(se)
OUTPUT
DataFrame with 22 rows and 9 columns
                sample     organism       age         sex   infection
           <character>  <character> <integer> <character> <character>
GSM2545336  GSM2545336 Mus musculus         8      Female  InfluenzaA
GSM2545337  GSM2545337 Mus musculus         8      Female NonInfected
GSM2545338  GSM2545338 Mus musculus         8      Female NonInfected
GSM2545339  GSM2545339 Mus musculus         8      Female  InfluenzaA
GSM2545340  GSM2545340 Mus musculus         8        Male  InfluenzaA
...                ...          ...       ...         ...         ...
GSM2545353  GSM2545353 Mus musculus         8      Female NonInfected
GSM2545354  GSM2545354 Mus musculus         8        Male NonInfected
GSM2545362  GSM2545362 Mus musculus         8      Female  InfluenzaA
GSM2545363  GSM2545363 Mus musculus         8        Male  InfluenzaA
GSM2545380  GSM2545380 Mus musculus         8      Female  InfluenzaA
                strain      time      tissue     mouse
           <character> <integer> <character> <integer>
GSM2545336     C57BL/6         8  Cerebellum        14
GSM2545337     C57BL/6         0  Cerebellum         9
GSM2545338     C57BL/6         0  Cerebellum        10
GSM2545339     C57BL/6         4  Cerebellum        15
GSM2545340     C57BL/6         4  Cerebellum        18
...                ...       ...         ...       ...
GSM2545353     C57BL/6         0  Cerebellum         4
GSM2545354     C57BL/6         0  Cerebellum         2
GSM2545362     C57BL/6         4  Cerebellum        20
GSM2545363     C57BL/6         4  Cerebellum        12
GSM2545380     C57BL/6         8  Cerebellum        19
R
dim(colData(se))
OUTPUT
[1] 22 9Nous pouvons également accéder aux métadonnées des caractéristiques à
l’aide de la fonction rowData :
R
head(rowData(se))
OUTPUT
DataFrame with 6 rows and 9 columns
               gene  ENTREZID                product    ensembl_gene_id
        <character> <integer>            <character>        <character>
Asl             Asl    109900 argininosuccinate ly.. ENSMUSG00000025533
Apod           Apod     11815 apolipoprotein D, tr.. ENSMUSG00000022548
Cyp2d22     Cyp2d22     56448 cytochrome P450, fam.. ENSMUSG00000061740
Klk6           Klk6     19144 kallikrein related-p.. ENSMUSG00000050063
Fcrls         Fcrls     80891 Fc receptor-like S, .. ENSMUSG00000015852
Slc2a4       Slc2a4     20528 solute carrier famil.. ENSMUSG00000018566
        external_synonym chromosome_name   gene_biotype  phenotype_description
             <character>     <character>    <character>            <character>
Asl        2510006M18Rik               5 protein_coding abnormal circulating..
Apod                  NA              16 protein_coding abnormal lipid homeo..
Cyp2d22             2D22              15 protein_coding abnormal skin morpho..
Klk6                Bssp               7 protein_coding abnormal cytokine le..
Fcrls      2810439C17Rik               3 protein_coding decreased CD8-positi..
Slc2a4            Glut-4              11 protein_coding abnormal circulating..
        hsapiens_homolog_associated_gene_name
                                  <character>
Asl                                       ASL
Apod                                     APOD
Cyp2d22                                CYP2D6
Klk6                                     KLK6
Fcrls                                   FCRL2
Slc2a4                                 SLC2A4
R
dim(rowData(se))
OUTPUT
[1] 1474 9Sélection d’éléments dans un SummarizedExperiment
Comme pour les tableaux de données, on peut extraire un sous-ensemble d’un SummarizedExperiment à l’aide d’indices numériques, de chaînes de caractères ou de valeurs logiques.
Ci-dessous, nous créons une nouvelle instance de la classe SummarizedExperiment qui ne contient que les 5 premières caractéristiques pour les 3 premiers échantillons.
R
se1 <- se[1:5, 1:3]
se1
OUTPUT
class: SummarizedExperiment
dim: 5 3
metadata(0):
assays(1): counts
rownames(5): Asl Apod Cyp2d22 Klk6 Fcrls
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(3): GSM2545336 GSM2545337 GSM2545338
colData names(9): sample organism ... tissue mouse
R
colData(se1)
OUTPUT
DataFrame with 3 rows and 9 columns
                sample     organism       age         sex   infection
           <character>  <character> <integer> <character> <character>
GSM2545336  GSM2545336 Mus musculus         8      Female  InfluenzaA
GSM2545337  GSM2545337 Mus musculus         8      Female NonInfected
GSM2545338  GSM2545338 Mus musculus         8      Female NonInfected
                strain      time      tissue     mouse
           <character> <integer> <character> <integer>
GSM2545336     C57BL/6         8  Cerebellum        14
GSM2545337     C57BL/6         0  Cerebellum         9
GSM2545338     C57BL/6         0  Cerebellum        10
R
rowData(se1)
OUTPUT
DataFrame with 5 rows and 9 columns
               gene  ENTREZID                product    ensembl_gene_id
        <character> <integer>            <character>        <character>
Asl             Asl    109900 argininosuccinate ly.. ENSMUSG00000025533
Apod           Apod     11815 apolipoprotein D, tr.. ENSMUSG00000022548
Cyp2d22     Cyp2d22     56448 cytochrome P450, fam.. ENSMUSG00000061740
Klk6           Klk6     19144 kallikrein related-p.. ENSMUSG00000050063
Fcrls         Fcrls     80891 Fc receptor-like S, .. ENSMUSG00000015852
        external_synonym chromosome_name   gene_biotype  phenotype_description
             <character>     <character>    <character>            <character>
Asl        2510006M18Rik               5 protein_coding abnormal circulating..
Apod                  NA              16 protein_coding abnormal lipid homeo..
Cyp2d22             2D22              15 protein_coding abnormal skin morpho..
Klk6                Bssp               7 protein_coding abnormal cytokine le..
Fcrls      2810439C17Rik               3 protein_coding decreased CD8-positi..
        hsapiens_homolog_associated_gene_name
                                  <character>
Asl                                       ASL
Apod                                     APOD
Cyp2d22                                CYP2D6
Klk6                                     KLK6
Fcrls                                   FCRL2
Nous pouvons également utiliser la fonction colData()
pour effectuer un sous-ensemble sur des éléments des métadonnées des
échantillons, ou la fonction rowData() pour effectuer un
sous-ensemble sur des éléments des métadonnées des caractéristiques. Par
exemple, ici, nous ne conservons que les miRNAs et les échantillons non
infectés :
R
se1 <- se[rowData(se)$gene_biotype == "miRNA",
          colData(se)$infection == "NonInfected"]
se1
OUTPUT
class: SummarizedExperiment
dim: 7 7
metadata(0):
assays(1): counts
rownames(7): Mir1901 Mir378a ... Mir128-1 Mir7682
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(7): GSM2545337 GSM2545338 ... GSM2545353 GSM2545354
colData names(9): sample organism ... tissue mouse
R
assay(se1)
OUTPUT
         GSM2545337 GSM2545338 GSM2545343 GSM2545348 GSM2545349 GSM2545353
Mir1901          45         44         74         55         68         33
Mir378a          11          7          9          4         12          4
Mir133b           4          6          5          4          6          7
Mir30c-2         10          6         16         12          8         17
Mir149            1          2          0          0          0          0
Mir128-1          4          1          2          2          1          2
Mir7682           2          0          4          1          3          5
         GSM2545354
Mir1901          60
Mir378a           8
Mir133b           3
Mir30c-2         15
Mir149            2
Mir128-1          1
Mir7682           5
R
colData(se1)
OUTPUT
DataFrame with 7 rows and 9 columns
                sample     organism       age         sex   infection
           <character>  <character> <integer> <character> <character>
GSM2545337  GSM2545337 Mus musculus         8      Female NonInfected
GSM2545338  GSM2545338 Mus musculus         8      Female NonInfected
GSM2545343  GSM2545343 Mus musculus         8        Male NonInfected
GSM2545348  GSM2545348 Mus musculus         8      Female NonInfected
GSM2545349  GSM2545349 Mus musculus         8        Male NonInfected
GSM2545353  GSM2545353 Mus musculus         8      Female NonInfected
GSM2545354  GSM2545354 Mus musculus         8        Male NonInfected
                strain      time      tissue     mouse
           <character> <integer> <character> <integer>
GSM2545337     C57BL/6         0  Cerebellum         9
GSM2545338     C57BL/6         0  Cerebellum        10
GSM2545343     C57BL/6         0  Cerebellum        11
GSM2545348     C57BL/6         0  Cerebellum         8
GSM2545349     C57BL/6         0  Cerebellum         7
GSM2545353     C57BL/6         0  Cerebellum         4
GSM2545354     C57BL/6         0  Cerebellum         2
R
rowData(se1)
OUTPUT
DataFrame with 7 rows and 9 columns
                gene  ENTREZID        product    ensembl_gene_id
         <character> <integer>    <character>        <character>
Mir1901      Mir1901 100316686  microRNA 1901 ENSMUSG00000084565
Mir378a      Mir378a    723889  microRNA 378a ENSMUSG00000105200
Mir133b      Mir133b    723817  microRNA 133b ENSMUSG00000065480
Mir30c-2    Mir30c-2    723964 microRNA 30c-2 ENSMUSG00000065567
Mir149        Mir149    387167   microRNA 149 ENSMUSG00000065470
Mir128-1    Mir128-1    387147 microRNA 128-1 ENSMUSG00000065520
Mir7682      Mir7682 102466847  microRNA 7682 ENSMUSG00000106406
         external_synonym chromosome_name gene_biotype  phenotype_description
              <character>     <character>  <character>            <character>
Mir1901          Mirn1901              18        miRNA                     NA
Mir378a           Mirn378              18        miRNA abnormal mitochondri..
Mir133b          mir 133b               1        miRNA no abnormal phenotyp..
Mir30c-2        mir 30c-2               1        miRNA                     NA
Mir149            Mirn149               1        miRNA increased circulatin..
Mir128-1          Mirn128               1        miRNA no abnormal phenotyp..
Mir7682      mmu-mir-7682               1        miRNA                     NA
         hsapiens_homolog_associated_gene_name
                                   <character>
Mir1901                                     NA
Mir378a                                MIR378A
Mir133b                                MIR133B
Mir30c-2                               MIR30C2
Mir149                                      NA
Mir128-1                              MIR128-1
Mir7682 NADéfi
Extrayez les niveaux d’expression génique des trois premiers gènes dans les échantillons au temps 0 et au temps 8.
R
assay(se)[1:3, colData(se)$time != 4]
OUTPUT
        GSM2545336 GSM2545337 GSM2545338 GSM2545341 GSM2545342 GSM2545343
Asl           1170        361        400        988        836        535
Apod         36194      10347       9173      29594      24959      13668
Cyp2d22       4060       1616       1603       3349       3122       2008
        GSM2545346 GSM2545347 GSM2545348 GSM2545349 GSM2545351 GSM2545353
Asl            938       1035        494        481        937        541
Apod         27769      34301      11258      11812      29242      13682
Cyp2d22       2985       3452       1883       2014       3678       2216
        GSM2545354 GSM2545380
Asl            473       1192
Apod         11088      38148
Cyp2d22       1821       4019
R
# Equivalent to
assay(se)[1:3, colData(se)$time == 0 | colData(se)$time == 8]
OUTPUT
        GSM2545336 GSM2545337 GSM2545338 GSM2545341 GSM2545342 GSM2545343
Asl           1170        361        400        988        836        535
Apod         36194      10347       9173      29594      24959      13668
Cyp2d22       4060       1616       1603       3349       3122       2008
        GSM2545346 GSM2545347 GSM2545348 GSM2545349 GSM2545351 GSM2545353
Asl            938       1035        494        481        937        541
Apod         27769      34301      11258      11812      29242      13682
Cyp2d22       2985       3452       1883       2014       3678       2216
        GSM2545354 GSM2545380
Asl            473       1192
Apod         11088      38148
Cyp2d22 1821 4019Défi
Vérifiez que vous obtenez les mêmes valeurs en utilisant le tableau
rna au format long.
R
rna |>
    filter(gene %in% c("Asl", "Apod", "Cyd2d22")) |>
    filter(time != 4) |>
    select(expression)
OUTPUT
# A tibble: 28 × 1
   expression
        <dbl>
 1       1170
 2      36194
 3        361
 4      10347
 5        400
 6       9173
 7        988
 8      29594
 9        836
10      24959
# ℹ 18 more rows
Le tableau au format long et le SummarizedExperiment
contiennent les mêmes informations, mais sont structurés différemment.
Chaque approche présente ses propres avantages : le premier convient
bien aux packages tidyverse, tandis que le second constitue
la structure privilégiée pour de nombreuses étapes de traitement
bioinformatique et statistique. C’est le cas, par exemple, d’une analyse
RNA-Seq classique avec le package DESeq2.
Ajout de variables aux métadonnées
Nous pouvons également ajouter des informations aux métadonnées. Supposons que vous souhaitiez ajouter le centre où les échantillons ont été collectés…
R
colData(se)$center <- rep("University of Illinois", nrow(colData(se)))
colData(se)
OUTPUT
DataFrame with 22 rows and 10 columns
                sample     organism       age         sex   infection
           <character>  <character> <integer> <character> <character>
GSM2545336  GSM2545336 Mus musculus         8      Female  InfluenzaA
GSM2545337  GSM2545337 Mus musculus         8      Female NonInfected
GSM2545338  GSM2545338 Mus musculus         8      Female NonInfected
GSM2545339  GSM2545339 Mus musculus         8      Female  InfluenzaA
GSM2545340  GSM2545340 Mus musculus         8        Male  InfluenzaA
...                ...          ...       ...         ...         ...
GSM2545353  GSM2545353 Mus musculus         8      Female NonInfected
GSM2545354  GSM2545354 Mus musculus         8        Male NonInfected
GSM2545362  GSM2545362 Mus musculus         8      Female  InfluenzaA
GSM2545363  GSM2545363 Mus musculus         8        Male  InfluenzaA
GSM2545380  GSM2545380 Mus musculus         8      Female  InfluenzaA
                strain      time      tissue     mouse                 center
           <character> <integer> <character> <integer>            <character>
GSM2545336     C57BL/6         8  Cerebellum        14 University of Illinois
GSM2545337     C57BL/6         0  Cerebellum         9 University of Illinois
GSM2545338     C57BL/6         0  Cerebellum        10 University of Illinois
GSM2545339     C57BL/6         4  Cerebellum        15 University of Illinois
GSM2545340     C57BL/6         4  Cerebellum        18 University of Illinois
...                ...       ...         ...       ...                    ...
GSM2545353     C57BL/6         0  Cerebellum         4 University of Illinois
GSM2545354     C57BL/6         0  Cerebellum         2 University of Illinois
GSM2545362     C57BL/6         4  Cerebellum        20 University of Illinois
GSM2545363     C57BL/6         4  Cerebellum        12 University of Illinois
GSM2545380     C57BL/6         8  Cerebellum        19 University of Illinois
Cela illustre que les slots de métadonnées peuvent s’étendre indéfiniment sans affecter les autres structures !
tidySummarizedExperiment
Vous vous demandez peut-être si nous pouvons utiliser des commandes
tidyverse pour interagir avec les objets
SummarizedExperiment. La réponse est oui, c’est possible
grâce au package tidySummarizedExperiment.
Rappelez-vous à quoi ressemble notre objet SummarizedExperiment :
R
se
OUTPUT
class: SummarizedExperiment
dim: 1474 22
metadata(0):
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(10): sample organism ... mouse center
Chargez tidySummarizedExperiment, puis examinez à
nouveau l’objet se.
R
## BiocManager::install("tidySummarizedExperiment")
library("tidySummarizedExperiment")

se
OUTPUT
class: SummarizedExperiment
dim: 1474 22
metadata(0):
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(10): sample organism ... mouse center
Il s’agit toujours d’un objet SummarizedExperiment, qui
conserve donc sa structure efficace, mais nous pouvons désormais le
consulter comme un tibble. La première ligne de la sortie indique qu’il
s’agit d’une abstraction
SummarizedExperiment-tibble. La deuxième ligne
indique également le nombre de transcrits et d’échantillons.
Nous pouvons désormais utiliser les commandes de tidyverse pour
interagir avec l’objet SummarizedExperiment.
Nous pouvons utiliser filter pour filtrer des lignes
selon une condition, par exemple pour afficher toutes les lignes d’un
échantillon.
R
se |> filter(sample == "GSM2545336")
OUTPUT
class: SummarizedExperiment
dim: 1474 1
metadata(1): latest_filter_scope_report
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(1): GSM2545336
colData names(10): sample organism ... mouse center
R
se |> filter(sex == "Female")
OUTPUT
class: SummarizedExperiment
dim: 1474 12
metadata(1): latest_filter_scope_report
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(12): GSM2545336 GSM2545337 ... GSM2545362 GSM2545380
colData names(10): sample organism ... mouse center
Nous pouvons utiliser select pour spécifier les colonnes
que nous souhaitons consulter.
R
se |> select(sample, sex)
WARNING
Warning: `when()` was deprecated in purrr 1.0.0.
ℹ Please use `if` instead.
ℹ The deprecated feature was likely used in the tidySummarizedExperiment
  package.
  Please report the issue at
  <https://github.com/stemangiola/tidySummarizedExperiment/issues>.
This warning is displayed once per session.
Call `lifecycle::last_lifecycle_warnings()` to see where this warning was
generated.
OUTPUT
tidySummarizedExperiment says: Key columns are missing. A data frame is returned for independent data analysis.OUTPUT
# A tibble: 32,428 × 2
   sample     sex
   <chr>      <chr>
 1 GSM2545336 Female
 2 GSM2545336 Female
 3 GSM2545336 Female
 4 GSM2545336 Female
 5 GSM2545336 Female
 6 GSM2545336 Female
 7 GSM2545336 Female
 8 GSM2545336 Female
 9 GSM2545336 Female
10 GSM2545336 Female
# ℹ 32,418 more rows
Nous pouvons utiliser mutate pour ajouter des
informations métadonnées.
R
se |> mutate(center = "Heidelberg University")
OUTPUT
class: SummarizedExperiment
dim: 1474 22
metadata(1): latest_mutate_scope_report
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(10): sample organism ... mouse center
Nous pouvons également combiner des commandes à l’aide du pipe
tidyverse |>. Par exemple, nous pourrions combiner
group_by et summarise pour obtenir la somme
des comptages pour chaque échantillon.
R
se |>
    group_by(.sample) |>
    summarise(total_counts=sum(counts))
OUTPUT
tidySummarizedExperiment says: A data frame is returned for independent data analysis.OUTPUT
# A tibble: 22 × 2
   .sample    total_counts
   <chr>             <int>
 1 GSM2545336      3039671
 2 GSM2545337      2602360
 3 GSM2545338      2458618
 4 GSM2545339      2500082
 5 GSM2545340      2479024
 6 GSM2545341      2413723
 7 GSM2545342      2349728
 8 GSM2545343      3105652
 9 GSM2545344      2524137
10 GSM2545345      2506038
# ℹ 12 more rows
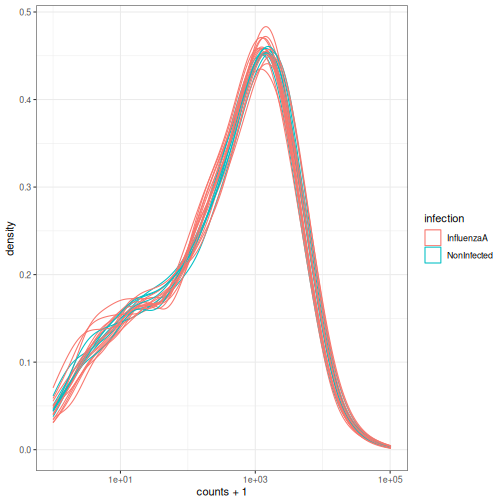
Nous pouvons traiter l’objet tidy SummarizedExperiment comme un tibble ordinaire pour créer des graphiques.
Ici, nous représentons la distribution des comptages par échantillon.
R
se |>
    ggplot(aes(counts + 1, group=.sample, color=infection)) +
    geom_density() +
    scale_x_log10() +
    theme_bw()
Pour plus d’informations sur tidySummarizedExperiment,
consultez le site web
du package.
Message clé
SummarizedExperimentreprésente un moyen efficace de stocker et de manipuler des données omiques.Ils sont utilisés dans de nombreux packages Bioconductor.
Si vous suivez la formation suivante consacrée à l’analyse du
séquençage de l’ARN, vous apprendrez à utiliser le package Bioconductor
DESeq2 pour réaliser des analyses d’expression
différentielle. L’intégralité de l’analyse du package
DESeq2 est gérée dans un
SummarizedExperiment.
- Bioconductor est un projet qui fournit un support et des packages pour la compréhension de données biologiques à haut débit.
- Un
SummarizedExperimentest un type d’objet utile pour stocker et gérer des données omiques à haut débit.
Le projet Bioconductor a été lancé par Robert Gentleman, l’un des deux créateurs du langage R. Bioconductor propose des outils dédiés à l’analyse de données omiques. Il utilise le langage de programmation statistique R ; son code source est ouvert et son développement est ouvert à la communauté.↩︎