
Manipulación y análisis de datos con dplyr
Última actualización: 2026-11-11 | Mejora esta página
Tiempo estimado: 150 minutos
Hoja de ruta
Preguntas
- Análisis de datos en R utilizando el metapaquete tidyverse
Objetivos
- Describa el propósito de los paquetes
dplyrytidyr. - Describa varias de sus funciones que son extremadamente útiles para manipular datos.
- Describa el concepto de los formatos de tabla ancho y largo, y vea cómo reestructurar una tabla de datos de un formato a otro.
- Demostrar cómo unir tablas.
Este episodio se basa en la lección Data Analysis and Visualisation in R for Ecologists de Data Carpentries.
Manipulación de datos mediante dplyr y
tidyr
La selección de subconjuntos mediante corchetes es práctica, pero puede resultar engorrosa y difícil de leer, especialmente en operaciones complicadas.
Algunos paquetes pueden facilitar considerablemente nuestra tarea al
manipular datos. Los paquetes en R son, básicamente, conjuntos de
funciones adicionales que nos permiten hacer más cosas. Las funciones
que hemos estado utilizando hasta ahora, como str() o
data.frame(), vienen integradas en R; cargar paquetes puede
darnos acceso a otras funciones específicas. Antes de usar un paquete
por primera vez, es necesario instalarlo en la máquina y,
posteriormente, importarlo en cada sesión posterior de R cuando lo
necesitemos.
El paquete
dplyrofrece herramientas potentes para tareas de manipulación de datos. Está diseñado para funcionar directamente con tablas de datos, con muchas tareas de manipulación optimizadas.Como veremos más adelante, a veces queremos que una tabla de datos se reorganice para poder realizar ciertos análisis específicos o para su visualización. El paquete
tidyraborda este problema común de reorganización de datos y proporciona herramientas para manipular los datos de manera ordenada.
Para obtener más información sobre
dplyr y
tidyr después del taller, puede consultar
este cheatsheet
práctico de transformación de datos con
dplyr y este de
tidyr.
- El paquete
tidyversees un “paquete paraguas” que instala varios paquetes útiles para el análisis de datos que funcionan bien juntos, comotidyr,dplyr,ggplot2,tibble, etc. Estos paquetes nos ayudan a trabajar e interactuar con los datos. Nos permiten realizar muchas acciones con sus datos, como crear subconjuntos, transformarlos, visualizarlos, etc.
Si realizó la configuración, ya debería haber instalado el paquete tidyverse. Compruebe si lo tiene intentando cargarlo desde la biblioteca:
R
## load the tidyverse packages, incl. dplyr
library("tidyverse")
Si obtuviste un mensaje de error
there is no package called ‘tidyverse’, es que aún no has
instalado el paquete para esta versión de R. Para instalar el paquete
tidyverse, escribe:
R
BiocManager::install("tidyverse")
Si tuviste que instalar el paquete
tidyverse, ¡no olvides cargarlo en esta
sesión de R utilizando el comando library() anterior!
Cargando datos con tidyverse
En lugar de read.csv(), cargaremos nuestros datos
utilizando la función read_csv() (fíjese en el
_ en lugar del .), del paquete tidyverse
readr.
R
rna <- read_csv("data/rnaseq.csv")

## view the data
rna
SALIDA
# A tibble: 32,428 × 19
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…       1170 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 Apod    GSM254…      36194 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 3 Cyp2d22 GSM254…       4060 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 4 Klk6    GSM254…        287 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 5 Fcrls   GSM254…         85 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 6 Slc2a4  GSM254…        782 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 7 Exd2    GSM254…       1619 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 Gjc2    GSM254…        288 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 9 Plp1    GSM254…      43217 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
10 Gnb4    GSM254…       1071 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
Nótese que la clase de los datos se denomina ahora «tibble».
Los tibbles ajustan algunos de los comportamientos de los objetos de tabla de datos que presentamos anteriormente. La estructura de datos es muy similar a la de una tabla de datos. Para nuestros propósitos, las únicas diferencias son que:
Muestra el tipo de datos de cada columna debajo de su nombre. Tenga en cuenta que <
dbl> es un tipo de datos definido para almacenar valores numéricos con puntos decimales.Solo imprime las primeras filas de datos y solo tantas columnas como quepan en una pantalla.
Ahora vamos a aprender algunas de las funciones
dplyr más comunes:
-
select(): seleccionar columnas -
filter(): seleccionar filas según condiciones -
mutate(): crear nuevas columnas utilizando información de otras columnas -
group_by()ysummarise(): crear estadísticas resumidas sobre datos agrupados -
arrange(): ordenar los resultados -
count(): contar valores discretos
Selección de columnas y filtrado de filas
Para seleccionar columnas de una tabla de datos, utilice
select(). El primer argumento de esta función es la tabla
de datos (rna), y los argumentos siguientes son las
columnas a conservar.
R
select(rna, gene, sample, tissue, expression)
SALIDA
# A tibble: 32,428 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545336 Cerebellum       1170
 2 Apod    GSM2545336 Cerebellum      36194
 3 Cyp2d22 GSM2545336 Cerebellum       4060
 4 Klk6    GSM2545336 Cerebellum        287
 5 Fcrls   GSM2545336 Cerebellum         85
 6 Slc2a4  GSM2545336 Cerebellum        782
 7 Exd2    GSM2545336 Cerebellum       1619
 8 Gjc2    GSM2545336 Cerebellum        288
 9 Plp1    GSM2545336 Cerebellum      43217
10 Gnb4    GSM2545336 Cerebellum       1071
# ℹ 32,418 more rows
Para seleccionar todas las columnas excepto algunas determinadas, coloque un “-” delante de la variable para excluirla.
R
select(rna, -tissue, -organism)
SALIDA
# A tibble: 32,428 × 17
   gene    sample   expression   age sex   infection strain  time mouse ENTREZID
   <chr>   <chr>         <dbl> <dbl> <chr> <chr>     <chr>  <dbl> <dbl>    <dbl>
 1 Asl     GSM2545…       1170     8 Fema… Influenz… C57BL…     8    14   109900
 2 Apod    GSM2545…      36194     8 Fema… Influenz… C57BL…     8    14    11815
 3 Cyp2d22 GSM2545…       4060     8 Fema… Influenz… C57BL…     8    14    56448
 4 Klk6    GSM2545…        287     8 Fema… Influenz… C57BL…     8    14    19144
 5 Fcrls   GSM2545…         85     8 Fema… Influenz… C57BL…     8    14    80891
 6 Slc2a4  GSM2545…        782     8 Fema… Influenz… C57BL…     8    14    20528
 7 Exd2    GSM2545…       1619     8 Fema… Influenz… C57BL…     8    14    97827
 8 Gjc2    GSM2545…        288     8 Fema… Influenz… C57BL…     8    14   118454
 9 Plp1    GSM2545…      43217     8 Fema… Influenz… C57BL…     8    14    18823
10 Gnb4    GSM2545…       1071     8 Fema… Influenz… C57BL…     8    14    14696
# ℹ 32,418 more rows
# ℹ 7 more variables: product <chr>, ensembl_gene_id <chr>,
#   external_synonym <chr>, chromosome_name <chr>, gene_biotype <chr>,
#   phenotype_description <chr>, hsapiens_homolog_associated_gene_name <chr>
Esto seleccionará todas las variables de rna excepto
tissue y organism.
Para seleccionar filas basándose en un criterio específico, utilice
filter():
R
filter(rna, sex == "Male")
SALIDA
# A tibble: 14,740 × 19
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…        626 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 2 Apod    GSM254…      13021 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 3 Cyp2d22 GSM254…       2171 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 4 Klk6    GSM254…        448 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 5 Fcrls   GSM254…        180 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 6 Slc2a4  GSM254…        313 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 7 Exd2    GSM254…       2366 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 8 Gjc2    GSM254…        310 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 9 Plp1    GSM254…      53126 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
10 Gnb4    GSM254…       1355 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
# ℹ 14,730 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
R
filter(rna, sex == "Male" & infection == "NonInfected")
SALIDA
# A tibble: 4,422 × 19
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…        535 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 2 Apod    GSM254…      13668 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 3 Cyp2d22 GSM254…       2008 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 4 Klk6    GSM254…       1101 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 5 Fcrls   GSM254…        375 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 6 Slc2a4  GSM254…        249 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 7 Exd2    GSM254…       3126 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 8 Gjc2    GSM254…        791 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 9 Plp1    GSM254…      98658 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
10 Gnb4    GSM254…       2437 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
# ℹ 4,412 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
Ahora imaginemos que nos interesan los homólogos humanos de los genes
de ratón analizados en este conjunto de datos. Esta información se
encuentra en la última columna del tibble rna, llamada
hsapiens_homolog_associated_gene_name. Para visualizarla
fácilmente, crearemos una nueva tabla que contenga únicamente las 2
columnas gene y
hsapiens_homolog_associated_gene_name.
R
genes <- select(rna, gene, hsapiens_homolog_associated_gene_name)
genes
SALIDA
# A tibble: 32,428 × 2
   gene    hsapiens_homolog_associated_gene_name
   <chr>   <chr>
 1 Asl     ASL
 2 Apod    APOD
 3 Cyp2d22 CYP2D6
 4 Klk6    KLK6
 5 Fcrls   FCRL2
 6 Slc2a4  SLC2A4
 7 Exd2    EXD2
 8 Gjc2    GJC2
 9 Plp1    PLP1
10 Gnb4    GNB4
# ℹ 32,418 more rows
Algunos genes de ratón no tienen homólogos humanos. Estos pueden
obtenerse mediante filter() y la función
is.na(), que determina si algo es un NA.
R
filter(genes, is.na(hsapiens_homolog_associated_gene_name))
SALIDA
# A tibble: 4,290 × 2
   gene     hsapiens_homolog_associated_gene_name
   <chr>    <chr>
 1 Prodh    <NA>
 2 Tssk5    <NA>
 3 Vmn2r1   <NA>
 4 Gm10654  <NA>
 5 Hexa     <NA>
 6 Sult1a1  <NA>
 7 Gm6277   <NA>
 8 Tmem198b <NA>
 9 Adam1a   <NA>
10 Ebp      <NA>
# ℹ 4,280 more rows
Si queremos conservar solo los genes de ratón que tengan un homólogo
humano, podemos insertar un símbolo “!” que niega el resultado, de modo
que solicitamos cada fila en la que
hsapiens_homolog_associated_gene_name no sea un
NA.
R
filter(genes, !is.na(hsapiens_homolog_associated_gene_name))
SALIDA
# A tibble: 28,138 × 2
   gene    hsapiens_homolog_associated_gene_name
   <chr>   <chr>
 1 Asl     ASL
 2 Apod    APOD
 3 Cyp2d22 CYP2D6
 4 Klk6    KLK6
 5 Fcrls   FCRL2
 6 Slc2a4  SLC2A4
 7 Exd2    EXD2
 8 Gjc2    GJC2
 9 Plp1    PLP1
10 Gnb4    GNB4
# ℹ 28,128 more rows
Pipes
¿Qué pasa si quieres seleccionar y filtrar al mismo tiempo? Hay tres formas de hacerlo: usar pasos intermedios, funciones anidadas o pipes.
Con pasos intermedios, se crea una tabla de datos temporal y se utiliza como entrada para la siguiente función, de la siguiente manera:
R
rna2 <- filter(rna, sex == "Male")
rna3 <- select(rna2, gene, sample, tissue, expression)
rna3
SALIDA
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rows
Esto es legible, pero puede saturar el espacio de trabajo con muchos objetos intermedios que hay que nombrar individualmente. Con múltiples pasos, puede resultar difícil hacer un seguimiento de ellos.
También puedes anidar funciones (es decir, una función dentro de otra), de esta manera:
R
rna3 <- select(filter(rna, sex == "Male"), gene, sample, tissue, expression)
rna3
SALIDA
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rows
Esto es práctico, pero puede resultar difícil de leer si hay demasiadas funciones anidadas, ya que R evalúa la expresión de adentro hacia afuera (en este caso, filtrando y luego seleccionando).
La última opción, los pipes, es una incorporación reciente a R. Los pipes permiten tomar la salida de una función y enviarla directamente a la siguiente, lo cual resulta útil cuando es necesario realizar muchas operaciones sobre el mismo conjunto de datos.
Los pipes en R se representan como %>% (disponible a
través del paquete magrittr) o
|> (a través de base R). Si utilizas RStudio, puedes
escribir el pipe con Ctrl + Shift + M
si tienes un PC o Cmd + Shift + M si
tienes un Mac.
En el código anterior, utilizamos el pipe para enviar primero el
conjunto de datos rna a través de filter()
para conservar las filas donde sex es Male, y luego a
través de select() para conservar únicamente las columnas
gene, sample, tissue y
expression.
El pipe |> toma el objeto a su izquierda y lo pasa
directamente como primer argumento a la función a su derecha; ya no es
necesario incluir explícitamente la tabla de datos como argumento de las
funciones filter() y select().
R
rna |>
  filter(sex == "Male") |>
  select(gene, sample, tissue, expression)
SALIDA
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rows
A algunas personas les resulta útil leer el pipe como la palabra
“luego”. Por ejemplo, en el ejemplo anterior, tomamos la tabla de datos
rna, luego filtramos las filas con
sex == "Male" mediante filter, luego
seleccionamos las columnas gene, sample,
tissue y expression mediante
select.
Las funciones dplyr por sí mismas son
algo sencillas, pero al combinarlas en flujos de trabajo lineales
mediante el pipe, podemos realizar manipulaciones más complejas de
tablas de datos.
Si queremos crear un nuevo objeto con esta versión reducida de los datos, podemos asignarle un nombre nuevo:
R
rna3 <- rna |>
  filter(sex == "Male") |>
  select(gene, sample, tissue, expression)

rna3
SALIDA
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rowsDesafío:
Utilizando pipes, seleccione un subconjunto de los datos
rna para conservar las observaciones de ratones hembra en
el momento 0, donde el gen tenga una expresión superior a 50000, y
conserve únicamente las columnas gene, sample,
time, expression y age.
R
rna |>
  filter(expression > 50000,
         sex == "Female",
         time == 0 ) |>
  select(gene, sample, time, expression, age)
SALIDA
# A tibble: 9 × 5
  gene   sample      time expression   age
  <chr>  <chr>      <dbl>      <dbl> <dbl>
1 Plp1   GSM2545337     0     101241     8
2 Atp1b1 GSM2545337     0      53260     8
3 Plp1   GSM2545338     0      96534     8
4 Atp1b1 GSM2545338     0      50614     8
5 Plp1   GSM2545348     0     102790     8
6 Atp1b1 GSM2545348     0      59544     8
7 Plp1   GSM2545353     0      71237     8
8 Glul   GSM2545353     0      52451     8
9 Atp1b1 GSM2545353     0      61451     8
Crear y modificar columnas (mutate)
A menudo querrá crear nuevas columnas basándose en los valores de
columnas existentes, por ejemplo, para realizar conversiones de unidades
o para hallar la proporción de valores en dos columnas. Para ello,
utilizaremos mutate().
Para crear una nueva columna de tiempo en horas:
R
rna |>
  mutate(time_hours = time * 24) |>
  select(time, time_hours)
SALIDA
# A tibble: 32,428 × 2
    time time_hours
   <dbl>      <dbl>
 1     8        192
 2     8        192
 3     8        192
 4     8        192
 5     8        192
 6     8        192
 7     8        192
 8     8        192
 9     8        192
10     8        192
# ℹ 32,418 more rows
También puede crear una segunda columna nueva basada en la primera
columna nueva dentro de la misma llamada a mutate():
R
rna |>
  mutate(time_hours = time * 24,
         time_mn = time_hours * 60) |>
  select(time, time_hours, time_mn)
SALIDA
# A tibble: 32,428 × 3
    time time_hours time_mn
   <dbl>      <dbl>   <dbl>
 1     8        192   11520
 2     8        192   11520
 3     8        192   11520
 4     8        192   11520
 5     8        192   11520
 6     8        192   11520
 7     8        192   11520
 8     8        192   11520
 9     8        192   11520
10     8        192   11520
# ℹ 32,418 more rows
Desafío
Crea una nueva tabla de datos a partir de los datos rna
que cumpla los siguientes criterios: contenga únicamente las columnas
gene, chromosome_name,
phenotype_description, sample y
expression. Los valores de expresión deben estar
transformados logarítmicamente. Esta tabla de datos debe contener
únicamente genes ubicados en cromosomas sexuales, asociados a un
phenotype_description y con una expresión logarítmica superior a 5.
Pista: ¡piensa en cómo deben ordenarse los comandos para generar esta tabla de datos!
R
rna |>
  mutate(expression = log(expression)) |>
  select(gene, chromosome_name, phenotype_description, sample, expression) |>
  filter(chromosome_name == "X" | chromosome_name == "Y") |>
  filter(!is.na(phenotype_description)) |>
  filter(expression > 5)
SALIDA
# A tibble: 649 × 5
   gene   chromosome_name phenotype_description                sample expression
   <chr>  <chr>           <chr>                                <chr>       <dbl>
 1 Plp1   X               abnormal CNS glial cell morphology   GSM25…      10.7
 2 Slc7a3 X               decreased body length                GSM25…       5.46
 3 Plxnb3 X               abnormal coat appearance             GSM25…       6.58
 4 Rbm3   X               abnormal liver morphology            GSM25…       9.32
 5 Cfp    X               abnormal cardiovascular system phys… GSM25…       6.18
 6 Ebp    X               abnormal embryonic erythrocyte morp… GSM25…       6.68
 7 Cd99l2 X               abnormal cellular extravasation      GSM25…       8.04
 8 Piga   X               abnormal brain development           GSM25…       6.06
 9 Pim2   X               decreased T cell proliferation       GSM25…       7.11
10 Itm2a  X               no abnormal phenotype detected       GSM25…       7.48
# ℹ 639 more rows
Análisis de datos de split-apply-combine
Muchas tareas de análisis de datos pueden abordarse utilizando el
paradigma split-apply-combine: dividir los datos en grupos,
aplicar algún análisis a cada grupo y, a continuación, combinar los
resultados. dplyr facilita enormemente
esto mediante el uso de la función group_by().
R
rna |>
  group_by(gene)
SALIDA
# A tibble: 32,428 × 19
# Groups:   gene [1,474]
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…       1170 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 Apod    GSM254…      36194 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 3 Cyp2d22 GSM254…       4060 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 4 Klk6    GSM254…        287 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 5 Fcrls   GSM254…         85 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 6 Slc2a4  GSM254…        782 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 7 Exd2    GSM254…       1619 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 Gjc2    GSM254…        288 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 9 Plp1    GSM254…      43217 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
10 Gnb4    GSM254…       1071 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
La función group_by() no realiza ningún procesamiento de
datos, sino que agrupa los datos en subconjuntos: en el ejemplo
anterior, nuestro tibble inicial de 32428 observaciones se
divide en 1474 grupos basándose en la variable gene.
Del mismo modo, podríamos decidir agrupar el tibble por las muestras:
R
rna |>
  group_by(sample)
SALIDA
# A tibble: 32,428 × 19
# Groups:   sample [22]
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…       1170 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 Apod    GSM254…      36194 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 3 Cyp2d22 GSM254…       4060 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 4 Klk6    GSM254…        287 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 5 Fcrls   GSM254…         85 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 6 Slc2a4  GSM254…        782 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 7 Exd2    GSM254…       1619 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 Gjc2    GSM254…        288 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 9 Plp1    GSM254…      43217 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
10 Gnb4    GSM254…       1071 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
Aquí nuestro tibble inicial de 32428 observaciones se
divide en 22 grupos según la variable sample.
Una vez agrupados los datos, las operaciones posteriores se aplicarán a cada grupo de forma independiente.
La función summarise()
group_by() se utiliza a menudo junto con
summarise(), que reduce cada grupo a un resumen de una sola
fila.
group_by() acepta como argumentos los nombres de las
columnas que contienen las variables categóricas para
las cuales se desea calcular las estadísticas resumidas. Por lo tanto,
para calcular la media de expression por gen:
R
rna |>
  group_by(gene) |>
  summarise(mean_expression = mean(expression))
SALIDA
# A tibble: 1,474 × 2
   gene     mean_expression
   <chr>              <dbl>
 1 AI504432         1053.
 2 AW046200          131.
 3 AW551984          295.
 4 Aamp             4751.
 5 Abca12              4.55
 6 Abcc8            2498.
 7 Abhd14a           525.
 8 Abi2             4909.
 9 Abi3bp           1002.
10 Abl2             2124.
# ℹ 1,464 more rows
También podríamos querer calcular los niveles de expresión medios de todos los genes en cada muestra:
R
rna |>
  group_by(sample) |>
  summarise(mean_expression = mean(expression))
SALIDA
# A tibble: 22 × 2
   sample     mean_expression
   <chr>                <dbl>
 1 GSM2545336           2062.
 2 GSM2545337           1766.
 3 GSM2545338           1668.
 4 GSM2545339           1696.
 5 GSM2545340           1682.
 6 GSM2545341           1638.
 7 GSM2545342           1594.
 8 GSM2545343           2107.
 9 GSM2545344           1712.
10 GSM2545345           1700.
# ℹ 12 more rows
Pero también podemos agrupar por múltiples columnas:
R
rna |>
  group_by(gene, infection, time) |>
  summarise(mean_expression = mean(expression))
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, infection, and time.
ℹ Output is grouped by gene and infection.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, infection, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
SALIDA
# A tibble: 4,422 × 4
# Groups:   gene, infection [2,948]
   gene     infection    time mean_expression
   <chr>    <chr>       <dbl>           <dbl>
 1 AI504432 InfluenzaA      4           1104.
 2 AI504432 InfluenzaA      8           1014
 3 AI504432 NonInfected     0           1034.
 4 AW046200 InfluenzaA      4            152.
 5 AW046200 InfluenzaA      8             81
 6 AW046200 NonInfected     0            155.
 7 AW551984 InfluenzaA      4            302.
 8 AW551984 InfluenzaA      8            342.
 9 AW551984 NonInfected     0            238
10 Aamp     InfluenzaA      4           4870
# ℹ 4,412 more rows
Una vez agrupados los datos, también se pueden resumir múltiples
variables al mismo tiempo (y no necesariamente en la misma variable).
Por ejemplo, podríamos añadir una columna que indique la mediana de
expression por gen y por condición:
R
rna |>
  group_by(gene, infection, time) |>
  summarise(mean_expression = mean(expression),
            median_expression = median(expression))
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, infection, and time.
ℹ Output is grouped by gene and infection.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, infection, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
SALIDA
# A tibble: 4,422 × 5
# Groups:   gene, infection [2,948]
   gene     infection    time mean_expression median_expression
   <chr>    <chr>       <dbl>           <dbl>             <dbl>
 1 AI504432 InfluenzaA      4           1104.             1094.
 2 AI504432 InfluenzaA      8           1014               985
 3 AI504432 NonInfected     0           1034.             1016
 4 AW046200 InfluenzaA      4            152.              144.
 5 AW046200 InfluenzaA      8             81                82
 6 AW046200 NonInfected     0            155.              163
 7 AW551984 InfluenzaA      4            302.              245
 8 AW551984 InfluenzaA      8            342.              287
 9 AW551984 NonInfected     0            238               265
10 Aamp     InfluenzaA      4           4870              4708
# ℹ 4,412 more rows
Desafío
Calcular el nivel de expresión medio del gen “Dok3” según los puntos temporales.
R
rna |>
  filter(gene == "Dok3") |>
  group_by(time) |>
  summarise(mean = mean(expression))
SALIDA
# A tibble: 3 × 2
   time  mean
  <dbl> <dbl>
1     0  169
2     4  156.
3     8   61
Conteo
Al trabajar con datos, a menudo queremos conocer el número de
observaciones encontradas para cada factor o combinación de factores.
Para esta tarea, dplyr proporciona
count(). Por ejemplo, si quisiéramos contar el número de
filas de datos para cada muestra infectada y no infectada, haríamos lo
siguiente:
R
rna |>
    count(infection)
SALIDA
# A tibble: 2 × 2
  infection       n
  <chr>       <int>
1 InfluenzaA  22110
2 NonInfected 10318
La función count() es una abreviatura de algo que ya
hemos visto: agrupar por una variable y resumirlo contando el número de
observaciones en ese grupo. En otras palabras,
rna |> count(infection) es equivalente a:
R
rna |>
    group_by(infection) |>
    summarise(n = n())
SALIDA
# A tibble: 2 × 2
  infection       n
  <chr>       <int>
1 InfluenzaA  22110
2 NonInfected 10318
El ejemplo anterior muestra el uso de count() para
contar el número de filas/observaciones para un factor (es
decir, infection). Si quisiéramos contar una
combinación de factores, como infection y
time, especificaríamos el primer y el segundo factor como
argumentos de count():
R
rna |>
    count(infection, time)
SALIDA
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      4 11792
2 InfluenzaA      8 10318
3 NonInfected     0 10318
lo que equivale a esto:
R
rna |>
  group_by(infection, time) |>
  summarise(n = n())
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by infection and time.
ℹ Output is grouped by infection.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(infection, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
SALIDA
# A tibble: 3 × 3
# Groups:   infection [2]
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      4 11792
2 InfluenzaA      8 10318
3 NonInfected     0 10318
A veces resulta útil ordenar el resultado para facilitar las
comparaciones. Podemos usar arrange() para ordenar la
tabla. Por ejemplo, podríamos querer organizar la tabla anterior por
tiempo:
R
rna |>
  count(infection, time) |>
  arrange(time)
SALIDA
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 NonInfected     0 10318
2 InfluenzaA      4 11792
3 InfluenzaA      8 10318
o por conteos:
R
rna |>
  count(infection, time) |>
  arrange(n)
SALIDA
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      8 10318
2 NonInfected     0 10318
3 InfluenzaA      4 11792
Para ordenar en orden descendente, necesitamos añadir la función
desc():
R
rna |>
  count(infection, time) |>
  arrange(desc(n))
SALIDA
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      4 11792
2 InfluenzaA      8 10318
3 NonInfected     0 10318
Desafío
- ¿Cuántos genes se analizaron en cada muestra?
- Utilice
group_by()ysummarise()para evaluar la profundidad de secuenciación (la suma de todos los recuentos) en cada muestra. ¿Qué muestra tiene la mayor profundidad de secuenciación? - Seleccione una muestra y evalúe el número de genes según el biotipo.
- Identifique los genes asociados con la descripción del fenotipo “abnormal DNA methylation” y calcule su expresión media (en log) en el momento 0, el momento 4 y el momento 8.
R
## 1.
rna |>
  count(sample)
SALIDA
# A tibble: 22 × 2
   sample         n
   <chr>      <int>
 1 GSM2545336  1474
 2 GSM2545337  1474
 3 GSM2545338  1474
 4 GSM2545339  1474
 5 GSM2545340  1474
 6 GSM2545341  1474
 7 GSM2545342  1474
 8 GSM2545343  1474
 9 GSM2545344  1474
10 GSM2545345  1474
# ℹ 12 more rows
R
## 2.
rna |>
  group_by(sample) |>
  summarise(seq_depth = sum(expression)) |>
  arrange(desc(seq_depth))
SALIDA
# A tibble: 22 × 2
   sample     seq_depth
   <chr>          <dbl>
 1 GSM2545350   3255566
 2 GSM2545352   3216163
 3 GSM2545343   3105652
 4 GSM2545336   3039671
 5 GSM2545380   3036098
 6 GSM2545353   2953249
 7 GSM2545348   2913678
 8 GSM2545362   2913517
 9 GSM2545351   2782464
10 GSM2545349   2758006
# ℹ 12 more rows
R
## 3.
rna |>
  filter(sample == "GSM2545336") |>
  count(gene_biotype) |>
  arrange(desc(n))
SALIDA
# A tibble: 13 × 2
   gene_biotype                           n
   <chr>                              <int>
 1 protein_coding                      1321
 2 lncRNA                                69
 3 processed_pseudogene                  59
 4 miRNA                                  7
 5 snoRNA                                 5
 6 TEC                                    4
 7 polymorphic_pseudogene                 2
 8 unprocessed_pseudogene                 2
 9 IG_C_gene                              1
10 scaRNA                                 1
11 transcribed_processed_pseudogene       1
12 transcribed_unitary_pseudogene         1
13 transcribed_unprocessed_pseudogene     1
R
## 4.
rna |>
  filter(phenotype_description == "abnormal DNA methylation") |>
  group_by(gene, time) |>
  summarise(mean_expression = mean(log(expression))) |>
  arrange()
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
SALIDA
# A tibble: 6 × 3
# Groups:   gene [2]
  gene   time mean_expression
  <chr> <dbl>           <dbl>
1 Xist      0            6.95
2 Xist      4            6.34
3 Xist      8            7.13
4 Zdbf2     0            6.27
5 Zdbf2     4            6.27
6 Zdbf2     8            6.19
Reestructuración de datos
En el tibble rna, las filas contienen valores de
expresión (la unidad) que están asociados a una combinación de otras 2
variables: gene y sample.
Todas las demás columnas corresponden a variables que describen la muestra (organism, age, sex, …) o el gen (gene_biotype, ENTREZ_ID, product, …). Las variables que no varían según los genes o las muestras tendrán el mismo valor en todas las filas.
R
rna |>
  arrange(gene)
SALIDA
# A tibble: 32,428 × 19
   gene     sample expression organism   age sex   infection strain  time tissue
   <chr>    <chr>       <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 AI504432 GSM25…       1230 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 AI504432 GSM25…       1085 Mus mus…     8 Fema… NonInfec… C57BL…     0 Cereb…
 3 AI504432 GSM25…        969 Mus mus…     8 Fema… NonInfec… C57BL…     0 Cereb…
 4 AI504432 GSM25…       1284 Mus mus…     8 Fema… Influenz… C57BL…     4 Cereb…
 5 AI504432 GSM25…        966 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 6 AI504432 GSM25…        918 Mus mus…     8 Male  Influenz… C57BL…     8 Cereb…
 7 AI504432 GSM25…        985 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 AI504432 GSM25…        972 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 9 AI504432 GSM25…       1000 Mus mus…     8 Fema… Influenz… C57BL…     4 Cereb…
10 AI504432 GSM25…        816 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
Esta estructura se denomina long-format, ya que una
columna contiene todos los valores y las demás columnas enumeran el
contexto de dicho valor.
En ciertos casos, el long-format no es realmente
«legible para el ser humano» y se prefiere otro formato, el
wide-format, como una forma más compacta de representar los
datos. Este es el caso habitual de los valores de expresión génica, que
los científicos suelen ver como matrices, donde las filas representan
los genes y las columnas las muestras.
En este formato, resultaría, por lo tanto, sencillo explorar la relación entre los niveles de expresión génica dentro de las muestras y entre ellas.
SALIDA
# A tibble: 1,474 × 23
   gene    GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
   <chr>        <dbl>      <dbl>      <dbl>      <dbl>      <dbl>      <dbl>
 1 Asl           1170        361        400        586        626        988
 2 Apod         36194      10347       9173      10620      13021      29594
 3 Cyp2d22       4060       1616       1603       1901       2171       3349
 4 Klk6           287        629        641        578        448        195
 5 Fcrls           85        233        244        237        180         38
 6 Slc2a4         782        231        248        265        313        786
 7 Exd2          1619       2288       2235       2513       2366       1359
 8 Gjc2           288        595        568        551        310        146
 9 Plp1         43217     101241      96534      58354      53126      27173
10 Gnb4          1071       1791       1867       1430       1355        798
# ℹ 1,464 more rows
# ℹ 16 more variables: GSM2545342 <dbl>, GSM2545343 <dbl>, GSM2545344 <dbl>,
#   GSM2545345 <dbl>, GSM2545346 <dbl>, GSM2545347 <dbl>, GSM2545348 <dbl>,
#   GSM2545349 <dbl>, GSM2545350 <dbl>, GSM2545351 <dbl>, GSM2545352 <dbl>,
#   GSM2545353 <dbl>, GSM2545354 <dbl>, GSM2545362 <dbl>, GSM2545363 <dbl>,
#   GSM2545380 <dbl>
Para convertir los valores de expresión génica de rna a
un formato ancho, necesitamos crear una nueva tabla en la que los
valores de la columna sample se conviertan en los nombres
de las variables de columna.
El punto clave aquí es que seguimos una estructura de datos ordenada, pero hemos reconfigurado los datos según las observaciones de interés: los niveles de expresión por gen, en lugar de registrarlos por gen y por muestra.
La transformación inversa consistiría en convertir los nombres de las columnas en valores de una nueva variable.
Podemos realizar ambas transformaciones con dos funciones
tidyr, pivot_longer() y
pivot_wider() (consulte el artículo sobre pivots en el
sitio web de tidyr para más detalles).
Transformación de los datos a un formato más ancho
Seleccionemos las primeras 3 columnas de rna y
utilicemos pivot_wider() para transformar los datos a un
formato ancho.
R
rna_exp <- rna |>
  select(gene, sample, expression)
rna_exp
SALIDA
# A tibble: 32,428 × 3
   gene    sample     expression
   <chr>   <chr>           <dbl>
 1 Asl     GSM2545336       1170
 2 Apod    GSM2545336      36194
 3 Cyp2d22 GSM2545336       4060
 4 Klk6    GSM2545336        287
 5 Fcrls   GSM2545336         85
 6 Slc2a4  GSM2545336        782
 7 Exd2    GSM2545336       1619
 8 Gjc2    GSM2545336        288
 9 Plp1    GSM2545336      43217
10 Gnb4    GSM2545336       1071
# ℹ 32,418 more rows
pivot_wider acepta tres argumentos principales:
- los datos a transformar;
- el
names_from: la columna cuyos valores se convertirán en nuevos nombres de columna; - el
values_from: la columna cuyos valores llenarán las nuevas columnas.
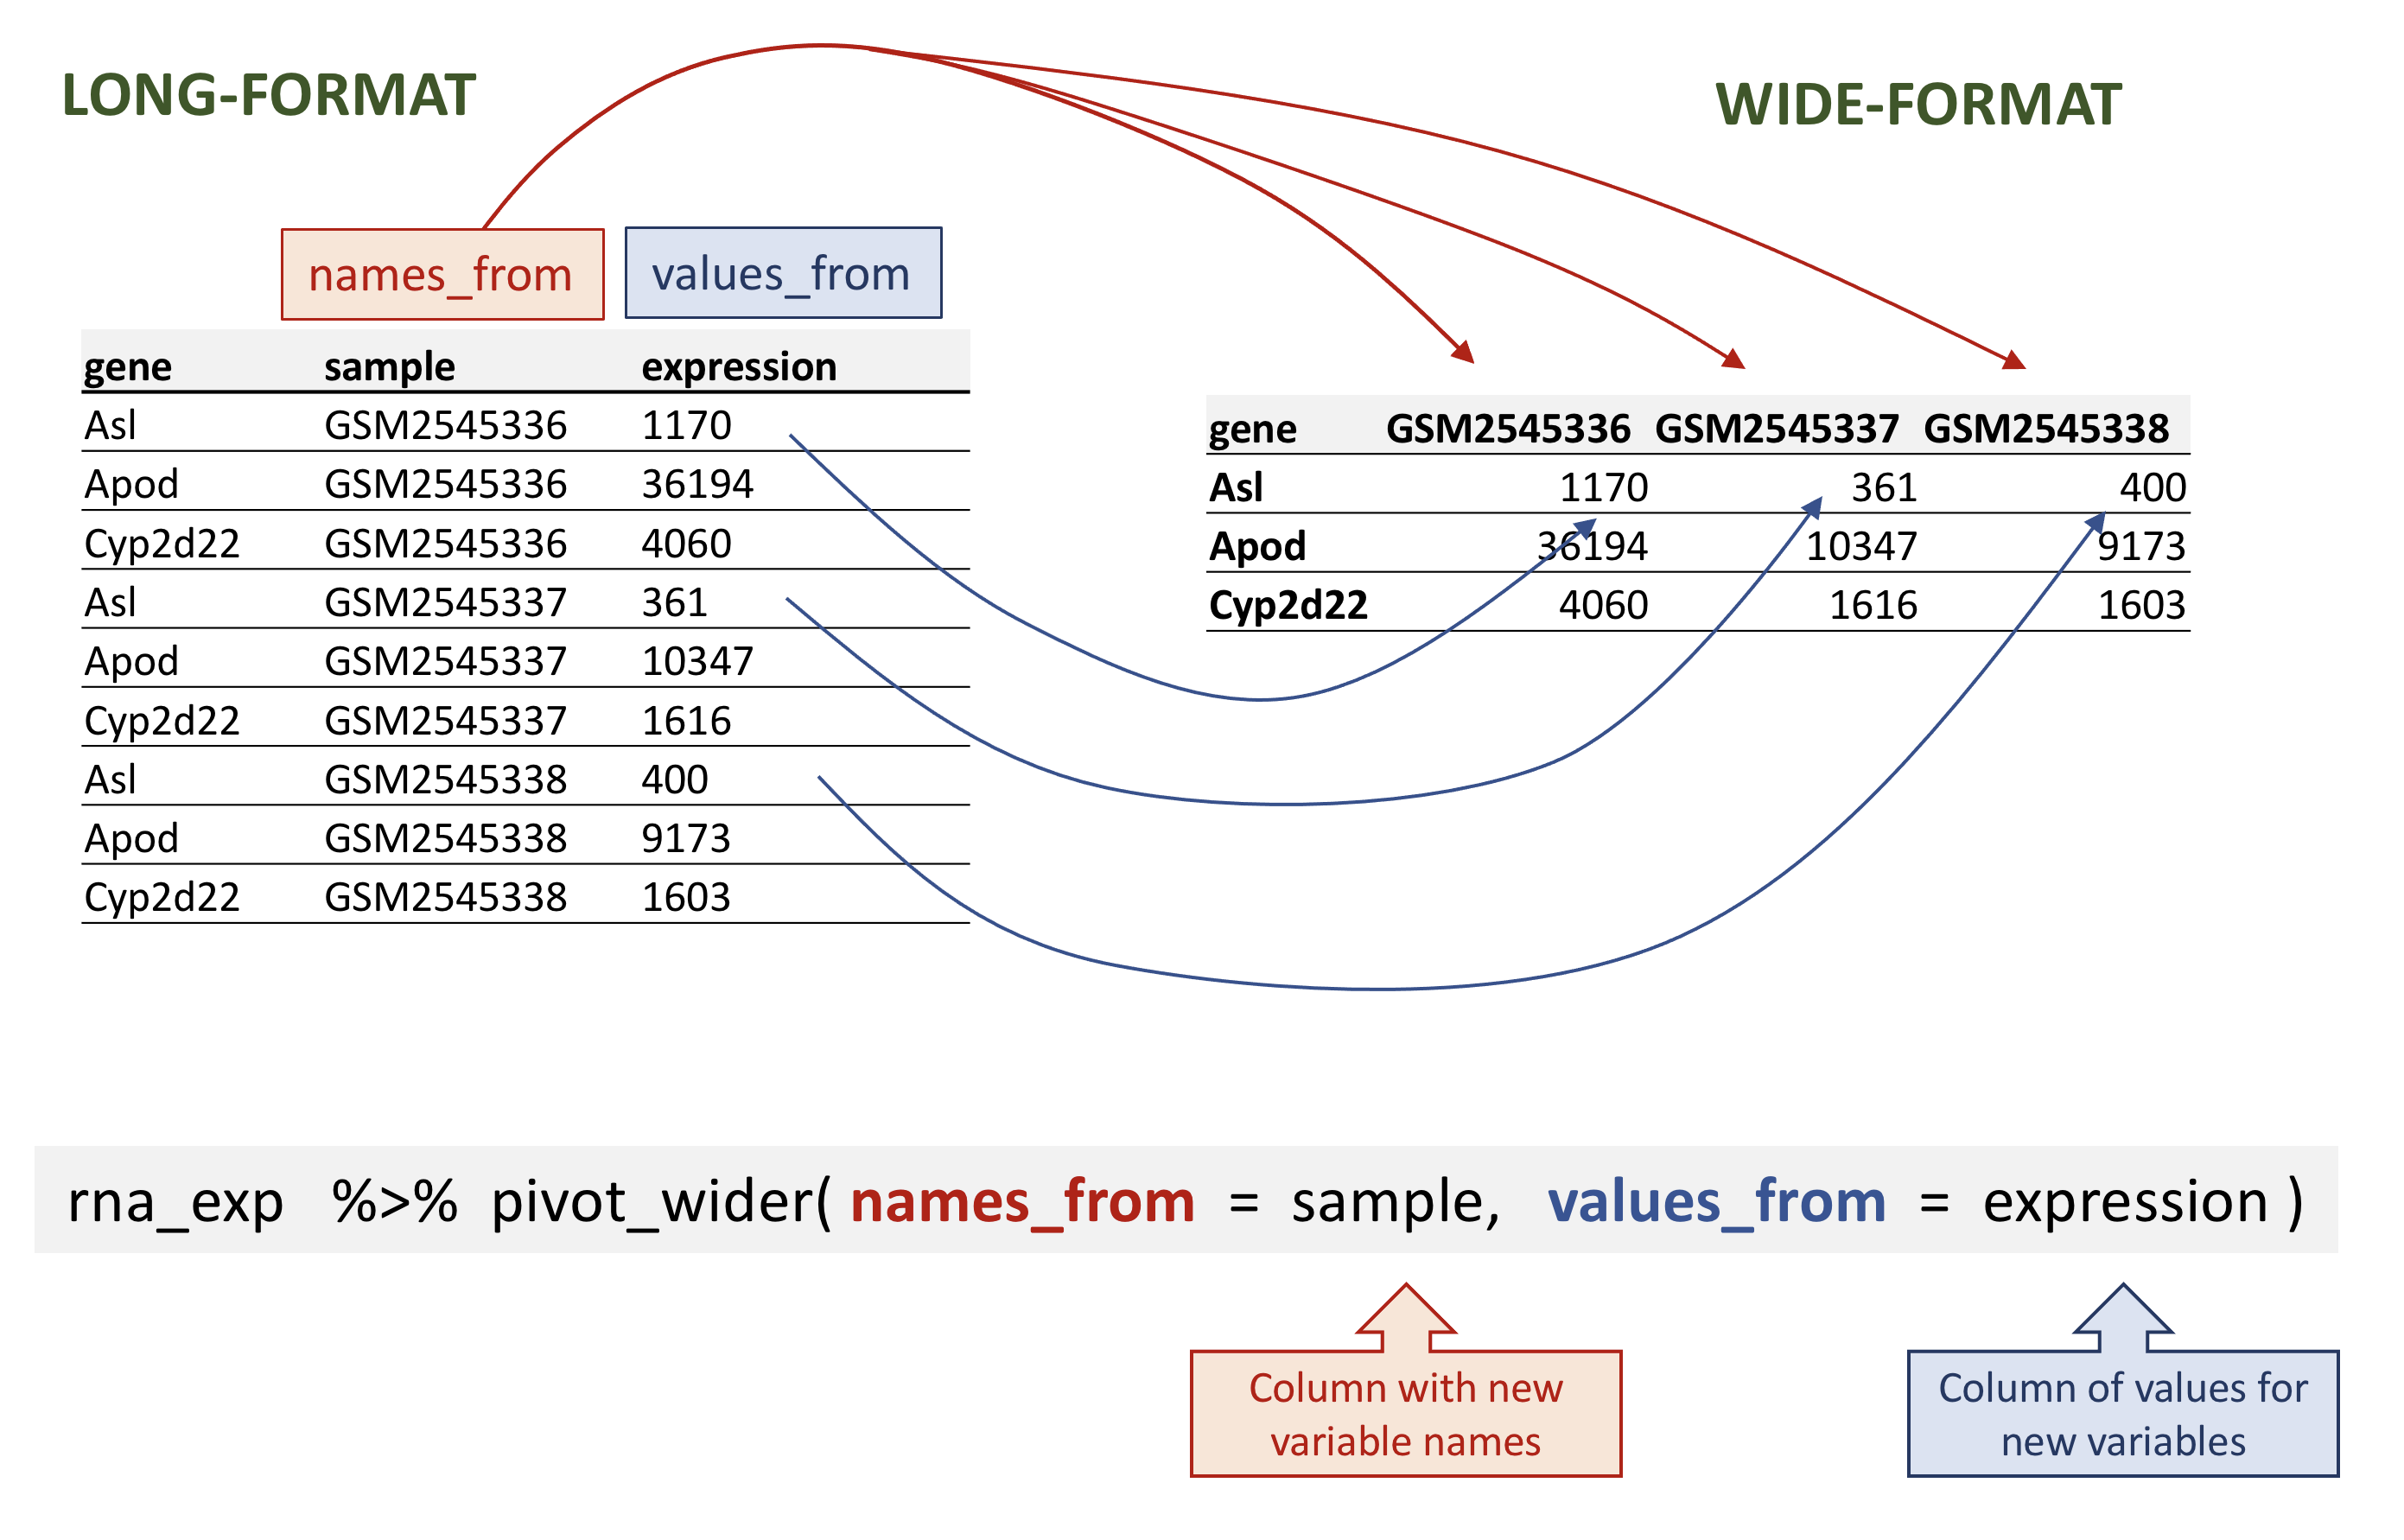
rna data.
R
rna_wide <- rna_exp |>
  pivot_wider(names_from = sample,
              values_from = expression)
rna_wide
SALIDA
# A tibble: 1,474 × 23
   gene    GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
   <chr>        <dbl>      <dbl>      <dbl>      <dbl>      <dbl>      <dbl>
 1 Asl           1170        361        400        586        626        988
 2 Apod         36194      10347       9173      10620      13021      29594
 3 Cyp2d22       4060       1616       1603       1901       2171       3349
 4 Klk6           287        629        641        578        448        195
 5 Fcrls           85        233        244        237        180         38
 6 Slc2a4         782        231        248        265        313        786
 7 Exd2          1619       2288       2235       2513       2366       1359
 8 Gjc2           288        595        568        551        310        146
 9 Plp1         43217     101241      96534      58354      53126      27173
10 Gnb4          1071       1791       1867       1430       1355        798
# ℹ 1,464 more rows
# ℹ 16 more variables: GSM2545342 <dbl>, GSM2545343 <dbl>, GSM2545344 <dbl>,
#   GSM2545345 <dbl>, GSM2545346 <dbl>, GSM2545347 <dbl>, GSM2545348 <dbl>,
#   GSM2545349 <dbl>, GSM2545350 <dbl>, GSM2545351 <dbl>, GSM2545352 <dbl>,
#   GSM2545353 <dbl>, GSM2545354 <dbl>, GSM2545362 <dbl>, GSM2545363 <dbl>,
#   GSM2545380 <dbl>
Tenga en cuenta que, por defecto, la función
pivot_wider() añadirá NA para los valores
faltantes.
Imaginemos que, por alguna razón, tuviéramos algunos valores de expresión faltantes para ciertos genes en determinadas muestras. En el siguiente ejemplo ficticio, el gen Cyp2d22 tiene un único valor de expresión, en la muestra GSM2545338.
R
rna_with_missing_values <- rna |>
  select(gene, sample, expression) |>
  filter(gene %in% c("Asl", "Apod", "Cyp2d22")) |>
  filter(sample %in% c("GSM2545336", "GSM2545337", "GSM2545338")) |>
  arrange(sample) |>
  filter(!(gene == "Cyp2d22" & sample != "GSM2545338"))
rna_with_missing_values
SALIDA
# A tibble: 7 × 3
  gene    sample     expression
  <chr>   <chr>           <dbl>
1 Asl     GSM2545336       1170
2 Apod    GSM2545336      36194
3 Asl     GSM2545337        361
4 Apod    GSM2545337      10347
5 Asl     GSM2545338        400
6 Apod    GSM2545338       9173
7 Cyp2d22 GSM2545338       1603
Por defecto, la función pivot_wider() añadirá
NA para los valores faltantes. Esto puede configurarse
mediante el argumento values_fill de la función
pivot_wider().
R
rna_with_missing_values |>
  pivot_wider(names_from = sample,
              values_from = expression)
SALIDA
# A tibble: 3 × 4
  gene    GSM2545336 GSM2545337 GSM2545338
  <chr>        <dbl>      <dbl>      <dbl>
1 Asl           1170        361        400
2 Apod         36194      10347       9173
3 Cyp2d22         NA         NA       1603
R
rna_with_missing_values |>
  pivot_wider(names_from = sample,
              values_from = expression,
              values_fill = 0)
SALIDA
# A tibble: 3 × 4
  gene    GSM2545336 GSM2545337 GSM2545338
  <chr>        <dbl>      <dbl>      <dbl>
1 Asl           1170        361        400
2 Apod         36194      10347       9173
3 Cyp2d22          0          0       1603
Conversión de datos a un formato más largo
En el caso opuesto, utilizamos los nombres de las columnas y los convertimos en un par de nuevas variables. Una variable representa los nombres de las columnas como valores, y la otra variable contiene los valores previamente asociados a los nombres de las columnas.
pivot_longer() acepta cuatro argumentos principales:
- los datos a transformar;
- el
names_to: el nombre de la nueva columna que queremos crear y llenar con los nombres de las columnas actuales; - el
values_to: el nombre de la nueva columna que queremos crear y llenar con los valores actuales; - los nombres de las columnas que se utilizarán para completar las
variables
names_toyvalues_to(o las columnas que se excluirán de la transformación).
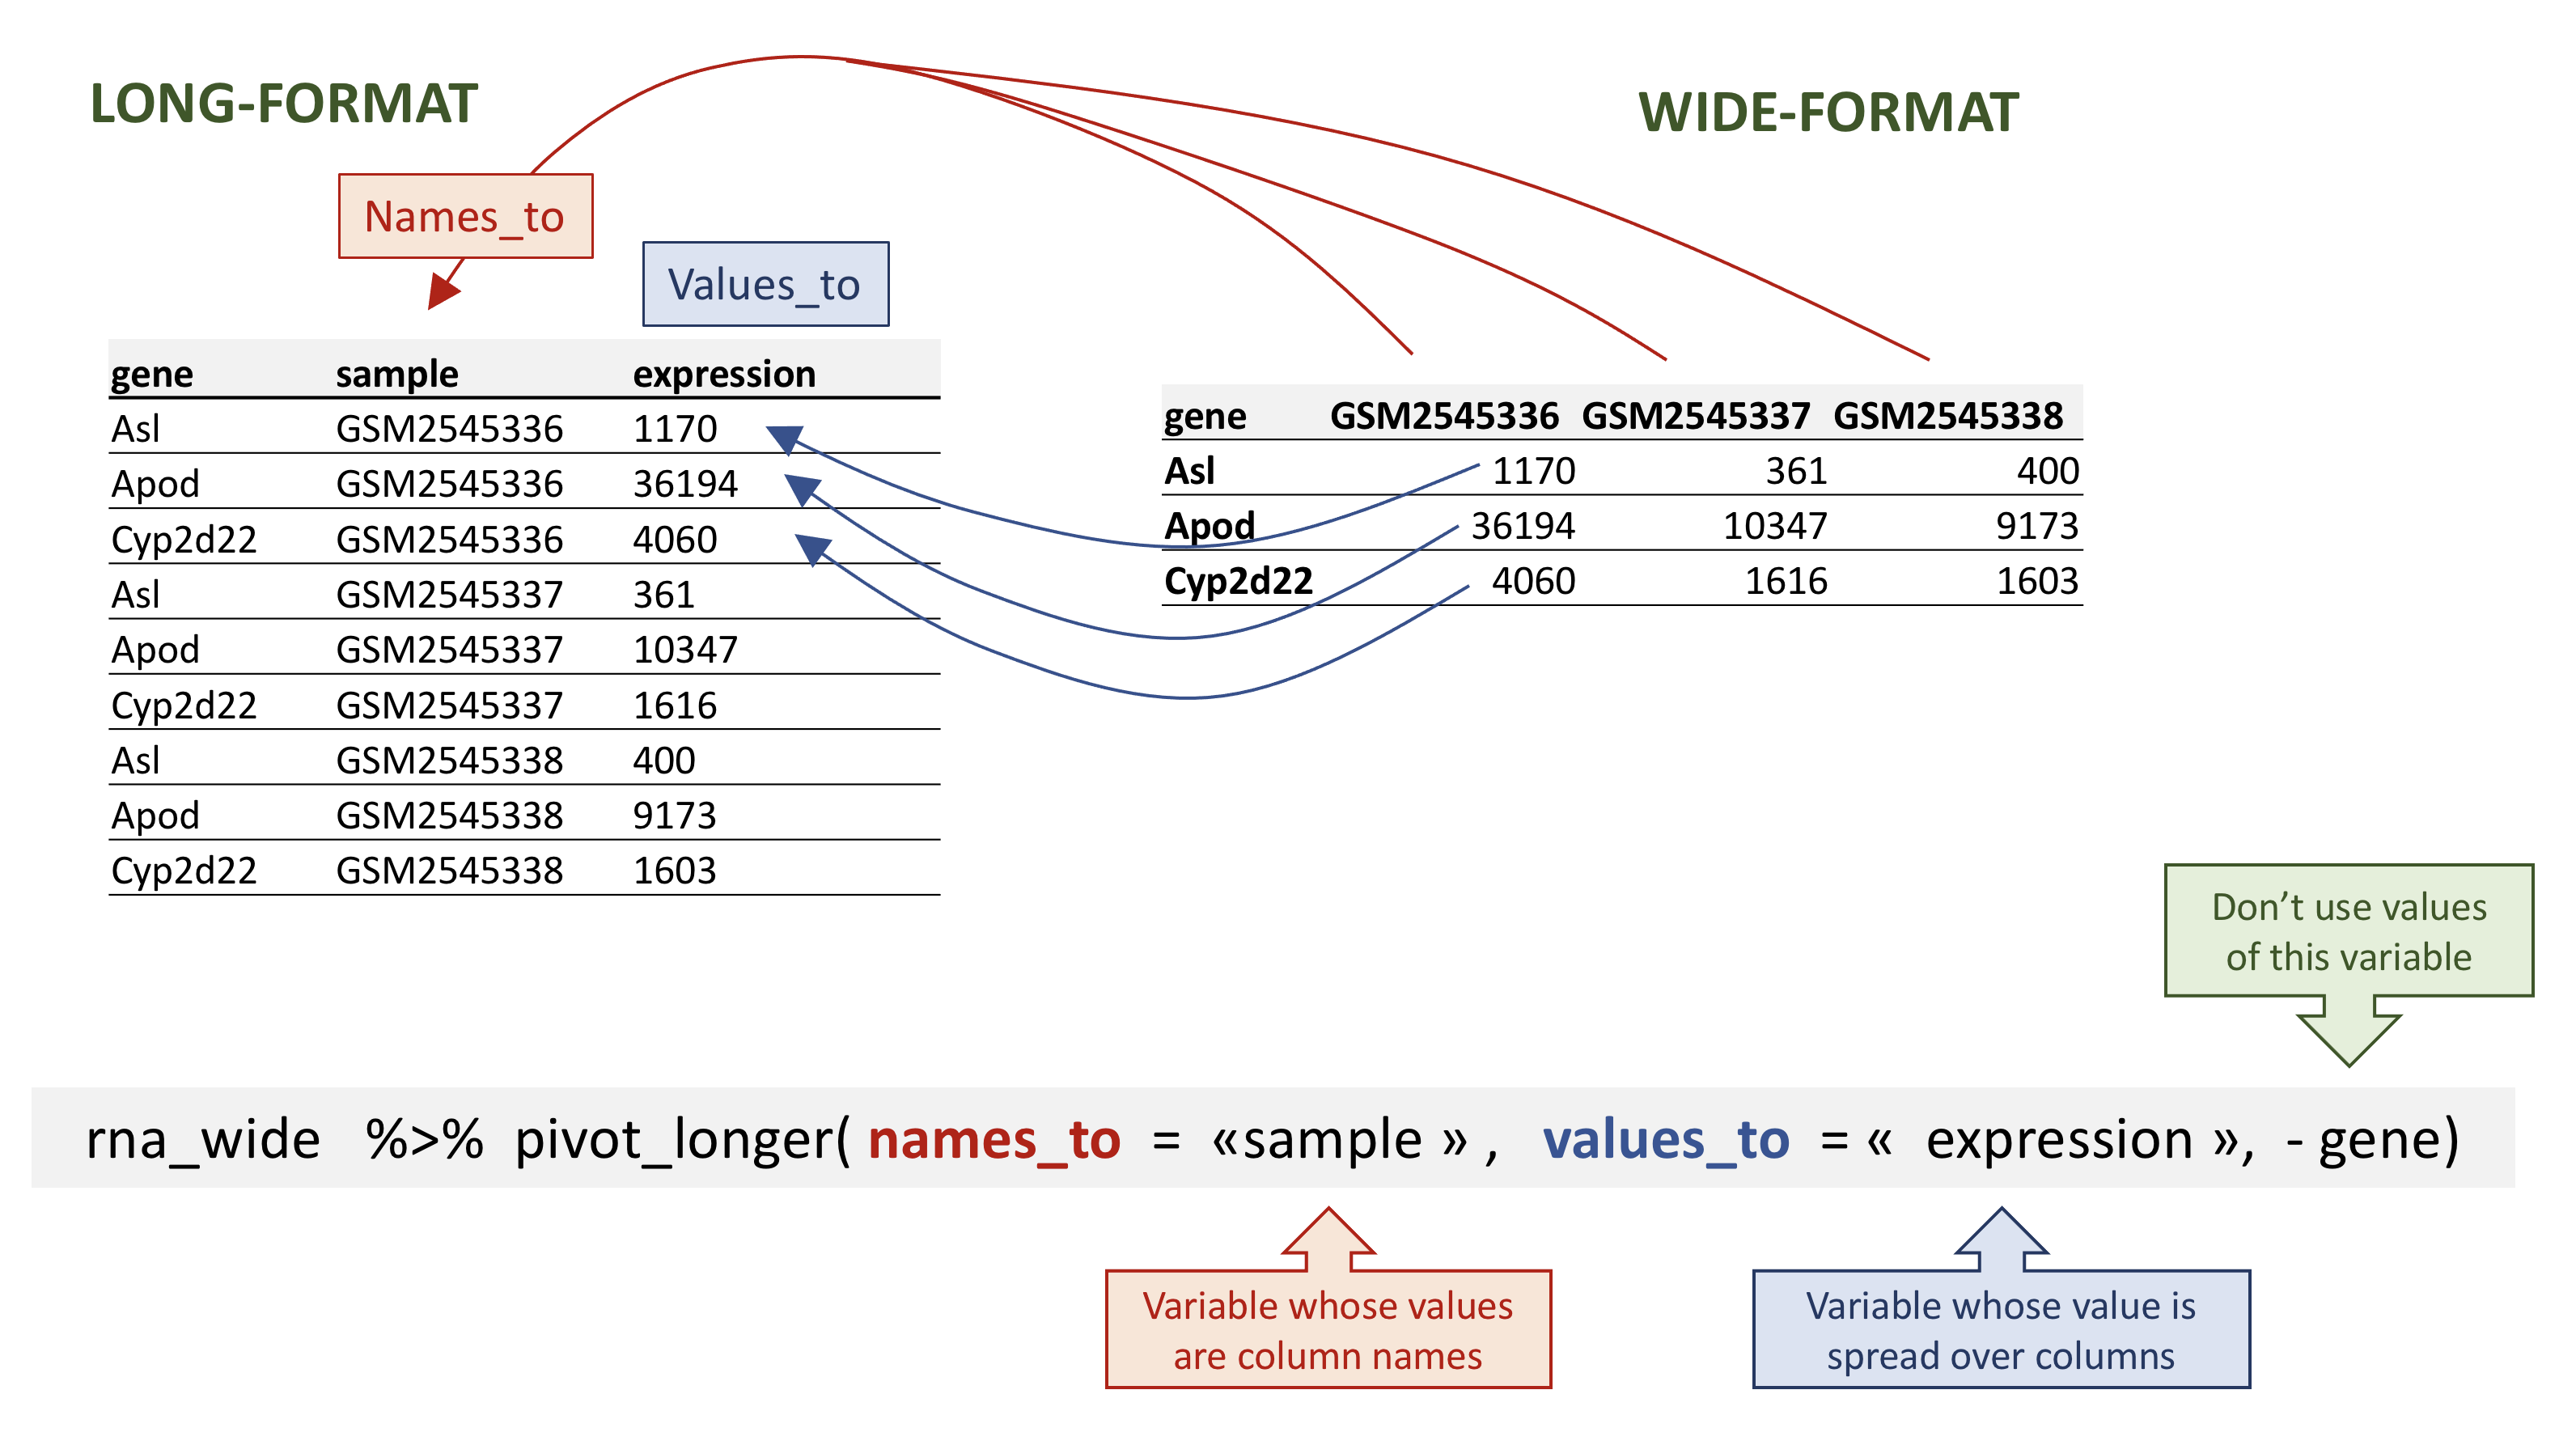
rna data.
Para recrear rna_long a partir de rna_wide,
crearíamos una clave llamada sample y un valor llamado
expression, y utilizaríamos todas las columnas excepto
gene para la variable clave. Aquí excluimos la columna
gene de la transformación con un signo menos.
Observe cómo los nombres de las nuevas variables deben ir entre comillas aquí.
R
rna_long <- rna_wide |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 -gene)
rna_long
SALIDA
# A tibble: 32,428 × 3
   gene  sample     expression
   <chr> <chr>           <dbl>
 1 Asl   GSM2545336       1170
 2 Asl   GSM2545337        361
 3 Asl   GSM2545338        400
 4 Asl   GSM2545339        586
 5 Asl   GSM2545340        626
 6 Asl   GSM2545341        988
 7 Asl   GSM2545342        836
 8 Asl   GSM2545343        535
 9 Asl   GSM2545344        586
10 Asl   GSM2545345        597
# ℹ 32,418 more rows
También podríamos haber utilizado una especificación sobre qué
columnas incluir. Esto puede resultar útil si se dispone de un gran
número de columnas identificativas, y resulta más sencillo especificar
qué recopilar que qué dejar fuera. ¡Aquí la función
starts_with() puede ayudar a recuperar los nombres de las
muestras sin tener que enumerarlas todas! ¡Otra posibilidad sería
utilizar el operador :!
R
rna_wide |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 cols = starts_with("GSM"))
SALIDA
# A tibble: 32,428 × 3
   gene  sample     expression
   <chr> <chr>           <dbl>
 1 Asl   GSM2545336       1170
 2 Asl   GSM2545337        361
 3 Asl   GSM2545338        400
 4 Asl   GSM2545339        586
 5 Asl   GSM2545340        626
 6 Asl   GSM2545341        988
 7 Asl   GSM2545342        836
 8 Asl   GSM2545343        535
 9 Asl   GSM2545344        586
10 Asl   GSM2545345        597
# ℹ 32,418 more rows
R
rna_wide |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 GSM2545336:GSM2545380)
SALIDA
# A tibble: 32,428 × 3
   gene  sample     expression
   <chr> <chr>           <dbl>
 1 Asl   GSM2545336       1170
 2 Asl   GSM2545337        361
 3 Asl   GSM2545338        400
 4 Asl   GSM2545339        586
 5 Asl   GSM2545340        626
 6 Asl   GSM2545341        988
 7 Asl   GSM2545342        836
 8 Asl   GSM2545343        535
 9 Asl   GSM2545344        586
10 Asl   GSM2545345        597
# ℹ 32,418 more rows
Tenga en cuenta que, si tuviéramos valores faltantes en el formato
ancho, el NA se incluiría en el nuevo formato largo.
Recuerde nuestro tibble ficticio anterior que contenía valores faltantes:
R
rna_with_missing_values
SALIDA
# A tibble: 7 × 3
  gene    sample     expression
  <chr>   <chr>           <dbl>
1 Asl     GSM2545336       1170
2 Apod    GSM2545336      36194
3 Asl     GSM2545337        361
4 Apod    GSM2545337      10347
5 Asl     GSM2545338        400
6 Apod    GSM2545338       9173
7 Cyp2d22 GSM2545338       1603
R
wide_with_NA <- rna_with_missing_values |>
  pivot_wider(names_from = sample,
              values_from = expression)
wide_with_NA
SALIDA
# A tibble: 3 × 4
  gene    GSM2545336 GSM2545337 GSM2545338
  <chr>        <dbl>      <dbl>      <dbl>
1 Asl           1170        361        400
2 Apod         36194      10347       9173
3 Cyp2d22         NA         NA       1603
R
wide_with_NA |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 -gene)
SALIDA
# A tibble: 9 × 3
  gene    sample     expression
  <chr>   <chr>           <dbl>
1 Asl     GSM2545336       1170
2 Asl     GSM2545337        361
3 Asl     GSM2545338        400
4 Apod    GSM2545336      36194
5 Apod    GSM2545337      10347
6 Apod    GSM2545338       9173
7 Cyp2d22 GSM2545336         NA
8 Cyp2d22 GSM2545337         NA
9 Cyp2d22 GSM2545338       1603
Realizar un pivote a formatos ancho y largo puede ser una forma útil de equilibrar un conjunto de datos para que cada réplica tenga la misma composición.
Pregunta
Partiendo de la tabla rna, utilice la función
pivot_wider() para crear una tabla en formato ancho que
muestre los niveles de expresión génica en cada ratón. A continuación,
utilice la función pivot_longer() para restaurar una tabla
en formato largo.
R
rna1 <- rna |>
select(gene, mouse, expression) |>
pivot_wider(names_from = mouse, values_from = expression)
rna1
SALIDA
# A tibble: 1,474 × 23
   gene     `14`    `9`  `10`  `15`  `18`   `6`   `5`  `11`  `22`  `13`  `23`
   <chr>   <dbl>  <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
 1 Asl      1170    361   400   586   626   988   836   535   586   597   938
 2 Apod    36194  10347  9173 10620 13021 29594 24959 13668 13230 15868 27769
 3 Cyp2d22  4060   1616  1603  1901  2171  3349  3122  2008  2254  2277  2985
 4 Klk6      287    629   641   578   448   195   186  1101   537   567   327
 5 Fcrls      85    233   244   237   180    38    68   375   199   177    89
 6 Slc2a4    782    231   248   265   313   786   528   249   266   357   654
 7 Exd2     1619   2288  2235  2513  2366  1359  1474  3126  2379  2173  1531
 8 Gjc2      288    595   568   551   310   146   186   791   454   370   240
 9 Plp1    43217 101241 96534 58354 53126 27173 28728 98658 61356 61647 38019
10 Gnb4     1071   1791  1867  1430  1355   798   806  2437  1394  1554   960
# ℹ 1,464 more rows
# ℹ 11 more variables: `24` <dbl>, `8` <dbl>, `7` <dbl>, `1` <dbl>, `16` <dbl>,
#   `21` <dbl>, `4` <dbl>, `2` <dbl>, `20` <dbl>, `12` <dbl>, `19` <dbl>
R
rna1 |>
pivot_longer(names_to = "mouse_id", values_to = "counts", -gene)
SALIDA
# A tibble: 32,428 × 3
   gene  mouse_id counts
   <chr> <chr>     <dbl>
 1 Asl   14         1170
 2 Asl   9           361
 3 Asl   10          400
 4 Asl   15          586
 5 Asl   18          626
 6 Asl   6           988
 7 Asl   5           836
 8 Asl   11          535
 9 Asl   22          586
10 Asl   13          597
# ℹ 32,418 more rowsPregunta
Extraiga los genes ubicados en los cromosomas X e Y de la tabla de
datos rna y despliegue la tabla de datos con
sex como columnas, chromosome_name como filas
y la expresión media de los genes ubicados en cada cromosoma como
valores, como en el siguiente tibble:
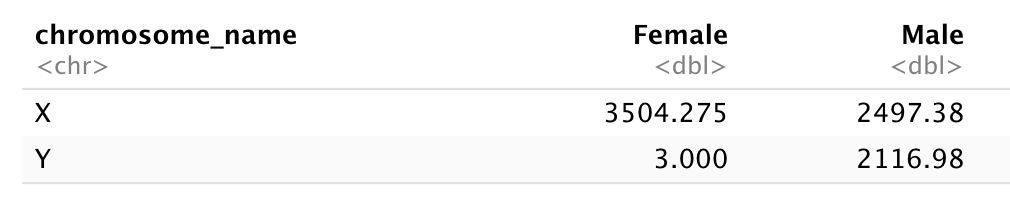
¡Tendrá que resumir antes de reestructurar!
Primero calculemos el nivel medio de expresión de los genes situados en los cromosomas X e Y en las muestras de ratones machos y hembras…
R
 rna |>
  filter(chromosome_name == "Y" | chromosome_name == "X") |>
  group_by(sex, chromosome_name) |>
  summarise(mean = mean(expression))
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by sex and chromosome_name.
ℹ Output is grouped by sex.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(sex, chromosome_name))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
SALIDA
# A tibble: 4 × 3
# Groups:   sex [2]
  sex    chromosome_name  mean
  <chr>  <chr>           <dbl>
1 Female X               3504.
2 Female Y                  3
3 Male   X               2497.
4 Male   Y               2117.
Y pivotar la tabla a formato ancho
R
rna_1 <- rna |>
  filter(chromosome_name == "Y" | chromosome_name == "X") |>
  group_by(sex, chromosome_name) |>
  summarise(mean = mean(expression)) |>
  pivot_wider(names_from = sex,
              values_from = mean)
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by sex and chromosome_name.
ℹ Output is grouped by sex.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(sex, chromosome_name))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
rna_1
SALIDA
# A tibble: 2 × 3
  chromosome_name Female  Male
  <chr>            <dbl> <dbl>
1 X                3504. 2497.
2 Y                   3  2117.
Ahora toma esa tabla de datos y transfórmala con
pivot_longer() para que cada fila sea una combinación única
de chromosome_name por gender.
R
rna_1 |>
  pivot_longer(names_to = "gender",
               values_to = "mean",
               -chromosome_name)
SALIDA
# A tibble: 4 × 3
  chromosome_name gender  mean
  <chr>           <chr>  <dbl>
1 X               Female 3504.
2 X               Male   2497.
3 Y               Female    3
4 Y Male 2117.Pregunta
Utilice la tabla de datos rna para crear una matriz de
expresión en la que cada fila represente los niveles de expresión
promedio de los genes y las columnas representen los diferentes puntos
temporales.
Primero, calculemos la expresión media por gen y por momento.
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression))
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
SALIDA
# A tibble: 4,422 × 3
# Groups:   gene [1,474]
   gene      time mean_exp
   <chr>    <dbl>    <dbl>
 1 AI504432     0    1034.
 2 AI504432     4    1104.
 3 AI504432     8    1014
 4 AW046200     0     155.
 5 AW046200     4     152.
 6 AW046200     8      81
 7 AW551984     0     238
 8 AW551984     4     302.
 9 AW551984     8     342.
10 Aamp         0    4603.
# ℹ 4,412 more rows
antes de utilizar la función pivot_wider()
R
rna_time <- rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp)
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
rna_time
SALIDA
# A tibble: 1,474 × 4
# Groups:   gene [1,474]
   gene         `0`     `4`     `8`
   <chr>      <dbl>   <dbl>   <dbl>
 1 AI504432 1034.   1104.   1014
 2 AW046200  155.    152.     81
 3 AW551984  238     302.    342.
 4 Aamp     4603.   4870    4763.
 5 Abca12      5.29    4.25    4.14
 6 Abcc8    2576.   2609.   2292.
 7 Abhd14a   591.    547.    432.
 8 Abi2     4881.   4903.   4945.
 9 Abi3bp   1175.   1061.    762.
10 Abl2     2170.   2078.   2131.
# ℹ 1,464 more rows
Nótese que esto genera un tibble con algunos nombres de columna que comienzan con un número. Si quisiéramos seleccionar la columna correspondiente a los puntos temporales, no podríamos usar los nombres de las columnas directamente… ¿Qué sucede cuando seleccionamos la columna 4?
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  select(gene, 4)
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
SALIDA
# A tibble: 1,474 × 2
# Groups:   gene [1,474]
   gene         `8`
   <chr>      <dbl>
 1 AI504432 1014
 2 AW046200   81
 3 AW551984  342.
 4 Aamp     4763.
 5 Abca12      4.14
 6 Abcc8    2292.
 7 Abhd14a   432.
 8 Abi2     4945.
 9 Abi3bp    762.
10 Abl2     2131.
# ℹ 1,464 more rows
Para seleccionar el punto temporal 4, tendríamos que encerrar el nombre de la columna entre comillas invertidas (backticks): “`”
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  select(gene, `4`)
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
SALIDA
# A tibble: 1,474 × 2
# Groups:   gene [1,474]
   gene         `4`
   <chr>      <dbl>
 1 AI504432 1104.
 2 AW046200  152.
 3 AW551984  302.
 4 Aamp     4870
 5 Abca12      4.25
 6 Abcc8    2609.
 7 Abhd14a   547.
 8 Abi2     4903.
 9 Abi3bp   1061.
10 Abl2     2078.
# ℹ 1,464 more rows
Otra posibilidad sería renombrar la columna, eligiendo un nombre que no empiece con un número:
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  rename("time0" = `0`, "time4" = `4`, "time8" = `8`) |>
  select(gene, time4)
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
SALIDA
# A tibble: 1,474 × 2
# Groups:   gene [1,474]
   gene       time4
   <chr>      <dbl>
 1 AI504432 1104.
 2 AW046200  152.
 3 AW551984  302.
 4 Aamp     4870
 5 Abca12      4.25
 6 Abcc8    2609.
 7 Abhd14a   547.
 8 Abi2     4903.
 9 Abi3bp   1061.
10 Abl2     2078.
# ℹ 1,464 more rowsPregunta
Utilice la tabla de datos anterior que contiene los niveles medios de expresión por punto temporal y cree una nueva columna con los cocientes de expresión (fold-changes) entre el punto temporal 8 y el punto temporal 0, y entre el punto temporal 8 y el punto temporal 4. Convierta esta tabla en una tabla de formato largo que reúna los cocientes calculados.
Partiendo del tibble rna_time:
R
rna_time
SALIDA
# A tibble: 1,474 × 4
# Groups:   gene [1,474]
   gene         `0`     `4`     `8`
   <chr>      <dbl>   <dbl>   <dbl>
 1 AI504432 1034.   1104.   1014
 2 AW046200  155.    152.     81
 3 AW551984  238     302.    342.
 4 Aamp     4603.   4870    4763.
 5 Abca12      5.29    4.25    4.14
 6 Abcc8    2576.   2609.   2292.
 7 Abhd14a   591.    547.    432.
 8 Abi2     4881.   4903.   4945.
 9 Abi3bp   1175.   1061.    762.
10 Abl2     2170.   2078.   2131.
# ℹ 1,464 more rows
Calcule los cocientes de expresión (fold-changes):
R
rna_time |>
  mutate(time_8_vs_0 = `8` / `0`, time_8_vs_4 = `8` / `4`)
SALIDA
# A tibble: 1,474 × 6
# Groups:   gene [1,474]
   gene         `0`     `4`     `8` time_8_vs_0 time_8_vs_4
   <chr>      <dbl>   <dbl>   <dbl>       <dbl>       <dbl>
 1 AI504432 1034.   1104.   1014          0.981       0.918
 2 AW046200  155.    152.     81          0.522       0.532
 3 AW551984  238     302.    342.         1.44        1.13
 4 Aamp     4603.   4870    4763.         1.03        0.978
 5 Abca12      5.29    4.25    4.14       0.784       0.975
 6 Abcc8    2576.   2609.   2292.         0.889       0.878
 7 Abhd14a   591.    547.    432.         0.731       0.791
 8 Abi2     4881.   4903.   4945.         1.01        1.01
 9 Abi3bp   1175.   1061.    762.         0.649       0.719
10 Abl2     2170.   2078.   2131.         0.982       1.03
# ℹ 1,464 more rows
Y utilice la función pivot_longer():
R
rna_time |>
  mutate(time_8_vs_0 = `8` / `0`, time_8_vs_4 = `8` / `4`) |>
  pivot_longer(names_to = "comparisons",
               values_to = "Fold_changes",
               time_8_vs_0:time_8_vs_4)
SALIDA
# A tibble: 2,948 × 6
# Groups:   gene [1,474]
   gene         `0`     `4`     `8` comparisons Fold_changes
   <chr>      <dbl>   <dbl>   <dbl> <chr>              <dbl>
 1 AI504432 1034.   1104.   1014    time_8_vs_0        0.981
 2 AI504432 1034.   1104.   1014    time_8_vs_4        0.918
 3 AW046200  155.    152.     81    time_8_vs_0        0.522
 4 AW046200  155.    152.     81    time_8_vs_4        0.532
 5 AW551984  238     302.    342.   time_8_vs_0        1.44
 6 AW551984  238     302.    342.   time_8_vs_4        1.13
 7 Aamp     4603.   4870    4763.   time_8_vs_0        1.03
 8 Aamp     4603.   4870    4763.   time_8_vs_4        0.978
 9 Abca12      5.29    4.25    4.14 time_8_vs_0        0.784
10 Abca12      5.29    4.25    4.14 time_8_vs_4        0.975
# ℹ 2,938 more rows
Unión de tablas
En muchas situaciones reales, los datos se distribuyen entre múltiples tablas. Por lo general, esto ocurre porque se recopilan diferentes tipos de información de diversas fuentes.
Para algunos análisis, puede resultar conveniente combinar datos de dos o más tablas en una única tabla de datos basándose en una columna común a todas ellas.
El paquete dplyr proporciona un conjunto de funciones de
unión para combinar dos tablas de datos basándose en coincidencias
dentro de columnas especificadas. A continuación, presentamos una breve
introducción a las uniones. Para lectura adicional, consulte el capítulo
sobre uniones
de tablas. La Hoja
de trucos de transformación de datos también ofrece una breve
descripción general de las uniones de tablas.
Vamos a ilustrar la unión utilizando una tabla pequeña,
rna_mini, que crearemos mediante un subconjunto de la tabla
original rna, manteniendo solo 3 columnas y 10 filas.
R
rna_mini <- rna |>
   select(gene, sample, expression) |>
   head(10)
rna_mini
SALIDA
# A tibble: 10 × 3
   gene    sample     expression
   <chr>   <chr>           <dbl>
 1 Asl     GSM2545336       1170
 2 Apod    GSM2545336      36194
 3 Cyp2d22 GSM2545336       4060
 4 Klk6    GSM2545336        287
 5 Fcrls   GSM2545336         85
 6 Slc2a4  GSM2545336        782
 7 Exd2    GSM2545336       1619
 8 Gjc2    GSM2545336        288
 9 Plp1    GSM2545336      43217
10 Gnb4    GSM2545336       1071
La segunda tabla, annot1, contiene 2 columnas: gene y
gene_description. Puede descargar
annot1.csv haciendo clic en el enlace y luego moverla a la carpeta
data/, o puede utilizar el código de R a continuación para
descargarla directamente en la carpeta.
R
download.file(url = "https://carpentries-incubator.github.io/bioc-intro/data/annot1.csv",
              destfile = "data/annot1.csv")
annot1 <- read_csv(file = "data/annot1.csv")
annot1
SALIDA
# A tibble: 10 × 2
   gene    gene_description
   <chr>   <chr>
 1 Cyp2d22 cytochrome P450, family 2, subfamily d, polypeptide 22 [Source:MGI S…
 2 Klk6    kallikrein related-peptidase 6 [Source:MGI Symbol;Acc:MGI:1343166]
 3 Fcrls   Fc receptor-like S, scavenger receptor [Source:MGI Symbol;Acc:MGI:19…
 4 Plp1    proteolipid protein (myelin) 1 [Source:MGI Symbol;Acc:MGI:97623]
 5 Exd2    exonuclease 3'-5' domain containing 2 [Source:MGI Symbol;Acc:MGI:192…
 6 Apod    apolipoprotein D [Source:MGI Symbol;Acc:MGI:88056]
 7 Gnb4    guanine nucleotide binding protein (G protein), beta 4 [Source:MGI S…
 8 Slc2a4  solute carrier family 2 (facilitated glucose transporter), member 4 …
 9 Asl     argininosuccinate lyase [Source:MGI Symbol;Acc:MGI:88084]
10 Gjc2    gap junction protein, gamma 2 [Source:MGI Symbol;Acc:MGI:2153060]
Ahora queremos unir estas dos tablas en una sola que contenga todas
las variables utilizando la función full_join() del paquete
dplyr. La función encontrará automáticamente la variable
común para emparejar las columnas de la primera y la segunda tabla. En
este caso, gene es la variable común. Tales variables se
denominan claves. Las claves se utilizan para relacionar observaciones
entre diferentes tablas.
R
full_join(rna_mini, annot1)
SALIDA
Joining with `by = join_by(gene)`SALIDA
# A tibble: 10 × 4
   gene    sample     expression gene_description
   <chr>   <chr>           <dbl> <chr>
 1 Asl     GSM2545336       1170 argininosuccinate lyase [Source:MGI Symbol;Acc…
 2 Apod    GSM2545336      36194 apolipoprotein D [Source:MGI Symbol;Acc:MGI:88…
 3 Cyp2d22 GSM2545336       4060 cytochrome P450, family 2, subfamily d, polype…
 4 Klk6    GSM2545336        287 kallikrein related-peptidase 6 [Source:MGI Sym…
 5 Fcrls   GSM2545336         85 Fc receptor-like S, scavenger receptor [Source…
 6 Slc2a4  GSM2545336        782 solute carrier family 2 (facilitated glucose t…
 7 Exd2    GSM2545336       1619 exonuclease 3'-5' domain containing 2 [Source:…
 8 Gjc2    GSM2545336        288 gap junction protein, gamma 2 [Source:MGI Symb…
 9 Plp1    GSM2545336      43217 proteolipid protein (myelin) 1 [Source:MGI Sym…
10 Gnb4    GSM2545336       1071 guanine nucleotide binding protein (G protein)…
En la práctica, las anotaciones de genes a veces se etiquetan de manera diferente.
La tabla annot2 es exactamente igual que la
annot1, excepto que la variable que contiene los nombres de
los genes está etiquetada de manera diferente. Nuevamente, puede descargar
annot2.csv usted mismo y moverla a data/ o utilizar el
código de R a continuación.
R
download.file(url = "https://carpentries-incubator.github.io/bioc-intro/data/annot2.csv",
              destfile = "data/annot2.csv")
annot2 <- read_csv(file = "data/annot2.csv")
annot2
SALIDA
# A tibble: 10 × 2
   external_gene_name description
   <chr>              <chr>
 1 Cyp2d22            cytochrome P450, family 2, subfamily d, polypeptide 22 [S…
 2 Klk6               kallikrein related-peptidase 6 [Source:MGI Symbol;Acc:MGI…
 3 Fcrls              Fc receptor-like S, scavenger receptor [Source:MGI Symbol…
 4 Plp1               proteolipid protein (myelin) 1 [Source:MGI Symbol;Acc:MGI…
 5 Exd2               exonuclease 3'-5' domain containing 2 [Source:MGI Symbol;…
 6 Apod               apolipoprotein D [Source:MGI Symbol;Acc:MGI:88056]
 7 Gnb4               guanine nucleotide binding protein (G protein), beta 4 [S…
 8 Slc2a4             solute carrier family 2 (facilitated glucose transporter)…
 9 Asl                argininosuccinate lyase [Source:MGI Symbol;Acc:MGI:88084]
10 Gjc2               gap junction protein, gamma 2 [Source:MGI Symbol;Acc:MGI:…
En caso de que ninguno de los nombres de las variables coincida,
podemos establecer manualmente las variables a utilizar para la
coincidencia. Estas variables pueden definirse mediante el argumento
by, como se muestra a continuación con las tablas
rna_mini y annot2.
R
full_join(rna_mini, annot2, by = c("gene" = "external_gene_name"))
SALIDA
# A tibble: 10 × 4
   gene    sample     expression description
   <chr>   <chr>           <dbl> <chr>
 1 Asl     GSM2545336       1170 argininosuccinate lyase [Source:MGI Symbol;Acc…
 2 Apod    GSM2545336      36194 apolipoprotein D [Source:MGI Symbol;Acc:MGI:88…
 3 Cyp2d22 GSM2545336       4060 cytochrome P450, family 2, subfamily d, polype…
 4 Klk6    GSM2545336        287 kallikrein related-peptidase 6 [Source:MGI Sym…
 5 Fcrls   GSM2545336         85 Fc receptor-like S, scavenger receptor [Source…
 6 Slc2a4  GSM2545336        782 solute carrier family 2 (facilitated glucose t…
 7 Exd2    GSM2545336       1619 exonuclease 3'-5' domain containing 2 [Source:…
 8 Gjc2    GSM2545336        288 gap junction protein, gamma 2 [Source:MGI Symb…
 9 Plp1    GSM2545336      43217 proteolipid protein (myelin) 1 [Source:MGI Sym…
10 Gnb4    GSM2545336       1071 guanine nucleotide binding protein (G protein)…
Como se puede observar arriba, el nombre de la variable de la primera tabla se conserva en la unida.
Desafío:
Descargue la tabla annot3 haciendo
clic en este enlace y coloque la tabla en su repositorio data/.
Utilizando la función full_join(), una las tablas
rna_mini y annot3. ¿Qué ha ocurrido con los
genes Klk6, mt-Tf, mt-Rnr1, mt-Tv,
mt-Rnr2 y mt-Tl1?
R
annot3 <- read_csv("data/annot3.csv")
full_join(rna_mini, annot3)
SALIDA
# A tibble: 15 × 4
   gene    sample     expression gene_description
   <chr>   <chr>           <dbl> <chr>
 1 Asl     GSM2545336       1170 argininosuccinate lyase [Source:MGI Symbol;Acc…
 2 Apod    GSM2545336      36194 apolipoprotein D [Source:MGI Symbol;Acc:MGI:88…
 3 Cyp2d22 GSM2545336       4060 cytochrome P450, family 2, subfamily d, polype…
 4 Klk6    GSM2545336        287 <NA>
 5 Fcrls   GSM2545336         85 Fc receptor-like S, scavenger receptor [Source…
 6 Slc2a4  GSM2545336        782 solute carrier family 2 (facilitated glucose t…
 7 Exd2    GSM2545336       1619 exonuclease 3'-5' domain containing 2 [Source:…
 8 Gjc2    GSM2545336        288 gap junction protein, gamma 2 [Source:MGI Symb…
 9 Plp1    GSM2545336      43217 proteolipid protein (myelin) 1 [Source:MGI Sym…
10 Gnb4    GSM2545336       1071 guanine nucleotide binding protein (G protein)…
11 mt-Tf   <NA>               NA mitochondrially encoded tRNA phenylalanine [So…
12 mt-Rnr1 <NA>               NA mitochondrially encoded 12S rRNA [Source:MGI S…
13 mt-Tv   <NA>               NA mitochondrially encoded tRNA valine [Source:MG…
14 mt-Rnr2 <NA>               NA mitochondrially encoded 16S rRNA [Source:MGI S…
15 mt-Tl1  <NA>               NA mitochondrially encoded tRNA leucine 1 [Source…
El gen Klk6 solo aparece en rna_mini, mientras
que los genes mt-Tf, mt-Rnr1, mt-Tv,
mt-Rnr2 y mt-Tl1 solo aparecen en la tabla
annot3. Sus respectivos valores para las variables de la
tabla han sido codificados como faltantes.
Exportación de datos
Ahora que ha aprendido a utilizar dplyr para extraer
información de sus datos brutos o resumirlos, es posible que desee
exportar estos nuevos conjuntos de datos para compartirlos con sus
colaboradores o para su archivo.
Al igual que la función read_csv() utilizada para leer
archivos CSV en R, existe una función write_csv() que
genera archivos CSV a partir de tablas de datos.
Antes de utilizar write_csv(), vamos a crear una carpeta
nueva, data_output, en nuestro directorio de trabajo donde
se almacenará este conjunto de datos generado. No queremos escribir los
conjuntos de datos generados en el mismo directorio que nuestros datos
brutos. Es una buena práctica mantenerlos separados. La carpeta
data solo debe contener los datos brutos y sin alterar, y
debe dejarse intacta para asegurarnos de no eliminarla ni modificarla.
Por el contrario, nuestro script generará el contenido del directorio
data_output, por lo que, incluso si se eliminan los
archivos que contiene, siempre podremos volver a generarlos.
Utilicemos write_csv() para guardar la tabla rna_wide
que creamos anteriormente.
R
write_csv(rna_wide, file = "data_output/rna_wide.csv")
- Datos tabulares en R utilizando el metapaquete tidyverse