
Visualización de datos
Última actualización: 2026-11-11 | Mejora esta página
Tiempo estimado: 120 minutos
Hoja de ruta
Preguntas
- Visualización en R
Objetivos
- Crear gráficos de dispersión, de cajas, de líneas, etc., utilizando ggplot.
- Configurar los ajustes universales del gráfico.
- Describa qué es el faceting y aplique el faceting en ggplot.
- Modifique la estética de un gráfico ggplot existente (incluyendo las etiquetas de los ejes y el color).
- Crear gráficos complejos y personalizados a partir de datos de una tabla de datos.
Este episodio se basa en la lección Data Analysis and Visualisation in R for Ecologists de Data Carpentries.
Visualización de datos
Comenzamos cargando los paquetes necesarios.
ggplot2 está incluido en el paquete
tidyverse.
R
library("tidyverse")
Si aún no se encuentra en el espacio de trabajo, cargue los datos que guardamos en la lección anterior.
R
rna <- read.csv("data/rnaseq.csv")
La Hoja
de trucos de visualización de datos cubrirá los conceptos básicos y
las funciones más avanzadas de ggplot2, y ayudará, además
de servir como recordatorio, a obtener una visión general de las
numerosas representaciones de datos disponibles en el paquete. Los
siguientes videotutoriales (parte 1 y parte 2) de
Thomas Lin Pedersen también son muy instructivos.
Representación gráfica con ggplot2
ggplot2 es un paquete de gráficos que facilita la
creación de gráficos complejos a partir de datos de una tabla de datos.
Proporciona una interfaz más programática para especificar qué variables
representar, cómo mostrarlas y las propiedades visuales generales. La
base teórica que sustenta a ggplot2 es la Grammar of
Graphics ( Wilkinson (2005) ). Al
utilizar este enfoque, solo necesitamos cambios mínimos si los datos
subyacentes cambian o si decidimos pasar de un gráfico de barras a un
gráfico de dispersión. Esto ayuda a crear gráficos de calidad editorial
con la mínima cantidad de ajustes y retoques.
Existe un libro sobre ggplot2 ( Wickham (2016) ) que ofrece una buena visión
general, pero está desactualizado. La tercera edición está en
preparación y estará disponible
gratuitamente en línea. La página web de ggplot2 (https://ggplot2.tidyverse.org)
proporciona una documentación amplia.
ggplot2 funciona con datos en formato «largo», es decir,
una columna por cada dimensión y una fila por cada observación. Los
datos bien estructurados le ahorrarán mucho tiempo al crear figuras con
ggplot2.
Los gráficos de ggplot se construyen paso a paso añadiendo nuevos elementos. Añadir capas de esta manera permite una gran flexibilidad y personalización de los gráficos.
La idea detrás de la Gramática de Gráficos es que puedes construir cualquier gráfico a partir de los mismos 3 componentes: (1) un conjunto de datos, (2) un sistema de coordenadas y (3) geoms — es decir, marcas visuales que representan puntos de datos 1
Para crear un ggplot, utilizaremos la siguiente plantilla básica que puede emplearse para diferentes tipos de gráficos:
ggplot(data = <DATA>, mapping = aes(<MAPPINGS>)) + <GEOM_FUNCTION>()- utilice la función
ggplot()y vincule el gráfico a una tabla de datos específica mediante el argumentodata
R
ggplot(data = rna)
- defina un mapeo (utilizando la función aesthetic
(
aes)), seleccionando las variables a representar y especificando cómo presentarlas en el gráfico, por ejemplo, como posiciones x/y o características como el tamaño, la forma, el color, etc.
R
ggplot(data = rna, mapping = aes(x = expression))
-
añada ‘geoms’ - geometrías, o representaciones gráficas de los datos en el gráfico (puntos, líneas, barras).
ggplot2ofrece muchas geometrías diferentes; hoy utilizaremos algunas comunes, entre ellas:* `geom_point()` for scatter plots, dot plots, etc. * `geom_histogram()` for histograms * `geom_boxplot()` for, well, boxplots! * `geom_line()` for trend lines, time series, etc.
Para añadir una geometría al gráfico, use el operador +.
Empecemos usando geom_histogram():
R
ggplot(data = rna, mapping = aes(x = expression)) +
  geom_histogram()
SALIDA
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.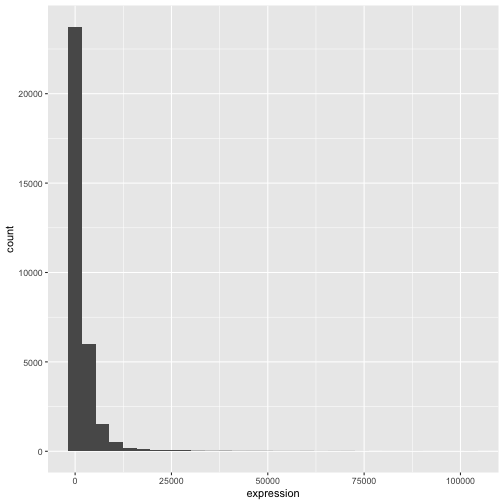
El + del paquete ggplot2 es particularmente
útil porque permite modificar objetos ggplot existentes.
Esto significa que puede configurar fácilmente plantillas de gráficos y
explorar cómodamente diferentes tipos de gráficos, por lo que el gráfico
anterior también puede generarse con un código como este:
R
# Assign plot to a variable
rna_plot <- ggplot(data = rna,
                   mapping = aes(x = expression))

# Draw the plot
rna_plot + geom_histogram()
Desafío
Probablemente hayas notado un mensaje automático que aparece al dibujar el histograma:
SALIDA
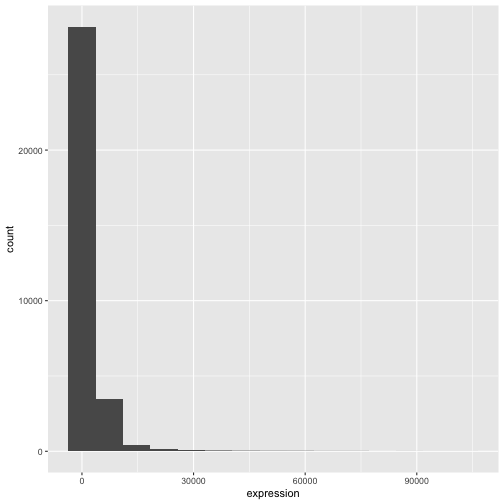
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.Cambie los argumentos bins o binwidth de
geom_histogram() para cambiar el número o el ancho de los
intervalos.
R
# change bins
ggplot(rna, aes(x = expression)) +
    geom_histogram(bins = 15)
R
# change binwidth
ggplot(rna, aes(x = expression)) +
    geom_histogram(binwidth = 2000)
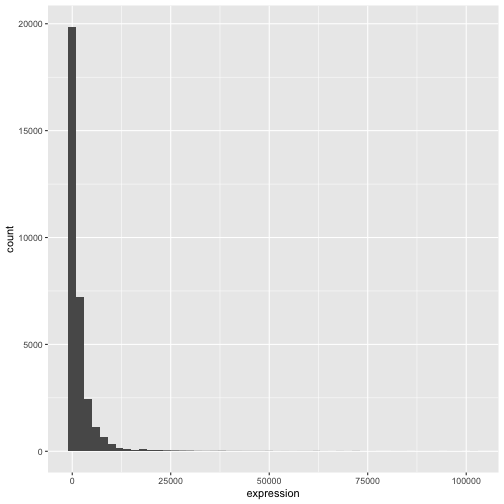
Aquí podemos observar que los datos están sesgados hacia la derecha.
Podemos aplicar una transformación logarítmica en base 2 para obtener
una distribución más simétrica. Tenga en cuenta que aquí añadimos un
pequeño valor constante (+1) para evitar que se devuelvan
valores de -Inf para valores de expresión iguales a 0.
R
rna <- rna |>
  mutate(expression_log = log2(expression + 1))
Si ahora trazamos el histograma de las expresiones transformadas logarítmicamente en base 2, la distribución es, en efecto, más cercana a una distribución normal.
R
ggplot(rna, aes(x = expression_log)) + geom_histogram()
SALIDA
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.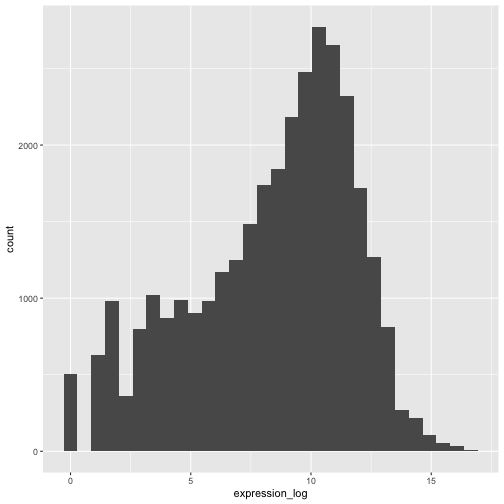
A partir de ahora, trabajaremos con los valores de expresión transformados logarítmicamente.
Desafío
Otra forma de visualizar esta transformación es considerar la escala de las observaciones. Por ejemplo, puede valer la pena cambiar la escala del eje para distribuir mejor las observaciones en el espacio del gráfico. Cambiar la escala de los ejes se hace de manera similar a añadir o modificar otros componentes (es decir, añadiendo comandos de forma incremental). Intente realizar esta modificación:
- Represente la expresión sin transformar en la escala log10; consulte
scale_x_log10(). Compárela con el gráfico anterior. ¿Por qué ahora aparecen mensajes de advertencia?
R
ggplot(data = rna,mapping = aes(x = expression))+
  geom_histogram() +
  scale_x_log10()
ADVERTENCIA
Warning in scale_x_log10(): log-10 transformation introduced infinite values.SALIDA
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.ADVERTENCIA
Warning: Removed 507 rows containing non-finite outside the scale range
(`stat_bin()`).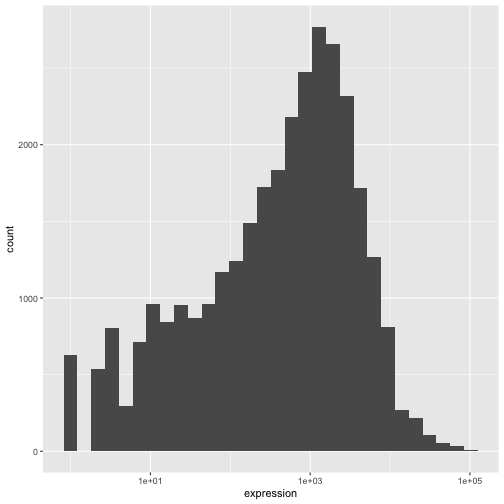
Notas
- Cualquier elemento que incluya en la función
ggplot()será visible en cualquier capa geom que añada (es decir, se trata de configuraciones globales del gráfico). Esto incluye el mapeo de los ejes x e y que configure enaes(). - También puede especificar mapeos para un geom determinado de forma
independiente de los mapeos definidos globalmente en la función
ggplot(). - El signo
+utilizado para añadir nuevas capas deberá colocarse al final de la línea que contiene la capa anterior. Si, en cambio, se añade el signo+al principio de la línea que contiene la nueva capa,ggplot2no añadirá la nueva capa y devolverá un mensaje de error.
R
# This is the correct syntax for adding layers
rna_plot +
  geom_histogram()

# This will not add the new layer and will return an error message
rna_plot
  + geom_histogram()
Creación iterativa de gráficos
A continuación, dibujaremos un gráfico de dispersión con dos
variables continuas y la función geom_point(). Este gráfico
representará los cambios relativos de expresión en escala log2
comparando el tiempo 8 frente al tiempo 0, y el tiempo 4 frente al
tiempo 0. Para ello, primero necesitamos calcular los promedios de los
valores de expresión transformados logarítmicamente por gen y tiempo, y
luego los cambios relativos en escala logarítmica restando el promedio
de las expresiones logarítmicas entre el tiempo 8 y el tiempo 0, y entre
el tiempo 4 y el tiempo 0. Tenga en cuenta que aquí también incluimos el
biotipo del gen que utilizaremos más adelante para representar los
genes. Guardaremos los cambios relativos de expresión en una nueva tabla
de datos llamada rna_fc..
R
rna_fc <- rna |> select(gene, time,
                         gene_biotype, expression_log) |>
  group_by(gene, time, gene_biotype) |>
  summarize(mean_exp = mean(expression_log)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  mutate(time_8_vs_0 = `8` - `0`, time_4_vs_0 = `4` - `0`)
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, time, and gene_biotype.
ℹ Output is grouped by gene and time.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time, gene_biotype))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
A continuación, podemos crear un ggplot con el conjunto de datos
recién creado rna_fc. Crear gráficos con
ggplot2 suele ser un proceso iterativo. Comenzamos
definiendo el conjunto de datos que utilizaremos, disponiendo los ejes y
eligiendo un geom:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_point()
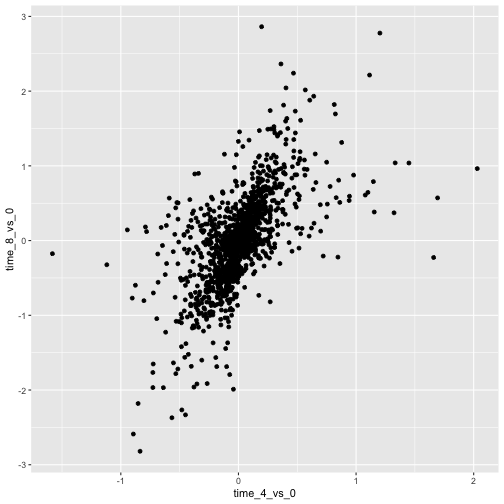
A continuación, comenzamos a modificar este gráfico para extraer más
información de él. Por ejemplo, podemos añadir transparencia
(alpha) para evitar el solapamiento:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_point(alpha = 0.3)
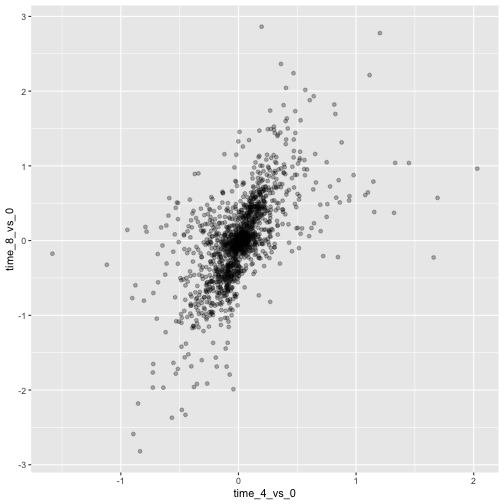
También podemos añadir colores a todos los puntos:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_point(alpha = 0.3, color = "blue")
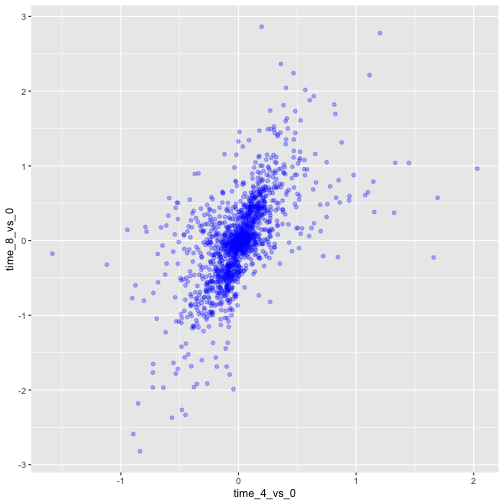
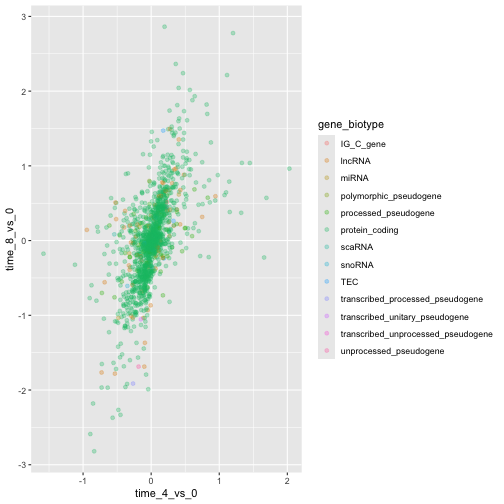
O bien, para colorear cada gen en el gráfico de manera diferente,
podría utilizar un vector como entrada para el argumento
color. ggplot2 proporcionará un color
diferente correspondiente a distintos valores del vector. Aquí tiene un
ejemplo donde se colorea con gene_biotype:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_point(alpha = 0.3, aes(color = gene_biotype))
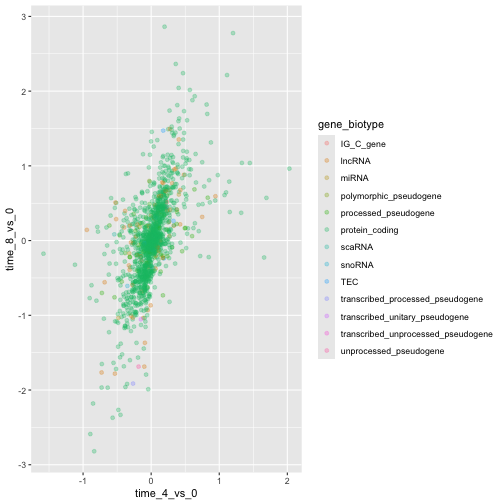
También podemos especificar los colores directamente dentro del mapeo
proporcionado en la función ggplot(). Esto será visible en
cualquier capa geom y el mapeo se determinará según la configuración de
los ejes x e y en aes().
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0,
                                color = gene_biotype)) +
  geom_point(alpha = 0.3)
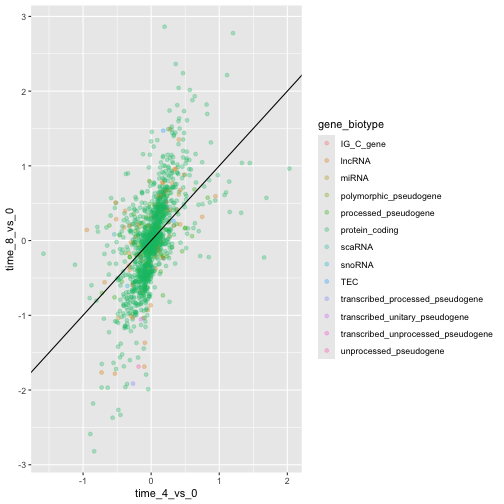
Por último, también podríamos añadir una línea diagonal con la
función geom_abline():
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0,
                                color = gene_biotype)) +
  geom_point(alpha = 0.3) +
  geom_abline(intercept = 0)
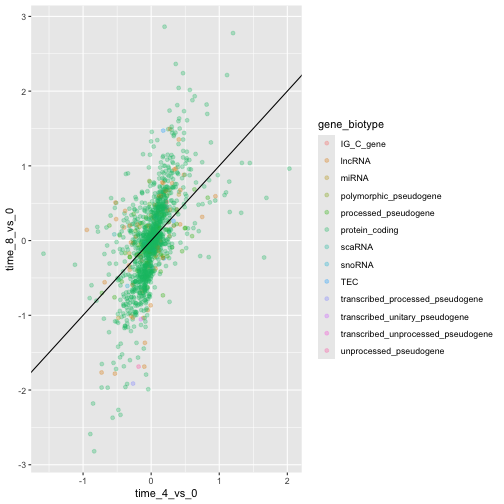
Nótese que podemos cambiar la capa geom de geom_point a
geom_jitter y los colores seguirán determinados por
gene_biotype.
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0,
                                color = gene_biotype)) +
  geom_jitter(alpha = 0.3) +
  geom_abline(intercept = 0)
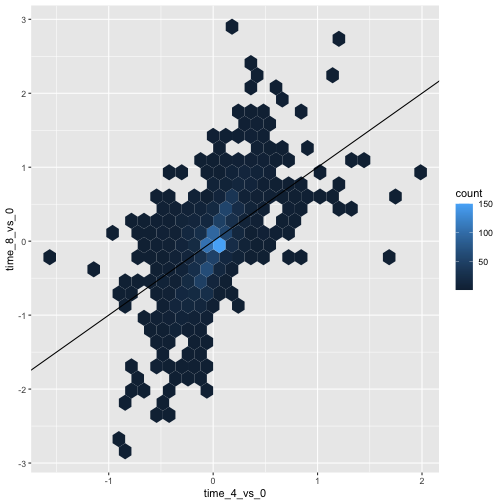
Desafío
Los gráficos de dispersión pueden ser herramientas exploratorias
útiles para conjuntos de datos pequeños. Para conjuntos de datos con un
gran número de observaciones, como el conjunto de datos
rna_fc, la superposición de puntos puede representar una
limitación de los gráficos de dispersión. Una estrategia para manejar
tales escenarios consiste en utilizar el agrupamiento hexagonal de las
observaciones. El espacio del gráfico se tesela en hexágonos. A cada
hexágono se le asigna un color basado en el número de observaciones que
caen dentro de sus límites.
Para utilizar el agrupamiento hexagonal en
ggplot2, primero instale el paquete de Rhexbindesde CRAN y cárguelo.A continuación, utilice la función
geom_hex()para generar la figura de hexbin.¿Cuáles son las fortalezas y debilidades relativas de un gráfico de binaje hexagonal en comparación con un gráfico de dispersión? Examine el gráfico de dispersión anterior y compárelo con el gráfico de binaje hexagonal que creó.
R
install.packages("hexbin")
R
library("hexbin")

ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_hex() +
  geom_abline(intercept = 0)
Desafío
Utiliza lo que acabas de aprender para crear un gráfico de dispersión
de expression_log sobre sample a partir del
conjunto de datos rna, con el tiempo mostrado en diferentes
colores. ¿Es esta una buena manera de representar este tipo de
datos?
R
ggplot(data = rna, mapping = aes(y = expression_log, x = sample)) +
    geom_point(aes(color = time))
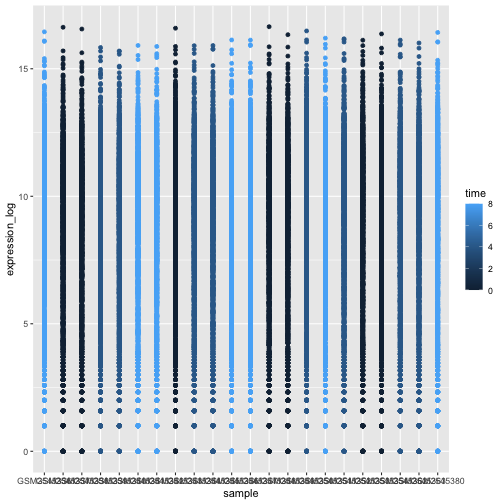
Gráfico de cajas
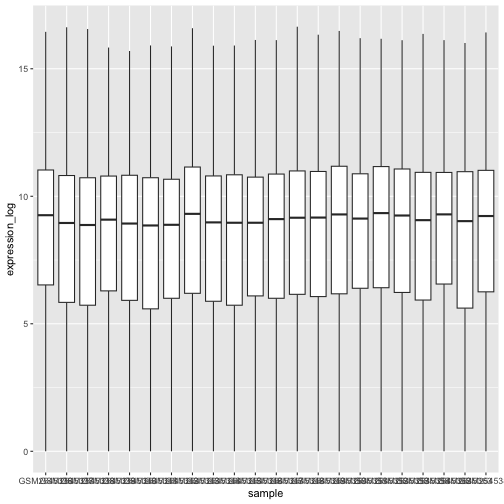
Podemos utilizar gráficos de cajas para visualizar la distribución de la expresión génica dentro de cada muestra:
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_boxplot()
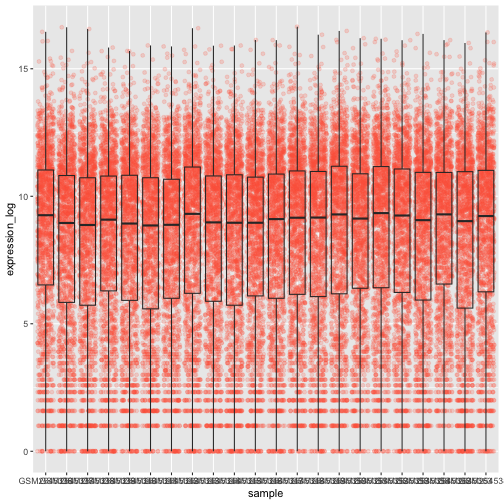
Al añadir puntos al gráfico de cajas, podemos tener una mejor idea del número de mediciones y de su distribución:
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_jitter(alpha = 0.2, color = "tomato") +
  geom_boxplot(alpha = 0)
Desafío
Observa cómo la capa del gráfico de cajas está por delante de la capa de jitter. ¿Qué debes cambiar en el código para colocar el gráfico de cajas debajo de los puntos?
Deberíamos cambiar el orden de estos dos geoms:
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_boxplot(alpha = 0) +
  geom_jitter(alpha = 0.2, color = "tomato")
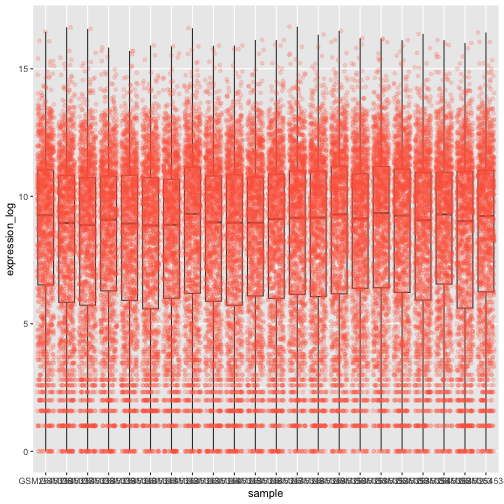
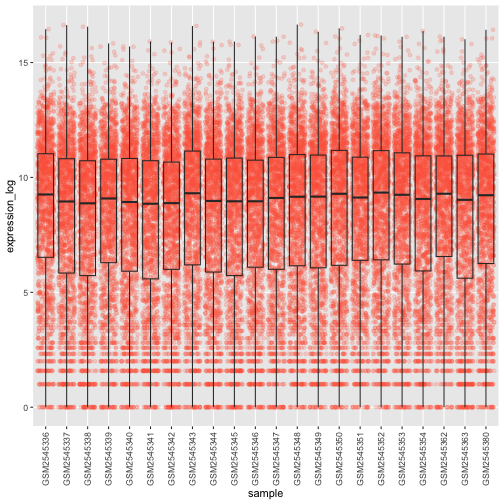
Es posible que notes que los valores del eje x todavía no son correctamente legibles. Cambiemos la orientación de las etiquetas y ajustémoslas vertical y horizontalmente para que no se solapen. Puedes usar un ángulo de 90 grados, o experimentar para encontrar el ángulo adecuado para las etiquetas orientadas diagonalmente:
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_jitter(alpha = 0.2, color = "tomato") +
  geom_boxplot(alpha = 0) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
Desafío
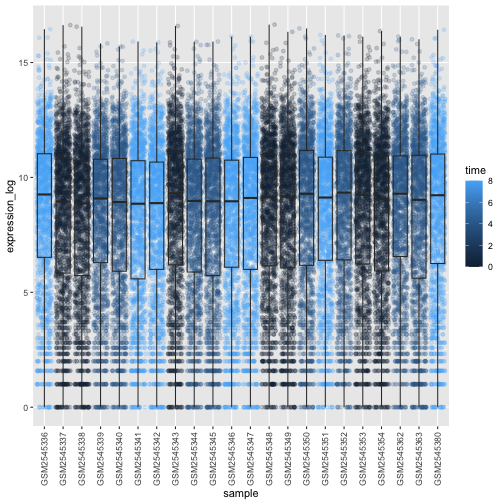
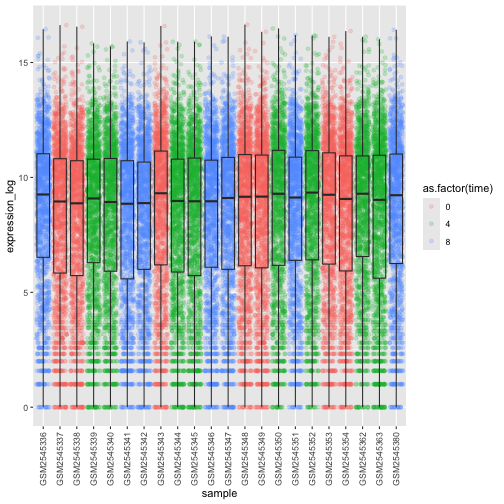
Añada color a los puntos de datos de su gráfico de cajas según la
duración de la infección (time).
Pista: Revisa la clase de time. Considera
cambiar la clase de time de entero a factor directamente en
la asignación de ggplot. ¿Por qué esto cambia la forma en que R crea el
gráfico?
R
# time as integer
ggplot(data = rna,
         mapping = aes(y = expression_log,
                       x = sample)) +
  geom_jitter(alpha = 0.2, aes(color = time)) +
  geom_boxplot(alpha = 0) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
R
# time as factor
ggplot(data = rna,
         mapping = aes(y = expression_log,
                       x = sample)) +
  geom_jitter(alpha = 0.2, aes(color = as.factor(time))) +
  geom_boxplot(alpha = 0) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
Desafío
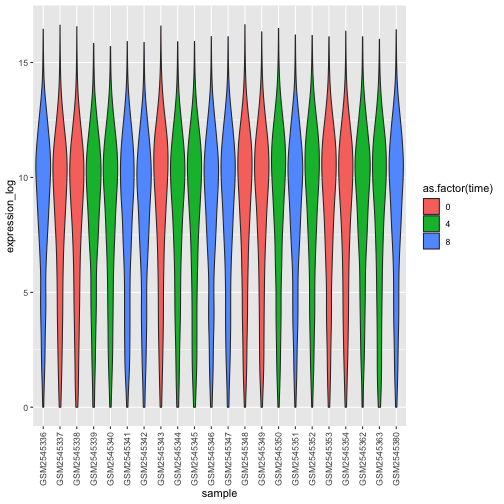
Los gráficos de cajas son resúmenes útiles, pero ocultan la forma de la distribución. Por ejemplo, si la distribución es bimodal, no se vería en un gráfico de cajas. Una alternativa al gráfico de cajas es el gráfico de violín, donde se dibuja la forma (de la densidad de los puntos).
- Sustituya el gráfico de cajas por un gráfico de violín; consulte
geom_violin(). Rellene los violines según el tiempo con el argumentofill.
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_violin(aes(fill = as.factor(time))) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
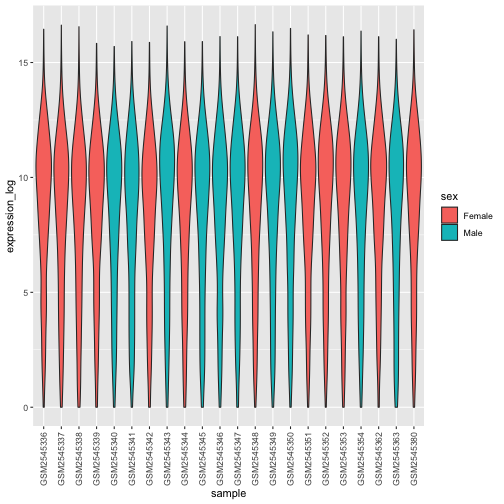
Desafío
- Modifique el gráfico en forma de violín para rellenar los violines
mediante
sex.
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_violin(aes(fill = sex)) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
Gráficos de líneas
Calculemos la expresión media por duración de la infección para los
10 genes con los mayores cambios relativos de expresión en escala
logarítmica al comparar el tiempo 8 con el tiempo 0. Primero, debemos
seleccionar los genes y crear un subconjunto de rna llamado
sub_rna que contenga los 10 genes seleccionados; luego,
debemos agrupar los datos y calcular la expresión génica media dentro de
cada grupo:
R
rna_fc <- rna_fc |> arrange(desc(time_8_vs_0))

genes_selected <- rna_fc$gene[1:10]

sub_rna <- rna |>
    filter(gene %in% genes_selected)

mean_exp_by_time <- sub_rna |>
  group_by(gene,time) |>
    summarize(mean_exp = mean(expression_log))
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
mean_exp_by_time
SALIDA
# A tibble: 30 × 3
# Groups:   gene [10]
   gene   time mean_exp
   <chr> <int>    <dbl>
 1 Acr       0     5.07
 2 Acr       4     5.54
 3 Acr       8     7.31
 4 Aipl1     0     3.70
 5 Aipl1     4     3.89
 6 Aipl1     8     6.56
 7 Bst1      0     3.20
 8 Bst1      4     3.77
 9 Bst1      8     5.22
10 Chil3     0     4.00
# ℹ 20 more rows
Podemos crear el gráfico de líneas con la duración de la infección en el eje x y la expresión media en el eje y:
R
ggplot(data = mean_exp_by_time, mapping = aes(x = time, y = mean_exp)) +
  geom_line()
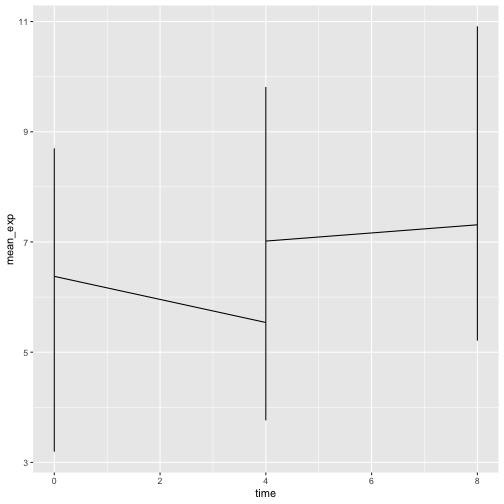
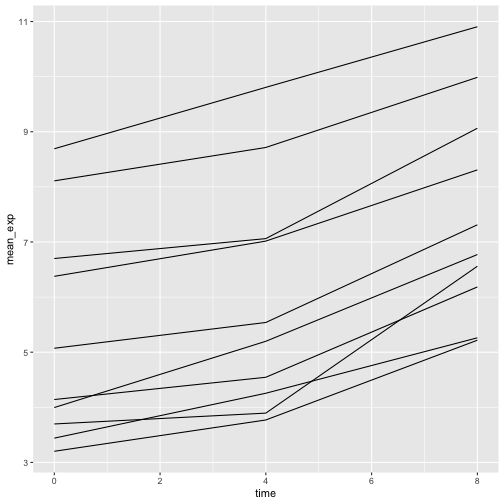
Lamentablemente, esto no funciona porque representamos los datos de
todos los genes juntos. Necesitamos indicar a ggplot que dibuje una
línea para cada gen modificando la función estética para incluir
group = gene:
R
ggplot(data = mean_exp_by_time,
       mapping = aes(x = time, y = mean_exp, group = gene)) +
  geom_line()
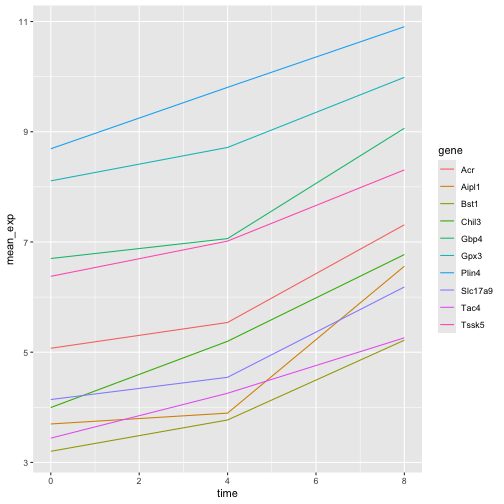
Podremos distinguir los genes en el gráfico si añadimos colores (el
uso de color también agrupa automáticamente los datos):
R
ggplot(data = mean_exp_by_time,
       mapping = aes(x = time, y = mean_exp, color = gene)) +
  geom_line()
Faceting
ggplot2 cuenta con una técnica especial llamada
faceting que permite al usuario dividir un gráfico en múltiples
gráficos (subgráficos) basándose en un factor incluido en el conjunto de
datos. Estos diferentes subgráficos heredan las mismas propiedades
(límites de los ejes, marcas, …) para facilitar su comparación directa.
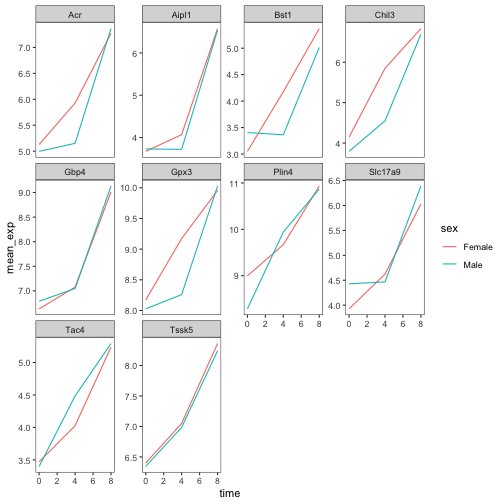
Lo utilizaremos para crear un gráfico de líneas a lo largo del tiempo
para cada gen:
R
ggplot(data = mean_exp_by_time,
       mapping = aes(x = time, y = mean_exp)) + geom_line() +
  facet_wrap(~ gene)
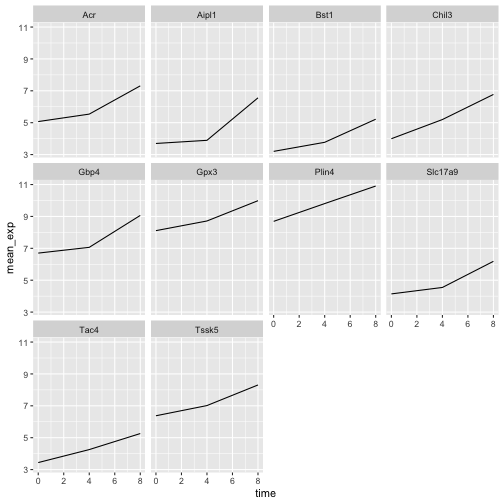
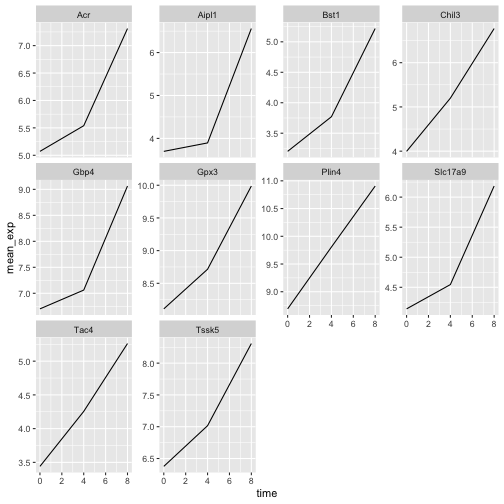
Aquí, tanto el eje x como el y tienen la misma escala en todos los
subgráficos. Puede cambiar este comportamiento predeterminado
modificando scales para permitir una escala libre para el
eje y:
R
ggplot(data = mean_exp_by_time,
       mapping = aes(x = time, y = mean_exp)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y")
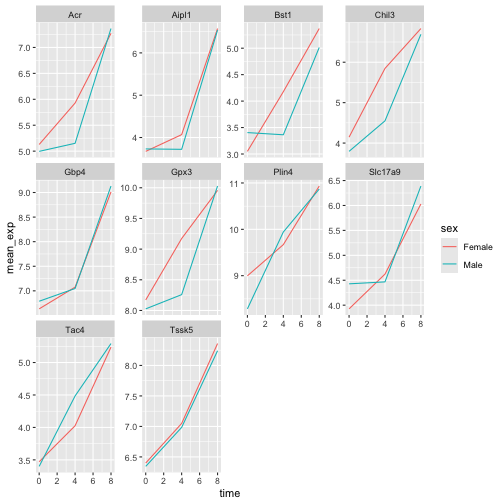
Ahora queremos dividir la línea en cada gráfico según el sexo de los
ratones. Para ello, necesitamos calcular la expresión media en la tabla
de datos agrupada por gene, time y
sex:
R
mean_exp_by_time_sex <- sub_rna |>
  group_by(gene, time, sex) |>
    summarize(mean_exp = mean(expression_log))
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, time, and sex.
ℹ Output is grouped by gene and time.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time, sex))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
mean_exp_by_time_sex
SALIDA
# A tibble: 60 × 4
# Groups:   gene, time [30]
   gene   time sex    mean_exp
   <chr> <int> <chr>     <dbl>
 1 Acr       0 Female     5.13
 2 Acr       0 Male       5.00
 3 Acr       4 Female     5.93
 4 Acr       4 Male       5.15
 5 Acr       8 Female     7.27
 6 Acr       8 Male       7.36
 7 Aipl1     0 Female     3.67
 8 Aipl1     0 Male       3.73
 9 Aipl1     4 Female     4.07
10 Aipl1     4 Male       3.72
# ℹ 50 more rows
Ahora podemos crear el gráfico facetado dividiendo aún más por sexo
utilizando color (dentro de un único gráfico):
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y")
Por lo general, los gráficos con fondo blanco resultan más legibles
al imprimirlos. Podemos establecer el fondo en blanco utilizando la
función theme_bw(). Además, podemos eliminar la
cuadrícula:
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank())
Desafío
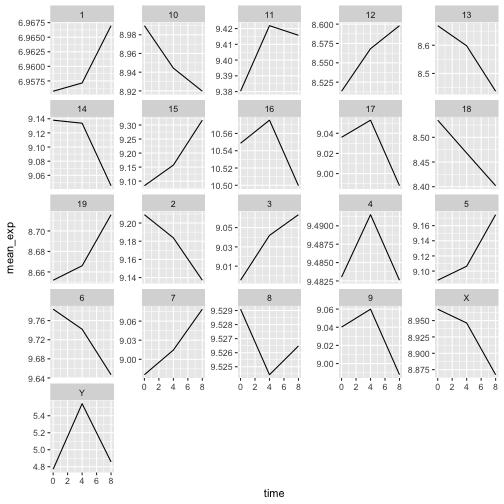
Utiliza lo que acabas de aprender para crear un gráfico que represente cómo varía la expresión promedio de cada cromosoma a lo largo de la duración de la infección.
R
mean_exp_by_chromosome <- rna |>
  group_by(chromosome_name, time) |>
  summarize(mean_exp = mean(expression_log))
SALIDA
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by chromosome_name and time.
ℹ Output is grouped by chromosome_name.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(chromosome_name, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
ggplot(data = mean_exp_by_chromosome, mapping = aes(x = time,
                                y = mean_exp)) +
  geom_line() +
  facet_wrap(~ chromosome_name, scales = "free_y")
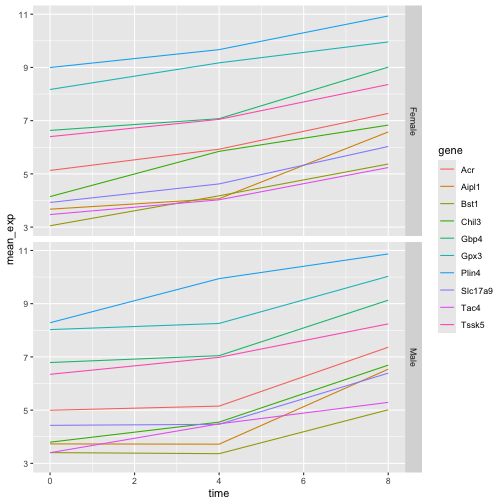
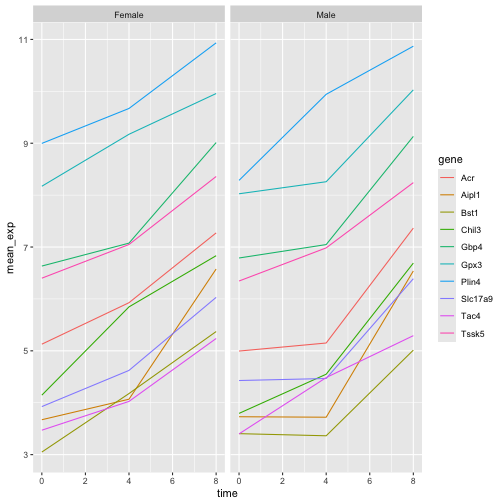
La geometría facet_wrap extrae los gráficos en un número
arbitrario de dimensiones para que quepan correctamente en una sola
página. Por otro lado, la geometría facet_grid permite
especificar explícitamente cómo se desea que estén dispuestos los
gráficos mediante la notación de fórmula (rows ~ columns;
un . puede utilizarse como marcador que indique una sola
fila o columna).
Modifiquemos el gráfico anterior para comparar cómo ha cambiado la expresión génica media de los machos y las hembras a lo largo del tiempo:
R
# One column, facet by rows
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = gene)) +
  geom_line() +
  facet_grid(sex ~ .)
R
# One row, facet by column
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = gene)) +
  geom_line() +
  facet_grid(. ~ sex)
Temas de ggplot2
Además de theme_bw(), que cambia el fondo del gráfico a
blanco, ggplot2 incluye varios otros temas que pueden
resultar útiles para cambiar rápidamente la apariencia de su
visualización. La lista completa de temas está disponible en https://ggplot2.tidyverse.org/reference/ggtheme.html.
theme_minimal() y theme_light() son populares,
y theme_void() puede resultar útil como punto de partida
para crear un nuevo tema diseñado a mano.
El paquete ggthemes
ofrece una amplia variedad de opciones (incluido un tema de Excel 2003).
El sitio web de
extensiones ggplot2 proporciona una lista de paquetes
que amplían las capacidades de ggplot2, incluidos temas
adicionales.
Personalización
Volvamos al gráfico facetado de la expresión media según el tiempo y el gen, coloreado por sexo.
Echa un vistazo a la hoja
de trucos ggplot2 y piensa en formas de mejorar el
gráfico.
Ahora, podemos cambiar los nombres de los ejes por algo más informativo que ‘time’ y ‘mean_exp’, y añadir un título a la figura:
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  labs(title = "Mean gene expression by duration of the infection",
       x = "Duration of the infection (in days)",
       y = "Mean gene expression")
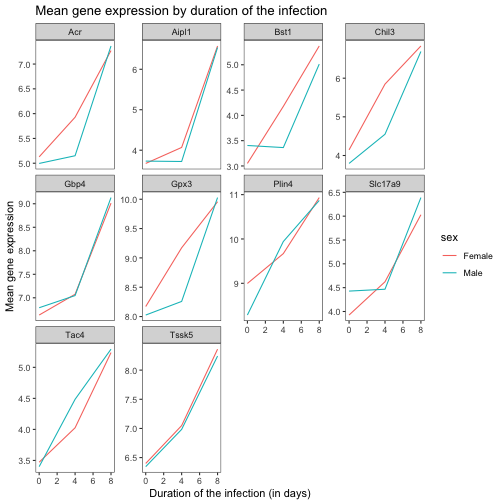
Los ejes tienen nombres más informativos, pero su legibilidad puede mejorarse aumentando el tamaño de la fuente:
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  labs(title = "Mean gene expression by duration of the infection",
       x = "Duration of the infection (in days)",
       y = "Mean gene expression")  +
  theme(text = element_text(size = 16))
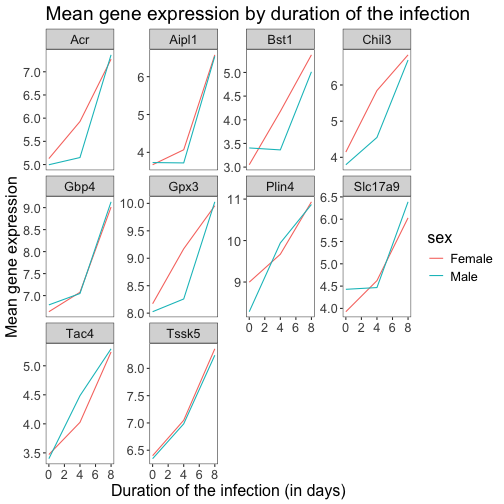
Tenga en cuenta que también es posible cambiar las fuentes de sus
gráficos. Si utiliza Windows, es posible que tenga que instalar el
paquete extrafont.
Podemos personalizar aún más el color del texto de los ejes x e y, el
color de la cuadrícula, etc. También podemos, por ejemplo, mover la
leyenda a la parte superior estableciendo legend.position
en "top".
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  labs(title = "Mean gene expression by duration of the infection",
       x = "Duration of the infection (in days)",
       y = "Mean gene expression")  +
  theme(text = element_text(size = 16),
        axis.text.x = element_text(colour = "royalblue4", size = 12),
        axis.text.y = element_text(colour = "royalblue4", size = 12),
        panel.grid = element_line(colour="lightsteelblue1"),
        legend.position = "top")
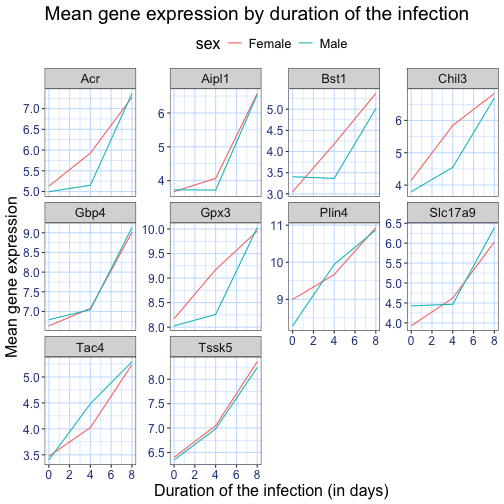
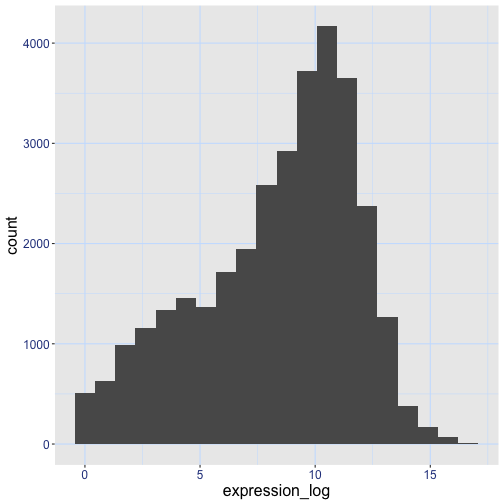
Si te gustan más los cambios que has realizado que el tema predeterminado, puedes guardarlos como un objeto para poder aplicarlos fácilmente a otros gráficos que crees. Aquí tienes un ejemplo con el histograma que creamos anteriormente.
R
blue_theme <- theme(axis.text.x = element_text(colour = "royalblue4",
                                               size = 12),
                    axis.text.y = element_text(colour = "royalblue4",
                                               size = 12),
                    text = element_text(size = 16),
                    panel.grid = element_line(colour="lightsteelblue1"))

ggplot(rna, aes(x = expression_log)) +
  geom_histogram(bins = 20) +
    blue_theme
Desafío
Con toda esta información a mano, tómese otros cinco minutos para
mejorar uno de los gráficos generados en este ejercicio o crear su
propio gráfico impecable. Utilice la hoja
de trucos ggplot2 de RStudio para inspirarse. Aquí
tiene algunas ideas:
- Mira si puedes cambiar el grosor de las líneas.
- ¿Puedes encontrar una forma de cambiar el nombre de la leyenda? ¿Y
sus etiquetas? (pista: busca una función de ggplot que empiece por
scale_) - Prueba a utilizar una paleta de colores diferente o a especificar manualmente los colores de las líneas (consulta https://www.cookbook-r.com/Graphs/Colors_(ggplot2)/).
Por ejemplo, basándose en este gráfico:
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank())
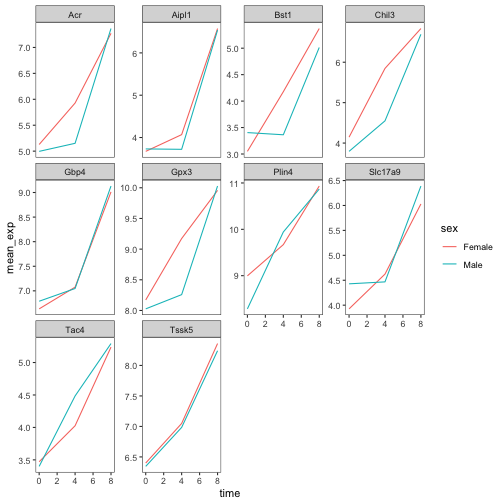
Podemos personalizarlo de las siguientes maneras:
R
# change the thickness of the lines
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line(size=1.5) +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank())
ADVERTENCIA
Warning: Using `size` aesthetic for lines was deprecated in ggplot2 3.4.0.
ℹ Please use `linewidth` instead.
This warning is displayed once per session.
Call `lifecycle::last_lifecycle_warnings()` to see where this warning was
generated.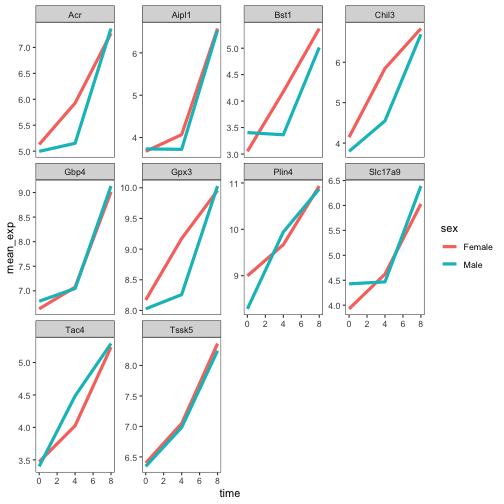
R
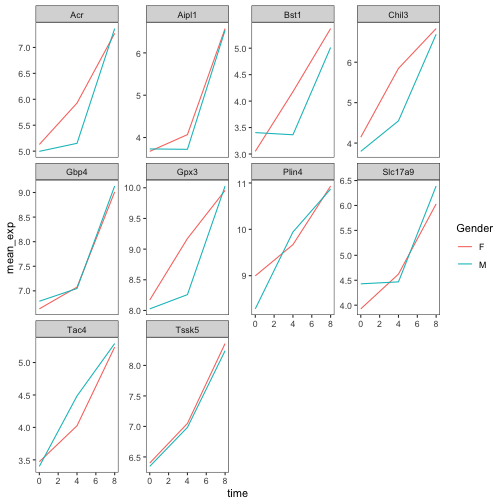
# change the name of the legend and the labels
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  scale_color_discrete(name = "Gender", labels = c("F", "M"))
R
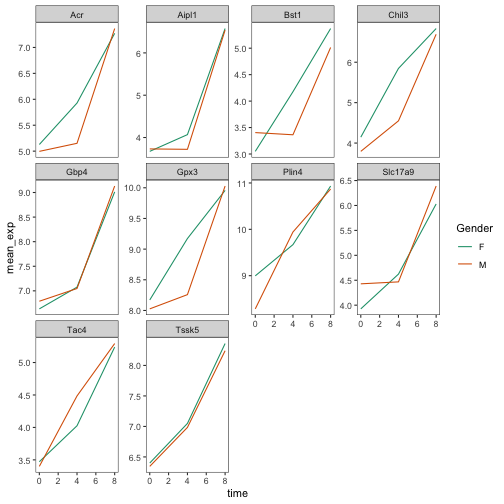
# using a different color palette
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  scale_color_brewer(name = "Gender", labels = c("F", "M"), palette = "Dark2")
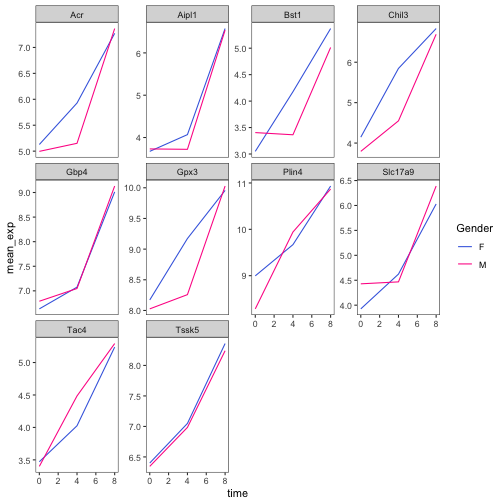
R
# manually specifying the colors
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  scale_color_manual(name = "Gender",  labels = c("F", "M"),
                     values = c("royalblue", "deeppink"))
Composición de gráficos
El faceting es una herramienta excelente para dividir un gráfico en múltiples subgráficos, pero a veces es posible que desee crear una sola figura que contenga varios gráficos independientes, es decir, gráficos basados en variables diferentes o incluso en tablas de datos distintas.
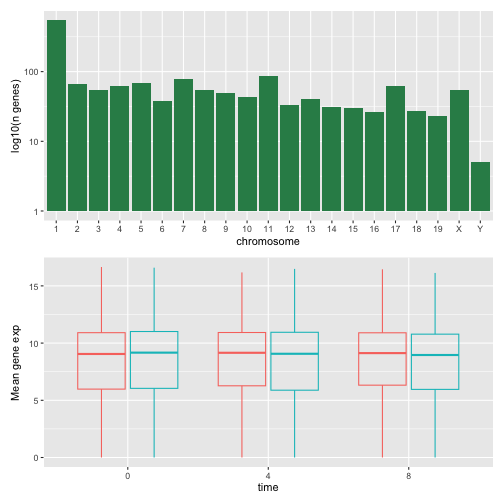
Comencemos creando los dos gráficos que queremos disponer uno junto al otro:
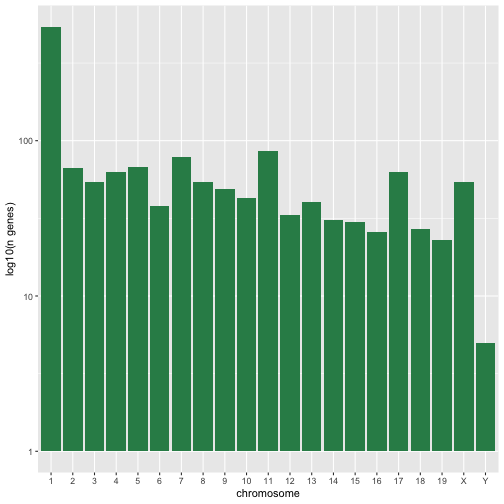
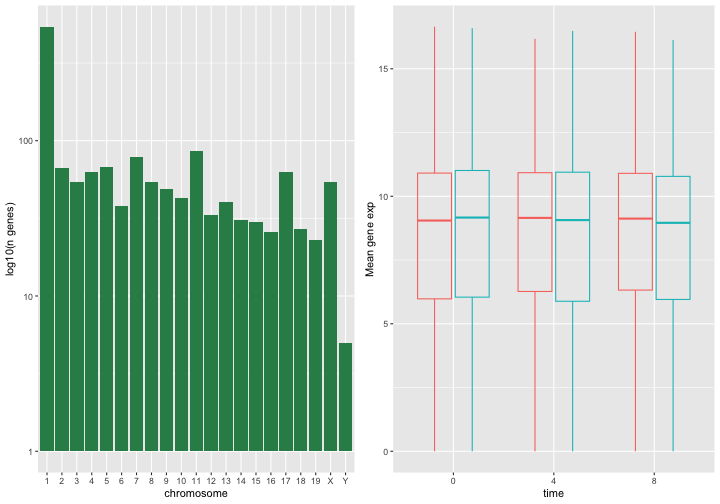
El primer gráfico cuenta el número de genes únicos por cromosoma.
Primero debemos reordenar los niveles de chromosome_name y
filtrar los genes únicos por cromosoma. También cambiamos la escala del
eje y a una escala logarítmica en base 10 para mejorar la
legibilidad.
R
rna$chromosome_name <- factor(rna$chromosome_name,
                               levels = c(1:19,"X","Y"))

count_gene_chromosome <- rna |>
  select(chromosome_name, gene) |>
  distinct() |> ggplot() +
  geom_bar(aes(x = chromosome_name), fill = "seagreen",
           position = "dodge", stat = "count") +
  labs(y = "log10(n genes)", x = "chromosome") +
  scale_y_log10()

count_gene_chromosome
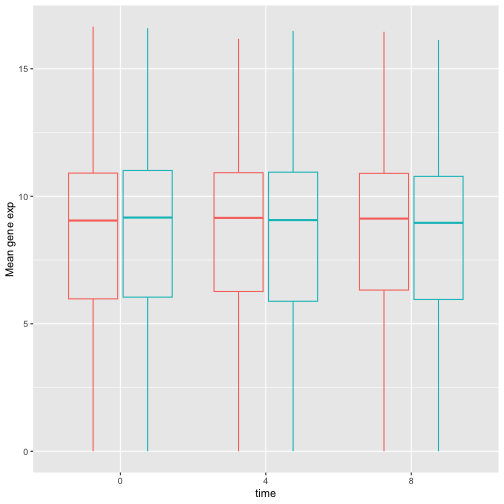
A continuación, también eliminamos la leyenda por completo
estableciendo legend.position en "none".
R
exp_boxplot_sex <- ggplot(rna, aes(y=expression_log, x = as.factor(time),
                 color=sex)) +
   geom_boxplot(alpha = 0) +
  labs(y = "Mean gene exp",
       x = "time") + theme(legend.position = "none")

exp_boxplot_sex
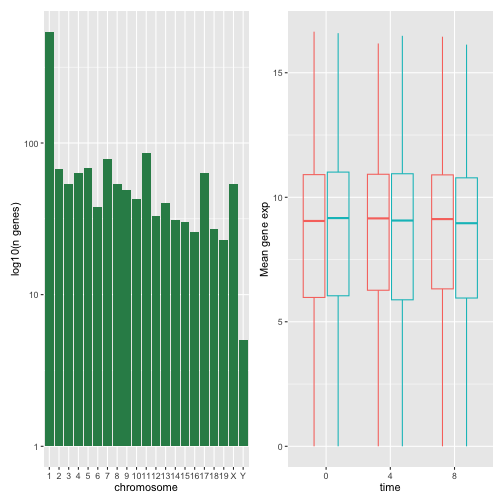
El paquete patchwork
ofrece un enfoque elegante para combinar figuras utilizando
+ para organizarlas (normalmente una al lado de la otra).
Más concretamente, | las organiza explícitamente una al
lado de la otra y / las apila una sobre otra.
R
install.packages("patchwork")
R
library("patchwork")
count_gene_chromosome + exp_boxplot_sex
R
## or count_gene_chromosome | exp_boxplot_sex
R
count_gene_chromosome / exp_boxplot_sex
Podemos controlar aún más la disposición de la composición final con
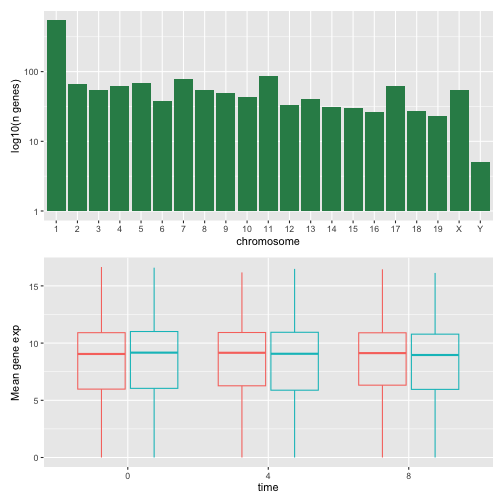
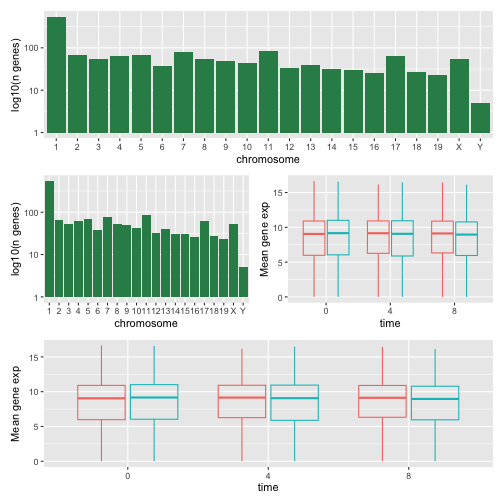
plot_layout para crear diseños más complejos:
R
count_gene_chromosome + exp_boxplot_sex + plot_layout(ncol = 1)
R
count_gene_chromosome +
 (count_gene_chromosome + exp_boxplot_sex) +
 exp_boxplot_sex +
 plot_layout(ncol = 1)
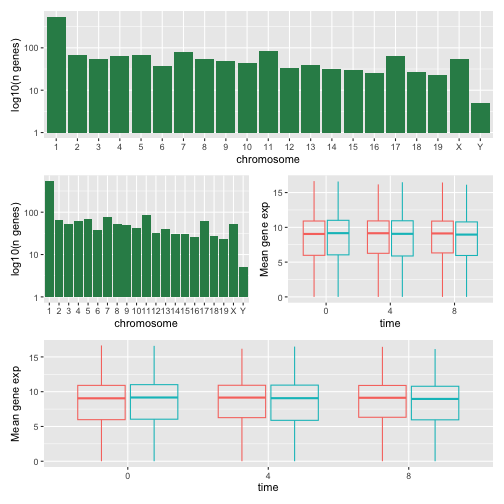
El último gráfico también puede crearse utilizando los compositores
| y /:
R
count_gene_chromosome /
 (count_gene_chromosome | exp_boxplot_sex) /
 exp_boxplot_sex
Obtenga más información sobre patchwork en su página web o en este video.
Otra opción es el paquete gridExtra,
que permite combinar ggplots independientes en una sola figura mediante
grid.arrange():
R
install.packages("gridExtra")
R
library("gridExtra")
grid.arrange(count_gene_chromosome, exp_boxplot_sex, ncol = 2)
Además de los argumentos ncol y nrow,
utilizados para realizar diseños sencillos, existen herramientas para construir
diseños más complejos.
Exportación de gráficos
Tras crear su gráfico, puede guardarlo en un archivo en su formato preferido. La pestaña Exportar en el panel Plot de RStudio guardará sus gráficos a baja resolución, la cual no será aceptada por muchas revistas y no escalará bien para pósteres.
En su lugar, utilice la función ggsave(), que le permite
cambiar fácilmente la dimensión y la resolución de su gráfico ajustando
los argumentos correspondientes (width, height
y dpi).
Asegúrese de tener la carpeta fig_output/ en su
directorio de trabajo.
R
my_plot <- ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  labs(title = "Mean gene expression by duration of the infection",
         x = "Duration of the infection (in days)",
         y = "Mean gene expression") +
  guides(color=guide_legend(title="Gender")) +
  theme_bw() +
  theme(axis.text.x = element_text(colour = "royalblue4", size = 12),
        axis.text.y = element_text(colour = "royalblue4", size = 12),
        text = element_text(size = 16),
        panel.grid = element_line(colour="lightsteelblue1"),
        legend.position = "top")
ggsave("fig_output/mean_exp_by_time_sex.png", my_plot, width = 15,
       height = 10)

# This also works for grid.arrange() plots
combo_plot <- grid.arrange(count_gene_chromosome, exp_boxplot_sex,
                           ncol = 2, widths = c(4, 6))
ggsave("fig_output/combo_plot_chromosome_sex.png", combo_plot,
       width = 10, dpi = 300)
Nota: Los parámetros width y height también
determinan el tamaño de la fuente en el gráfico guardado.
Otros paquetes para la visualización
ggplot2 es un paquete muy potente que encaja a la
perfección en nuestro pipeline de datos ordenados y
herramientas ordenadas. Existen otros paquetes de visualización
en R que no deben pasarse por alto.
Gráficos básicos
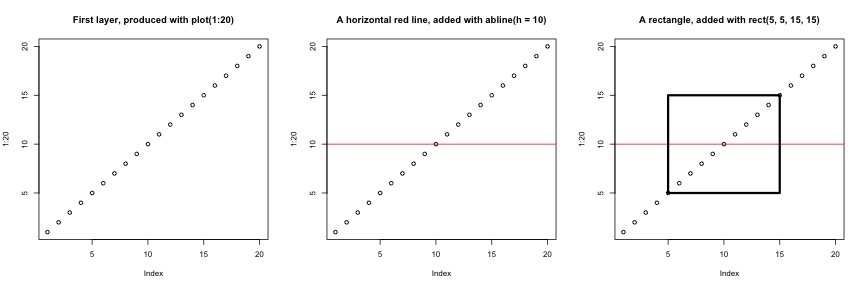
El sistema gráfico predeterminado que incluye R, a menudo llamado
gráficos básicos de R, es sencillo y rápido. Se basa en el
modelo del pintor o del lienzo, donde diferentes resultados se
superponen directamente entre sí (véase la figura siguiente ). Esta es una diferencia
fundamental con ggplot2 (y con lattice,
descrito más adelante), que devuelve objetos dedicados que se renderizan
en pantalla o en un archivo, e incluso pueden actualizarse.
R
par(mfrow = c(1, 3))
plot(1:20, main = "First layer, produced with plot(1:20)")

plot(1:20, main = "A horizontal red line, added with abline(h = 10)")
abline(h = 10, col = "red")

plot(1:20, main = "A rectangle, added with rect(5, 5, 15, 15)")
abline(h = 10, col = "red")
rect(5, 5, 15, 15, lwd = 3)
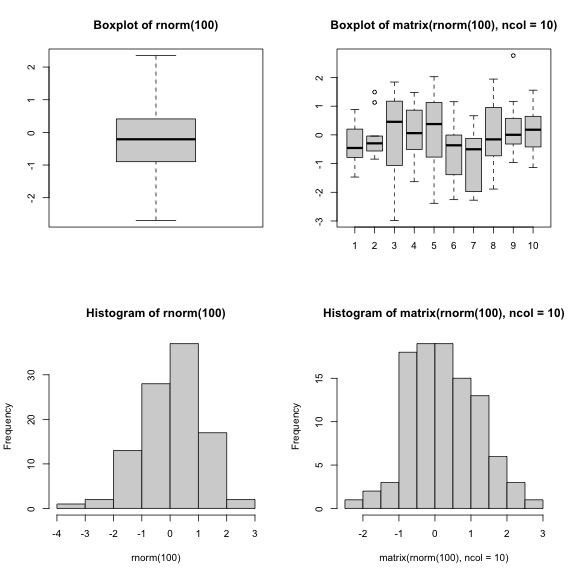
Otra diferencia principal es que las funciones de trazado de los
gráficos básicos intentan hacer lo correcto según el tipo de
entrada; es decir, adaptan su comportamiento en función de la clase de
su entrada. Esto es, nuevamente, muy diferente a lo que tenemos en
ggplot2, que solo acepta tablas de datos como entrada y
requiere que los gráficos se construyan poco a poco.
R
par(mfrow = c(2, 2))
boxplot(rnorm(100),
        main = "Boxplot of rnorm(100)")
boxplot(matrix(rnorm(100), ncol = 10),
        main = "Boxplot of matrix(rnorm(100), ncol = 10)")
hist(rnorm(100))
hist(matrix(rnorm(100), ncol = 10))
El enfoque estándar de los gráficos básicos puede ser muy eficiente
para figuras sencillas y estándar, que pueden producirse muy rápidamente
con una sola línea de código y una sola función como plot,
o hist, o boxplot, … Sin embargo, los valores
predeterminados no siempre son los más atractivos, y el ajuste de las
figuras, especialmente cuando estas se vuelven más complejas (por
ejemplo, para producir facetas), puede resultar largo y engorroso.
El paquete lattice
El paquete lattice es similar a
ggplot2 en que utiliza tablas de datos como entrada,
devuelve objetos gráficos y admite el faceting. lattice,
sin embargo, no se basa en la gramática de gráficos y tiene una interfaz
más compleja.
Una buena referencia para el paquete lattice es Deepayan (2008).
- Visualización en R
Fuente: Data Visualization Cheat Sheet.↩︎