
从数据开始
最后更新于 2026-11-07 | 编辑此页
预计用时: 60 分钟
概述
问题
- R 语言中的初步数据分析
学习目标
- 描述什么是
data.frame。 - 从 .csv 文件中将外部数据加载到数据框中。
- 汇总数据框的内容。
- 描述什么是因子。
- 在字符串和因子之间进行转换。
- 重新排序并重命名因子。
- 格式化日期。
- 导出并保存数据。
本集基于 Data Carpentries 的 Data Analysis and Visualisation in R for Ecologists 课程。
基因表达数据的呈现
我们将使用 Blackmore et al. (2017) 发表的部分数据,即《上呼吸道感染对中枢神经系统转录组变化的影响》。该研究的目的是确定上呼吸道感染对感染后小脑和脊髓中 RNA 转录变化的影响。将性别匹配的八周龄 C57BL/6 小鼠经鼻腔途径接种生理盐水或甲型流感病毒,并在第 0 天(未感染)、4 天和 8 天通过 RNA-seq 评估小脑和脊髓组织的转录组变化。
该数据集以逗号分隔值 (CSV) 文件的形式存储。每一行包含单次 RNA 表达测量的信息,前 11 列分别表示:
| 列 | 描述 |
|---|---|
| gene | 所测量的基因名称 |
| sample | 测量基因表达的样本名称 |
| expression | 基因表达的值 |
| organism | 生物体/物种 —— 此处所有数据均来自小鼠 |
| age | 小鼠的年龄(此处所有小鼠均为 8 周龄) |
| sex | 小鼠的性别 |
| infection | 小鼠的感染状态,即是否感染甲型流感。 |
| strain | 甲型流感毒株。 |
| time | 感染持续时间(以天为单位)。 |
| tissue | 用于基因表达实验的组织,即小脑或脊髓。 |
| mouse | 小鼠唯一标识符。 |
我们将使用 R 函数 download.file() 下载包含基因表达数据的
CSV 文件,并使用 read.csv() 将 CSV 文件的内容作为
data.frame 类的对象加载到内存中。在
download.file 命令中,第一个项是一个包含源 URL
的字符串。该源 URL 从 GitHub 仓库下载一个 CSV 文件。逗号后的文本
("data/rnaseq.csv")
是文件在本地机器上的目标位置。您的机器上需要有一个名为
"data"
的文件夹,用于下载该文件。因此,此命令下载远程文件,将其命名为
"rnaseq.csv",并将其添加到名为 "data"
的现有文件夹中。
R
download.file(url = "https://github.com/carpentries-incubator/bioc-intro/raw/main/episodes/data/rnaseq.csv",
              destfile = "data/rnaseq.csv")
现在您可以加载数据了:
R
rna <- read.csv("data/rnaseq.csv")
这条语句不会产生任何输出,因为正如你可能记得的,赋值操作不会显示任何内容。如果我们想检查数据是否已加载,可以通过输入数据框的名称来查看其内容:
R
rna
哇……输出量真大。至少这意味着数据已正确加载。让我们使用
head() 函数来检查这个数据框的前几行(前 6 行):
R
head(rna)
输出
     gene     sample expression     organism age    sex  infection  strain time
1     Asl GSM2545336       1170 Mus musculus   8 Female InfluenzaA C57BL/6    8
2    Apod GSM2545336      36194 Mus musculus   8 Female InfluenzaA C57BL/6    8
3 Cyp2d22 GSM2545336       4060 Mus musculus   8 Female InfluenzaA C57BL/6    8
4    Klk6 GSM2545336        287 Mus musculus   8 Female InfluenzaA C57BL/6    8
5   Fcrls GSM2545336         85 Mus musculus   8 Female InfluenzaA C57BL/6    8
6  Slc2a4 GSM2545336        782 Mus musculus   8 Female InfluenzaA C57BL/6    8
      tissue mouse ENTREZID
1 Cerebellum    14   109900
2 Cerebellum    14    11815
3 Cerebellum    14    56448
4 Cerebellum    14    19144
5 Cerebellum    14    80891
6 Cerebellum    14    20528
                                                                       product
1                               argininosuccinate lyase, transcript variant X1
2                                       apolipoprotein D, transcript variant 3
3 cytochrome P450, family 2, subfamily d, polypeptide 22, transcript variant 2
4                         kallikrein related-peptidase 6, transcript variant 2
5                Fc receptor-like S, scavenger receptor, transcript variant X1
6          solute carrier family 2 (facilitated glucose transporter), member 4
     ensembl_gene_id external_synonym chromosome_name   gene_biotype
1 ENSMUSG00000025533    2510006M18Rik               5 protein_coding
2 ENSMUSG00000022548             <NA>              16 protein_coding
3 ENSMUSG00000061740             2D22              15 protein_coding
4 ENSMUSG00000050063             Bssp               7 protein_coding
5 ENSMUSG00000015852    2810439C17Rik               3 protein_coding
6 ENSMUSG00000018566           Glut-4              11 protein_coding
                            phenotype_description
1           abnormal circulating amino acid level
2                      abnormal lipid homeostasis
3                        abnormal skin morphology
4                         abnormal cytokine level
5 decreased CD8-positive alpha-beta T cell number
6              abnormal circulating glucose level
  hsapiens_homolog_associated_gene_name
1                                   ASL
2                                  APOD
3                                CYP2D6
4                                  KLK6
5                                 FCRL2
6                                SLC2A4
R
## Try also
## View(rna)
注意
read.csv()
假设字段由逗号分隔,但在某些国家,逗号被用作小数点分隔符,而分号 (;)
则被用作字段分隔符。如果你想在 R 中读取此类文件,可以使用
read.csv2() 函数。它的行为与 read.csv()
完全相同,但对小数点和字段分隔符使用不同的参数。如果你处理的是其他格式,用户可以同时指定这两个参数。输入
?read.csv 查看 read.csv()
的帮助信息以了解更多详情。此外,还有用于读取制表符分隔数据文件的
read.delim()
函数。需要注意的是,所有这些函数实际上都是带有不同参数的主函数
read.table() 的包装函数。因此,上述数据也可以通过使用
read.table() 并将分隔参数设为 ,
来加载。代码如下:
R
rna <- read.table(file = "data/rnaseq.csv",
                  sep = ",",
                  header = TRUE)
必须将 header 参数设置为 TRUE 才能读取表头,因为默认情况下
read.table() 的 header 参数设置为 FALSE。
什么是数据框?
数据框是大多数表格数据的事实上的数据结构,也是我们用于统计和绘图的结构。
数据框可以手动创建,但最常见的是通过 read.csv() 或
read.table()
函数生成;换句话说,就是在从硬盘(或网络)导入电子表格时。
数据框是以表格形式表示数据的一种方式,其中各列均为长度相同的向量。由于各列均为向量,因此每列必须包含单一类型的数据(例如:字符、整数、因子)。例如,下图展示了一个由数值向量、字符向量和逻辑向量组成的数据框。
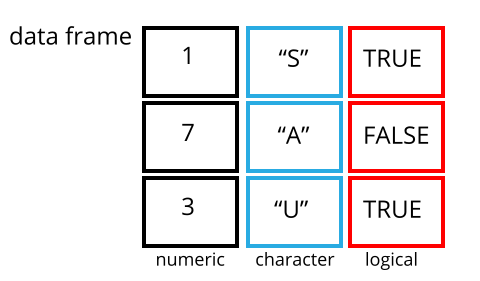
我们可以通过使用 str() 函数检查数据框的 structure
来看到这一点:
R
str(rna)
输出
'data.frame':	32428 obs. of  19 variables:
 $ gene                                 : chr  "Asl" "Apod" "Cyp2d22" "Klk6" ...
 $ sample                               : chr  "GSM2545336" "GSM2545336" "GSM2545336" "GSM2545336" ...
 $ expression                           : int  1170 36194 4060 287 85 782 1619 288 43217 1071 ...
 $ organism                             : chr  "Mus musculus" "Mus musculus" "Mus musculus" "Mus musculus" ...
 $ age                                  : int  8 8 8 8 8 8 8 8 8 8 ...
 $ sex                                  : chr  "Female" "Female" "Female" "Female" ...
 $ infection                            : chr  "InfluenzaA" "InfluenzaA" "InfluenzaA" "InfluenzaA" ...
 $ strain                               : chr  "C57BL/6" "C57BL/6" "C57BL/6" "C57BL/6" ...
 $ time                                 : int  8 8 8 8 8 8 8 8 8 8 ...
 $ tissue                               : chr  "Cerebellum" "Cerebellum" "Cerebellum" "Cerebellum" ...
 $ mouse                                : int  14 14 14 14 14 14 14 14 14 14 ...
 $ ENTREZID                             : int  109900 11815 56448 19144 80891 20528 97827 118454 18823 14696 ...
 $ product                              : chr  "argininosuccinate lyase, transcript variant X1" "apolipoprotein D, transcript variant 3" "cytochrome P450, family 2, subfamily d, polypeptide 22, transcript variant 2" "kallikrein related-peptidase 6, transcript variant 2" ...
 $ ensembl_gene_id                      : chr  "ENSMUSG00000025533" "ENSMUSG00000022548" "ENSMUSG00000061740" "ENSMUSG00000050063" ...
 $ external_synonym                     : chr  "2510006M18Rik" NA "2D22" "Bssp" ...
 $ chromosome_name                      : chr  "5" "16" "15" "7" ...
 $ gene_biotype                         : chr  "protein_coding" "protein_coding" "protein_coding" "protein_coding" ...
 $ phenotype_description                : chr  "abnormal circulating amino acid level" "abnormal lipid homeostasis" "abnormal skin morphology" "abnormal cytokine level" ...
 $ hsapiens_homolog_associated_gene_name: chr  "ASL" "APOD" "CYP2D6" "KLK6" ...
检查 data.frame 对象
我们已经看到了 head() 和 str()
函数如何用于检查数据框的内容和结构。以下是一份并非详尽的函数列表,可用于了解数据的内容/结构。让我们试一试吧!
大小:
-
dim(rna)- 返回一个向量,第一个元素为行数,第二个元素为列数(对象的维度)。 -
nrow(rna)- 返回行数。 -
ncol(rna)- 返回列数。
内容:
-
head(rna)- 显示前 6 行。 -
tail(rna)- 显示最后 6 行。
名称:
-
names(rna)- 返回列名(对于data.frame对象,与colnames()同义)。 -
rownames(rna)- 返回行名。
摘要:
-
str(rna)- 对象的结构以及关于类别、每列长度和内容的信息。 -
summary(rna)- 每一列的汇总统计数据。
注:这些函数大多是“通用”的,除了 data.frame
之外,也可以用于其他类型的对象。
挑战:
根据 str(rna) 的输出结果,你能回答以下问题吗?
- 对象
rna的类型是什么? - 该对象有多少行和多少列?
- 类型:数据框
- 行数:32428,列数:19
数据框的索引与子集提取
我们的 rna 数据框包含行和列(具有 2
维);如果我们想从中提取某些特定数据,需要指定所需的“坐标”。行号在前,列号在后。但请注意,指定这些坐标的不同方式会导致结果的类型不同。
R
# first element in the first column of the data frame (as a vector)
rna[1, 1]
# first element in the 6th column (as a vector)
rna[1, 6]
# first column of the data frame (as a vector)
rna[, 1]
# first column of the data frame (as a data.frame)
rna[1]
# first three elements in the 7th column (as a vector)
rna[1:3, 7]
# the 3rd row of the data frame (as a data.frame)
rna[3, ]
# equivalent to head_rna <- head(rna)
head_rna <- rna[1:6, ]
head_rna
:
是一个特殊函数,用于创建递增或递减的整数数值向量,例如可试用
1:10 和 10:1。详情请参阅“生成向量”一节。
您还可以使用“-”符号来排除数据框中的某些索引:
R
rna[, -1]          ## The whole data frame, except the first column
rna[-c(7:66465), ] ## Equivalent to head(rna)
数据框可以通过调用索引(如前所示)进行子集提取,也可以直接通过调用其列名来实现:
R
rna["gene"]       # Result is a data.frame
rna[, "gene"]     # Result is a vector
rna[["gene"]]     # Result is a vector
rna$gene          # Result is a vector
在 RStudio 中,您可以使用自动补全功能来获取列的完整且正确的名称。
挑战
创建一个
data.frame(rna_200),仅包含rna数据集中第 200 行的数据。注意
nrow()如何给出了data.frame的行数?
使用该数值,从初始的
rna数据框中仅提取出最后一行。将此结果与你使用
tail()看到的最后一行进行对比,以确保其符合预期。使用
nrow()而非行号来提取最后一行。从该最后一行创建一个新的数据框 (
rna_last)。
使用
nrow()提取rna数据框中间的那一行。将该行的内容存储在名为rna_middle的对象中。将
nrow()与上述-表示法结合使用,以重现head(rna)的行为,并仅保留 rna 数据集的第 1 行至第 6 行。
R
## 1.
rna_200 <- rna[200, ]
## 2.
## Saving `n_rows` to improve readability and reduce duplication
n_rows <- nrow(rna)
rna_last <- rna[n_rows, ]
## 3.
rna_middle <- rna[n_rows / 2, ]
## 4.
rna_head <- rna[-(7:n_rows), ]
因子
因子表示分类数据。它们以与标签关联的整数形式存储,且可以是有序或无序的。虽然因子看起来(且通常表现得)像字符向量,但在 R 中实际上被视为整数向量。因此,在将它们作为字符串处理时,需要格外小心。
一旦创建,因子只能包含一组预定义的值,称为级别。默认情况下,R 总是按字母顺序对级别进行排序。例如,如果你有一个包含 2 个级别的因子:
R
sex <- factor(c("male", "female", "female", "male", "female"))
R 会将 1 分配给层级 "female",将
2 分配给层级 "male"(因为 f 在
m 之前,尽管该向量的第一个元素是
"male")。你可以使用函数 levels()
来查看这一点,并使用 nlevels() 来查找层级数量:
R
levels(sex)
输出
[1] "female" "male" R
nlevels(sex)
输出
[1] 2有时,因子的顺序并不重要;而有时,你可能希望指定顺序,因为该顺序具有实际意义(例如“低”、“中”、“高”),能够改善可视化效果,或者是特定类型的分析所要求的。在这里,重新排列
sex 向量中级别的一种方法是:
R
sex ## current order
输出
[1] male   female female male   female
Levels: female male
R
sex <- factor(sex, levels = c("male", "female"))
sex ## after re-ordering
输出
[1] male   female female male   female
Levels: male female
在 R 的内存中,这些因子由整数 (1, 2, 3)
表示,但由于因子具有自描述性,因此比整数提供更多信息:"female"、"male"
比 1、2
更具描述性。哪一个是“雄性”?仅凭整数数据是无法判断的。而因子则内置了这一信息。当级别较多时(如我们示例数据集中的基因生物型),这种方式尤为有用。
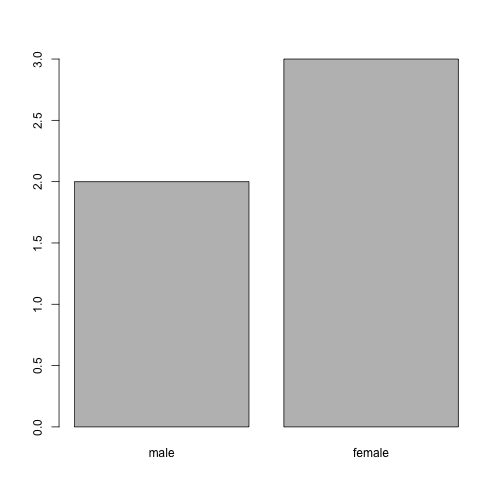
当数据以因子形式存储时,您可以使用 plot()
函数快速查看每个因子层级所代表的观测值数量。让我们来看看数据中雄性和雌性的数量。
R
plot(sex)
转换为字符串
如果需要将因子转换为字符向量,请使用
as.character(x)。
R
as.character(sex)
输出
[1] "male" "female" "female" "male" "female"重命名因子
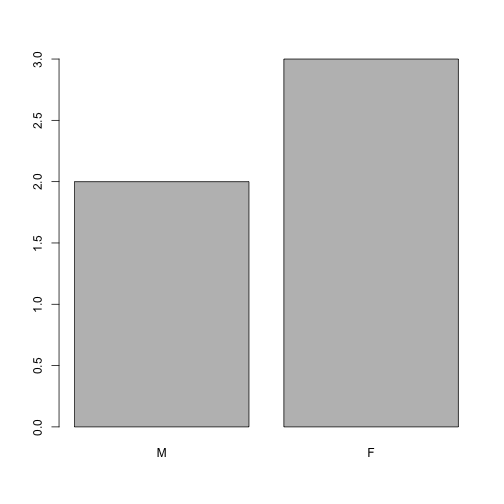
如果我们想重命名这些因子,只需修改其层级即可:
R
levels(sex)
输出
[1] "male" "female"R
levels(sex) <- c("M", "F")
sex
输出
[1] M F F M F
Levels: M F
R
plot(sex)
挑战:
- 将“F”和“M”分别重命名为“Female”和“Male”。
R
levels(sex)
输出
[1] "M" "F"R
levels(sex) <- c("Male", "Female")
- 动物名称周围缺少引号
- “feel”列缺失一项(可能是其中一种毛茸茸的动物)
- weight 列缺少一个逗号
挑战:
你能预测下面示例中每一列的类型吗?
使用 str(country_climate) 检查你的猜测:
它们符合你的预期吗?为什么?为什么不呢?
尝试在创建数据框时,在最后一个变量后添加
stringsAsFactors = TRUE。现在发生了什么?在使用read.csv()将基于文本的电子表格读取到 R 中时,也可以设置stringsAsFactors。
R
country_climate <- data.frame(
       country = c("Canada", "Panama", "South Africa", "Australia"),
       climate = c("cold", "hot", "temperate", "hot/temperate"),
       temperature = c(10, 30, 18, "15"),
       northern_hemisphere = c(TRUE, TRUE, FALSE, "FALSE"),
       has_kangaroo = c(FALSE, FALSE, FALSE, 1)
       )
R
country_climate <- data.frame(
       country = c("Canada", "Panama", "South Africa", "Australia"),
       climate = c("cold", "hot", "temperate", "hot/temperate"),
       temperature = c(10, 30, 18, "15"),
       northern_hemisphere = c(TRUE, TRUE, FALSE, "FALSE"),
       has_kangaroo = c(FALSE, FALSE, FALSE, 1)
       )
str(country_climate)
输出
'data.frame':	4 obs. of  5 variables:
 $ country            : chr  "Canada" "Panama" "South Africa" "Australia"
 $ climate            : chr  "cold" "hot" "temperate" "hot/temperate"
 $ temperature        : chr  "10" "30" "18" "15"
 $ northern_hemisphere: chr  "TRUE" "TRUE" "FALSE" "FALSE"
 $ has_kangaroo       : num  0 0 0 1
数据类型的自动转换有时是便利,有时则令人困扰。请留意这一机制的存在,掌握相关规则,并仔细核对在 R 中导入的数据在数据框中是否为正确类型。如果不对,可以利用这一点来检测数据录入过程中可能出现的错误(例如,某一列中出现了字母,而该列应当仅包含数字)。
在此 RStudio 教程 中了解更多信息
矩阵
在继续学习之前,既然我们已经了解了数据框,让我们回顾一下包的安装,并学习一种新的数据类型,即
matrix。与 data.frame
一样,矩阵具有行和列两个维度。但主要区别在于,matrix
中的所有单元格必须属于同一种类型:numeric、character、logical、…
从这个意义上说,矩阵与 vector 更为接近,而非
data.frame。
矩阵的默认构造函数是
matrix。它接收一个用于填充矩阵的值向量,以及行数和/或列数1。如下图所示,这些值按列依次填充。
R
m <- matrix(1:9, ncol = 3, nrow = 3)
m
输出
     [,1] [,2] [,3]
[1,]    1    4    7
[2,]    2    5    8
[3,] 3 6 9挑战:
使用函数 installed.packages() 创建一个
character
矩阵,其中包含当前计算机上所有已安装包的信息。对其进行探索。
R
## create the matrix
ip <- installed.packages()
head(ip)
## try also View(ip)
## number of package
nrow(ip)
## names of all installed packages
rownames(ip)
## type of information we have about each package
colnames(ip)
创建大型随机数据矩阵作为测试数据通常很有用。下面的练习要求你创建这样一个由均值
0、标准差 1 的正态分布抽取的随机数据矩阵,这可以通过
rnorm() 函数实现。
挑战:
构建一个 1000 x 3 的正态分布数据矩阵(均值 0,标准差 1)
R
set.seed(123)
m <- matrix(rnorm(3000), ncol = 3)
dim(m)
输出
[1] 1000 3R
head(m)
输出
            [,1]        [,2]       [,3]
[1,] -0.56047565 -0.99579872 -0.5116037
[2,] -0.23017749 -1.03995504  0.2369379
[3,]  1.55870831 -0.01798024 -0.5415892
[4,]  0.07050839 -0.13217513  1.2192276
[5,]  0.12928774 -2.54934277  0.1741359
[6,]  1.71506499  1.04057346 -0.6152683
日期格式化
新手(以及资深!)R 用户最常遇到的问题之一,就是将日期和时间信息转换为在分析过程中适用且可用的变量。
关于电子表格程序中日期的注意事项
电子表格中的日期通常存储在单一列中。虽然这看起来是记录日期最自然的方式,但实际上并非最佳实践。电子表格应用程序会以看似正确的方式(对人类观察者而言)显示日期,但其实际处理和存储日期的方式可能会存在问题。将年份 (YEAR)、月份 (MONTH) 和日期 (DAY) 分别存储在独立列中,或者将年份 (YEAR) 和一年中的第几天 (DAY-OF-YEAR) 分别存储在独立列中,通常要安全得多。
诸如 LibreOffice、Microsoft Excel、OpenOffice、Gnumeric 等电子表格软件,在编码日期时采用了不同的(且通常互不兼容的)方式(即使是同一软件在不同版本和操作系统之间也是如此)。此外,Excel 还会将非日期项转换为日期 ( Zeeberg et al. (2004) ),例如 MAR1、DEC1、OCT4 等名称或标识符。因此,如果你整体上避免使用日期格式,就更容易发现这些问题。
Data Carpentry 课程中的 Dates as data 章节提供了关于电子表格中日期处理陷阱的更多见解。
我们将使用来自 lubridate 包的
ymd() 函数(该包属于
tidyverse;欲了解更多信息,请访问 tidyverse
网站)。lubridate 随
tidyverse 的安装一同安装。当你加载
tidyverse
(library(tidyverse))
时,核心包(大多数数据分析中使用的包)将被加载。然而,lubridate
不属于 tidyverse 核心包,因此你必须通过 library(lubridate)
显式地加载它。
首先加载所需的包:
R
library("lubridate")
ymd() 接收一个表示年、月、日的向量,并将其转换为
Date 向量。Date 是 R
认可的日期数据类型,可以像日期一样进行操作。该函数所需的参数较为灵活,但作为最佳实践,应使用格式为
“YYYY-MM-DD” 的字符向量。
让我们创建一个日期对象并检查其结构:
R
my_date <- ymd("2015-01-01")
str(my_date)
输出
Date[1:1], format: "2015-01-01"现在让我们分别拼接年、月、日——结果相同:
R
# sep indicates the character to use to separate each component
my_date <- ymd(paste("2015", "1", "1", sep = "-"))
str(my_date)
输出
Date[1:1], format: "2015-01-01"现在让我们熟悉一个典型的日期处理流程。下面的小数据将日期分别存储在不同的
year、month 和 day 列中。
R
x <- data.frame(year = c(1996, 1992, 1987, 1986, 2000, 1990, 2002, 1994, 1997, 1985),
                month = c(2,  3,  3, 10,  1,  8,  3,  4,  5,  5),
                day = c(24,  8,  1,  5,  8, 17, 13, 10, 11, 24),
                value = c(4,  5,  1,  9,  3,  8, 10,  2,  6,  7))
x
输出
   year month day value
1  1996     2  24     4
2  1992     3   8     5
3  1987     3   1     1
4  1986    10   5     9
5  2000     1   8     3
6  1990     8  17     8
7  2002     3  13    10
8  1994     4  10     2
9  1997     5  11     6
10 1985     5  24     7
现在我们将此函数应用于 x 数据集。首先,我们使用
paste() 从 x 的
year、month 和 day
列创建一个字符向量:
R
paste(x$year, x$month, x$day, sep = "-")
输出
 [1] "1996-2-24" "1992-3-8"  "1987-3-1"  "1986-10-5" "2000-1-8"  "1990-8-17"
 [7] "2002-3-13" "1994-4-10" "1997-5-11" "1985-5-24"
此字符向量可用作 ymd() 的参数:
R
ymd(paste(x$year, x$month, x$day, sep = "-"))
输出
 [1] "1996-02-24" "1992-03-08" "1987-03-01" "1986-10-05" "2000-01-08"
 [6] "1990-08-17" "2002-03-13" "1994-04-10" "1997-05-11" "1985-05-24"
得到的 Date 向量可以作为新列 date 添加到
x 中:
R
x$date <- ymd(paste(x$year, x$month, x$day, sep = "-"))
str(x) # notice the new column, with 'date' as the class
输出
'data.frame':	10 obs. of  5 variables:
 $ year : num  1996 1992 1987 1986 2000 ...
 $ month: num  2 3 3 10 1 8 3 4 5 5
 $ day  : num  24 8 1 5 8 17 13 10 11 24
 $ value: num  4 5 1 9 3 8 10 2 6 7
 $ date : Date, format: "1996-02-24" "1992-03-08" ...
让我们确认一切是否运行正常。检查新列的一种方法是使用
summary():
R
summary(x$date)
输出
        Min.      1st Qu.       Median         Mean      3rd Qu.         Max.
"1985-05-24" "1988-01-11" "1993-03-24" "1993-03-18" "1997-01-20" "2002-03-13" 请注意,ymd()
要求按年、月、日的顺序排列。例如,如果您拥有日、月、年,则需要使用
dmy()。
R
dmy(paste(x$day, x$month, x$year, sep = "-"))
输出
 [1] "1996-02-24" "1992-03-08" "1987-03-01" "1986-10-05" "2000-01-08"
 [6] "1990-08-17" "2002-03-13" "1994-04-10" "1997-05-11" "1985-05-24"
lubdridate 提供了许多函数来处理各种日期变体。
R 对象概览
到目前为止,我们已经看到了几种 R 对象,它们在维度数量以及能否存储单一或多种数据类型方面各不相同:
-
vector:一维(具有长度),单一数据类型。 -
matrix:两维,单一数据类型。 -
data.frame:两维,每列一种类型。
列表
一种我们尚未见过、但值得了解,且由刚才看到的摘要推导出的数据类型,即列表:
-
list:单维,每个项可以是不同的数据类型。
下面,让我们创建一个包含数值向量、字符向量、矩阵、数据框以及另一个列表的列表:
R
l <- list(1:10, ## numeric
          letters, ## character
          installed.packages(), ## a matrix
          cars, ## a data.frame
          list(1, 2, 3)) ## a list
length(l)
输出
[1] 5R
str(l)
输出
List of 5
 $ : int [1:10] 1 2 3 4 5 6 7 8 9 10
 $ : chr [1:26] "a" "b" "c" "d" ...
 $ : chr [1:261, 1:17] "litedown" "metabolomicsWorkbenchR" "mgcv" "MultiAssayExperiment" ...
  ..- attr(*, "dimnames")=List of 2
  .. ..$ : chr [1:261] "litedown" "metabolomicsWorkbenchR" "mgcv" "MultiAssayExperiment" ...
  .. ..$ : chr [1:17] "Package" "LibPath" "Version" "Priority" ...
 $ :'data.frame':	50 obs. of  2 variables:
  ..$ speed: num [1:50] 4 4 7 7 8 9 10 10 10 11 ...
  ..$ dist : num [1:50] 2 10 4 22 16 10 18 26 34 17 ...
 $ :List of 3
  ..$ : num 1
  ..$ : num 2
  ..$ : num 3
列表子集操作使用 [] 来提取一个新的子列表,或使用
[[]]
来提取该列表中的单个元素(如果列表已命名,则使用索引或名称)。
R
l[[1]] ## first element
输出
[1] 1 2 3 4 5 6 7 8 9 10R
l[1:2] ## a list of length 2
输出
[[1]]
 [1]  1  2  3  4  5  6  7  8  9 10

[[2]]
 [1] "a" "b" "c" "d" "e" "f" "g" "h" "i" "j" "k" "l" "m" "n" "o" "p" "q" "r" "s"
[20] "t" "u" "v" "w" "x" "y" "z"
R
l[1] ## a list of length 1
输出
[[1]]
 [1]  1  2  3  4  5  6  7  8  9 10
导出与保存表格数据
我们已经了解了如何使用 read.table
系列函数将基于文本的电子表格读取到 R 中。若要将 data.frame
导出为基于文本的电子表格,可以使用 write.table
系列函数(write.csv、write.delim、…)。这些函数均需接收待导出的变量和导出目标文件。例如,若要将
rna 数据导出到 data_output 目录下的
my_rna.csv 文件中,我们可以执行:
R
write.csv(rna, file = "data_output/my_rna.csv")
现在可以将这个新的 CSV 文件与不熟悉 R 的其他合作者共享。请注意,尽管
data.frame 中的某些字段包含逗号(例如“product”列),但 R
默认会用引号将每个字段括起来,因此即使也使用逗号作为列分隔符,我们依然能够将其正确读取回
R 中。
- R 中的表格数据
行数或列数其中之一即可,因为另一者可以从数值的长度推导出来。试一下,如果数值与行数/列数不匹配会发生什么。↩︎