
اسپریڈشیٹس کے ذریعے ڈیٹا کی تنظیم
Last updated on 2026-11-11 | Edit this page
Overview
Questions
- ٹیبل ڈیٹا کو کیسے ترتیب دیا جائے؟
Objectives
- اسپریڈشیٹس، ان کی خوبیوں اور خامیوں کے بارے میں جانیں۔
- مؤثر ڈیٹا استعمال کے لیے ہم اسپریڈشیٹس میں ڈیٹا کو کیسے فارمیٹ کرتے ہیں؟
- اسپریڈشیٹس میں ہونے والی عام غلطیوں اور انہیں درست کرنے کے طریقوں کے بارے میں جانیں۔
- اپنے ڈیٹا کو منظم ڈیٹا کے اصولوں کے مطابق ترتیب دیں۔
- ٹیکسٹ پر مبنی اسپریڈشیٹ فارمیٹس، جیسے کہ کوما-سیپریٹڈ (CSV) یا ٹیب-سیپریٹڈ (TSV) فارمیٹس کے بارے میں جانیں۔
یہ ایپیسوڈ Data Carpentries کے Data Analysis and Visualisation in R for Ecologists اسباق پر مبنی ہے۔
اسپریڈشیٹ پروگرامز
سوال
- ڈیٹا کی بہتر ترتیب کے لیے اسپریڈشیٹس کے استعمال کے بنیادی اصول کیا ہیں؟
مقصد
- ڈیٹا کی ترتیب کے بہترین طریقہ کاروں کی وضاحت کریں تاکہ کمپیوٹرز ڈیٹا سیٹس کا بہترین استعمال کر سکیں۔
اہم نکتہ
- ڈیٹا کی بہترین تنظیم کسی بھی تحقیقی منصوبے کی بنیاد ہوتی ہے۔
ڈیٹا کی بہترین ترتیب آپ کے تحقیقی پروجیکٹ کی بنیاد ہے۔ زیادہ تر محققین کے پاس ڈیٹا اسپریڈشیٹس میں موجود ہوتا ہے یا وہ ان میں ڈیٹا انٹری کرتے ہیں۔ اسپریڈشیٹ پروگرامز ڈیٹا ٹیبلز ڈیزائن کرنے اور ڈیٹا کے معیار کے انتظام کے بنیادی افعال کو سنبھالنے کے لیے انتہائی مفید گرافیکل انٹرفیسز ہیں۔ Broman and Woo (2018). بھی دیکھیں۔
اسپریڈشیٹ کا خاکہ
اسپریڈشیٹس ڈیٹا انٹری کے لیے موزوں ہیں۔ اسی لیے ہمارے پاس اسپریڈشیٹس میں بہت زیادہ ڈیٹا موجود ہوتا ہے۔ بطور محقق، آپ کا بہت سارا وقت اس ‘ڈیٹا کی ترتیب و تیاری’ کے مرحلے میں گزرے گا۔ یہ بہت زیادہ دلچسپ نہیں ہے، لیکن ضروری ہے۔ ہم آپ کو یہ سکھائیں گے کہ ڈیٹا کی ترتیب کے بارے میں کیسے سوچنا ہے اور زیادہ مؤثر ڈیٹا کی ترتیب و تیاری کے لیے کچھ طریقے بھی۔
یہ سبق آپ کو یہ نہیں سکھائے گا
- اسپریڈشیٹ میں شماریات کیسے کریں
- اسپریڈشیٹ میں پلوٹنگ کیسے کریں
- اسپریڈشیٹ پروگراموں میں کوڈ لکھنے کا طریقہ
اگر آپ ایسا کرنا چاہتے ہیں، تو O’Reilly کی شائع کردہ Head First Excel ایک اچھا حوالہ ہے۔
ہم اسپریڈشیٹس میں ڈیٹا تجزیہ کیوں نہیں سکھا رہے؟
اسپریڈشیٹس میں ڈیٹا کا تجزیہ عام طور پر بہت زیادہ دستی کام کا مطالبہ کرتا ہے۔ اگر آپ کسی پیرامیٹر کو تبدیل کرنا چاہتے ہیں یا کسی نئے ڈیٹا سیٹ کے ساتھ تجزیہ کرنا چاہتے ہیں، تو آپ کو عام طور پر سب کچھ ہاتھ سے دوبارہ کرنا پڑتا ہے۔ (ہم جانتے ہیں کہ آپ میکروز بنا سکتے ہیں، لیکن اگلے نکتے کو دیکھیں۔)
اس کے علاوہ، جب آپ اپنے کام پر واپس جانا چاہتے ہوں یا کوئی آپ کے تجزیے کی تفصیلات مانگے، تو اسپریڈشیٹ پروگراموں میں کیے گئے شماریاتی یا پلاٹنگ تجزیوں کا سراغ لگانا یا انہیں دوبارہ تیار کرنا بھی مشکل ہوتا ہے۔
اسپریڈشیٹ پروگراموں کی بہت سی اقسام دستیاب ہیں۔ چونکہ زیادہ تر شرکاء اپنے بنیادی اسپریڈشیٹ پروگرام کے طور پر ایکسل (Excel) کا استعمال کرتے ہیں، اس لیے اس سبق میں ایکسل کی مثالوں کا استعمال کیا جائے گا۔ ایک مفت اسپریڈشیٹ پروگرام جو استعمال کیا جا سکتا ہے، وہ لیبر اوفیس (LibreOffice) ہے۔ پروگراموں کے درمیان کمانڈز میں تھوڑا فرق ہو سکتا ہے، لیکن بنیادی تصور ایک ہی ہے۔
اسپریڈشیٹ پروگرامز میں ان بہت سی چیزوں کا احاطہ ہوتا ہے جو ہمیں بطور محققین کرنے کی ضرورت ہوتی ہے۔ ہم انہیں درج ذیل مقاصد کے لیے استعمال کر سکتے ہیں:
- ڈیٹا انٹری
- ڈیٹا کی ترتیب
- ڈیٹا کی سب سیٹنگ اور ترتیب
- اعداد و شمار
- پلوٹنگ
اسپریڈشیٹ پروگرامز ڈیٹا کی نمائندگی اور نمائش کے لیے ٹیبلز کا استعمال کرتے ہیں۔ ٹیبلز کی شکل میں فارمیٹ شدہ ڈیٹا اس باب کا بنیادی موضوع بھی ہے، اور ہم دیکھیں گے کہ کس طرح ڈیٹا کو ایک معیاری طریقے سے ٹیبلز میں ترتیب دیا جائے تاکہ بعد کے مؤثر تجزیے کو یقینی بنایا جا سکے۔
چیلنج: اپنے پڑوسی کے ساتھ درج ذیل نکات پر تبادلہ خیال کریں
- کیا آپ نے اپنی تحقیق، کورسز، یا گھر پر اسپریڈشیٹس کا استعمال کیا ہے؟
- آپ اسپریڈشیٹس میں کس قسم کے آپریشنز کرتے ہیں؟
- آپ کے خیال میں اسپریڈشیٹس کس کاموں کے لیے موزوں ہیں؟
- کیا آپ نے کبھی کسی اسپریڈشیٹ پروگرام میں ایسا کچھ غلطی سے کیا ہے جس سے آپ مایوس یا اداس ہوئے ہیں؟
اسپریڈشیٹس کے مسائل
اسپریڈشیٹس ڈیٹا انٹری کے لیے موزوں ہیں، لیکن حقیقت میں ہم اسپریڈشیٹ پروگرامز کو ڈیٹا انٹری سے کہیں زیادہ مقاصد کے لیے استعمال کرتے ہیں۔ ہم انہیں اشاعتوں کے لیے ڈیٹا ٹیبلز تیار کرنے، خلاصہ اعداد و شمار حاصل کرنے اور فیگرز بنانے کے لیے استعمال کرتے ہیں۔
اسپریڈشیٹ میں اشاعتوں کے لیے ٹیبلز تیار کرنا موزوں طریقہ نہیں ہے - اکثر، اشاعت کے لیے ڈیٹا ٹیبل کو فارمیٹ کرتے وقت، ہم اہم خلاصہ اعداد و شمار کو اس طرح پیش کرتے ہیں جسے حقیقت میں ڈیٹا کے طور پر پڑھنے کا ارادہ نہیں ہوتا، اور اس میں اکثر خصوصی فارمیٹنگ (سیلز کو یکجا کرنا، بارڈرز بنانا، یا اسے خوبصورت بنانا) شامل ہوتی ہے۔ ہم آپ کو مشورہ دیتے ہیں کہ اس قسم کا کام اپنے ڈاکومنٹ ایڈیٹنگ سافٹ ویئر میں ہی کریں۔
بعد کے دو ایپلی کیشنز، اعداد و شمار اور اشکال کی تیاری، احتیاط کے ساتھ استعمال کیے جانے چاہئیں: اسپریڈشیٹ پروگراموں کی گرافیکل اور ڈریگ اینڈ ڈراپ خصوصیت کی وجہ سے، اپنے اقدامات کو دہرانا، بلکہ دوسروں کے اقدامات کو دہرانا بھی، انتہائی مشکل یا ناممکن ہو سکتا ہے، خاص طور پر اگر آپ کے اعداد و شمار یا اشکال کے لیے زیادہ پیچیدہ حسابات کرنے کی ضرورت ہو۔ مزید برآں، اسپریڈشیٹ میں حسابات کرتے وقت، غلطی سے متصل کئی سیلز پر تھوڑا مختلف فارمولا لاگو کر دینا آسان ہوتا ہے۔ جب آپ R یا SAS جیسے کمانڈ لائن پر مبنی اعداد و شمار کے پروگرام کا استعمال کرتے ہیں، تو یہ عملی طور پر ناممکن ہے کہ آپ اپنے ڈیٹا سیٹ کے ایک مشاہدے پر حساب کریں لیکن دوسرے پر نہ کریں، الا یہ کہ آپ یہ جان بوجھ کر کر رہے ہوں۔
ڈیٹا انٹری اور صفائی کے لیے اسپریڈشیٹس کا استعمال
اس سبق میں، ہم یہ فرض کریں گے کہ آپ غالباً اپنے بنیادی اسپریڈشیٹ پروگرام کے طور پر ایکسل (Excel) استعمال کر رہے ہیں - دیگر پروگرامز بھی موجود ہیں (gnumeric، OpenOffice کا Calc)، اور ان کی کارکردگی بھی ملتی جلتی ہے، لیکن ایکسل وہ پروگرام معلوم ہوتا ہے جسے ماہرینِ حیاتیات اور بائیو میڈیکل محققین سب سے زیادہ استعمال کرتے ہیں۔
اس سبق میں ہم ان بارے میں بات کریں گے:
- اسپریڈشیٹس میں ڈیٹا ٹیبلز کی فارمیٹنگ
- فارمیٹنگ کے مسائل
- ڈیٹا کی ایکسپورٹنگ
اسپریڈشیٹس میں ڈیٹا ٹیبلز کی فارمیٹنگ
سوالات
- مؤثر ڈیٹا استعمال کے لیے ہم اسپریڈشیٹس میں ڈیٹا کو کیسے فارمیٹ کرتے ہیں؟
اہداف
اسپریڈشیٹس میں ڈیٹا انٹری اور فارمیٹنگ کے لیے بہترین طریقہ کار کی وضاحت کریں۔
اسپریڈشیٹ میں متغیرات اور مشاہدات کو ترتیب دینے کے لیے بہترین طریقہ کار اپنائیں۔
اہم نکات
اپنے خام ڈیٹا میں کبھی تبدیلی نہ کریں۔ کوئی بھی تبدیلی کرنے سے پہلے ہمیشہ ایک کاپی بنا لیں۔
اپنے ڈیٹا کو صاف کرنے کے لیے اٹھائے گئے تمام اقدامات کا ریکارڈ ایک پلین ٹیکسٹ فائل میں رکھیں۔
اپنے ڈیٹا کو منظم ڈیٹا کے اصولوں کے مطابق ترتیب دیں۔
سب سے عام غلطی یہ ہوتی ہے کہ اسپریڈشیٹ پروگراموں کو لیب نوٹ بکس کی طرح استعمال کیا جائے، یعنی معلومات پہنچانے کے لیے سیاق و سباق، مارجن میں لکھی ہوئی نوٹس، ڈیٹا اور فیلڈز کی مکانی ترتیب پر بھروسہ کیا جائے۔ بطور انسان، ہم (عام طور پر) ان چیزوں کی تشریح کر سکتے ہیں، لیکن کمپیوٹرز معلومات کو اسی طرح نہیں دیکھتے، اور جب تک ہم کمپیوٹر کو یہ نہیں بتائیں کہ ہر ایک چیز کا کیا مطلب ہے (اور یہ مشکل ہو سکتا ہے!)، وہ یہ نہیں سمجھ پائے گا کہ ہمارا ڈیٹا ایک دوسرے کے ساتھ کیسے جڑا ہوا ہے۔
کمپیوٹرز کی طاقت کا استعمال کرتے ہوئے، ہم ڈیٹا کو کہیں زیادہ مؤثر اور تیز طریقوں سے مینج اور تجزیہ کر سکتے ہیں، لیکن اس طاقت کا استعمال کرنے کے لیے، ہمیں اپنے ڈیٹا کو اس طرح تیار کرنا ہوگا کہ کمپیوٹر اسے سمجھ سکے (اور کمپیوٹرز بہت سختی سے حقیقت پسند ہوتے ہیں)۔
اسی لیے شروع سے ہی بہترین طریقے سے فارمیٹ شدہ ٹیبلز تیار کرنا انتہائی ضروری ہے—اس سے پہلے کہ آپ اپنے پہلے ابتدائی تجربے سے ڈیٹا درج کرنا شروع کریں۔ ڈیٹا کی تنظیم آپ کے تحقیقی منصوبے کی بنیاد ہے۔ یہ آپ کے تجزیے کے دوران ڈیٹا کے ساتھ کام کرنے کو آسان یا مشکل بنا سکتی ہے، اس لیے ڈیٹا درج کرتے وقت یا اپنے تجربے کو ترتیب دیتے وقت اس بارے میں سوچنا فائدہ مند ہے۔ آپ اسپریڈشیٹس میں مختلف طریقوں سے چیزوں کو ترتیب دے سکتے ہیں، لیکن ان میں سے کچھ انتخاب دیگر پروگراموں میں ڈیٹا کے ساتھ کام کرنے کی آپ کی صلاحیت کو محدود کر سکتے ہیں یا اس بات میں رکاوٹ بن سکتے ہیں کہ آپ کے 6 ماہ بعد کا آپ یا آپ کا کوئی ساتھی ڈیٹا کے ساتھ کام کر سکے۔
نوٹ: ڈیٹا انٹری اور ڈیٹا تجزیے کے لیے بہترین لے آؤٹس/فارمیٹس (نیز سافٹ ویئر اور انٹرفیسز) مختلف ہو سکتے ہیں۔ اس بات کو مدنظر رکھنا ضروری ہے، اور مثالی طور پر ایک سے دوسرے میں تبدیلی کو خودکار بنانا بہتر ہے۔
اپنے تجزیوں کا ریکارڈ رکھنا
جب آپ اسپریڈشیٹس کے ساتھ کام کر رہے ہوں، تو ڈیٹا کی صفائی یا تجزیوں کے دوران، یہ بہت آسان ہو جاتا ہے کہ آپ کا اسپریڈشیٹ اس سے بہت مختلف نظر آنے لگے جو آپ نے شروع میں استعمال کیا تھا۔ اپنے تجزیوں کو دوبارہ حاصل کرنے یا اس بات کا پتہ لگانے کے لیے کہ آپ نے کیا کیا تھا جب کوئی ریویوئر یا انسٹرکٹر کسی مختلف تجزیے کی درخواست کرے، آپ کو
اپنے صاف کیے ہوئے یا تجزیہ شدہ ڈیٹا کے ساتھ ایک نیا فائل بنائیں۔ اصل ڈیٹا سیٹ کو تبدیل نہ کریں، ورنہ آپ کبھی یہ نہیں جان پائیں گے کہ آپ کہاں سے شروع کیا تھا!
اپنی صفائی یا تجزیے میں اٹھائے گئے مراحل کا حساب رکھیں۔ آپ کو ان مراحل کو اسی طرح ریکارڈ کرنا چاہیے جیسے آپ کسی تجربے کے کسی بھی مرحلے کو ریکارڈ کرتے ہیں۔ ہم تجویز کرتے ہیں کہ آپ یہ کام ایک سادہ ٹیکسٹ فائل میں کریں جو ڈیٹا فائل والے ہی فولڈر میں محفوظ ہو۔
یہ اسپریڈشیٹ کی ترتیب کی ایک مثال ہو سکتی ہے:
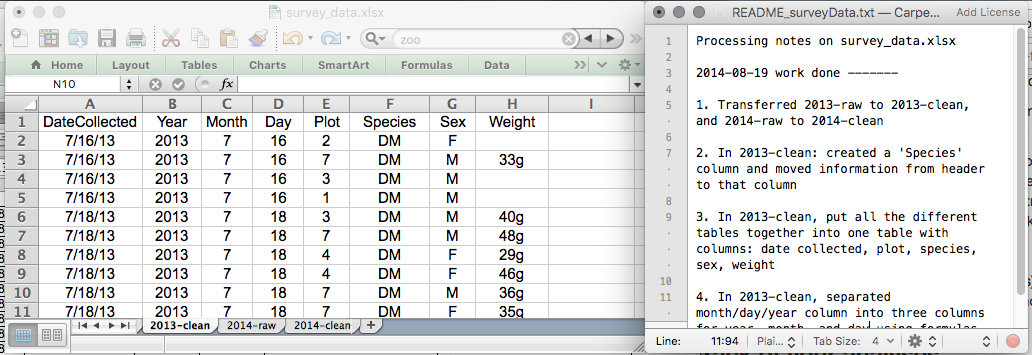
ان اصولوں کو آج ہی اپنی مشقوں کے دوران عملی طور پر لاگو کریں۔
اگرچہ ورژننگ اس کورس کے دائرہ کار سے باہر ہے، لیکن آپ اپنے ڈیٹا پر ورژن کنٹرول کو برقرار رکھنے کے طریقے سیکھنے کے لیے Carpentries کے ‘Git’ پر مبنی اسباق کو دیکھ سکتے ہیں۔ ایک مختصر ٹیوٹوریل کے لیے اس بلاگ پوسٹ یا زیادہ تحقیقی طور پر استعمال کے کیس کے لیے Perez-Riverol et al. (2016) کو بھی دیکھیں۔
اسپریڈشیٹس میں ڈیٹا کی ساخت
ڈیٹا کے لیے اسپریڈشیٹ پروگرامز کے استعمال کے بنیادی اصول:
- اپنے تمام متغیرات کو کالموں میں رکھیں - وہ چیز جس کی آپ پیمائش کر رہے ہیں، جیسے کہ ‘وزن’ یا ‘درجہ حرارت’۔
- ہر مشاہدے کو اپنی ایک الگ قطار میں رکھیں۔
- ایک ہی سیل میں معلومات کے متعدد حصوں کو یکجا نہ کریں۔ کبھی کبھی یہ صرف ایک چیز معلوم ہوتی ہے، لیکن سوچیں کہ کیا یہی وہ واحد طریقہ ہے جس کے ذریعے آپ اس ڈیٹا کو استعمال یا ترتیب دینا چاہیں گے۔
- خام ڈیٹا کو خام ہی رہنے دیں - اس میں کوئی تبدیلی نہ کریں!
- صاف کیے گئے ڈیٹا کو ٹیکسٹ پر مبنی فارمیٹ، جیسے کہ CSV (کوما-سیپریٹڈ ویلیوز) فارمیٹ میں ایکسپورٹ کریں۔ اس سے یہ یقینی بنتا ہے کہ کوئی بھی اس ڈیٹا کو استعمال کر سکے، اور زیادہ تر ڈیٹا ریپوزٹریز کے لیے یہ ضروری ہے۔
مثال کے طور پر، ہمارے پاس ان مریضوں کا ڈیٹا ہے جو برسلز، بیلجیم کے کئی ہسپتالوں میں آئے تھے۔ انہوں نے دورے کی تاریخ، ہسپتال، مریضوں کی جنس، وزن اور خون کے گروپ کا ریکارڈ کیا تھا۔
اگر ہم ڈیٹا کا حساب اس طرح رکھیں:
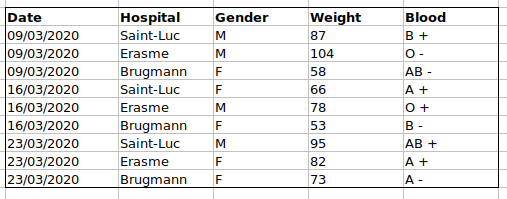
مسئلہ یہ ہے کہ ABO اور Rhesus گروپس ایک ہی Blood ٹائپ
کالم میں ہیں۔ لہٰذا، اگر وہ A گروپ کے تمام مشاہدات کا جائزہ لینا چاہتے
ہوں یا ABO گروپ کے لحاظ سے وزن کی تقسیم دیکھنا چاہتے ہوں، تو اس ڈیٹا سیٹ
اپ کا استعمال کرتے ہوئے ایسا کرنا مشکل ہوگا۔ اگر اس کے بجائے ہم ABO اور
Rhesus گروپس کو الگ الگ کالموں میں رکھیں، تو آپ دیکھ سکتے ہیں کہ یہ کہیں
زیادہ آسان ہو جائے گا۔
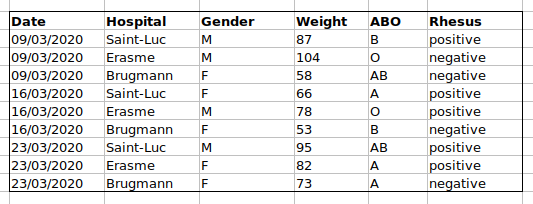
ڈیٹا شیٹ تیار کرتے وقت ایک اہم قاعدہ یہ ہے کہ کالموں کا استعمال متغیرات کے لیے کیا جاتا ہے اور قطاروں کا استعمال مشاہدات کے لیے کیا جاتا ہے:
- کالمز متغیرات ہیں
- قطاریں مشاہدات ہیں
- سیلز انفرادی اقدار ہیں
چیلنج: ہم ایک غیر منظم ڈیٹا سیٹ کو لیں گے اور بتائیں گے کہ ہم اسے کیسے صاف کریں گے۔
اس لنک پر کلک کر کے ایک غیر منظم ڈیٹا سیٹ ڈاؤن لوڈ کریں۔
ڈیٹا کو ایک اسپریڈشیٹ پروگرام میں کھولیں۔
آپ دیکھ سکتے ہیں کہ یہاں دو ٹیبز موجود ہیں۔ ڈیٹا میں مختلف کلینیکل متغیرات شامل ہیں جو 2020 میں کووڈ-19 کی پہلی اور دوسری لہروں کے دوران برسلز کے مختلف ہسپتالوں میں ریکارڈ کی گئی تھیں۔ جیسا کہ آپ دیکھ سکتے ہیں، مارچ اور نومبر کی لہروں کے دوران ڈیٹا کو مختلف طریقوں سے ریکارڈ کیا گیا تھا۔ اب آپ اس پروجیکٹ کے ذمہ دار شخص ہیں اور آپ ڈیٹا کا تجزیہ شروع کرنا چاہتے ہیں۔
اپنے ساتھ موجود شخص کے ساتھ مل کر، اس اسپریڈشیٹ میں کیا غلطی ہے، اس کی نشاندہی کریں۔ اس کے علاوہ، ان مراحل پر بھی تبادلہ خیال کریں جو آپ کو پہلی اور دوسری لہر کے ٹیبز کو صاف کرنے اور انہیں ایک ہی اسپریڈشیٹ میں یکجا کرنے کے لیے اٹھانے پڑیں گے۔
اہم: ہماری پہلی مشورے کو نہ بھولیں: صاف کیے گئے ڈیٹا کے لیے ایک نیا فائل (یا ٹیب) بنائیں، اپنے اصل (خام) ڈیٹا میں کبھی بھی تبدیلی نہ کریں۔
اس مشق کو مکمل کرنے کے بعد، ہم ایک گروپ کے طور پر اس بات پر تبادلہ خیال کریں گے کہ اس ڈیٹا میں کیا غلطی تھی اور آپ اسے کیسے درست کریں گے۔
چیلنج: ڈیٹا کو ترتیب دینے کے بعد، درج ذیل سوالات کے جوابات دیں:
- اس مطالعے میں کتنے مردوں اور عورتوں نے شرکت کی؟
- کتنے A، AB اور B اقسام کا ٹیسٹ کیا گیا ہے؟
- جیسا کہ اوپر، لیکن آلودہ نمونوں کو نظر انداز کرتے ہوئے؟
- کتنے Rhesus + اور - کے نمونے ٹیسٹ کیے گئے ہیں؟
- کتنے یونیورسل ڈونرز (O-) کا ٹیسٹ کیا گیا ہے؟
- AB رکھنے والے مردوں کا اوسط وزن کتنا ہے؟
- مختلف ہسپتالوں میں کتنے نمونوں کا ٹیسٹ کیا گیا ہے؟
ایک بہترین حوالہ، خاص طور پر R اسکرپٹنگ کے حوالے سے، Tidy Data پیپر Wickham (2014). ہے۔
اسپریڈشیٹس میں عام غلطیاں
سوالات
- اسپریڈشیٹس میں ڈیٹا کی فارمیٹنگ کے حوالے سے کچھ عام چیلنجز کیا ہیں اور ہم ان سے کیسے بچ سکتے ہیں؟
اہداف
- اسپریڈشیٹ فارمیٹنگ کے عام مسائل کی شناخت کریں اور انہیں حل کریں۔
اہم نکات
- ایک ہی اسپریڈشیٹ میں متعدد ٹیبلز کے استعمال سے گریز کریں۔
- ڈیٹا کو متعدد ٹیبز پر پھیلانے سے گریز کریں۔
- صفر کو صفر کے طور پر درج کریں۔
- غیر موجود ڈیٹا کو درج کرنے کے لیے ایک مناسب نل ویلیو استعمال کریں۔
- معلومات پہنچانے یا اپنے اسپریڈشیٹ کو خوبصورت بنانے کے لیے فارمیٹنگ استعمال نہ کریں۔
- تبصرے ایک علیحدہ کالم میں رکھیں۔
- کالم کے سرخیوں میں اکائیوں کو درج کریں۔
- ایک سیل میں صرف ایک معلومات شامل کریں۔
- کالم کے سرخیوں میں خالی جگہوں، اعداد اور خصوصی حروف سے گریز کریں۔
- اپنے ڈیٹا میں خصوصی حروف سے گریز کریں۔
- میٹا ڈیٹا کو ایک علیحدہ پلین ٹیکسٹ فائل میں درج کریں۔
اپنے ڈیٹا کے ساتھ ساتھ تعاون کرنے والوں یا انٹرنیٹ سے حاصل کردہ ڈیٹا میں بھی کچھ ممکنہ غلطیوں کے بارے میں خبردار رہنے کی ضرورت ہے۔ اگر آپ ان غلطیوں اور آنے والے ڈیٹا تجزیے اور نتائج کی تشریح پر ان کے ممکنہ منفی اثرات سے واقف ہیں، تو یہ آپ کو اور آپ کے پروجیکٹ ممبران کو ان سے بچنے کی کوشش کرنے کے لیے ترغیب دے سکتا ہے۔ اسپریڈشیٹس میں اپنے ڈیٹا کو فارمیٹ کرنے کے طریقے میں معمولی تبدیلیاں کرنے سے ڈیٹا کی صفائی اور تجزیے کے حوالے سے کارکردگی اور بھروسہ مندی پر گہرا اثر پڑ سکتا ہے۔
- ایک سے زیادہ ٹیبلز کا استعمال
- ایک سے زیادہ ٹیبز کا استعمال
- صفر کو پُر نہ کرنا
- مسئلہ پیدا کرنے والی نل ویلیوز کا استعمال
- معلومات پہنچانے کے لیے فارمیٹنگ کا استعمال
- ڈیٹا شیٹ کو خوبصورت بنانے کے لیے فارمیٹنگ کا استعمال
- سیلز میں تبصرے یا یونٹس شامل کرنا
- ایک سیل میں ایک سے زیادہ معلومات درج کرنا
- مسئلہ پیدا کرنے والے فیلڈ ناموں کا استعمال
- ڈیٹا میں خصوصی حروف کا استعمال
- ڈیٹا ٹیبل میں میٹا ڈیٹا کی شمولیت
ایک سے زیادہ ٹیبلز کا استعمال
ایک عام طریقہ کار یہ ہے کہ ایک ہی اسپریڈشیٹ میں متعدد ڈیٹا ٹیبلز بنائے جائیں۔ یہ کمپیوٹر کو الجھن میں ڈال دیتا ہے، اس لیے ایسا نہ کریں! جب آپ ایک ہی اسپریڈشیٹ میں متعدد ٹیبلز بناتے ہیں، تو آپ کمپیوٹر کے لیے چیزوں کے درمیان غلط تعلقات قائم کر رہے ہوتے ہیں، کیونکہ کمپیوٹر ہر قطار کو ایک مشاہدے کے طور پر دیکھتا ہے۔ آپ ممکنہ طور پر ایک ہی فیلڈ کا نام متعدد جگہوں پر استعمال کر رہے ہوں گے، جس سے آپ کے ڈیٹا کو قابلِ استعمال شکل میں ترتیب دینا مشکل ہو جائے گا۔ نیچے دیا گیا مثال اس مسئلے کی وضاحت کرتا ہے:
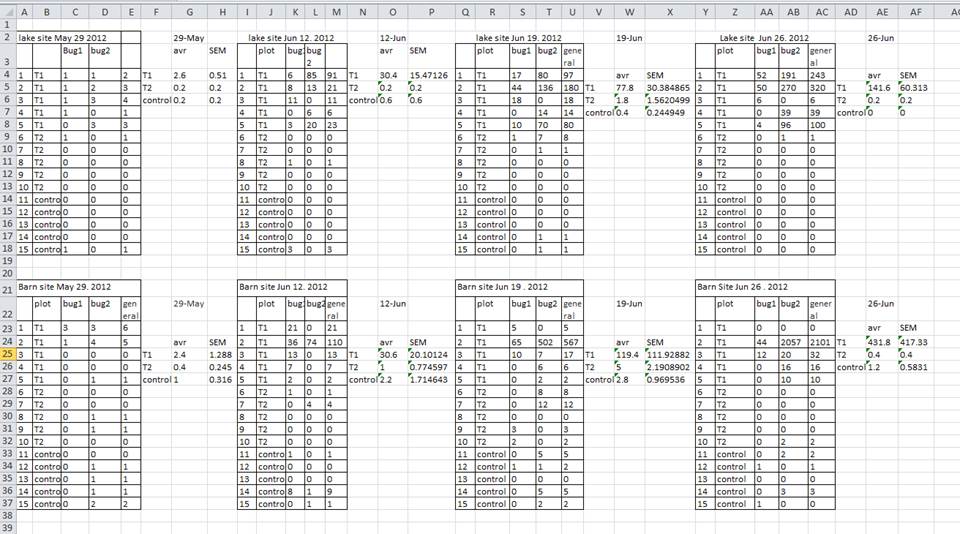
مندرجہ بالا مثال میں، کمپیوٹر (مثال کے طور پر) قطار 4 کو دیکھے گا اور یہ فرض کرے گا کہ تمام کالمز A-AF ایک ہی نمونے کی طرف اشارہ کرتے ہیں۔ یہ قطار دراصل چار الگ الگ نمونوں (چار مختلف جمع کرنے کی تاریخوں — 29 مئی، 12 جون، 19 جون، اور 26 جون — کے لیے ہر ایک کا نمونہ 1) کی نمائندگی کرتی ہے، نیز ان میں سے دو نمونوں کے لیے کچھ حساب کیے گئے خلاصہ اعداد و شمار (ایک اوسط (avr) اور پیمائش کی معیاری غلطی (SEM)) بھی پیش کرتی ہے۔ دیگر قطاریں بھی اسی طرح مسئلہ پیدا کرتی ہیں۔
متعدد ٹیبز کا استعمال
لیکن ورک بک ٹیبز کا کیا ہوگا؟ ڈیٹا کو ترتیب دینے کا یہ ایک آسان طریقہ لگتا ہے، ہے نا؟ خیر، ہاں اور نہیں۔ جب آپ اضافی ٹیبز بناتے ہیں، تو آپ کمپیوٹر کو ڈیٹا میں موجود تعلقات دیکھنے کے موقع سے محروم کر دیتے ہیں (اس تعلق کو یقینی بنانے کے لیے آپ کو اسپریڈشیٹ ایپلی کیشن کے مخصوص فنکشنز یا اسکرپٹنگ کا استعمال کرنا پڑتا ہے)۔ مثال کے طور پر، فرض کریں کہ آپ ہر اس دن کے لیے ایک الگ ٹیب بناتے ہیں جب آپ پیمائش کرتے ہیں۔
یہ دو وجوہات کی بنا پر ایک بہتر طریقہ کار نہیں ہے:
آپ کے ڈیٹا میں غلطی سے تضادات شامل کرنے کا امکان زیادہ ہو جاتا ہے اگر ہر بار جب آپ کوئی پیمائش کریں، تو ڈیٹا کو ایک نئے ٹیب میں ریکارڈ کرنا شروع کر دیں، اور
چاہے آپ تمام تضادات کو ختم کرنے میں کامیاب ہی کیوں نہ ہوں، ڈیٹا کا تجزیہ کرنے سے پہلے آپ کو ایک اضافی مرحلہ اختیار کرنا پڑے گا کیونکہ آپ کو ان ڈیٹا کو ایک ہی ڈیٹا ٹیبل میں یکجا کرنا ہوگا۔ آپ کو کمپیوٹر کو واضح طور پر بتانا ہوگا کہ ٹیبز کو کیسے یکجا کیا جائے - اور اگر ٹیبز کی فارمیٹنگ غیر یکساں ہو، تو شاید آپ کو یہ کام دستی طور پر بھی کرنا پڑے۔
اگلی بار جب آپ ڈیٹا درج کر رہے ہوں گے اور کوئی اور ٹیب یا ٹیبل بنانے جائیں گے، تو خود سے پوچھیں کہ کیا آپ اپنے اصل اسپریڈشیٹ میں ایک اور کالم شامل کر کے اس ٹیب کو شامل کرنے سے بچ سکتے ہیں۔ ہم نے ایک بے ترتیب ڈیٹا فائل کی مثال میں متعدد ٹیبز استعمال کیے تھے، لیکن اب آپ نے دیکھا ہے کہ آپ اپنے ڈیٹا کو کس طرح دوبارہ ترتیب دے کر مختلف ٹیبز میں یکجا کر سکتے ہیں۔
تجربے کے دوران آپ کی ڈیٹا شیٹ بہت طویل ہو سکتی ہے۔ اگر آپ کو اسپریڈشیٹ کے اوپری حصے میں اپنے ہیڈرز نظر نہ آئیں، تو ڈیٹا درج کرنا مشکل ہو جاتا ہے۔ لیکن اپنی ہیڈر رو کو دہرائیں مت۔ یہ آسانی سے ڈیٹا میں شامل ہو سکتے ہیں، جس سے مستقبل میں مسائل پیدا ہو سکتے ہیں۔ اس کے بجائے، آپ کالم ہیڈرز کو فریز کر سکتے ہیں تاکہ وہ اس وقت بھی نظر آتے رہیں جب آپ کے پاس بہت سی قطاروں والی اسپریڈشیٹ ہو۔
صفر کو پُر نہ کرنا
ہو سکتا ہے کہ جب آپ کسی چیز کی پیمائش کر رہے ہوں، تو وہ عام طور پر صفر ہو، مثال کے طور پر سروے میں ایک خرگوش کے مشاہدہ کی تعداد۔ جب اس کالم میں زیادہ تر صفر ہوں، تو اس میں صفر کا نمبر لکھنے کی ضرورت کیا ہے؟
تاہم، اسپریڈشیٹ میں صفر اور خالی سیل کے درمیان فرق ہوتا ہے۔ کمپیوٹر کے لیے، صفر دراصل ڈیٹا ہوتا ہے۔ آپ نے اسے ناپا یا گنا ہے۔ ایک خالی سیل کا مطلب ہے کہ اسے ناپا نہیں گیا اور کمپیوٹر اسے ایک نامعلوم ویلیو (جسے نل یا مسڈ ویلیو بھی کہا جاتا ہے) کے طور پر تشریح کرے گا۔
اسپریڈشیٹس یا شماریاتی پروگرامز غالباً ان خالی خلیات کو غلط طور پر سمجھ لیں گے جنہیں آپ صفر رکھنے کا ارادہ رکھتے ہیں۔ اپنے مشاہدے کی ویلیو درج نہ کر کے، آپ اپنے کمپیوٹر کو یہ بتاتے ہیں کہ اس ڈیٹا کو نامعلوم یا غائب (null) کے طور پر ظاہر کرے۔ اس سے بعد کے حسابات یا تجزیوں میں مسائل پیدا ہو سکتے ہیں۔ مثال کے طور پر، اعداد کے ایک سیٹ کی اوسط جس میں ایک غیر معلوم ویلیو شامل ہو، ہمیشہ غیر معلوم ہوتی ہے (کیونکہ کمپیوٹر غائب مشاہدات کی ویلیو کا اندازہ نہیں لگا سکتا)۔ اسی وجہ سے، صفر کو صفر کے طور پر اور واقعی غائب ڈیٹا کو غیر معلوم (nulls) کے طور پر ریکارڈ کرنا بہت ضروری ہے۔
مسئلہ پیدا کرنے والی نل ویلیوزکا استعمال
مثال: غائب ڈیٹا کی نمائندگی کے لیے -999 یا دیگر عددی اقدار (یا صفر) کا استعمال کرنا۔
حل:
ڈیٹا سیٹ کے اندر نل ویلیوز (null values) کو مختلف طریقوں سے ظاہر کرنے کی چند وجوہات ہوتی ہیں۔ کبھی کبھی پیمائشی آلے سے پریشان کن نل ویلیوز خود بخود ریکارڈ ہو جاتی ہیں۔ اگر ایسا ہے، تو آپ کے پاس زیادہ کچھ کرنے کو نہیں ہوتا، لیکن تجزیے سے پہلے OpenRefine جیسے ٹول کے ذریعے ڈیٹا کی صفائی (data cleaning) میں اس کا حل نکالا جا سکتا ہے۔ دیگر اوقات میں، ڈیٹا کی عدم موجودگی کی مختلف وجوہات بیان کرنے کے لیے مختلف نل ویلیوز استعمال کی جاتی ہیں۔ یہ ریکارڈ کرنے کے قابل اہم معلومات ہیں، لیکن اس کا مطلب دراصل ایک کالم کو دو معلومات ریکارڈ کرنے کے لیے استعمال کرنا ہے۔ جیسا کہ معلومات پہنچانے کے لیے فارمیٹنگ کا استعمال کرنے کی صورت میں ہوتا ہے، یہاں بھی ‘data_missing’ جیسا ایک نیا کالم بنانا اور اس کالم کو مختلف وجوہات ریکارڈ کرنے کے لیے استعمال کرنا بہتر رہے گا۔
وجہ جو بھی ہو، یہ ایک مسئلہ ہے اگر نامعلوم یا غائب ڈیٹا کو -999، 999، یا 0 کے طور پر ریکارڈ کیا جائے۔
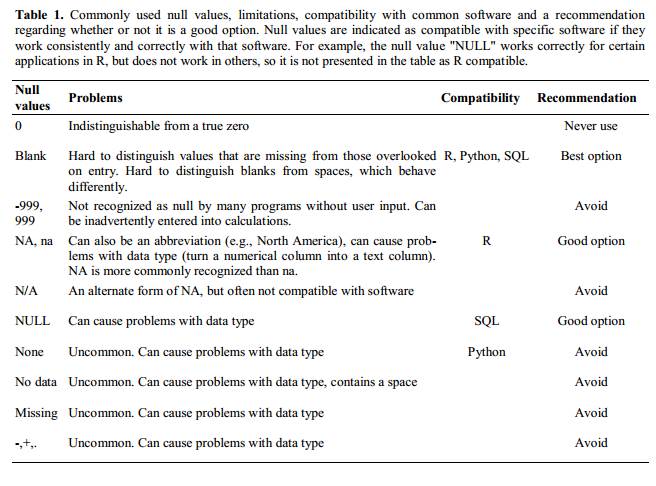
بہت سے شماریاتی پروگرامز یہ پہچاننے میں ناکام رہیں گے کہ ان کا مقصد غائب (null) ویلیوز کی نمائندگی کرنا ہے۔ ان ویلیوز کی تشریح اس سافٹ ویئر پر منحصر ہوگی جسے آپ اپنے ڈیٹا کے تجزیے کے لیے استعمال کرتے ہیں۔ ایک واضح طور پر متعین اور مستقل نل انڈیکیٹر کا استعمال کرنا ضروری ہے۔
خالی جگہیں (زیادہ تر ایپلی کیشنز) اور NA (R کے لیے) اچھے انتخاب ہیں۔ White et al. (2013) اپنے مضمون میں مختلف سافٹ ویئر ایپلی کیشنز کے لیے نل ویلیوز کی نشاندہی کے موزوں انتخاب کی وضاحت کرتے ہیں:
معلومات پہنچانے کے لیے فارمیٹنگ کا استعمال
مثال: ان سیلز، قطاروں یا کالموں کو نمایاں کرنا جنہیں تجزیے سے خارج کیا جانا چاہیے، اور ڈیٹا میں تقسیم کو ظاہر کرنے کے لیے خالی قطاریں چھوڑنا۔
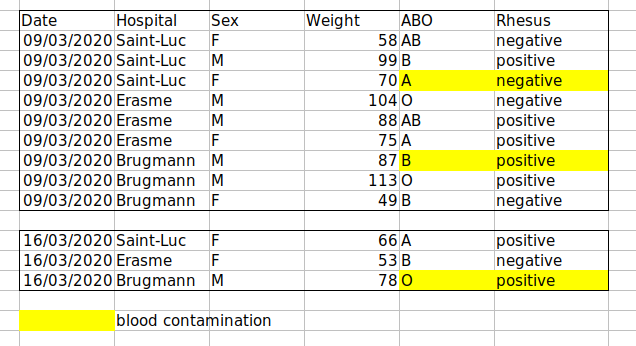
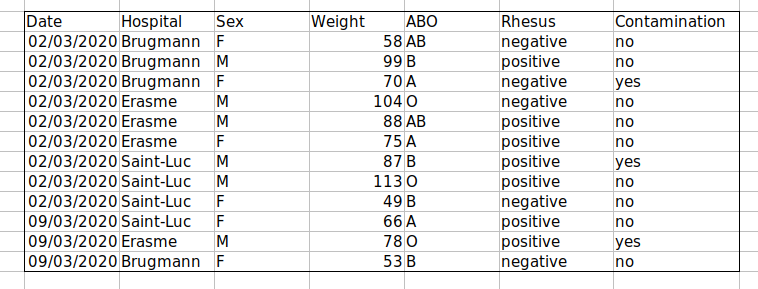
حل: ایک نیا فیلڈ بنائیں تاکہ یہ کوڈ کیا جا سکے کہ کون سا ڈیٹا خارج کیا جانا چاہیے۔
ڈیٹا شیٹ کو خوبصورت بنانے کے لیے فارمیٹنگ کا استعمال
مثال: سیلز کو یکجا کرنا۔
حل: اگر آپ احتیاط نہیں کریں گے، تو ورکشیٹ کو زیادہ خوبصورت بنانے کے لیے فارمیٹنگ کرنے سے آپ کے کمپیوٹر کی ڈیٹا میں تعلقات دیکھنے کی صلاحیت متاثر ہو سکتی ہے۔ مرجڈ سیلز آپ کے ڈیٹا کو شماریاتی سافٹ ویئر کے لیے ناقابلِ پڑھنے بنا دیں گے۔ اپنے ڈیٹا کی دوبارہ ترتیب پر غور کریں تاکہ ڈیٹا کو منظم کرنے کے لیے آپ کو سیلز مرج کرنے کی ضرورت نہ پڑے۔
سیلز میں تبصرے یا یونٹس شامل کرنا
زیادہ تر تجزیاتی سافٹ ویئر Excel یا LibreOffice کے کمنٹس کو نہیں پہچان سکتے، اور ڈیٹا کے سیلز میں رکھے گئے کمنٹس سے الجھ سکتے ہیں۔ فارمیٹنگ کے حوالے سے اوپر بیان کیے گئے طریقے کے مطابق، اگر آپ کو سیلز میں نوٹس شامل کرنے کی ضرورت ہو تو ایک الگ فیلڈ بنائیں۔ اسی طرح، سیلز میں یونٹس شامل نہ کریں: مثالی طور پر، ایک کالم میں رکھے گئے تمام پیمائشی اقدار ایک ہی یونٹ میں ہونی چاہئیں، لیکن اگر کسی وجہ سے وہ ایک ہی نہیں ہیں، تو ایک الگ فیلڈ بنائیں اور اس سیل کے یونٹ کی وضاحت کریں۔
ایک سیل میں ایک سے زیادہ معلومات درج کرنا
مثال: ایک ہی سیل میں ABO اور Rhesus گروپس کو درج کرنا، جیسے کہ A+، B+، A-، …
حل: ایک سیل میں ایک سے زیادہ معلومات شامل نہ کریں۔ ایک سیل میں معلومات کے کئی حصے رکھنے سے ڈیٹا کا تجزیہ کرنے کے طریقے محدود ہو جاتے ہیں۔ اگر آپ کو ان دونوں پیمائشوں کی ضرورت ہے، تو اپنی ڈیٹا شیٹ کو اس طرح ڈیزائن کریں کہ اس میں یہ معلومات شامل ہوں۔ مثال کے طور پر، ABO گروپ کے لیے ایک کالم اور Rhesus گروپ کے لیے ایک کالم شامل کریں۔
مسئلہ پیدا کرنے والے فیلڈ ناموں کا استعمال
فیلڈز کے لیے وضاحتی نام منتخب کریں، لیکن اس بات کا خیال رکھیں کہ ان میں کسی بھی قسم کے خالی جگہ، نمبر یا خصوصی حروف شامل نہ ہوں۔ خالی جگہوں کو ان پارسرز غلط سمجھ سکتے ہیں جو وائٹ اسپیس کو ڈیلیمیٹر کے طور پر استعمال کرتے ہیں، اور کچھ پروگرامز ایسے فیلڈ نام پسند نہیں کرتے جو نمبروں سے شروع ہونے والے ٹیکسٹ اسٹرنگز ہوں۔
انڈر اسکورز (_) سپیسز کا ایک اچھا متبادل ہیں۔ پڑھنے میں
آسانی کے لیے ناموں کو کیمل کیس (camel case) میں لکھنے پر غور کریں (جیسے
کہ: ExampleFileName)۔ یاد رکھیں کہ وہ مخففات جو اس وقت معنی رکھتے ہیں،
شاید 6 ماہ بعد اتنے واضح نہ رہیں، لیکن ناموں کو حد سے زیادہ طویل نہ
کریں۔ فیلڈ کے ناموں میں اکائیوں (units) کو شامل کرنے سے الجھن سے بچا جا
سکتا ہے اور دوسرے لوگ آپ کے فیلڈز کی آسانی سے تشریح کر سکتے ہیں۔
مثالیں
| اچھا نام | بہتر متبادل | سے گریز کریں |
|---|---|---|
| Max_temp_C | MaxTemp | Maximum Temp (°C) |
| Precipitation_mm | Precipitation | precmm |
| Mean_year_growth | MeanYearGrowth | Mean growth/year |
| sex | sex | M/F |
| weight | weight | w. |
| cell_type | CellType | Cell Type |
| Observation_01 | first_observation | 1st Obs |
ڈیٹا میں خصوصی حروف کا استعمال
مثال: آپ نوٹس لکھتے وقت اپنے اسپریڈشیٹ پروگرام کو ورڈ پروسیسر کے طور پر استعمال کرتے ہیں، مثال کے طور پر Word یا دیگر ایپلی کیشنز سے براہِ راست ڈیٹا کاپی کرتے ہیں۔
حل: یہ ایک عام طریقہ کار ہے۔ مثال کے طور پر، جب کسی سیل میں طویل متن لکھا جاتا ہے، تو لوگ اکثر اپنے اسپریڈشیٹ میں لائن بریکس، ایم-ڈیشز وغیرہ شامل کر دیتے ہیں۔ مزید برآں، Word جیسی ایپلی کیشنز سے ڈیٹا کاپی کرتے وقت، فارمیٹنگ اور غیر معیاری خصوصی حروف (جیسے بائیں اور دائیں جانب ترتیب دیے گئے کوٹیشن مارکس) شامل ہو جاتے ہیں۔ جب اس ڈیٹا کو کوڈنگ/سٹیٹسٹیکل ماحول یا ایک ریلیشنل ڈیٹا بیس میں ایکسپورٹ کیا جاتا ہے، تو خطوط کے آدھے ہونے اور انکوڈنگ کی غلطیوں کے پیدا ہونے جیسے خطرناک واقعات پیش آ سکتے ہیں۔
عمومی بہترین طریقہ کار یہ ہے کہ نیو لائنز، ٹیبز اور ورٹیکل ٹیبز جیسے حروف شامل کرنے سے گریز کیا جائے۔ دوسرے الفاظ میں، ایک ٹیکسٹ سیل کو اس طرح سمجھیں جیسے کہ وہ ایک سادہ ویب فارم ہو جو صرف ٹیکسٹ اور سپیسز کا حامل ہو سکے۔
ڈیٹا ٹیبل میں میٹا ڈیٹا کی شمولیت
مثال: آپ اپنے ڈیٹا ٹیبل کے اوپر یا نیچے ایک لیجنڈ شامل کرتے ہیں جس میں کالموں کے معنی، اکائیوں، استثنیٰ وغیرہ کی وضاحت کی جاتی ہے۔
حل: اپنے ڈیٹا کے بارے میں معلومات (“میٹا ڈیٹا”) درج کرنا ضروری ہے۔ ڈیٹا کو جمع کرنے اور اس کا تجزیہ کرنے کے دوران آپ اپنے ڈیٹا سیٹ سے مکمل طور پر واقف ہو سکتے ہیں، لیکن اس بات کا امکان کہ آپ چند مہینوں، ایک سال یا اس سے زیادہ عرصے بعد بھی یاد رکھیں گے کہ مثال کے طور پر، متغیر “sglmemgp” کا مطلب گروپ کا واحد رکن ہے، یا کسی متغیر کو تبدیل کرنے یا ایک مشتقہ متغیر بنانے کے لیے آپ نے جو درست الگورتھم استعمال کیا، اس کا امکان بہت کم ہے۔
مزید برآں، ایسی بہت سی وجوہات ہو سکتی ہیں جن کی بنا پر دوسرے لوگ آپ کے ڈیٹا کا جائزہ لینا یا اسے استعمال کرنا چاہیں گے—آپ کے نتائج کو سمجھنے، ان کی تصدیق کرنے، آپ کی جمع کرائی گئی اشاعت کا جائزہ لینے، آپ کے نتائج کو دوہرا کرنے، ایک ملتی جلتی تحقیق کا ڈیزائن تیار کرنے، یا یہاں تک کہ دوسروں کی رسائی اور دوبارہ استعمال کے لیے اپنے ڈیٹا کو آرکائیو کرنے کے لیے۔ اگرچہ ڈیجیٹل ڈیٹا تعریف کے مطابق مشین کے ذریعے پڑھے جا سکتے ہیں، لیکن ان کے معنی کو سمجھنا انسانوں کا کام ہے۔ آپ کی تحقیق کے اکٹھا کرنے اور تجزیے کے مرحلے کے دوران اپنے ڈیٹا کی دستاویز سازی کی اہمیت کو کبھی بھی کم نہیں سمجھا جا سکتا، خاص طور پر اگر آپ کی تحقیق علمی ریکارڈ کا حصہ بننے والی ہو۔
تاہم، میٹا ڈیٹا کو خود ڈیٹا فائل میں شامل نہیں کیا جانا چاہیے۔ ایک مقالے کے ٹیبل یا اضافی فائل کے برعکس، میٹا ڈیٹا (لیجنڈز کی شکل میں) کو ڈیٹا فائل میں شامل نہیں کیا جانا چاہیے کیونکہ یہ معلومات ڈیٹا نہیں ہیں، اور اسے شامل کرنے سے کمپیوٹر پروگراموں کے ذریعے آپ کی ڈیٹا فائل کی تشریح کے طریقے میں خلل پڑ سکتا ہے۔ اس کے بجائے، میٹا ڈیٹا کو آپ کی ڈیٹا فائل کے اسی ڈائریکٹری میں ایک علیحدہ فائل کے طور پر محفوظ کیا جانا چاہیے، ترجیحاً پلین ٹیکسٹ فارمیٹ میں ایک ایسے نام کے ساتھ جس سے اس کا تعلق آپ کی ڈیٹا فائل سے واضح طور پر ظاہر ہو۔ چونکہ میٹا ڈیٹا فائلیں فری ٹیکسٹ فارمیٹ میں ہوتی ہیں، اس لیے یہ آپ کو تبصرے، یونٹس، اور اس بارے میں معلومات کو انکوڈ کرنے کی اجازت بھی دیتی ہیں کہ نل ویلیوز کو کس طرح انکوڈ کیا جاتا ہے، وغیرہ، جو دستاویز کرنے کے لیے اہم ہوتے ہیں لیکن آپ کی ڈیٹا فائل کی فارمیٹنگ میں خلل پیدا کر سکتے ہیں۔
مزید برآں، فائل یا ڈیٹا بیس کی سطح کا میٹا ڈیٹا یہ بیان کرتا ہے کہ ڈیٹا سیٹ کو تشکیل دینے والی فائلیں ایک دوسرے سے کیسے جڑی ہوئی ہیں؛ وہ کس فارمیٹ میں ہیں؛ اور آیا وہ سابقہ فائلوں کی جگہ لیتی ہیں یا سابقہ فائلیں ان کی جگہ لیتی ہیں۔ فولڈر کی سطح کی readme.txt فائل کسی پروجیکٹ میں تمام فائلوں اور فولڈرز کا حساب رکھنے کا ایک روایتی طریقہ ہے۔
(میٹا ڈیٹا سے متعلق متن EDINA اور یونیورسٹی آف ایڈنبرہ کی ڈیٹا لائبریری کے آن لائن کورس Research Data MANTRA سے لیا گیا ہے۔ MANTRA کو Creative Commons Attribution 4.0 International License کے تحت لائسنس دیا گیا ہے۔)
ڈیٹا کی ایکسپورٹنگ
سوال
- ہم اسپریڈشیٹس سے ڈیٹا کو اس طرح ایکسپورٹ کیسے کر سکتے ہیں جو آنے والی ایپلی کیشنز کے لیے مفید ہو؟
اہداف
- اسپریڈشیٹ ڈیٹا کو یونیورسل فائل فارمیٹس میں محفوظ کریں۔
- اسپریڈشیٹ سے ڈیٹا کو CSV فائل میں ایکسپورٹ کریں۔
اہم نکات
عام اسپریڈشیٹ فارمیٹس میں محفوظ ڈیٹا اکثر ڈیٹا تجزیے کے سافٹ ویئر میں درست طریقے سے پڑھا نہیں جاتا، جس سے آپ کے ڈیٹا میں غلطیاں پیدا ہو جاتی ہیں۔
اسپریڈشیٹس سے ڈیٹا کو CSV یا TSV جیسے فارمیٹس میں ایکسپورٹ کرنے سے وہ ایک ایسے فارمیٹ میں آ جاتا ہے جسے زیادہ تر پروگرامز مستقل طور پر استعمال کر سکتے ہیں۔
اپنے تجزیوں کے لیے استعمال ہونے والے ڈیٹا کو ایکسل کے ڈیفالٹ فائل
فارمیٹ (*.xls یا *.xlsx - ایکسل کے ورژن کے
لحاظ سے) میں محفوظ کرنا ایک اچھا خیال نہیں ہے۔ کیوں؟
کیونکہ یہ ایک پراپرائٹری فارمیٹ ہے، اور یہ ممکن ہے کہ مستقبل میں فائل کھولنے کی ٹیکنالوجی موجود نہیں ہوگی (یا بہت نایاب ہو جائے گی) جس سے اسے کھولنا ناممکن یا کم از کم دشوار ہو جائے گا۔
دیگر اسپریڈشیٹ سافٹ ویئر شاید پراپرائٹری ایکسل فارمیٹ میں محفوظ فائلوں کو کھولنے کے قابل نہ ہوں۔
ایکسل کے مختلف ورژنز ڈیٹا کو مختلف طریقوں سے ہینڈل کر سکتے ہیں، جس سے تضادات پیدا ہو سکتے ہیں۔ Dates ڈیٹا اسٹوریج میں تضادات کی ایک اچھی طرح دستاویزی شکل ہے۔
آخر میں، زیادہ جریدے اور گرانٹ ایجنسیاں آپ سے اپنے ڈیٹا کو ایک ڈیٹا ریپوزٹری میں جمع کروانے کا مطالبہ کر رہی ہیں، اور ان میں سے زیادہ تر ایکسل فارمیٹ قبول نہیں کرتیں۔ اسے نیچے زیرِ بحث فارمیٹس میں سے کسی ایک میں ہونا ضروری ہے۔
مندرجہ بالا نکات دیگر فارمیٹس پر بھی لاگو ہوتے ہیں، جیسے کہ LibreOffice / Open Office کے استعمال کردہ اوپن ڈیٹا فارمیٹس۔ یہ فارمیٹس ساکن نہیں ہوتے اور مختلف سافٹ ویئر پیکیجز انہیں ایک ہی طریقے سے پارس نہیں کرتے۔
ڈیٹا کو ایک عالمگیر، کھلا اور ساکن فارمیٹ میں محفوظ کرنے سے اس مسئلے سے نمٹنے میں مدد ملے گی۔ ٹیب-ڈیلیمیٹڈ (tab separated values یا TSV) یا کوما-ڈیلیمیٹڈ (comma separated values یا CSV) فارمیٹ آزما کر دیکھیں۔ CSV فائلیں سادہ ٹیکسٹ فائلیں ہوتی ہیں جہاں کالموں کو کوموں سے الگ کیا جاتا ہے، اسی لیے انہیں ‘کوما سیپریٹڈ ویلیوز’ یا CSV کہا جاتا ہے۔ Excel/SPSS/وغیرہ کی فائلوں کے مقابلے میں CSV فائل کا فائدہ یہ ہے کہ ہم تقریباً کسی بھی سافٹ ویئر کے ذریعے CSV فائل کھول اور پڑھ سکتے ہیں، بشمول سادہ ٹیکسٹ ایڈیٹرز جیسے کہ TextEdit یا NotePad۔ CSV فائل میں موجود ڈیٹا کو دیگر فارمیٹس اور ماحولوں، جیسے کہ SQLite اور R میں بھی آسانی سے امپورٹ کیا جا سکتا ہے۔ جب ہم CSV فائلوں کے ساتھ کام کرتے ہیں تو ہم کسی مہنگے پروگرام کے کسی مخصوص ورژن سے جڑے نہیں ہوتے، اس لیے زیادہ سے زیادہ پورٹیبلٹی اور اینڈورنس کے لیے یہ ایک بہترین فارمیٹ ہے۔ زیادہ تر اسپریڈشیٹ پروگرامز CSV جیسے ڈیلیمیٹڈ ٹیکسٹ فارمیٹس میں آسانی سے محفوظ کر سکتے ہیں، اگرچہ فائل ایکسپورٹ کے دوران وہ آپ کو ایک وارننگ دے سکتے ہیں۔
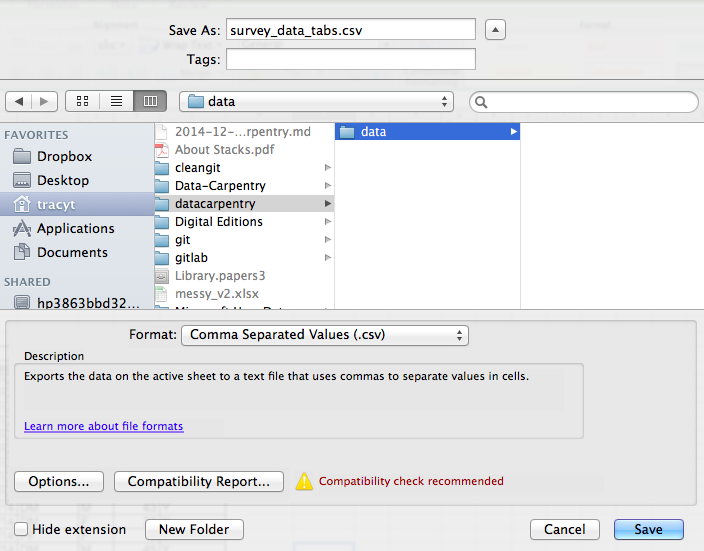
ایکسل میں کھولے ہوئے فائل کو CSV فارمیٹ میں محفوظ کرنے کے لیے:
- اوپر والے مینو سے ‘File’ اور ‘Save as’ منتخب کریں۔
- ‘Format’ فیلڈ میں، فہرست سے ‘Comma Separated Values’
(
*.csv) منتخب کریں۔ - فائل کے نام اور اس مقام کی دوبارہ تصدیق کریں جہاں آپ اسے محفوظ کرنا چاہتے ہیں اور ‘Save’ پر کلک کریں۔
بیک ورڈ کمپیٹیبلٹی کے لیے ایک اہم نوٹ: آپ CSV فائلوں کو Excel میں کھول سکتے ہیں!
R اور xls کے بارے میں ایک نوٹ: ایسے R
پیکیجز موجود ہیں جو xls فائلوں (نیز گوگل اسپریڈشیٹس) کو پڑھ
سکتے ہیں۔ یہاں تک کہ xls دستاویزات میں مختلف ورک شیٹس تک
رسائی حاصل کرنا بھی ممکن ہے۔
لیکن
- ان میں سے کچھ صرف ونڈوز پر کام کرتے ہیں۔
- اس کا مطلب
csvکے لیے ایک (سادہ مگر دستی) ایکسپورٹ کو ڈیٹا تجزیہ کے R کوڈ میں اضافی پیچیدگی/وابستگیوں سے تبدیل کرنا ہے۔ - ڈیٹا فارمیٹنگ کے بہترین طریقہ کار اب بھی لاگو ہوتے ہیں۔
- کیا واقعی کوئی ٹھوس وجہ ہے کہ
csv(یا اس جیسا کوئی اور) کافی نہیں ہے؟
کوموں کے حوالے سے احتیاطی تدابیر
کچھ ڈیٹا سیٹس میں، ڈیٹا کی اقدار میں خود کومے (,) شامل ہو سکتے ہیں۔ ایسی صورت میں، آپ کے استعمال کردہ سافٹ ویئر (بشمول Excel) غالباً ڈیٹا کو غلط طریقے سے کالموں میں ظاہر کرے گا۔ اس کی وجہ یہ ہے کہ ڈیٹا کی اقدار کا حصہ بننے والے کومے کو ڈیلیمیٹرز کے طور پر سمجھا جائے گا۔
مثال کے طور پر، ہمارا ڈیٹا کچھ اس طرح ہو سکتا ہے:
species_id,genus,species,taxa
AB,Amphispiza,bilineata,Bird
AH,Ammospermophilus,harrisi,Rodent, not censused
AS,Ammodramus,savannarum,Bird
BA,Baiomys,taylori,Rodent
ریکارڈ AH,Ammospermophilus,harrisi,Rodent, not censused
میں taxa کی ویلیو میں کوما
(Rodent, not censused) شامل ہے۔ اگر ہم مذکورہ بالا کو ایکسل
(یا کسی دوسرے اسپریڈشیٹ پروگرام) میں پڑھنے کی کوشش کریں گے، تو ہمیں کچھ
اس طرح کی چیز ملے گی:
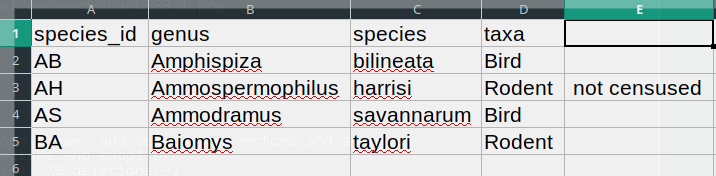
taxa کی ویلیو کو دو کالموں میں تقسیم کر دیا گیا (بجائے
اس کے کہ اسے ایک کالم D میں رکھا جائے)۔ یہ کئی مزید غلطیوں
کا سبب بن سکتا ہے۔ مثال کے طور پر، اس اضافی کالم کو ایسے کالم کے طور پر
سمجھا جائے گا جس میں بہت سی غیر موجود ویلیوز ہوں (اور جس میں کوئی مناسب
ہیڈر نہ ہو)۔ اس کے علاوہ، قطار 3 کے ریکارڈ کے لیے کالم D
میں موجود ویلیو (یعنی وہ ریکارڈ جہاں ‘taxa’ کی ویلیو میں کوما تھا) اب
غلط ہے۔
اگر آپ اپنا ڈیٹا csv فارمیٹ میں محفوظ کرنا چاہتے ہیں اور
یہ توقع رکھتے ہیں کہ آپ کے ڈیٹا کی اقدار میں کومے ہو سکتے ہیں، تو آپ
اقدار کو واوین (““) میں رکھ کر اوپر بحث کی گئی مسئلے سے بچ سکتے ہیں۔ اس
قاعدے کو لاگو کرتے ہوئے، ہمارا ڈیٹا کچھ اس طرح نظر آ سکتا ہے:
species_id,genus,species,taxa
"AB","Amphispiza","bilineata","Bird"
"AH","Ammospermophilus","harrisi","Rodent, not censused"
"AS","Ammodramus","savannarum","Bird"
"BA","Baiomys","taylori","Rodent"
اب اس فائل کو Excel میں csv کے طور پر کھولنے سے کوئی
اضافی کالم نہیں بنے گا، کیونکہ Excel صرف ان کوموں کو علامت کے طور پر
استعمال کرے گا جو کوٹیشن مارکس کے باہر ہوں گے۔
متبادل طور پر، اگر آپ ایسے ڈیٹا کے ساتھ کام کر رہے ہیں جس میں کومے شامل ہیں، تو اسپریڈشیٹ میں کام کرتے وقت آپ کو غالباً کسی دوسرے ڈیلیمیٹر کا استعمال کرنے کی ضرورت ہوگی1۔ اس صورت میں، اپنے ڈیلیمیٹر کے طور پر ٹیبز کے استعمال اور TSV فائلوں کے ساتھ کام کرنے پر غور کریں۔ TSV فائلوں کو اسپریڈشیٹ پروگراموں سے بالکل اسی طرح ایکسپورٹ کیا جا سکتا ہے جیسے CSV فائلوں کو کیا جاتا ہے۔
اگر آپ ایک پہلے سے موجود ڈیٹا سیٹ کے ساتھ کام کر رہے ہیں جس میں ڈیٹا کی اقدار “” میں شامل نہیں ہیں لیکن کومے ڈیلیمیٹرز اور ڈیٹا کی اقدار کے حصوں، دونوں کے طور پر استعمال ہو رہے ہیں، تو آپ ڈیٹا کی صفائی کے حوالے سے ایک بڑے مسئلے کا سامنا کر رہے ہوں گے۔ اگر جس ڈیٹا سیٹ کے ساتھ آپ کام کر رہے ہیں اس میں سینکڑوں یا ہزاروں ریکارڈز شامل ہیں، تو انہیں دستی طور پر صاف کرنے میں (یا تو ڈیٹا کی اقدار سے کومے ہٹانے کے ذریعے یا اقدار کو واوین میں رکھنے کے ذریعے - ““) نہ صرف گھنٹوں اور گھنٹے لگیں گے بلکہ اس کے نتیجے میں آپ غلطی سے بہت سی غلطیاں شامل کر سکتے ہیں۔
ڈیٹا سیٹس کی صفائی کرنا کئی سائنسی شعبوں میں بڑے مسائل میں سے ایک ہے۔ اس کا طریقہ کار تقریباً ہمیشہ مخصوص سیاق و سباق پر منحصر ہوتا ہے۔ تاہم، ڈیٹا کو خودکار طریقے سے صاف کرنا ایک بہتر طریقہ کار ہے، مثال کے طور پر ایک اسکرپٹ لکھ کر اور اسے چلا کر۔ پائتھن اور R کے اسباق آپ کو متعلقہ اسکرپٹس بنانے کی مہارتیں پیدا کرنے کے لیے بنیاد فراہم کریں گے۔
خلاصہ
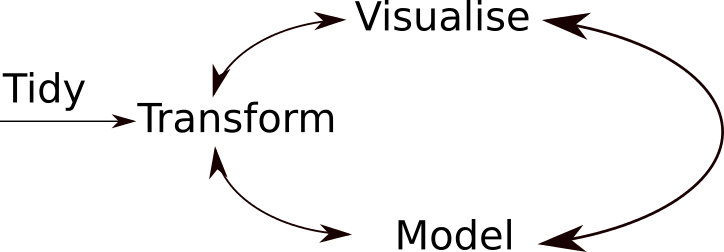
ڈیٹا تجزیے کا ایک معمول کا ورک فلو اعلیٰ شکل میں دکھایا گیا ہے، جہاں ڈیٹا کو بار بار تبدیل، بصری شکل دی اور ماڈل کیا جاتا ہے۔ یہ عمل کئی بار دہرایا جاتا ہے جب تک کہ ڈیٹا کو سمجھ نہ لیا جائے۔ تاہم، کئی حقیقی صورتحال میں، زیادہ تر وقت ڈیٹا کی تصفیہ اور تیاری میں صرف کیا جاتا ہے، بجائے اس کے کہ اس کا عملی طور پر تجزیہ اور سمجھ بوجھ کیا جائے۔
ڈیٹا کے تبدیلی/بصری شکل دینے/ماڈلنگ کے چکر کے کئی تیز رفتار تکرارات پر مبنی ایک چست ڈیٹا تجزیہ کا ورک فلو صرف اس صورت میں ممکن ہوتا ہے جب ڈیٹا ایک قابلِ پیش گوئی طریقے سے فارمیٹ کیا گیا ہو اور ڈیٹا کو دیکھنے اور/یا اسے درست کرنے کے بغیر اس کے بارے میں استدلال کیا جا سکے۔
- ڈیٹا کی بہترین تنظیم کسی بھی تحقیقی منصوبے کی بنیاد ہوتی ہے۔
یہ بات خاص طور پر ان یورپی ممالک میں اہم ہے جہاں کومہ کو اعشاری علامت کے طور پر استعمال کیا جاتا ہے۔ ایسی صورتوں میں، CSV فائل میں ڈیفالٹ ویلیو سیپریٹر سیمی کولن (;) ہوگا، یا ویلیوز کو منظم طریقے سے کوٹس میں رکھا جائے گا۔↩︎