
ڈیٹا کی بصری عکاسی
Last updated on 2026-11-11 | Edit this page
Overview
Questions
- R میں بصری نمائش
Objectives
- ggplot کا استعمال کرتے ہوئے اسکیٹر پلاٹس، باکس پلاٹس، لائن پلاٹس وغیرہ تیار کریں۔
- پلاٹ کی عمومی سیٹنگز مقرر کریں۔
- بتائیں کہ فیسیٹنگ کیا ہے اور ggplot میں فیسیٹنگ کا استعمال کریں۔
- ایک موجودہ ggplot پلوٹ کی جمالیاتی خصوصیات (بشمول محور کے لیبلز اور رنگ) میں ترمیم کریں۔
- ایک ڈیٹا فریم میں موجود ڈیٹا سے پیچیدہ اور کسٹمائزڈ پلوٹس تیار کریں۔
یہ ایپیسوڈ Data Carpentries کے Data Analysis and Visualisation in R for Ecologists اسباق پر مبنی ہے۔
ڈیٹا کی بصری عکاسی
ہم ضروری پیکجز کو لوڈ کرنے سے آغاز کرتے ہیں۔
ggplot2
tidyverse پیکج میں شامل ہے۔
R
library("tidyverse")
اگر یہ ابھی تک ورک اسپیس میں موجود نہیں ہے، تو پچھلے اسباق میں محفوظ کیے گئے ڈیٹا کو لوڈ کریں۔
R
rna <- read.csv("data/rnaseq.csv")
ڈیٹا
ویژولائزیشن چیٹ شیٹ میں ggplot2 کی بنیادی چیزوں اور
زیادہ جدید خصوصیات کا احاطہ کیا جائے گا، اور یہ ایک یاددہانی کے طور پر
کام کرنے کے ساتھ ساتھ پیکیج میں دستیاب ڈیٹا کی متعدد نمائندگیوں کا جائزہ
لینے میں بھی مددگار ثابت ہوگی۔ تھامس لن پیڈرسن کے درج ذیل ویڈیو
ٹیوٹوریلز (حصہ
1 اور حصہ
2) بھی انتہائی معلوماتی ہیں۔
ggplot2 کے ذریعے پلوٹنگ
ggplot2 ایک پلوٹنگ پیکیج ہے جو ڈیٹا فریم میں موجود ڈیٹا
سے پیچیدہ پلوٹس بنانا آسان بنا دیتا ہے۔ یہ ان متغیرات کی نشاندہی کرنے،
ان کے ظاہر ہونے کے طریقے اور عمومی بصری خصوصیات کے لیے ایک زیادہ
پروگرامی انٹرفیس فراہم کرتا ہے۔ ggplot2 کی حمایت کرنے والی
نظریاتی بنیاد Grammar of Graphics ( Wilkinson (2005) ) ہے۔ اس طریقہ کار کے ذریعے،
اگر بنیادی ڈیٹا تبدیل ہو جائے یا ہم بار پلوٹ سے اسکیٹر پلوٹ میں تبدیلی
کرنے کا فیصلہ کریں، تو ہمیں صرف معمولی تبدیلیوں کی ضرورت ہوتی ہے۔ یہ کم
سے کم ایڈجسٹمنٹس اور تھوڑی سی تبدیلیوں کے ساتھ اشاعتی معیار کے پلوٹس
بنانے میں مدد دیتا ہے۔
ggplot2 ( Wickham (2016) )
کے بارے میں ایک کتاب موجود ہے جو ایک اچھا جائزہ فراہم کرتی ہے، لیکن وہ
پرانی ہو چکی ہے۔ تیسری ایڈیشن تیار کی جا رہی ہے اور یہ آن لائن مفت دستیاب ہوگی۔
ggplot2 کا ویب پیج (https://ggplot2.tidyverse.org)
کافی دستاویزات فراہم کرتا ہے۔
ggplot2 کے فنکشنز ‘لانگ’ فارمیٹ والے ڈیٹا کے ساتھ بہتر
کام کرتے ہیں، یعنی ہر ڈائمنشن کے لیے ایک کالم اور ہر مشاہدے کے لیے ایک
قطار۔ منظم ڈیٹا ggplot2 کے ذریعے فیگرز تیار کرتے وقت آپ کا
بہت سارا وقت بچائے گا۔
ggplot گرافکس نئے عناصر شامل کرتے ہوئے مرحلہ وار تیار کیے جاتے ہیں۔ اس طریقے سے لیئرز شامل کرنے سے پلوٹس میں وسیع لچک اور کسٹمائزیشن کی سہولت ملتی ہے۔
گرافکس کے گرامر کے پیچھے موجود خیال یہ ہے کہ آپ ہر گراف کو انہی 3 اجزاء سے بنا سکتے ہیں: (1) ایک ڈیٹا سیٹ، (2) ایک کوآرڈینیٹ سسٹم، اور (3) جیومز — یعنی ویژول مارکس جو ڈیٹا پوائنٹس کی نمائندگی کرتے ہیں 1
ggplot بنانے کے لیے، ہم درج ذیل بنیادی ٹیمپلیٹ استعمال کریں گے جسے مختلف اقسام کے پلوٹس کے لیے استعمال کیا جا سکتا ہے:
ggplot(data = <DATA>, mapping = aes(<MAPPINGS>)) + <GEOM_FUNCTION>()-
ggplot()فنکشن استعمال کریں اورdataآرگومنٹ کے ذریعے پلوٹ کو ایک مخصوص ڈیٹا فریم سے منسلک کریں۔
R
ggplot(data = rna)
- ایک میپنگ (aesthetic (
aes) فانکشن کا استعمال کرتے ہوئے) متعین کریں، جس میں پلوٹ کیے جانے والے ویری ایبلز کا انتخاب کیا جائے اور یہ تفصیل دی جائے کہ انہیں گراف میں کیسے پیش کیا جائے، مثلاً x/y پوزیشنز کے طور پر یا سائز، شکل، رنگ وغیرہ جیسی خصوصیات کے طور پر۔
R
ggplot(data = rna, mapping = aes(x = expression))
-
‘geoms’ شامل کریں - جیومیٹریز، یا پلاٹ میں ڈیٹا کی گرافیکل نمائندگیاں (پوائنٹس، لائنیں، بارز)۔
ggplot2بہت سے مختلف geoms فراہم کرتا ہے؛ ہم آج کچھ عام استعمال ہونے والے geoms استعمال کریں گے، جن میں شامل ہیں:* `geom_point()` for scatter plots, dot plots, etc. * `geom_histogram()` for histograms * `geom_boxplot()` for, well, boxplots! * `geom_line()` for trend lines, time series, etc.
پلاٹ میں جیومیٹری (geometry) شامل کرنے کے لیے + آپریٹر
استعمال کریں۔ آئیے پہلے geom_histogram() استعمال کرتے
ہیں:
R
ggplot(data = rna, mapping = aes(x = expression)) +
  geom_histogram()
OUTPUT
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.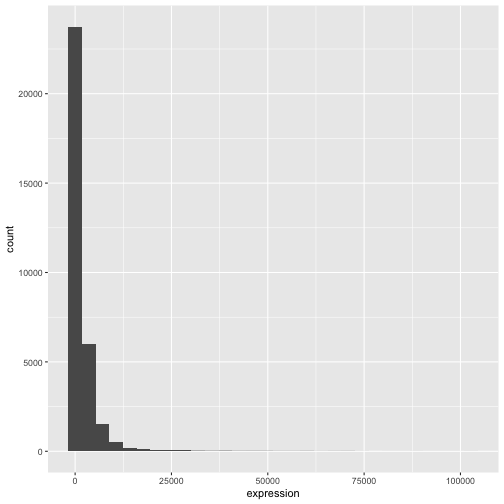
ggplot2 پیکج میں موجود + خاص طور پر مفید ہے
کیونکہ یہ آپ کو موجودہ ggplot آبجیکٹس میں تبدیلی کرنے کی
اجازت دیتا ہے۔ اس کا مطلب ہے کہ آپ آسانی سے پلوٹ ٹیمپلیٹس تیار کر سکتے
ہیں اور مختلف اقسام کے پلوٹس کو آسانی سے کھوج سکتے ہیں، لہذا مذکورہ بالا
پلوٹ کو اس طرح کے کوڈ کے ذریعے بھی تیار کیا جا سکتا ہے:
R
# Assign plot to a variable
rna_plot <- ggplot(data = rna,
                   mapping = aes(x = expression))

# Draw the plot
rna_plot + geom_histogram()
چیلنج
آپ نے غالباً ایک خودکار پیغام دیکھا ہوگا جو ہسٹوگرام بناتے وقت ظاہر ہوتا ہے:
OUTPUT
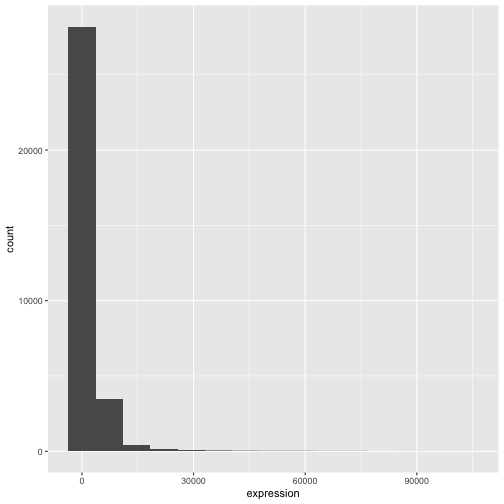
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.بائنز کی تعداد یا چوڑائی تبدیل کرنے کے لیے
geom_histogram() کے آرگیومنٹس bins یا
binwidth کو تبدیل کریں۔
R
# change bins
ggplot(rna, aes(x = expression)) +
    geom_histogram(bins = 15)
R
# change binwidth
ggplot(rna, aes(x = expression)) +
    geom_histogram(binwidth = 2000)
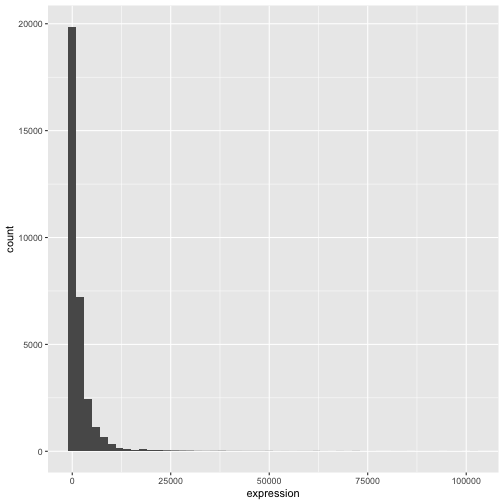
ہم یہاں دیکھ سکتے ہیں کہ ڈیٹا دائیں جانب جھکا ہوا ہے۔ ہم زیادہ متماثل
تقسیم حاصل کرنے کے لیے اساس 2 کی لوگارتھمی تبدیلی لاگو کر سکتے ہیں۔ نوٹ
کریں کہ ہم یہاں ایک چھوٹی مستقل ویلیو (+1) شامل کر رہے ہیں
تاکہ 0 کے برابر اظہار کی ویلیوز کے لیے -Inf ویلیوز واپس نہ
آئیں۔
R
rna <- rna |>
  mutate(expression_log = log2(expression + 1))
اگر ہم اب اساس 2 کی لوگارتھمی تبدیلی کے بعد اظہارات کا ہسٹوگرام بنائیں، تو تقسیم واقعی نارمل تقسیم کے زیادہ قریب ہو جاتی ہے۔
R
ggplot(rna, aes(x = expression_log)) + geom_histogram()
OUTPUT
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.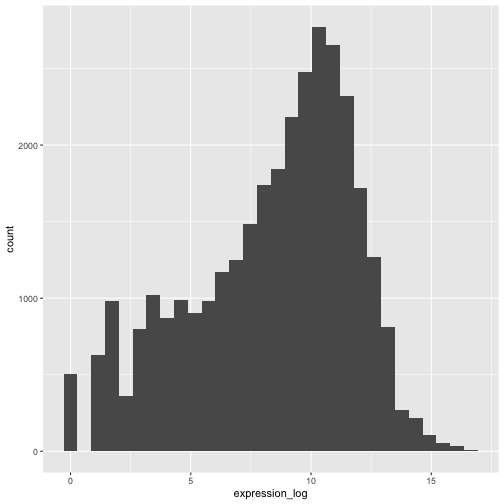
اب سے ہم اساس 2 کی لوگارتھمی تبدیلی شدہ اظہار کی اقدار پر کام کریں گے۔
چیلنج
اس تبدیلی کو بصری شکل میں پیش کرنے کا ایک اور طریقہ یہ ہے کہ مشاہدات کے پیمانے پر غور کیا جائے۔ مثال کے طور پر، پلوٹ کی جگہ میں مشاہدات کی بہتر تقسیم کے لیے محور کے پیمانے کو تبدیل کرنا فائدہ مند ہو سکتا ہے۔ محوروں کے پیمانے کو تبدیل کرنے کا طریقہ دیگر اجزاء کو شامل کرنے یا ترمیم کرنے کے مشابہ ہے (یعنی، کمانڈز کو بتدریج شامل کر کے)۔ اس ترمیم کو کرنے کی کوشش کریں:
- غیر تبدیل شدہ اظہار کو log10 سکیل پر ظاہر کریں؛
scale_x_log10()دیکھیں۔ اس کا موازنہ پچھلے گراف سے کریں۔ اب احتیاطی پیغامات کیوں ظاہر ہو رہے ہیں؟
R
ggplot(data = rna,mapping = aes(x = expression))+
  geom_histogram() +
  scale_x_log10()
WARNING
Warning in scale_x_log10(): log-10 transformation introduced infinite values.OUTPUT
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.WARNING
Warning: Removed 507 rows containing non-finite outside the scale range
(`stat_bin()`).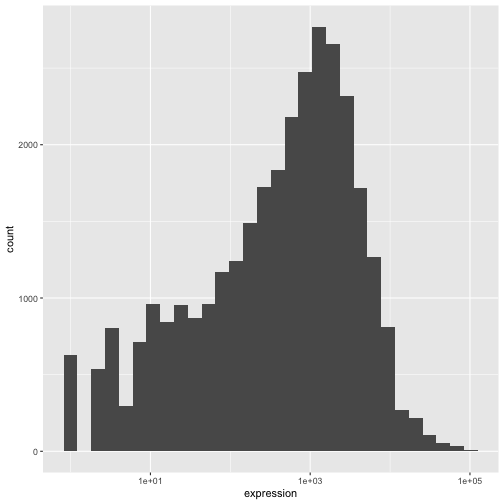
نوٹس
-
ggplot()فنکشن میں آپ جو کچھ بھی لکھتے ہیں، اسے آپ کے شامل کردہ کسی بھی geom لیئرز دیکھ سکتے ہیں (یعنی، یہ پلوٹ کی گلوبل سیٹنگز ہیں)۔ اس میں وہ x- اور y-ایکسیس میپنگ بھی شامل ہے جو آپ نےaes()میں سیٹ کی ہے۔ - آپ
ggplot()فنکشن میں عالمی طور پر متعین کردہ میپنگز سے آزادانہ طور پر کسی مخصوص geom کے لیے میپنگز بھی متعین کر سکتے ہیں۔ - نئی لیئرز شامل کرنے کے لیے استعمال ہونے والے
+علامت کو اس لائن کے آخر میں رکھنا ہوگا جس میں پچھلا لیئر موجود ہو۔ اگر اس کے بجائے،+علامت کو نئے لیئر والی لائن کے آغاز میں شامل کیا جائے، توggplot2نیا لیئر شامل نہیں کرے گا اور ایک ایرر میسج واپس کرے گا۔
R
# This is the correct syntax for adding layers
rna_plot +
  geom_histogram()

# This will not add the new layer and will return an error message
rna_plot
  + geom_histogram()
اپنے پلوٹس کو تکراری طور پر تیار کرنا
اب ہم دو مسلسل متغیرات اور geom_point() فنکشن کا استعمال
کرتے ہوئے ایک اسکیٹر پلاٹ بنائیں گے۔ یہ گراف وقت 0 کے مقابلے میں وقت 8،
اور وقت 0 کے مقابلے میں وقت 4 پر اظہار کی log2 فولڈ چینجز کی نمائندگی
کرے گا۔ اس مقصد کے لیے، ہمیں پہلے ہر جین اور وقت کے لحاظ سے لوگارتھمی
تبدیلی شدہ اظہار کی اقدار کی اوسط کا حساب لگانا ہوگا۔ پھر وقت 8 کی اوسط
سے وقت 0 کی اوسط، اور وقت 4 کی اوسط سے وقت 0 کی اوسط منہا کر کے
لوگارتھمی فولڈ چینجز کا حساب لگائیں گے۔ نوٹ کریں کہ ہم یہاں جین
بائیوٹائپ بھی شامل کر رہے ہیں جسے ہم بعد میں جینز کی نمائندگی کے لیے
استعمال کریں گے۔ ہم فولڈ چینجز کو ایک نئے ڈیٹا فریم میں محفوظ کریں گے
جسے rna_fc. کہا جائے گا۔
R
rna_fc <- rna |> select(gene, time,
                         gene_biotype, expression_log) |>
  group_by(gene, time, gene_biotype) |>
  summarize(mean_exp = mean(expression_log)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  mutate(time_8_vs_0 = `8` - `0`, time_4_vs_0 = `4` - `0`)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, time, and gene_biotype.
ℹ Output is grouped by gene and time.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time, gene_biotype))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
اس کے بعد ہم نئے بنائے گئے ڈیٹا سیٹ rna_fc کے ساتھ ایک
ggplot تیار کر سکتے ہیں۔ ggplot2 کے ذریعے پلوٹس بنانا عام
طور پر ایک تکراری عمل ہوتا ہے۔ ہم اس ڈیٹا سیٹ کی تعریف کر کے آغاز کرتے
ہیں جسے ہم استعمال کریں گے، محوروں کی ترتیب کرتے ہیں، اور ایک geom کا
انتخاب کرتے ہیں:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_point()
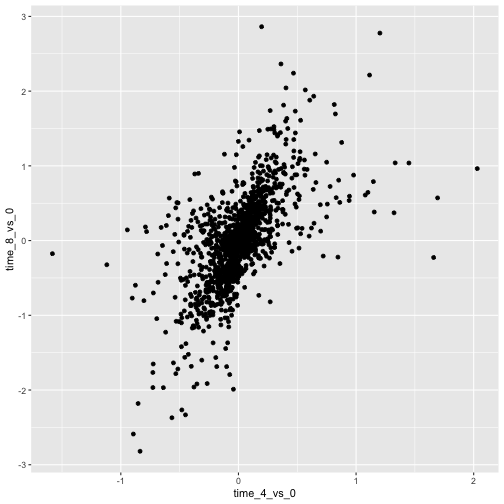
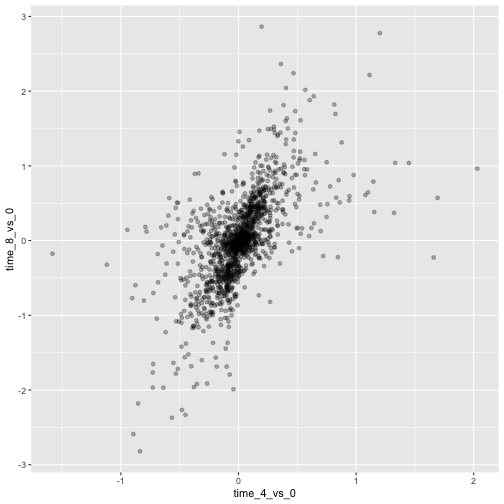
پھر، ہم اس پلاٹ میں ترمیم کرنا شروع کرتے ہیں تاکہ اس سے مزید معلومات
نکال سکیں۔ مثال کے طور پر، ہم اوور پلوٹنگ سے بچنے کے لیے شفافیت
(alpha) شامل کر سکتے ہیں:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_point(alpha = 0.3)
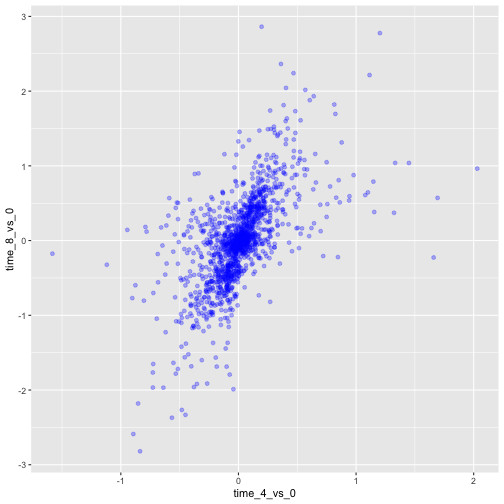
ہم تمام پوائنٹس کے لیے رنگ بھی شامل کر سکتے ہیں:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_point(alpha = 0.3, color = "blue")
یا پلاٹ میں ہر جین کو الگ الگ رنگ دینے کے لیے، آپ
color آرگومنٹ کے ان پٹ کے طور پر ایک ویکٹر استعمال کر
سکتے ہیں۔ ggplot2 ویکٹر کی مختلف اقدار کے مطابق مختلف رنگ
فراہم کرے گا۔ یہاں ایک مثال ہے جہاں ہم gene_biotype کے
ذریعے رنگ دیتے ہیں:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_point(alpha = 0.3, aes(color = gene_biotype))
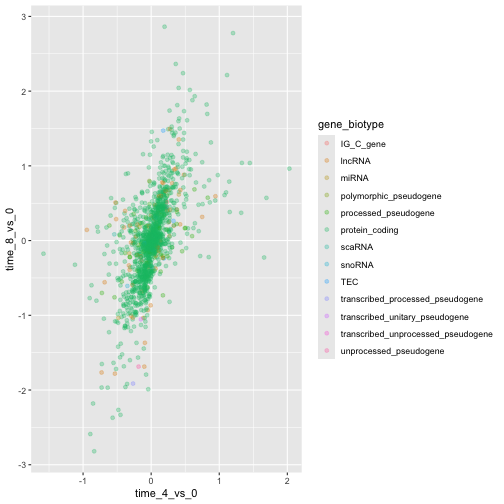
ہم ggplot() فنکشن میں فراہم کردہ میپنگ کے اندر براہِ راست
رنگ بھی متعین کر سکتے ہیں۔ یہ کسی بھی geom لیئرز کے لیے دیکھا جائے گا
اور میپنگ کا تعین aes() میں سیٹ کیے گئے x- اور y-ایکسز سے
ہوگا۔
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0,
                                color = gene_biotype)) +
  geom_point(alpha = 0.3)
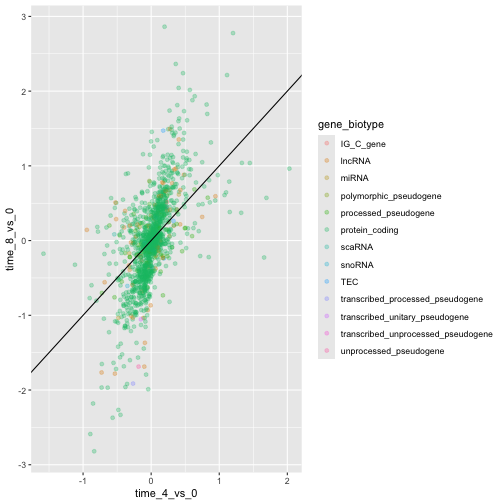
آخر میں، ہم geom_abline() فنکشن کے ذریعے ایک ترچھی لکیر
بھی شامل کر سکتے ہیں:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0,
                                color = gene_biotype)) +
  geom_point(alpha = 0.3) +
  geom_abline(intercept = 0)
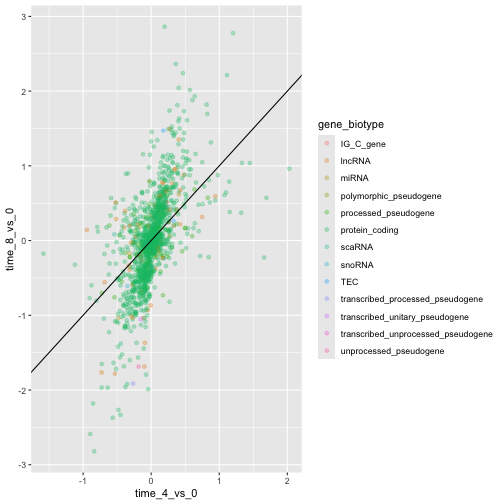
نوٹ کریں کہ ہم geom لیئر کو geom_point سے بدل کر
geom_jitter کر سکتے ہیں اور رنگ اب بھی
gene_biotype کے ذریعے طے ہوں گے۔
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0,
                                color = gene_biotype)) +
  geom_jitter(alpha = 0.3) +
  geom_abline(intercept = 0)
چیلنج
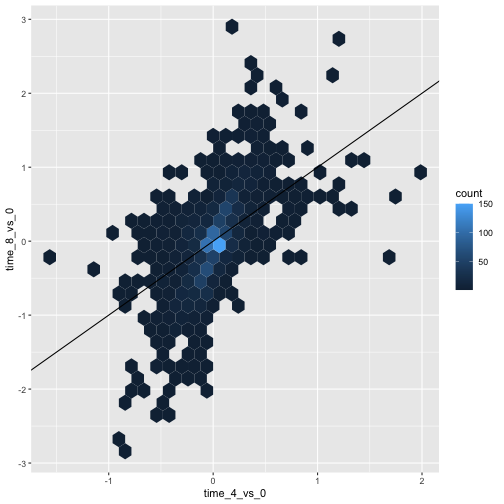
اسکیٹر پلوٹس (Scatter plots) چھوٹے ڈیٹا سیٹس کے لیے مفید ایکسپلوریٹری
ٹولز ہو سکتے ہیں۔ بڑی تعداد میں آبزرویشنز والے ڈیٹا سیٹس، جیسے کہ
rna_fc ڈیٹا سیٹ، میں پوائنٹس کی اوور پلوٹنگ (overplotting)
اسکیٹر پلوٹس کی ایک محدودیت ہو سکتی ہے۔ ایسی صورتحال سے نمٹنے کی ایک
حکمتِ عملی آبزرویشنز کی ہیکساگونل بننگ (hexagonal binning) کا استعمال
کرنا ہے۔ پلوٹ اسپیس کو ہیکساگونز میں تقسیم کیا جاتا ہے۔ ہر ہیکساگون کو
اس کی حدود کے اندر آنے والے آبزرویشنز کی تعداد کی بنیاد پر ایک رنگ تفویض
کیا جاتا ہے۔
ggplot2میں ہیکساگونل بننگ استعمال کرنے کے لیے، پہلے CRAN سے R پیکیجhexbinانسٹال کریں اور اسے لوڈ کریں۔پھر ہیکسبن (hexbin) تصویر تیار کرنے کے لیے
geom_hex()فنکشن کا استعمال کریں۔ایک اسکیٹر پلاٹ کے مقابلے میں ہیکساگونل بائن پلاٹ کی نسبتی خوبیاں اور خامیاں کیا ہیں؟ اوپر دیے گئے اسکیٹر پلاٹ کا جائزہ لیں اور اس کا موازنہ اس ہیکساگونل بائن پلاٹ سے کریں جو آپ نے تیار کیا ہے۔
R
install.packages("hexbin")
R
library("hexbin")

ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
  geom_hex() +
  geom_abline(intercept = 0)
چیلنج
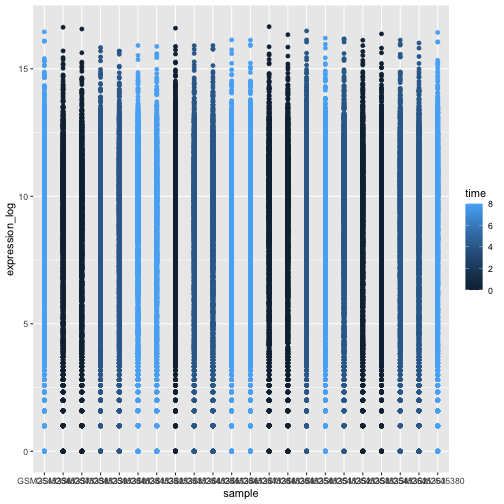
ابھی سیکھی گئی باتوں کا استعمال کرتے ہوئے rna ڈیٹا سیٹ
سے expression_log کا sample پر ایک اسکیٹر پلاٹ
(scatter plot) بنائیں، جس میں وقت کو مختلف رنگوں میں دکھایا جائے۔ کیا اس
قسم کے ڈیٹا کو دکھانے کا یہ ایک اچھا طریقہ ہے؟
R
ggplot(data = rna, mapping = aes(y = expression_log, x = sample)) +
    geom_point(aes(color = time))
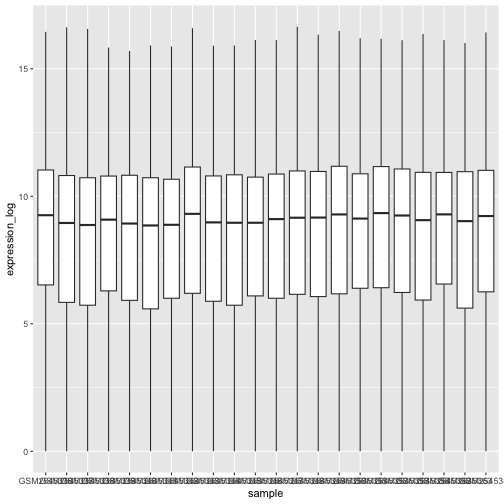
باکس پلوٹ
ہم ہر نمونے میں جین کے اظہار کی تقسیم کو بصری شکل میں دیکھنے کے لیے باکس پلوٹس کا استعمال کر سکتے ہیں:
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_boxplot()
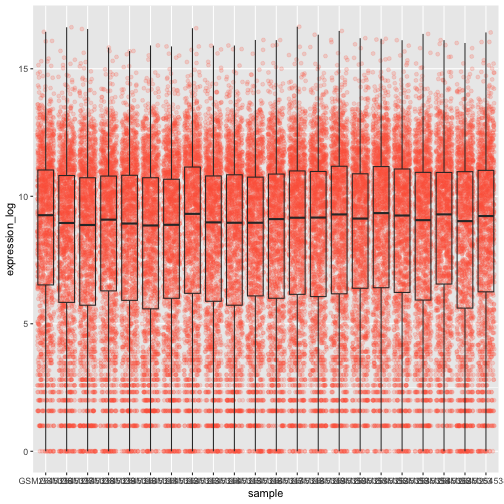
باکس پلوٹ میں پوائنٹس شامل کر کے، ہم پیمائشوں کی تعداد اور ان کی تقسیم کے بارے میں بہتر اندازہ لگا سکتے ہیں:
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_jitter(alpha = 0.2, color = "tomato") +
  geom_boxplot(alpha = 0)
چیلنج
غور کریں کہ باکس پلاٹ (boxplot) لیئر جٹر (jitter) لیئر سے آگے کیوں ہے؟ باکس پلاٹ کو پوائنٹس کے نیچے رکھنے کے لیے آپ کو کوڈ میں کیا تبدیلی کرنے کی ضرورت ہے؟
ہمیں ان دو geoms کی ترتیب بدلنی چاہیے:
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_boxplot(alpha = 0) +
  geom_jitter(alpha = 0.2, color = "tomato")
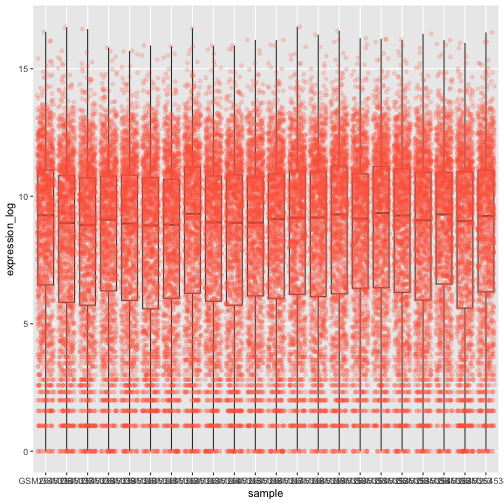
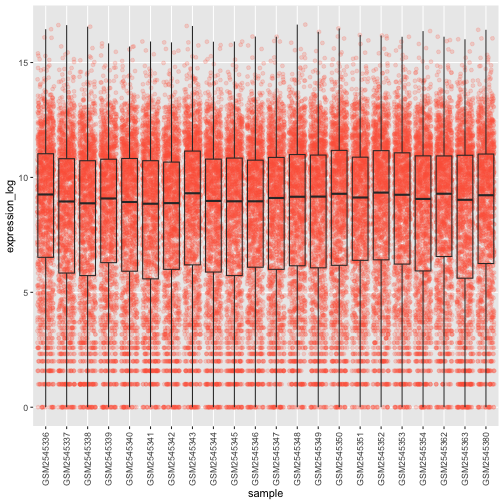
آپ نے غور کیا ہوگا کہ x-axis پر موجود اقدار اب بھی مناسب طریقے سے پڑھی نہیں جا رہیں۔ آئیے لیبلز کی سمت بدلیں اور انہیں عمودی اور افقی طور پر ایڈجسٹ کریں تاکہ وہ ایک دوسرے کے اوپر نہ آ جائیں۔ آپ 90 ڈگری کا زاویہ استعمال کر سکتے ہیں، یا ترچھی سمت میں موجود لیبلز کے لیے مناسب زاویہ تلاش کرنے کے لیے تجربات کر سکتے ہیں:
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_jitter(alpha = 0.2, color = "tomato") +
  geom_boxplot(alpha = 0) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
چیلنج
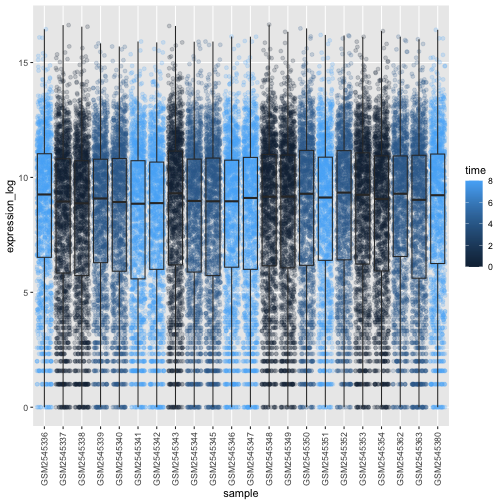
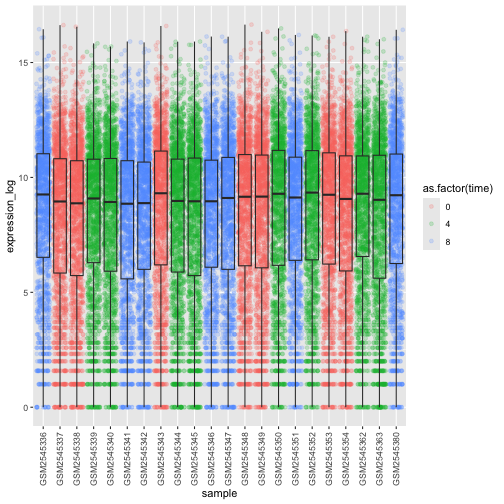
اپنے باکس پلوٹ پر ڈیٹا پوائنٹس کو انفیکشن کی مدت (time)
کے مطابق رنگ شامل کریں۔
اشارہ: time کی کلاس چیک کریں۔ ggplot میپنگ میں
براہِ راست time کی کلاس کو integer سے بدل کر factor کرنے پر
غور کریں۔ یہ تبدیلی R کے گراف بنانے کے طریقے کو کیوں بدل دیتی ہے؟
R
# time as integer
ggplot(data = rna,
         mapping = aes(y = expression_log,
                       x = sample)) +
  geom_jitter(alpha = 0.2, aes(color = time)) +
  geom_boxplot(alpha = 0) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
R
# time as factor
ggplot(data = rna,
         mapping = aes(y = expression_log,
                       x = sample)) +
  geom_jitter(alpha = 0.2, aes(color = as.factor(time))) +
  geom_boxplot(alpha = 0) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
چیلنج
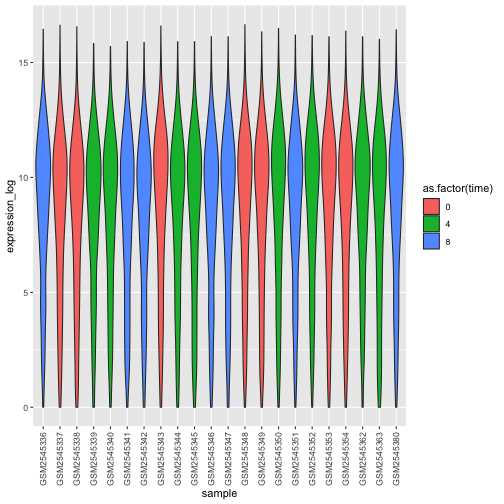
باکس پلوٹس (Boxplots) مفید خلاصے ہوتے ہیں، لیکن وہ تقسیم (distribution) کی شکل کو چھپا دیتے ہیں۔ مثال کے طور پر، اگر تقسیم بائی موڈل (bimodal) ہو، تو ہم اسے باکس پلوٹ میں نہیں دیکھ پائیں گے۔ باکس پلوٹ کا ایک متبادل وائلن پلوٹ (violin plot) ہے، جس میں شکل (پوائنٹس کی کثافت کی) کو دکھایا جاتا ہے۔
- باکس پلوٹ کو وائلن پلوٹ سے تبدیل کریں؛
geom_violin()دیکھیں۔ آرگیومنٹfillکے ذریعے وقت کے مطابق وائلنز کو بھریں۔
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_violin(aes(fill = as.factor(time))) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
چیلنج
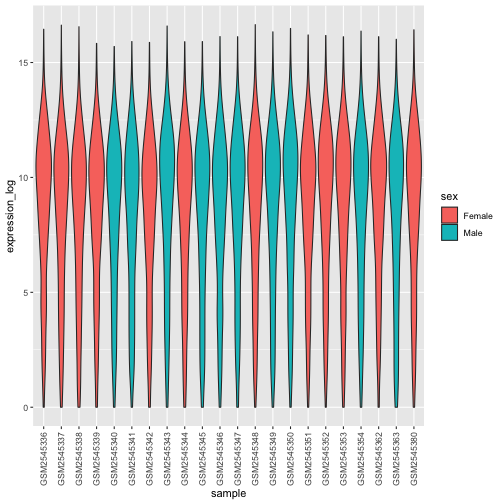
- وائلن پلاٹ کو اس طرح تبدیل کریں کہ
sexکے مطابق وائلنز بھر دیے جائیں۔
R
ggplot(data = rna,
         mapping = aes(y = expression_log, x = sample)) +
  geom_violin(aes(fill = sex)) +
  theme(axis.text.x = element_text(angle = 90,  hjust = 0.5, vjust = 0.5))
لائن پلوٹس
آئیے ٹائم 8 اور ٹائم 0 کے موازنے میں سب سے زیادہ لوگ فولڈ چینجز رکھنے
والے 10 جینز کے لیے انفیکشن کی مدت کے لحاظ سے اوسط اظہار کا حساب لگائیں۔
سب سے پہلے، ہمیں جینز کا انتخاب کرنا ہوگا اور rna کا ایک سب
سیٹ sub_rna بنانا ہوگا جس میں منتخب کردہ 10 جینز شامل ہوں،
پھر ہمیں ڈیٹا کو گروپ کرنا ہوگا اور ہر گروپ کے اندر جین کے اوسط اظہار کا
حساب لگانا ہوگا:
R
rna_fc <- rna_fc |> arrange(desc(time_8_vs_0))

genes_selected <- rna_fc$gene[1:10]

sub_rna <- rna |>
    filter(gene %in% genes_selected)

mean_exp_by_time <- sub_rna |>
  group_by(gene,time) |>
    summarize(mean_exp = mean(expression_log))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
mean_exp_by_time
OUTPUT
# A tibble: 30 × 3
# Groups:   gene [10]
   gene   time mean_exp
   <chr> <int>    <dbl>
 1 Acr       0     5.07
 2 Acr       4     5.54
 3 Acr       8     7.31
 4 Aipl1     0     3.70
 5 Aipl1     4     3.89
 6 Aipl1     8     6.56
 7 Bst1      0     3.20
 8 Bst1      4     3.77
 9 Bst1      8     5.22
10 Chil3     0     4.00
# ℹ 20 more rows
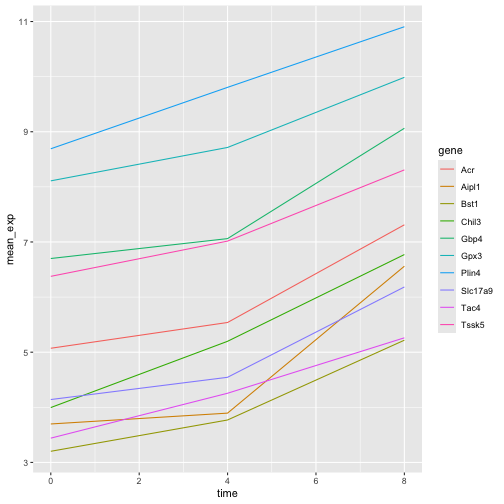
ہم انفیکشن کی مدت کو x-axis پر اور اوسط اظہار کو y-axis پر رکھ کر لائن پلاٹ تیار کر سکتے ہیں:
R
ggplot(data = mean_exp_by_time, mapping = aes(x = time, y = mean_exp)) +
  geom_line()
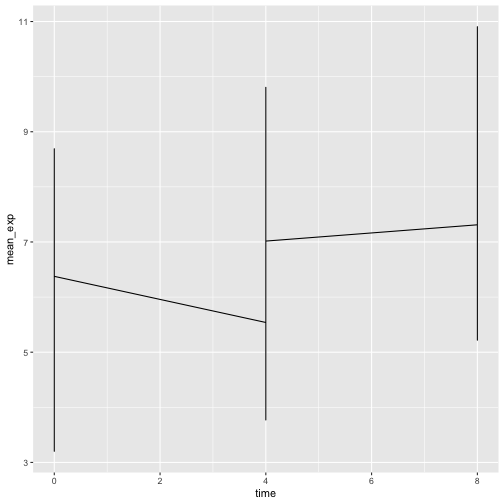
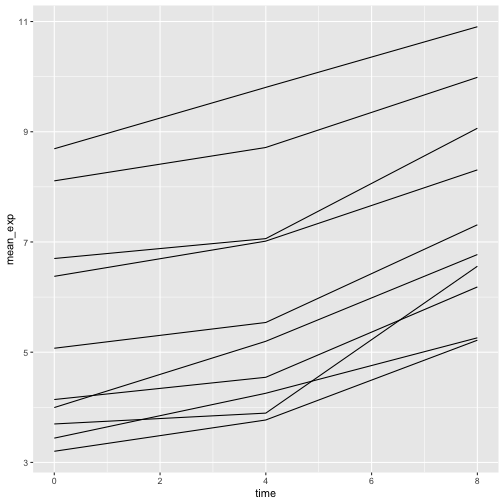
بدقسمتی سے، یہ کام نہیں کرتا کیونکہ ہم نے تمام جینز کے ڈیٹا کو ایک
ساتھ پلوٹ کیا ہے۔ ہمیں ggplot کو یہ بتانا ہوگا کہ وہ ہر جین کے لیے ایک
لائن کھینچے، جس کے لیے ہمیں ایسٹھیٹک فنکشن میں group = gene
شامل کر کے اسے تبدیل کرنا ہوگا:
R
ggplot(data = mean_exp_by_time,
       mapping = aes(x = time, y = mean_exp, group = gene)) +
  geom_line()
ہم پلاٹ میں جینز کے درمیان فرق کر سکیں گے اگر ہم رنگ شامل کریں
(color کا استعمال ڈیٹا کو خود بخود گروپ بھی کر دیتا
ہے):
R
ggplot(data = mean_exp_by_time,
       mapping = aes(x = time, y = mean_exp, color = gene)) +
  geom_line()
فیسیٹنگ
ggplot2 میں ایک خاص تکنیک ہے جسے faceting کہا
جاتا ہے، جو صارف کو ڈیٹا سیٹ میں شامل ایک فیکٹر کی بنیاد پر ایک پلاٹ کو
متعدد (ذیلی) پلاٹس میں تقسیم کرنے کی سہولت دیتی ہے۔ یہ مختلف ذیلی پلاٹس
ایک جیسی خصوصیات (ایکسز کی حدود، ٹکس، …) ورثے میں حاصل کرتے ہیں تاکہ ان
کا براہِ راست موازنہ آسان ہو سکے۔ ہم اسے ہر جین کے لیے وقت کے ساتھ ایک
لائن پلاٹ بنانے کے لیے استعمال کریں گے:
R
ggplot(data = mean_exp_by_time,
       mapping = aes(x = time, y = mean_exp)) + geom_line() +
  facet_wrap(~ gene)
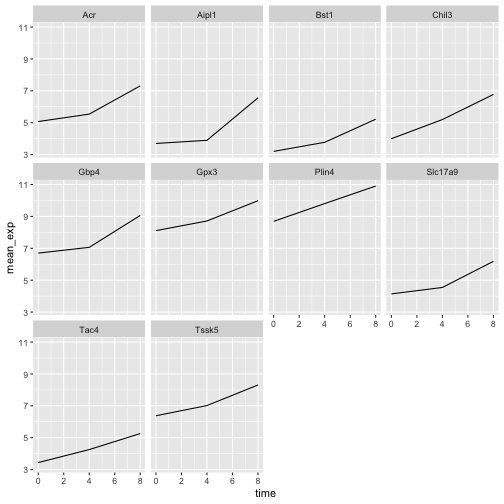
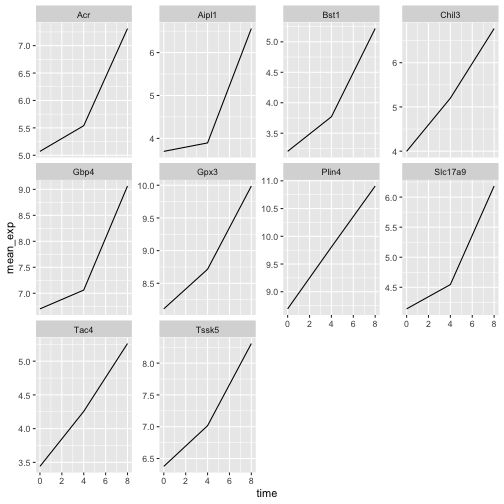
یہاں تمام سب پلوٹس کے لیے x اور y دونوں محورات کا پیمانہ ایک جیسا ہے۔
آپ scales میں تبدیلی کر کے اس ڈیفالٹ رویے کو بدل سکتے ہیں
تاکہ y-محور کے لیے ایک آزاد پیمانہ کی اجازت مل سکے:
R
ggplot(data = mean_exp_by_time,
       mapping = aes(x = time, y = mean_exp)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y")
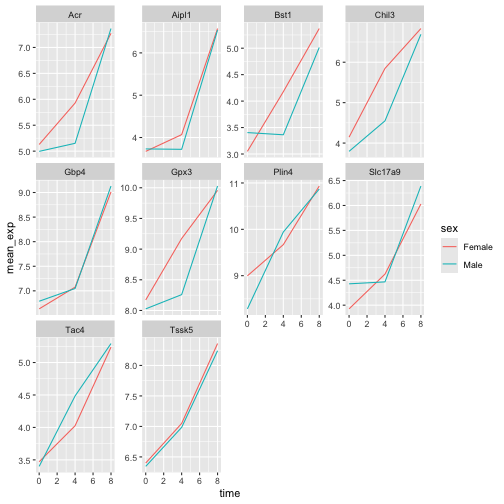
اب ہم ہر پلوٹ میں لائن کو چوہوں کی جنس کے لحاظ سے تقسیم کرنا چاہتے
ہیں۔ ایسا کرنے کے لیے ہمیں ڈیٹا فریم میں gene،
time، اور sex کے گروپس میں تقسیم کر کے اوسط
اظہار کا حساب لینا ہوگا:
R
mean_exp_by_time_sex <- sub_rna |>
  group_by(gene, time, sex) |>
    summarize(mean_exp = mean(expression_log))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, time, and sex.
ℹ Output is grouped by gene and time.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time, sex))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
mean_exp_by_time_sex
OUTPUT
# A tibble: 60 × 4
# Groups:   gene, time [30]
   gene   time sex    mean_exp
   <chr> <int> <chr>     <dbl>
 1 Acr       0 Female     5.13
 2 Acr       0 Male       5.00
 3 Acr       4 Female     5.93
 4 Acr       4 Male       5.15
 5 Acr       8 Female     7.27
 6 Acr       8 Male       7.36
 7 Aipl1     0 Female     3.67
 8 Aipl1     0 Male       3.73
 9 Aipl1     4 Female     4.07
10 Aipl1     4 Male       3.72
# ℹ 50 more rows
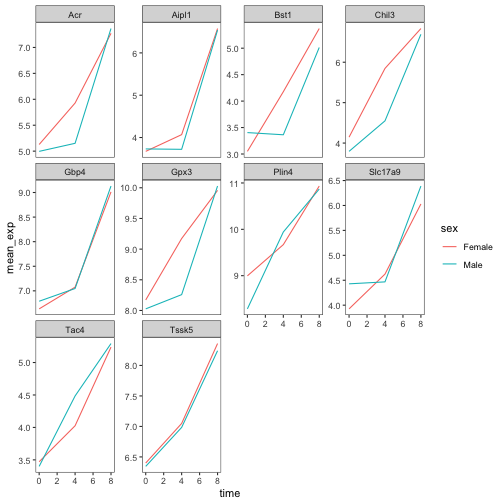
اب ہم color کا استعمال کرتے ہوئے مزید جنس کے لحاظ سے
تقسیم کر کے فیسیٹڈ پلاٹ تیار کر سکتے ہیں (ایک ہی پلاٹ کے اندر):
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y")
عام طور پر سفید پس منظر والے پلوٹس پرنٹ کرنے پر زیادہ واضح نظر آتے
ہیں۔ ہم فانکشن theme_bw() کا استعمال کرتے ہوئے پس منظر کو
سفید سیٹ کر سکتے ہیں۔ مزید برآں، ہم گرڈ کو ہٹا سکتے ہیں:
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank())
چیلنج
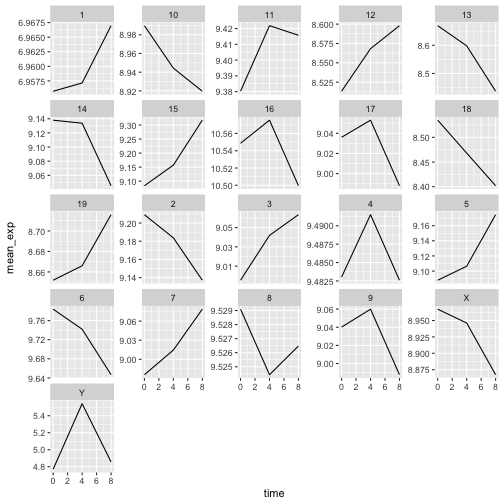
ابھی سیکھی گئی باتوں کا استعمال کرتے ہوئے ایک ایسا پلاٹ بنائیں جو یہ ظاہر کرے کہ انفیکشن کے دوران ہر کروموسوم کے اوسط اظہار میں کیسے تبدیلی آتی ہے۔
R
mean_exp_by_chromosome <- rna |>
  group_by(chromosome_name, time) |>
  summarize(mean_exp = mean(expression_log))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by chromosome_name and time.
ℹ Output is grouped by chromosome_name.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(chromosome_name, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
ggplot(data = mean_exp_by_chromosome, mapping = aes(x = time,
                                y = mean_exp)) +
  geom_line() +
  facet_wrap(~ chromosome_name, scales = "free_y")
facet_wrap ذیلی پلوٹس کو صفحے پر مناسب ترتیب میں سمیٹتا
ہے تاکہ وہ ایک صفحے پر صاف ستھرا فٹ ہو سکیں۔ دوسری طرف،
facet_grid آپ کو فارمولا نوٹیشن
(rows ~ columns؛ ایک . کو پلیس ہولڈر کے طور پر
استعمال کیا جا سکتا ہے جو صرف ایک قطار یا کالم کی نشاندہی کرتا ہے) کے
ذریعے واضح طور پر متعین کرنے کی اجازت دیتا ہے کہ آپ اپنے پلوٹس کو کس طرح
ترتیب دینا چاہتے ہیں۔
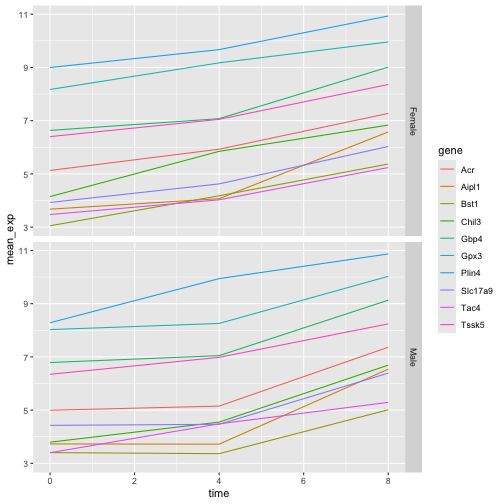
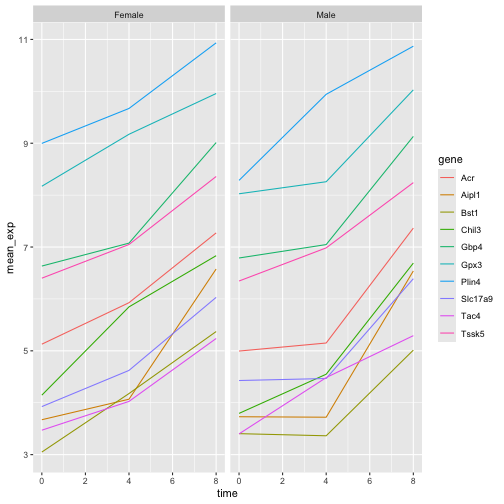
آئیے پچھلے پلاٹ کو تبدیل کریں تاکہ یہ موازنہ کیا جا سکے کہ نر اور مادہ چوہوں میں جین کے اوسط اظہار میں وقت کے ساتھ کیسے تبدیلی آئی ہے:
R
# One column, facet by rows
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = gene)) +
  geom_line() +
  facet_grid(sex ~ .)
R
# One row, facet by column
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = gene)) +
  geom_line() +
  facet_grid(. ~ sex)
ggplot2 تھیمز
theme_bw() کے علاوہ، جو پلاٹ کے بیک گراؤنڈ کو سفید کر
دیتا ہے، ggplot2 کے ساتھ کئی دیگر تھیمز بھی آتے ہیں جو آپ
کی ویژولائزیشن کی شکل کو تیزی سے تبدیل کرنے میں مفید ثابت ہو سکتے ہیں۔
تھیمز کی مکمل فہرست https://ggplot2.tidyverse.org/reference/ggtheme.html
پر دستیاب ہے۔ theme_minimal() اور
theme_light() مقبول ہیں، اور theme_void() ایک
نیا ہاتھ سے تیار کردہ تھیم بنانے کے لیے ایک آغازی نقطہ کے طور پر مفید ہو
سکتا ہے۔
ggthemes
پیکیج اختیارات کی ایک وسیع رینج فراہم کرتا ہے (بشمول ایکسل 2003 تھیم)۔
ggplot2
ایکسٹینشنز کی ویب سائٹ ان پیکیجز کی فہرست فراہم کرتی ہے جو
ggplot2 کی صلاحیتوں کو وسعت دیتے ہیں، بشمول اضافی
تھیمز۔
کسٹمائزیشن
آئیے وقت اور جین کے لحاظ سے اوسط اظہار کے فیسیٹڈ پلاٹ پر واپس آتے ہیں، جسے جنس کے لحاظ سے رنگا گیا ہے۔
ggplot2
چیٹ شیٹ پر ایک نظر ڈالیں، اور ان طریقوں کے بارے میں سوچیں جن کے
ذریعے آپ پلاٹ کو بہتر بنا سکتے ہیں۔
اب، ہم محوروں کے ناموں کو ‘time’ اور ‘mean_exp’ کے بجائے زیادہ معلوماتی ناموں میں تبدیل کر سکتے ہیں، اور فیگر میں ایک عنوان شامل کر سکتے ہیں:
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  labs(title = "Mean gene expression by duration of the infection",
       x = "Duration of the infection (in days)",
       y = "Mean gene expression")
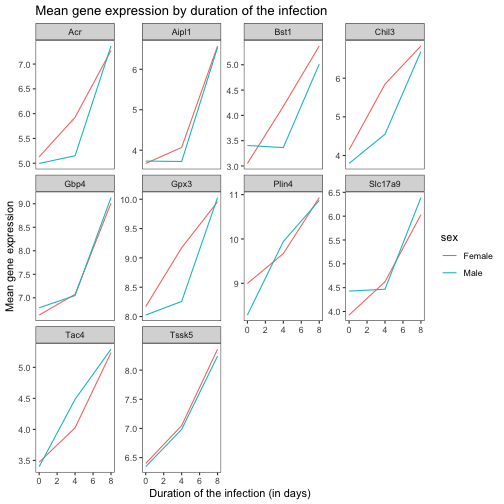
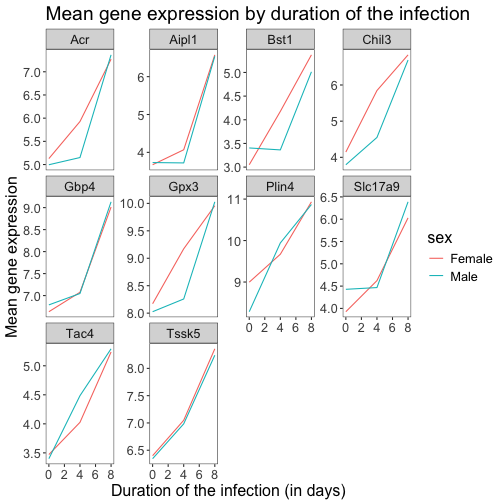
محوروں کے نام زیادہ معلوماتی ہیں، لیکن فونٹ کے سائز کو بڑھا کر ان کی پڑھنے کی صلاحیت کو مزید بہتر بنایا جا سکتا ہے:
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  labs(title = "Mean gene expression by duration of the infection",
       x = "Duration of the infection (in days)",
       y = "Mean gene expression")  +
  theme(text = element_text(size = 16))
نوٹ کریں کہ آپ اپنے پلوٹس کے فونٹس کو بدلنا بھی ممکن ہے۔ اگر آپ ونڈوز
استعمال کر رہے ہیں، تو ہو سکتا ہے کہ آپ کو extrafont
پیکیج انسٹال کرنا پڑے۔
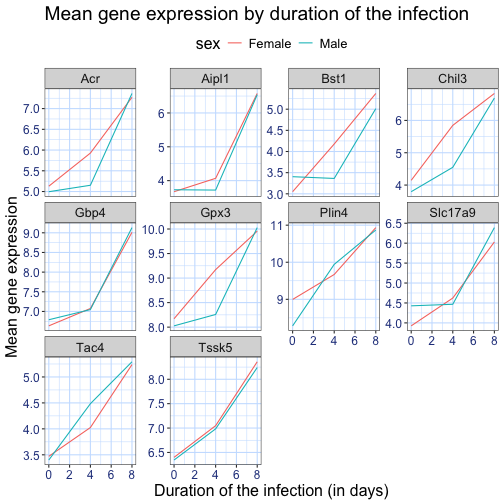
ہم x- اور y-ایکس کے ٹیکسٹ کے رنگ، گرڈ کے رنگ وغیرہ کو مزید کسٹمائز کر
سکتے ہیں۔ ہم مثال کے طور پر legend.position کو
"top" سیٹ کر کے لیجنڈ کو اوپر منتقل بھی کر سکتے ہیں۔
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  labs(title = "Mean gene expression by duration of the infection",
       x = "Duration of the infection (in days)",
       y = "Mean gene expression")  +
  theme(text = element_text(size = 16),
        axis.text.x = element_text(colour = "royalblue4", size = 12),
        axis.text.y = element_text(colour = "royalblue4", size = 12),
        panel.grid = element_line(colour="lightsteelblue1"),
        legend.position = "top")
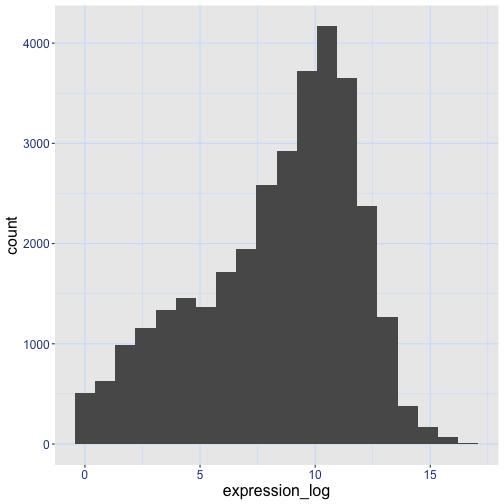
اگر آپ کو اپنی کی گئی تبدیلیاں ڈیفالٹ تھیم کے مقابلے میں زیادہ پسند آئیں، تو آپ انہیں ایک آبجیکٹ کے طور پر محفوظ کر سکتے ہیں تاکہ آپ انہیں دیگر پلوٹس پر آسانی سے لاگو کر سکیں جنہیں آپ بنا سکتے ہیں۔ یہاں ایک مثال ہے جس میں وہ ہسٹوگرام ہے جو ہم نے پہلے بنایا تھا۔
R
blue_theme <- theme(axis.text.x = element_text(colour = "royalblue4",
                                               size = 12),
                    axis.text.y = element_text(colour = "royalblue4",
                                               size = 12),
                    text = element_text(size = 16),
                    panel.grid = element_line(colour="lightsteelblue1"))

ggplot(rna, aes(x = expression_log)) +
  geom_histogram(bins = 20) +
    blue_theme
چیلنج
ان تمام معلومات کے حوالے سے، براہِ کرم مزید پانچ منٹ لیں تاکہ یا تو اس
مشق میں تیار کردہ پلوٹس میں سے کسی ایک کو بہتر بنا سکیں یا اپنا ایک
خوبصورت گراف تیار کر سکیں۔ تحریک کے لیے RStudio کے ggplot2
چیٹ شیٹ کا استعمال کریں۔ یہاں کچھ آئیڈیاز دیے گئے ہیں:
- دیکھیں کہ کیا آپ لائنوں کی موٹائی تبدیل کر سکتے ہیں۔
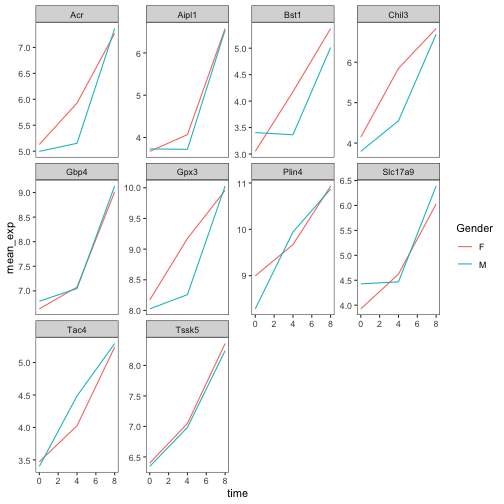
- کیا آپ لیجنڈ کا نام تبدیل کرنے کا کوئی طریقہ ڈھونڈ سکتے ہیں؟ اس کے
لیبلز کے بارے میں کیا؟ (اشارہ:
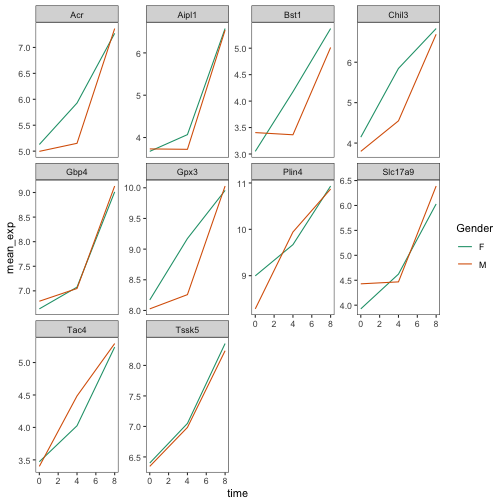
scale_سے شروع ہونے والے ggplot فنکشن کو تلاش کریں) - کسی مختلف کلر پیلیٹ کا استعمال کرنے یا لائنوں کے لیے رنگوں کو دستی طور پر متعین کرنے کی کوشش کریں (https://www.cookbook-r.com/Graphs/Colors_(ggplot2)/ دیکھیں)۔
مثال کے طور پر، اس پلوٹ کی بنیاد پر:
R
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank())
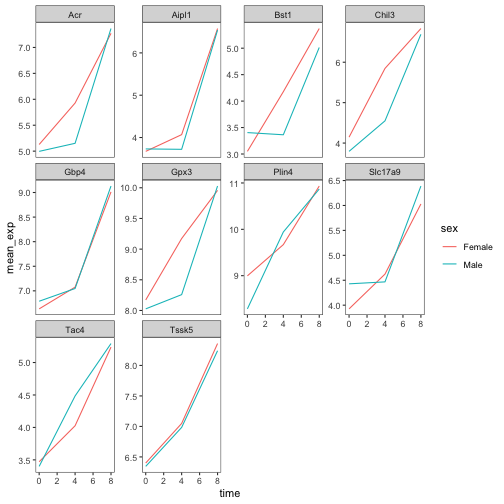
ہم اسے درج ذیل طریقوں سے کسٹمائز کر سکتے ہیں:
R
# change the thickness of the lines
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line(size=1.5) +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank())
WARNING
Warning: Using `size` aesthetic for lines was deprecated in ggplot2 3.4.0.
ℹ Please use `linewidth` instead.
This warning is displayed once per session.
Call `lifecycle::last_lifecycle_warnings()` to see where this warning was
generated.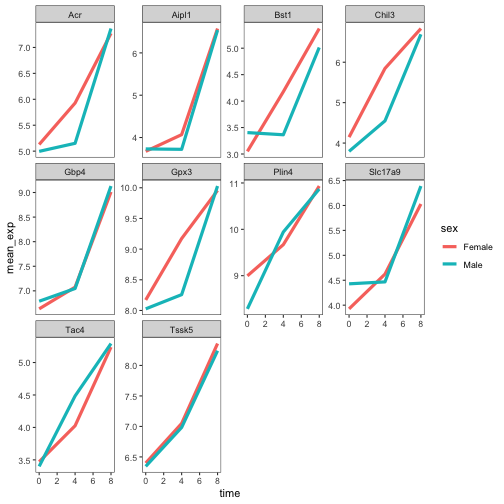
R
# change the name of the legend and the labels
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  scale_color_discrete(name = "Gender", labels = c("F", "M"))
R
# using a different color palette
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  scale_color_brewer(name = "Gender", labels = c("F", "M"), palette = "Dark2")
R
# manually specifying the colors
ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  theme_bw() +
  theme(panel.grid = element_blank()) +
  scale_color_manual(name = "Gender",  labels = c("F", "M"),
                     values = c("royalblue", "deeppink"))
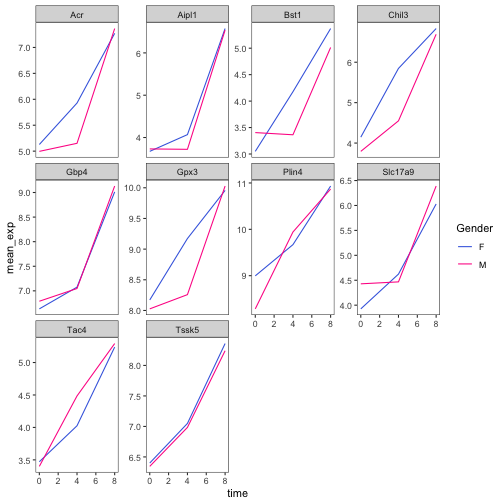
پلوٹس کی تشکیل
فیسیٹنگ ایک پلوٹ کو متعدد سب پلوٹس میں تقسیم کرنے کے لیے ایک بہترین ٹول ہے، لیکن کبھی کبھی آپ ایک ایسا واحد فیگر تیار کرنا چاہیں گے جس میں متعدد آزاد پلوٹس شامل ہوں، یعنی ایسے پلوٹس جو مختلف متغیرات یا یہاں تک کہ مختلف ڈیٹا فریمز پر مبنی ہوں۔
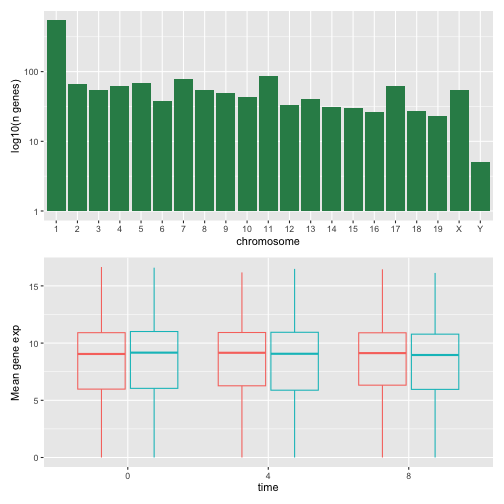
آئیے ان دو پلوٹس کو بنانے سے آغاز کرتے ہیں جنہیں ہم ایک دوسرے کے ساتھ ترتیب دینا چاہتے ہیں:
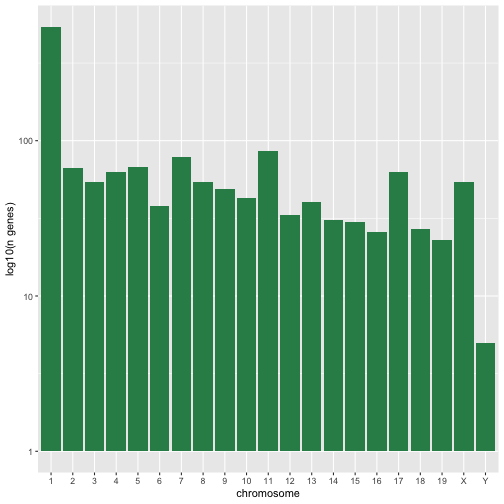
پہلا گراف ہر کروموسوم کے لیے منفرد جینز کی تعداد گنتا ہے۔ ہمیں پہلے
chromosome_name کی لیولز کی ترتیب تبدیل کرنی ہوگی اور ہر
کروموسوم کے لیے منفرد جینز کو فلٹر کرنا ہوگا۔ ہم یہاں تک کہ کہتے ہیں کہ
بہتر پڑھنے کی سہولت کے لیے y-axis کا پیمانہ log10 پیمانے میں تبدیل کر
دیتے ہیں۔
R
rna$chromosome_name <- factor(rna$chromosome_name,
                               levels = c(1:19,"X","Y"))

count_gene_chromosome <- rna |>
  select(chromosome_name, gene) |>
  distinct() |> ggplot() +
  geom_bar(aes(x = chromosome_name), fill = "seagreen",
           position = "dodge", stat = "count") +
  labs(y = "log10(n genes)", x = "chromosome") +
  scale_y_log10()

count_gene_chromosome
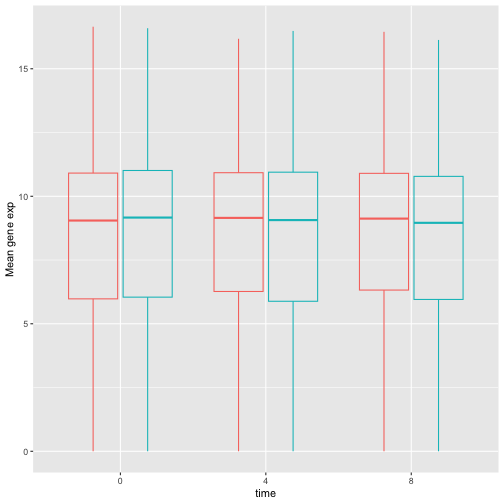
نیچے، ہم legend.position کو "none" سیٹ کر
کے لیجنڈ کو مکمل طور پر ہٹا دیتے ہیں۔
R
exp_boxplot_sex <- ggplot(rna, aes(y=expression_log, x = as.factor(time),
                 color=sex)) +
   geom_boxplot(alpha = 0) +
  labs(y = "Mean gene exp",
       x = "time") + theme(legend.position = "none")

exp_boxplot_sex
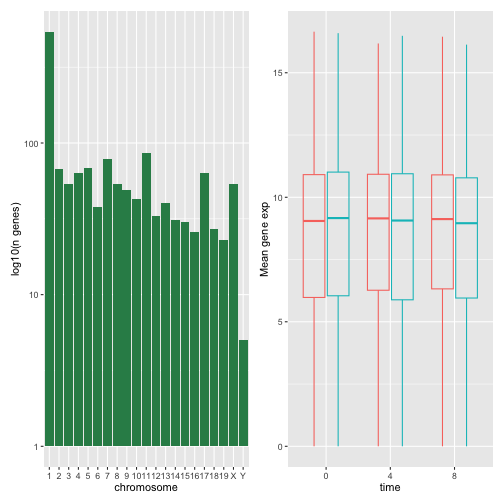
patchwork
پیکیج فیگرز کو ترتیب دینے کے لیے + کا استعمال کرتے ہوئے
انہیں یکجا کرنے کا ایک بہترین طریقہ فراہم کرتا ہے (عام طور پر ایک دوسرے
کے برابر)۔ مزید واضح طور پر، | انہیں واضح طور پر ایک دوسرے
کے برابر ترتیب دیتا ہے اور / انہیں ایک دوسرے کے اوپر ایک
دوسرے کے ساتھ رکھتا ہے۔
R
install.packages("patchwork")
R
library("patchwork")
count_gene_chromosome + exp_boxplot_sex
R
## or count_gene_chromosome | exp_boxplot_sex
R
count_gene_chromosome / exp_boxplot_sex
ہم plot_layout کے ذریعے حتمی ترتیب کے لے آؤٹ پر مزید
کنٹرول کر کے مزید پیچیدہ لے آؤٹس تیار کر سکتے ہیں:
R
count_gene_chromosome + exp_boxplot_sex + plot_layout(ncol = 1)
R
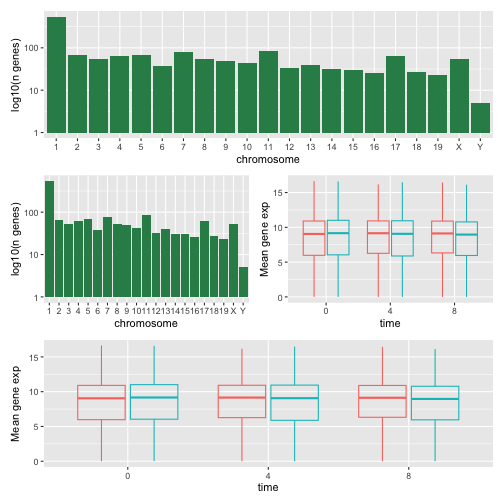
count_gene_chromosome +
 (count_gene_chromosome + exp_boxplot_sex) +
 exp_boxplot_sex +
 plot_layout(ncol = 1)
آخری پلوٹ کو | اور / کمپوزرز کا استعمال
کرتے ہوئے بھی بنایا جا سکتا ہے:
R
count_gene_chromosome /
 (count_gene_chromosome | exp_boxplot_sex) /
 exp_boxplot_sex
patchwork کے بارے میں مزید معلومات اس کے ویب پیج یا اس ویڈیو سے حاصل
کریں۔
ایک اور آپشن gridExtra پیکیج ہے جو
grid.arrange() کا استعمال کرتے ہوئے الگ الگ ggplots کو ایک
ہی فیگر میں یکجا کرنے کی سہولت فراہم کرتا ہے:
R
install.packages("gridExtra")
R
library("gridExtra")
grid.arrange(count_gene_chromosome, exp_boxplot_sex, ncol = 2)
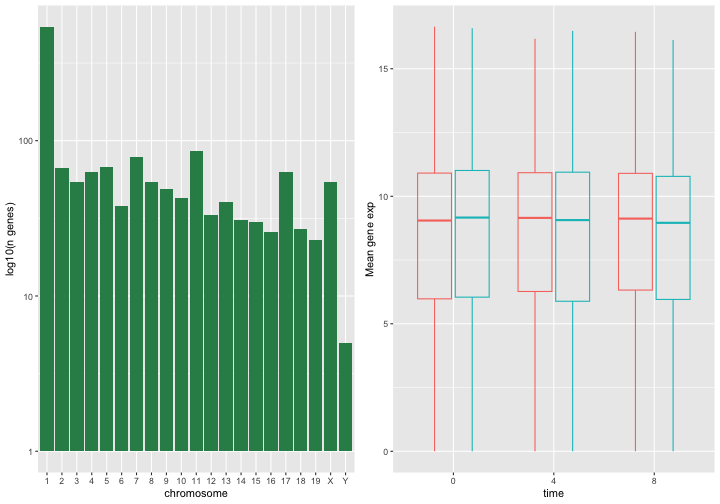
سادہ ترتیبات بنانے کے لیے استعمال ہونے والے ncol اور
nrow آرگومنٹس کے علاوہ، زیادہ
پیچیدہ لے آؤٹس تیار کرنے کے لیے ٹولز بھی موجود ہیں۔
پلوٹس کی ایکسپورٹنگ
اپنا پلوٹ بنانے کے بعد، آپ اسے اپنی پسند کے فارمیٹ میں ایک فائل میں محفوظ کر سکتے ہیں۔ RStudio کے Plot پین میں موجود Export ٹیب آپ کے پلوٹس کو کم ریزولوشن میں محفوظ کرے گا، جو بہت سے جرنلز کی جانب سے قبول نہیں کیا جائے گا اور پوسٹرز کے لیے مناسب طریقے سے اسکیل نہیں ہو پائے گا۔
اس کے بجائے، ggsave() فنکشن استعمال کریں، جو آپ کو مناسب
آرگومنٹس (width، height اور dpi)
کو ایڈجسٹ کر کے اپنے پلوٹ کے ڈائمنشن اور ریزولوشن کو آسانی سے تبدیل کرنے
کی سہولت فراہم کرتا ہے۔
اس بات کو یقینی بنائیں کہ آپ کی ورکنگ ڈائریکٹری میں
fig_output/ فولڈر موجود ہے۔
R
my_plot <- ggplot(data = mean_exp_by_time_sex,
       mapping = aes(x = time, y = mean_exp, color = sex)) +
  geom_line() +
  facet_wrap(~ gene, scales = "free_y") +
  labs(title = "Mean gene expression by duration of the infection",
         x = "Duration of the infection (in days)",
         y = "Mean gene expression") +
  guides(color=guide_legend(title="Gender")) +
  theme_bw() +
  theme(axis.text.x = element_text(colour = "royalblue4", size = 12),
        axis.text.y = element_text(colour = "royalblue4", size = 12),
        text = element_text(size = 16),
        panel.grid = element_line(colour="lightsteelblue1"),
        legend.position = "top")
ggsave("fig_output/mean_exp_by_time_sex.png", my_plot, width = 15,
       height = 10)

# This also works for grid.arrange() plots
combo_plot <- grid.arrange(count_gene_chromosome, exp_boxplot_sex,
                           ncol = 2, widths = c(4, 6))
ggsave("fig_output/combo_plot_chromosome_sex.png", combo_plot,
       width = 10, dpi = 300)
نوٹ: پیرامیٹرز width اور height محفوظ کردہ
پلوٹ میں فونٹ کے سائز کا تعین بھی کرتے ہیں۔
ویژولائزیشن کے لیے دیگر پیکیجز
ggplot2 ایک انتہائی طاقتور پیکیج ہے جو ہمارے منظم
ڈیٹا اور منظم ٹولز پائپ لائن میں بہت اچھی طرح فٹ بیٹھتا
ہے۔ R میں ویژولائزیشن کے دیگر پیکیجز بھی ہیں جنہیں نظر انداز نہیں کیا
جانا چاہیے۔
بیس گرافکس
R کے ساتھ آنے والا ڈیفالٹ گرافکس سسٹم، جسے اکثر base R
graphics کہا جاتا ہے، سادہ اور تیز ہے۔ یہ پینٹر یا کینوس
ماڈل پر مبنی ہے، جہاں مختلف آؤٹ پٹس براہِ راست ایک دوسرے کے اوپر
رکھے جاتے ہیں (شکل ذیل میں دیکھیں)۔ یہ
ggplot2 (اور نیچے بیان کیے گئے lattice) کے
ساتھ ایک بنیادی فرق ہے، جو مخصوص آبجیکٹس واپس کرتا ہے، جنہیں اسکرین پر
یا فائل میں رینڈر کیا جاتا ہے، اور انہیں یہاں تک کہ اپ ڈیٹ بھی کیا جا
سکتا ہے۔
R
par(mfrow = c(1, 3))
plot(1:20, main = "First layer, produced with plot(1:20)")

plot(1:20, main = "A horizontal red line, added with abline(h = 10)")
abline(h = 10, col = "red")

plot(1:20, main = "A rectangle, added with rect(5, 5, 15, 15)")
abline(h = 10, col = "red")
rect(5, 5, 15, 15, lwd = 3)
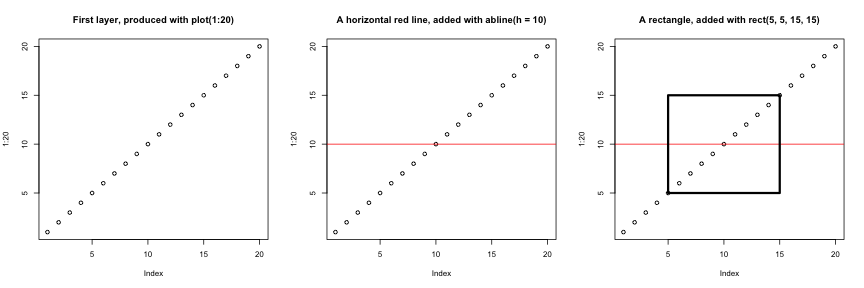
ایک اور بنیادی فرق یہ ہے کہ بیس گرافکس کا پلوٹنگ فنکشن ان کے ان پٹ کی
قسم کی بنیاد پر درست کام کرنے کی کوشش کرتا ہے، یعنی یہ اپنے ان
پٹ کی کلاس کے مطابق اپنے رویے کو ڈھال لیتا ہے۔ یہ ایک بار پھر اس سے بہت
مختلف ہے جو ہمارے پاس ggplot2 میں ہے، جو صرف ڈیٹا فریمز کو
ان پٹ کے طور پر قبول کرتا ہے، اور جس میں پلوٹس کو مرحلہ وار، ایک ایک جزو
شامل کر کے، تیار کرنا ہوتا ہے۔
R
par(mfrow = c(2, 2))
boxplot(rnorm(100),
        main = "Boxplot of rnorm(100)")
boxplot(matrix(rnorm(100), ncol = 10),
        main = "Boxplot of matrix(rnorm(100), ncol = 10)")
hist(rnorm(100))
hist(matrix(rnorm(100), ncol = 10))
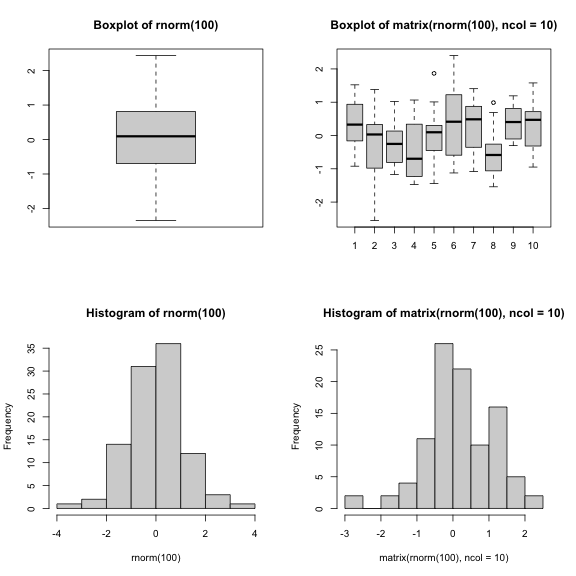
بیس گرافکس (base graphics) میں ڈیفالٹ طریقہ کار سادہ اور معیاری فیگرز
کے لیے بہت مؤثر ہو سکتا ہے، جنہیں کوڈ کی ایک سینگل لائن اور ایک ہی فنکشن
جیسے کہ plot، یا hist، یا
boxplot، … کے ذریعے بہت جلد تیار کیا جا سکتا ہے۔ تاہم،
ڈیفالٹ سیٹنگز ہمیشہ سب سے زیادہ پرکشش نہیں ہوتیں اور فیگرز کی ٹیوننگ،
خاص طور پر جب وہ زیادہ پیچیدہ ہو جائیں (مثال کے طور پر فیسیٹس (facets)
تیار کرنے کے لیے)، طویل اور پیچیدہ ہو سکتی ہے۔
لیٹیس (lattice) پیکیج
lattice پیکیج ggplot2 کے
مشابہ ہے کیونکہ یہ ان پٹ کے طور پر ڈیٹا فریمز استعمال کرتا ہے، گرافیکل
آبجیکٹس واپس کرتا ہے اور فیسیٹنگ کو سپورٹ کرتا ہے۔ تاہم،
lattice گرافکس کے گرامر پر مبنی نہیں ہے اور اس کا انٹرفیس
زیادہ پیچیدہ ہے۔
lattice پیکیج کے لیے ایک اچھا حوالہ Deepayan (2008). ہے۔
- R میں بصری نمائش
ذریعہ: Data Visualization Cheat Sheet۔↩︎