
All in One View
Content from اسپریڈشیٹس کے ذریعے ڈیٹا کی تنظیم
Last updated on 2026-11-11 | Edit this page
Overview
Questions
- ٹیبل ڈیٹا کو کیسے ترتیب دیا جائے؟
Objectives
- اسپریڈشیٹس، ان کی خوبیوں اور خامیوں کے بارے میں جانیں۔
- مؤثر ڈیٹا استعمال کے لیے ہم اسپریڈشیٹس میں ڈیٹا کو کیسے فارمیٹ کرتے ہیں؟
- اسپریڈشیٹس میں ہونے والی عام غلطیوں اور انہیں درست کرنے کے طریقوں کے بارے میں جانیں۔
- اپنے ڈیٹا کو منظم ڈیٹا کے اصولوں کے مطابق ترتیب دیں۔
- ٹیکسٹ پر مبنی اسپریڈشیٹ فارمیٹس، جیسے کہ کوما-سیپریٹڈ (CSV) یا ٹیب-سیپریٹڈ (TSV) فارمیٹس کے بارے میں جانیں۔
یہ ایپیسوڈ Data Carpentries کے Data Analysis and Visualisation in R for Ecologists اسباق پر مبنی ہے۔
اسپریڈشیٹ پروگرامز
سوال
- ڈیٹا کی بہتر ترتیب کے لیے اسپریڈشیٹس کے استعمال کے بنیادی اصول کیا ہیں؟
مقصد
- ڈیٹا کی ترتیب کے بہترین طریقہ کاروں کی وضاحت کریں تاکہ کمپیوٹرز ڈیٹا سیٹس کا بہترین استعمال کر سکیں۔
اہم نکتہ
- ڈیٹا کی بہترین تنظیم کسی بھی تحقیقی منصوبے کی بنیاد ہوتی ہے۔
ڈیٹا کی بہترین ترتیب آپ کے تحقیقی پروجیکٹ کی بنیاد ہے۔ زیادہ تر محققین کے پاس ڈیٹا اسپریڈشیٹس میں موجود ہوتا ہے یا وہ ان میں ڈیٹا انٹری کرتے ہیں۔ اسپریڈشیٹ پروگرامز ڈیٹا ٹیبلز ڈیزائن کرنے اور ڈیٹا کے معیار کے انتظام کے بنیادی افعال کو سنبھالنے کے لیے انتہائی مفید گرافیکل انٹرفیسز ہیں۔ Broman and Woo (2018). بھی دیکھیں۔
اسپریڈشیٹ کا خاکہ
اسپریڈشیٹس ڈیٹا انٹری کے لیے موزوں ہیں۔ اسی لیے ہمارے پاس اسپریڈشیٹس میں بہت زیادہ ڈیٹا موجود ہوتا ہے۔ بطور محقق، آپ کا بہت سارا وقت اس ‘ڈیٹا کی ترتیب و تیاری’ کے مرحلے میں گزرے گا۔ یہ بہت زیادہ دلچسپ نہیں ہے، لیکن ضروری ہے۔ ہم آپ کو یہ سکھائیں گے کہ ڈیٹا کی ترتیب کے بارے میں کیسے سوچنا ہے اور زیادہ مؤثر ڈیٹا کی ترتیب و تیاری کے لیے کچھ طریقے بھی۔
یہ سبق آپ کو یہ نہیں سکھائے گا
- اسپریڈشیٹ میں شماریات کیسے کریں
- اسپریڈشیٹ میں پلوٹنگ کیسے کریں
- اسپریڈشیٹ پروگراموں میں کوڈ لکھنے کا طریقہ
اگر آپ ایسا کرنا چاہتے ہیں، تو O’Reilly کی شائع کردہ Head First Excel ایک اچھا حوالہ ہے۔
ہم اسپریڈشیٹس میں ڈیٹا تجزیہ کیوں نہیں سکھا رہے؟
اسپریڈشیٹس میں ڈیٹا کا تجزیہ عام طور پر بہت زیادہ دستی کام کا مطالبہ کرتا ہے۔ اگر آپ کسی پیرامیٹر کو تبدیل کرنا چاہتے ہیں یا کسی نئے ڈیٹا سیٹ کے ساتھ تجزیہ کرنا چاہتے ہیں، تو آپ کو عام طور پر سب کچھ ہاتھ سے دوبارہ کرنا پڑتا ہے۔ (ہم جانتے ہیں کہ آپ میکروز بنا سکتے ہیں، لیکن اگلے نکتے کو دیکھیں۔)
اس کے علاوہ، جب آپ اپنے کام پر واپس جانا چاہتے ہوں یا کوئی آپ کے تجزیے کی تفصیلات مانگے، تو اسپریڈشیٹ پروگراموں میں کیے گئے شماریاتی یا پلاٹنگ تجزیوں کا سراغ لگانا یا انہیں دوبارہ تیار کرنا بھی مشکل ہوتا ہے۔
اسپریڈشیٹ پروگراموں کی بہت سی اقسام دستیاب ہیں۔ چونکہ زیادہ تر شرکاء اپنے بنیادی اسپریڈشیٹ پروگرام کے طور پر ایکسل (Excel) کا استعمال کرتے ہیں، اس لیے اس سبق میں ایکسل کی مثالوں کا استعمال کیا جائے گا۔ ایک مفت اسپریڈشیٹ پروگرام جو استعمال کیا جا سکتا ہے، وہ لیبر اوفیس (LibreOffice) ہے۔ پروگراموں کے درمیان کمانڈز میں تھوڑا فرق ہو سکتا ہے، لیکن بنیادی تصور ایک ہی ہے۔
اسپریڈشیٹ پروگرامز میں ان بہت سی چیزوں کا احاطہ ہوتا ہے جو ہمیں بطور محققین کرنے کی ضرورت ہوتی ہے۔ ہم انہیں درج ذیل مقاصد کے لیے استعمال کر سکتے ہیں:
- ڈیٹا انٹری
- ڈیٹا کی ترتیب
- ڈیٹا کی سب سیٹنگ اور ترتیب
- اعداد و شمار
- پلوٹنگ
اسپریڈشیٹ پروگرامز ڈیٹا کی نمائندگی اور نمائش کے لیے ٹیبلز کا استعمال کرتے ہیں۔ ٹیبلز کی شکل میں فارمیٹ شدہ ڈیٹا اس باب کا بنیادی موضوع بھی ہے، اور ہم دیکھیں گے کہ کس طرح ڈیٹا کو ایک معیاری طریقے سے ٹیبلز میں ترتیب دیا جائے تاکہ بعد کے مؤثر تجزیے کو یقینی بنایا جا سکے۔
چیلنج: اپنے پڑوسی کے ساتھ درج ذیل نکات پر تبادلہ خیال کریں
- کیا آپ نے اپنی تحقیق، کورسز، یا گھر پر اسپریڈشیٹس کا استعمال کیا ہے؟
- آپ اسپریڈشیٹس میں کس قسم کے آپریشنز کرتے ہیں؟
- آپ کے خیال میں اسپریڈشیٹس کس کاموں کے لیے موزوں ہیں؟
- کیا آپ نے کبھی کسی اسپریڈشیٹ پروگرام میں ایسا کچھ غلطی سے کیا ہے جس سے آپ مایوس یا اداس ہوئے ہیں؟
اسپریڈشیٹس کے مسائل
اسپریڈشیٹس ڈیٹا انٹری کے لیے موزوں ہیں، لیکن حقیقت میں ہم اسپریڈشیٹ پروگرامز کو ڈیٹا انٹری سے کہیں زیادہ مقاصد کے لیے استعمال کرتے ہیں۔ ہم انہیں اشاعتوں کے لیے ڈیٹا ٹیبلز تیار کرنے، خلاصہ اعداد و شمار حاصل کرنے اور فیگرز بنانے کے لیے استعمال کرتے ہیں۔
اسپریڈشیٹ میں اشاعتوں کے لیے ٹیبلز تیار کرنا موزوں طریقہ نہیں ہے - اکثر، اشاعت کے لیے ڈیٹا ٹیبل کو فارمیٹ کرتے وقت، ہم اہم خلاصہ اعداد و شمار کو اس طرح پیش کرتے ہیں جسے حقیقت میں ڈیٹا کے طور پر پڑھنے کا ارادہ نہیں ہوتا، اور اس میں اکثر خصوصی فارمیٹنگ (سیلز کو یکجا کرنا، بارڈرز بنانا، یا اسے خوبصورت بنانا) شامل ہوتی ہے۔ ہم آپ کو مشورہ دیتے ہیں کہ اس قسم کا کام اپنے ڈاکومنٹ ایڈیٹنگ سافٹ ویئر میں ہی کریں۔
بعد کے دو ایپلی کیشنز، اعداد و شمار اور اشکال کی تیاری، احتیاط کے ساتھ استعمال کیے جانے چاہئیں: اسپریڈشیٹ پروگراموں کی گرافیکل اور ڈریگ اینڈ ڈراپ خصوصیت کی وجہ سے، اپنے اقدامات کو دہرانا، بلکہ دوسروں کے اقدامات کو دہرانا بھی، انتہائی مشکل یا ناممکن ہو سکتا ہے، خاص طور پر اگر آپ کے اعداد و شمار یا اشکال کے لیے زیادہ پیچیدہ حسابات کرنے کی ضرورت ہو۔ مزید برآں، اسپریڈشیٹ میں حسابات کرتے وقت، غلطی سے متصل کئی سیلز پر تھوڑا مختلف فارمولا لاگو کر دینا آسان ہوتا ہے۔ جب آپ R یا SAS جیسے کمانڈ لائن پر مبنی اعداد و شمار کے پروگرام کا استعمال کرتے ہیں، تو یہ عملی طور پر ناممکن ہے کہ آپ اپنے ڈیٹا سیٹ کے ایک مشاہدے پر حساب کریں لیکن دوسرے پر نہ کریں، الا یہ کہ آپ یہ جان بوجھ کر کر رہے ہوں۔
ڈیٹا انٹری اور صفائی کے لیے اسپریڈشیٹس کا استعمال
اس سبق میں، ہم یہ فرض کریں گے کہ آپ غالباً اپنے بنیادی اسپریڈشیٹ پروگرام کے طور پر ایکسل (Excel) استعمال کر رہے ہیں - دیگر پروگرامز بھی موجود ہیں (gnumeric، OpenOffice کا Calc)، اور ان کی کارکردگی بھی ملتی جلتی ہے، لیکن ایکسل وہ پروگرام معلوم ہوتا ہے جسے ماہرینِ حیاتیات اور بائیو میڈیکل محققین سب سے زیادہ استعمال کرتے ہیں۔
اس سبق میں ہم ان بارے میں بات کریں گے:
- اسپریڈشیٹس میں ڈیٹا ٹیبلز کی فارمیٹنگ
- فارمیٹنگ کے مسائل
- ڈیٹا کی ایکسپورٹنگ
اسپریڈشیٹس میں ڈیٹا ٹیبلز کی فارمیٹنگ
سوالات
- مؤثر ڈیٹا استعمال کے لیے ہم اسپریڈشیٹس میں ڈیٹا کو کیسے فارمیٹ کرتے ہیں؟
اہداف
اسپریڈشیٹس میں ڈیٹا انٹری اور فارمیٹنگ کے لیے بہترین طریقہ کار کی وضاحت کریں۔
اسپریڈشیٹ میں متغیرات اور مشاہدات کو ترتیب دینے کے لیے بہترین طریقہ کار اپنائیں۔
اہم نکات
اپنے خام ڈیٹا میں کبھی تبدیلی نہ کریں۔ کوئی بھی تبدیلی کرنے سے پہلے ہمیشہ ایک کاپی بنا لیں۔
اپنے ڈیٹا کو صاف کرنے کے لیے اٹھائے گئے تمام اقدامات کا ریکارڈ ایک پلین ٹیکسٹ فائل میں رکھیں۔
اپنے ڈیٹا کو منظم ڈیٹا کے اصولوں کے مطابق ترتیب دیں۔
سب سے عام غلطی یہ ہوتی ہے کہ اسپریڈشیٹ پروگراموں کو لیب نوٹ بکس کی طرح استعمال کیا جائے، یعنی معلومات پہنچانے کے لیے سیاق و سباق، مارجن میں لکھی ہوئی نوٹس، ڈیٹا اور فیلڈز کی مکانی ترتیب پر بھروسہ کیا جائے۔ بطور انسان، ہم (عام طور پر) ان چیزوں کی تشریح کر سکتے ہیں، لیکن کمپیوٹرز معلومات کو اسی طرح نہیں دیکھتے، اور جب تک ہم کمپیوٹر کو یہ نہیں بتائیں کہ ہر ایک چیز کا کیا مطلب ہے (اور یہ مشکل ہو سکتا ہے!)، وہ یہ نہیں سمجھ پائے گا کہ ہمارا ڈیٹا ایک دوسرے کے ساتھ کیسے جڑا ہوا ہے۔
کمپیوٹرز کی طاقت کا استعمال کرتے ہوئے، ہم ڈیٹا کو کہیں زیادہ مؤثر اور تیز طریقوں سے مینج اور تجزیہ کر سکتے ہیں، لیکن اس طاقت کا استعمال کرنے کے لیے، ہمیں اپنے ڈیٹا کو اس طرح تیار کرنا ہوگا کہ کمپیوٹر اسے سمجھ سکے (اور کمپیوٹرز بہت سختی سے حقیقت پسند ہوتے ہیں)۔
اسی لیے شروع سے ہی بہترین طریقے سے فارمیٹ شدہ ٹیبلز تیار کرنا انتہائی ضروری ہے—اس سے پہلے کہ آپ اپنے پہلے ابتدائی تجربے سے ڈیٹا درج کرنا شروع کریں۔ ڈیٹا کی تنظیم آپ کے تحقیقی منصوبے کی بنیاد ہے۔ یہ آپ کے تجزیے کے دوران ڈیٹا کے ساتھ کام کرنے کو آسان یا مشکل بنا سکتی ہے، اس لیے ڈیٹا درج کرتے وقت یا اپنے تجربے کو ترتیب دیتے وقت اس بارے میں سوچنا فائدہ مند ہے۔ آپ اسپریڈشیٹس میں مختلف طریقوں سے چیزوں کو ترتیب دے سکتے ہیں، لیکن ان میں سے کچھ انتخاب دیگر پروگراموں میں ڈیٹا کے ساتھ کام کرنے کی آپ کی صلاحیت کو محدود کر سکتے ہیں یا اس بات میں رکاوٹ بن سکتے ہیں کہ آپ کے 6 ماہ بعد کا آپ یا آپ کا کوئی ساتھی ڈیٹا کے ساتھ کام کر سکے۔
نوٹ: ڈیٹا انٹری اور ڈیٹا تجزیے کے لیے بہترین لے آؤٹس/فارمیٹس (نیز سافٹ ویئر اور انٹرفیسز) مختلف ہو سکتے ہیں۔ اس بات کو مدنظر رکھنا ضروری ہے، اور مثالی طور پر ایک سے دوسرے میں تبدیلی کو خودکار بنانا بہتر ہے۔
اپنے تجزیوں کا ریکارڈ رکھنا
جب آپ اسپریڈشیٹس کے ساتھ کام کر رہے ہوں، تو ڈیٹا کی صفائی یا تجزیوں کے دوران، یہ بہت آسان ہو جاتا ہے کہ آپ کا اسپریڈشیٹ اس سے بہت مختلف نظر آنے لگے جو آپ نے شروع میں استعمال کیا تھا۔ اپنے تجزیوں کو دوبارہ حاصل کرنے یا اس بات کا پتہ لگانے کے لیے کہ آپ نے کیا کیا تھا جب کوئی ریویوئر یا انسٹرکٹر کسی مختلف تجزیے کی درخواست کرے، آپ کو
اپنے صاف کیے ہوئے یا تجزیہ شدہ ڈیٹا کے ساتھ ایک نیا فائل بنائیں۔ اصل ڈیٹا سیٹ کو تبدیل نہ کریں، ورنہ آپ کبھی یہ نہیں جان پائیں گے کہ آپ کہاں سے شروع کیا تھا!
اپنی صفائی یا تجزیے میں اٹھائے گئے مراحل کا حساب رکھیں۔ آپ کو ان مراحل کو اسی طرح ریکارڈ کرنا چاہیے جیسے آپ کسی تجربے کے کسی بھی مرحلے کو ریکارڈ کرتے ہیں۔ ہم تجویز کرتے ہیں کہ آپ یہ کام ایک سادہ ٹیکسٹ فائل میں کریں جو ڈیٹا فائل والے ہی فولڈر میں محفوظ ہو۔
یہ اسپریڈشیٹ کی ترتیب کی ایک مثال ہو سکتی ہے:
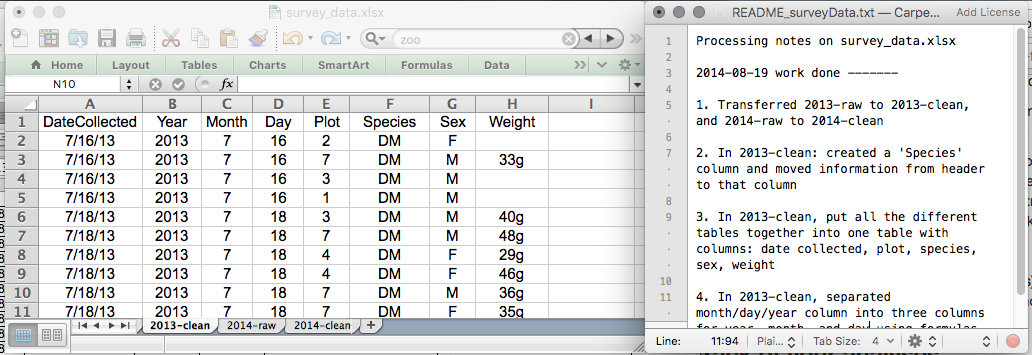
ان اصولوں کو آج ہی اپنی مشقوں کے دوران عملی طور پر لاگو کریں۔
اگرچہ ورژننگ اس کورس کے دائرہ کار سے باہر ہے، لیکن آپ اپنے ڈیٹا پر ورژن کنٹرول کو برقرار رکھنے کے طریقے سیکھنے کے لیے Carpentries کے ‘Git’ پر مبنی اسباق کو دیکھ سکتے ہیں۔ ایک مختصر ٹیوٹوریل کے لیے اس بلاگ پوسٹ یا زیادہ تحقیقی طور پر استعمال کے کیس کے لیے Perez-Riverol et al. (2016) کو بھی دیکھیں۔
اسپریڈشیٹس میں ڈیٹا کی ساخت
ڈیٹا کے لیے اسپریڈشیٹ پروگرامز کے استعمال کے بنیادی اصول:
- اپنے تمام متغیرات کو کالموں میں رکھیں - وہ چیز جس کی آپ پیمائش کر رہے ہیں، جیسے کہ ‘وزن’ یا ‘درجہ حرارت’۔
- ہر مشاہدے کو اپنی ایک الگ قطار میں رکھیں۔
- ایک ہی سیل میں معلومات کے متعدد حصوں کو یکجا نہ کریں۔ کبھی کبھی یہ صرف ایک چیز معلوم ہوتی ہے، لیکن سوچیں کہ کیا یہی وہ واحد طریقہ ہے جس کے ذریعے آپ اس ڈیٹا کو استعمال یا ترتیب دینا چاہیں گے۔
- خام ڈیٹا کو خام ہی رہنے دیں - اس میں کوئی تبدیلی نہ کریں!
- صاف کیے گئے ڈیٹا کو ٹیکسٹ پر مبنی فارمیٹ، جیسے کہ CSV (کوما-سیپریٹڈ ویلیوز) فارمیٹ میں ایکسپورٹ کریں۔ اس سے یہ یقینی بنتا ہے کہ کوئی بھی اس ڈیٹا کو استعمال کر سکے، اور زیادہ تر ڈیٹا ریپوزٹریز کے لیے یہ ضروری ہے۔
مثال کے طور پر، ہمارے پاس ان مریضوں کا ڈیٹا ہے جو برسلز، بیلجیم کے کئی ہسپتالوں میں آئے تھے۔ انہوں نے دورے کی تاریخ، ہسپتال، مریضوں کی جنس، وزن اور خون کے گروپ کا ریکارڈ کیا تھا۔
اگر ہم ڈیٹا کا حساب اس طرح رکھیں:
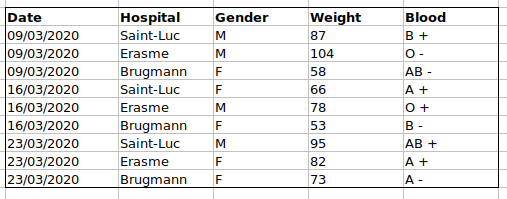
مسئلہ یہ ہے کہ ABO اور Rhesus گروپس ایک ہی Blood ٹائپ
کالم میں ہیں۔ لہٰذا، اگر وہ A گروپ کے تمام مشاہدات کا جائزہ لینا چاہتے
ہوں یا ABO گروپ کے لحاظ سے وزن کی تقسیم دیکھنا چاہتے ہوں، تو اس ڈیٹا سیٹ
اپ کا استعمال کرتے ہوئے ایسا کرنا مشکل ہوگا۔ اگر اس کے بجائے ہم ABO اور
Rhesus گروپس کو الگ الگ کالموں میں رکھیں، تو آپ دیکھ سکتے ہیں کہ یہ کہیں
زیادہ آسان ہو جائے گا۔
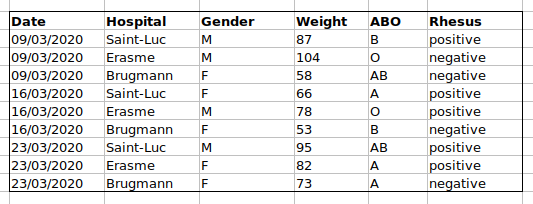
ڈیٹا شیٹ تیار کرتے وقت ایک اہم قاعدہ یہ ہے کہ کالموں کا استعمال متغیرات کے لیے کیا جاتا ہے اور قطاروں کا استعمال مشاہدات کے لیے کیا جاتا ہے:
- کالمز متغیرات ہیں
- قطاریں مشاہدات ہیں
- سیلز انفرادی اقدار ہیں
چیلنج: ہم ایک غیر منظم ڈیٹا سیٹ کو لیں گے اور بتائیں گے کہ ہم اسے کیسے صاف کریں گے۔
اس لنک پر کلک کر کے ایک غیر منظم ڈیٹا سیٹ ڈاؤن لوڈ کریں۔
ڈیٹا کو ایک اسپریڈشیٹ پروگرام میں کھولیں۔
آپ دیکھ سکتے ہیں کہ یہاں دو ٹیبز موجود ہیں۔ ڈیٹا میں مختلف کلینیکل متغیرات شامل ہیں جو 2020 میں کووڈ-19 کی پہلی اور دوسری لہروں کے دوران برسلز کے مختلف ہسپتالوں میں ریکارڈ کی گئی تھیں۔ جیسا کہ آپ دیکھ سکتے ہیں، مارچ اور نومبر کی لہروں کے دوران ڈیٹا کو مختلف طریقوں سے ریکارڈ کیا گیا تھا۔ اب آپ اس پروجیکٹ کے ذمہ دار شخص ہیں اور آپ ڈیٹا کا تجزیہ شروع کرنا چاہتے ہیں۔
اپنے ساتھ موجود شخص کے ساتھ مل کر، اس اسپریڈشیٹ میں کیا غلطی ہے، اس کی نشاندہی کریں۔ اس کے علاوہ، ان مراحل پر بھی تبادلہ خیال کریں جو آپ کو پہلی اور دوسری لہر کے ٹیبز کو صاف کرنے اور انہیں ایک ہی اسپریڈشیٹ میں یکجا کرنے کے لیے اٹھانے پڑیں گے۔
اہم: ہماری پہلی مشورے کو نہ بھولیں: صاف کیے گئے ڈیٹا کے لیے ایک نیا فائل (یا ٹیب) بنائیں، اپنے اصل (خام) ڈیٹا میں کبھی بھی تبدیلی نہ کریں۔
اس مشق کو مکمل کرنے کے بعد، ہم ایک گروپ کے طور پر اس بات پر تبادلہ خیال کریں گے کہ اس ڈیٹا میں کیا غلطی تھی اور آپ اسے کیسے درست کریں گے۔
چیلنج: ڈیٹا کو ترتیب دینے کے بعد، درج ذیل سوالات کے جوابات دیں:
- اس مطالعے میں کتنے مردوں اور عورتوں نے شرکت کی؟
- کتنے A، AB اور B اقسام کا ٹیسٹ کیا گیا ہے؟
- جیسا کہ اوپر، لیکن آلودہ نمونوں کو نظر انداز کرتے ہوئے؟
- کتنے Rhesus + اور - کے نمونے ٹیسٹ کیے گئے ہیں؟
- کتنے یونیورسل ڈونرز (O-) کا ٹیسٹ کیا گیا ہے؟
- AB رکھنے والے مردوں کا اوسط وزن کتنا ہے؟
- مختلف ہسپتالوں میں کتنے نمونوں کا ٹیسٹ کیا گیا ہے؟
ایک بہترین حوالہ، خاص طور پر R اسکرپٹنگ کے حوالے سے، Tidy Data پیپر Wickham (2014). ہے۔
اسپریڈشیٹس میں عام غلطیاں
سوالات
- اسپریڈشیٹس میں ڈیٹا کی فارمیٹنگ کے حوالے سے کچھ عام چیلنجز کیا ہیں اور ہم ان سے کیسے بچ سکتے ہیں؟
اہداف
- اسپریڈشیٹ فارمیٹنگ کے عام مسائل کی شناخت کریں اور انہیں حل کریں۔
اہم نکات
- ایک ہی اسپریڈشیٹ میں متعدد ٹیبلز کے استعمال سے گریز کریں۔
- ڈیٹا کو متعدد ٹیبز پر پھیلانے سے گریز کریں۔
- صفر کو صفر کے طور پر درج کریں۔
- غیر موجود ڈیٹا کو درج کرنے کے لیے ایک مناسب نل ویلیو استعمال کریں۔
- معلومات پہنچانے یا اپنے اسپریڈشیٹ کو خوبصورت بنانے کے لیے فارمیٹنگ استعمال نہ کریں۔
- تبصرے ایک علیحدہ کالم میں رکھیں۔
- کالم کے سرخیوں میں اکائیوں کو درج کریں۔
- ایک سیل میں صرف ایک معلومات شامل کریں۔
- کالم کے سرخیوں میں خالی جگہوں، اعداد اور خصوصی حروف سے گریز کریں۔
- اپنے ڈیٹا میں خصوصی حروف سے گریز کریں۔
- میٹا ڈیٹا کو ایک علیحدہ پلین ٹیکسٹ فائل میں درج کریں۔
اپنے ڈیٹا کے ساتھ ساتھ تعاون کرنے والوں یا انٹرنیٹ سے حاصل کردہ ڈیٹا میں بھی کچھ ممکنہ غلطیوں کے بارے میں خبردار رہنے کی ضرورت ہے۔ اگر آپ ان غلطیوں اور آنے والے ڈیٹا تجزیے اور نتائج کی تشریح پر ان کے ممکنہ منفی اثرات سے واقف ہیں، تو یہ آپ کو اور آپ کے پروجیکٹ ممبران کو ان سے بچنے کی کوشش کرنے کے لیے ترغیب دے سکتا ہے۔ اسپریڈشیٹس میں اپنے ڈیٹا کو فارمیٹ کرنے کے طریقے میں معمولی تبدیلیاں کرنے سے ڈیٹا کی صفائی اور تجزیے کے حوالے سے کارکردگی اور بھروسہ مندی پر گہرا اثر پڑ سکتا ہے۔
- ایک سے زیادہ ٹیبلز کا استعمال
- ایک سے زیادہ ٹیبز کا استعمال
- صفر کو پُر نہ کرنا
- مسئلہ پیدا کرنے والی نل ویلیوز کا استعمال
- معلومات پہنچانے کے لیے فارمیٹنگ کا استعمال
- ڈیٹا شیٹ کو خوبصورت بنانے کے لیے فارمیٹنگ کا استعمال
- سیلز میں تبصرے یا یونٹس شامل کرنا
- ایک سیل میں ایک سے زیادہ معلومات درج کرنا
- مسئلہ پیدا کرنے والے فیلڈ ناموں کا استعمال
- ڈیٹا میں خصوصی حروف کا استعمال
- ڈیٹا ٹیبل میں میٹا ڈیٹا کی شمولیت
ایک سے زیادہ ٹیبلز کا استعمال
ایک عام طریقہ کار یہ ہے کہ ایک ہی اسپریڈشیٹ میں متعدد ڈیٹا ٹیبلز بنائے جائیں۔ یہ کمپیوٹر کو الجھن میں ڈال دیتا ہے، اس لیے ایسا نہ کریں! جب آپ ایک ہی اسپریڈشیٹ میں متعدد ٹیبلز بناتے ہیں، تو آپ کمپیوٹر کے لیے چیزوں کے درمیان غلط تعلقات قائم کر رہے ہوتے ہیں، کیونکہ کمپیوٹر ہر قطار کو ایک مشاہدے کے طور پر دیکھتا ہے۔ آپ ممکنہ طور پر ایک ہی فیلڈ کا نام متعدد جگہوں پر استعمال کر رہے ہوں گے، جس سے آپ کے ڈیٹا کو قابلِ استعمال شکل میں ترتیب دینا مشکل ہو جائے گا۔ نیچے دیا گیا مثال اس مسئلے کی وضاحت کرتا ہے:
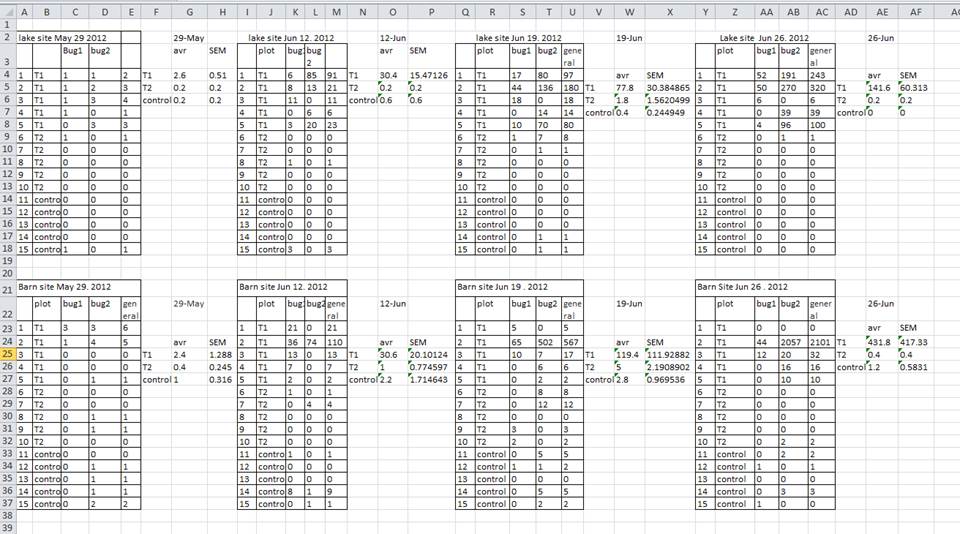
مندرجہ بالا مثال میں، کمپیوٹر (مثال کے طور پر) قطار 4 کو دیکھے گا اور یہ فرض کرے گا کہ تمام کالمز A-AF ایک ہی نمونے کی طرف اشارہ کرتے ہیں۔ یہ قطار دراصل چار الگ الگ نمونوں (چار مختلف جمع کرنے کی تاریخوں — 29 مئی، 12 جون، 19 جون، اور 26 جون — کے لیے ہر ایک کا نمونہ 1) کی نمائندگی کرتی ہے، نیز ان میں سے دو نمونوں کے لیے کچھ حساب کیے گئے خلاصہ اعداد و شمار (ایک اوسط (avr) اور پیمائش کی معیاری غلطی (SEM)) بھی پیش کرتی ہے۔ دیگر قطاریں بھی اسی طرح مسئلہ پیدا کرتی ہیں۔
متعدد ٹیبز کا استعمال
لیکن ورک بک ٹیبز کا کیا ہوگا؟ ڈیٹا کو ترتیب دینے کا یہ ایک آسان طریقہ لگتا ہے، ہے نا؟ خیر، ہاں اور نہیں۔ جب آپ اضافی ٹیبز بناتے ہیں، تو آپ کمپیوٹر کو ڈیٹا میں موجود تعلقات دیکھنے کے موقع سے محروم کر دیتے ہیں (اس تعلق کو یقینی بنانے کے لیے آپ کو اسپریڈشیٹ ایپلی کیشن کے مخصوص فنکشنز یا اسکرپٹنگ کا استعمال کرنا پڑتا ہے)۔ مثال کے طور پر، فرض کریں کہ آپ ہر اس دن کے لیے ایک الگ ٹیب بناتے ہیں جب آپ پیمائش کرتے ہیں۔
یہ دو وجوہات کی بنا پر ایک بہتر طریقہ کار نہیں ہے:
آپ کے ڈیٹا میں غلطی سے تضادات شامل کرنے کا امکان زیادہ ہو جاتا ہے اگر ہر بار جب آپ کوئی پیمائش کریں، تو ڈیٹا کو ایک نئے ٹیب میں ریکارڈ کرنا شروع کر دیں، اور
چاہے آپ تمام تضادات کو ختم کرنے میں کامیاب ہی کیوں نہ ہوں، ڈیٹا کا تجزیہ کرنے سے پہلے آپ کو ایک اضافی مرحلہ اختیار کرنا پڑے گا کیونکہ آپ کو ان ڈیٹا کو ایک ہی ڈیٹا ٹیبل میں یکجا کرنا ہوگا۔ آپ کو کمپیوٹر کو واضح طور پر بتانا ہوگا کہ ٹیبز کو کیسے یکجا کیا جائے - اور اگر ٹیبز کی فارمیٹنگ غیر یکساں ہو، تو شاید آپ کو یہ کام دستی طور پر بھی کرنا پڑے۔
اگلی بار جب آپ ڈیٹا درج کر رہے ہوں گے اور کوئی اور ٹیب یا ٹیبل بنانے جائیں گے، تو خود سے پوچھیں کہ کیا آپ اپنے اصل اسپریڈشیٹ میں ایک اور کالم شامل کر کے اس ٹیب کو شامل کرنے سے بچ سکتے ہیں۔ ہم نے ایک بے ترتیب ڈیٹا فائل کی مثال میں متعدد ٹیبز استعمال کیے تھے، لیکن اب آپ نے دیکھا ہے کہ آپ اپنے ڈیٹا کو کس طرح دوبارہ ترتیب دے کر مختلف ٹیبز میں یکجا کر سکتے ہیں۔
تجربے کے دوران آپ کی ڈیٹا شیٹ بہت طویل ہو سکتی ہے۔ اگر آپ کو اسپریڈشیٹ کے اوپری حصے میں اپنے ہیڈرز نظر نہ آئیں، تو ڈیٹا درج کرنا مشکل ہو جاتا ہے۔ لیکن اپنی ہیڈر رو کو دہرائیں مت۔ یہ آسانی سے ڈیٹا میں شامل ہو سکتے ہیں، جس سے مستقبل میں مسائل پیدا ہو سکتے ہیں۔ اس کے بجائے، آپ کالم ہیڈرز کو فریز کر سکتے ہیں تاکہ وہ اس وقت بھی نظر آتے رہیں جب آپ کے پاس بہت سی قطاروں والی اسپریڈشیٹ ہو۔
صفر کو پُر نہ کرنا
ہو سکتا ہے کہ جب آپ کسی چیز کی پیمائش کر رہے ہوں، تو وہ عام طور پر صفر ہو، مثال کے طور پر سروے میں ایک خرگوش کے مشاہدہ کی تعداد۔ جب اس کالم میں زیادہ تر صفر ہوں، تو اس میں صفر کا نمبر لکھنے کی ضرورت کیا ہے؟
تاہم، اسپریڈشیٹ میں صفر اور خالی سیل کے درمیان فرق ہوتا ہے۔ کمپیوٹر کے لیے، صفر دراصل ڈیٹا ہوتا ہے۔ آپ نے اسے ناپا یا گنا ہے۔ ایک خالی سیل کا مطلب ہے کہ اسے ناپا نہیں گیا اور کمپیوٹر اسے ایک نامعلوم ویلیو (جسے نل یا مسڈ ویلیو بھی کہا جاتا ہے) کے طور پر تشریح کرے گا۔
اسپریڈشیٹس یا شماریاتی پروگرامز غالباً ان خالی خلیات کو غلط طور پر سمجھ لیں گے جنہیں آپ صفر رکھنے کا ارادہ رکھتے ہیں۔ اپنے مشاہدے کی ویلیو درج نہ کر کے، آپ اپنے کمپیوٹر کو یہ بتاتے ہیں کہ اس ڈیٹا کو نامعلوم یا غائب (null) کے طور پر ظاہر کرے۔ اس سے بعد کے حسابات یا تجزیوں میں مسائل پیدا ہو سکتے ہیں۔ مثال کے طور پر، اعداد کے ایک سیٹ کی اوسط جس میں ایک غیر معلوم ویلیو شامل ہو، ہمیشہ غیر معلوم ہوتی ہے (کیونکہ کمپیوٹر غائب مشاہدات کی ویلیو کا اندازہ نہیں لگا سکتا)۔ اسی وجہ سے، صفر کو صفر کے طور پر اور واقعی غائب ڈیٹا کو غیر معلوم (nulls) کے طور پر ریکارڈ کرنا بہت ضروری ہے۔
مسئلہ پیدا کرنے والی نل ویلیوزکا استعمال
مثال: غائب ڈیٹا کی نمائندگی کے لیے -999 یا دیگر عددی اقدار (یا صفر) کا استعمال کرنا۔
حل:
ڈیٹا سیٹ کے اندر نل ویلیوز (null values) کو مختلف طریقوں سے ظاہر کرنے کی چند وجوہات ہوتی ہیں۔ کبھی کبھی پیمائشی آلے سے پریشان کن نل ویلیوز خود بخود ریکارڈ ہو جاتی ہیں۔ اگر ایسا ہے، تو آپ کے پاس زیادہ کچھ کرنے کو نہیں ہوتا، لیکن تجزیے سے پہلے OpenRefine جیسے ٹول کے ذریعے ڈیٹا کی صفائی (data cleaning) میں اس کا حل نکالا جا سکتا ہے۔ دیگر اوقات میں، ڈیٹا کی عدم موجودگی کی مختلف وجوہات بیان کرنے کے لیے مختلف نل ویلیوز استعمال کی جاتی ہیں۔ یہ ریکارڈ کرنے کے قابل اہم معلومات ہیں، لیکن اس کا مطلب دراصل ایک کالم کو دو معلومات ریکارڈ کرنے کے لیے استعمال کرنا ہے۔ جیسا کہ معلومات پہنچانے کے لیے فارمیٹنگ کا استعمال کرنے کی صورت میں ہوتا ہے، یہاں بھی ‘data_missing’ جیسا ایک نیا کالم بنانا اور اس کالم کو مختلف وجوہات ریکارڈ کرنے کے لیے استعمال کرنا بہتر رہے گا۔
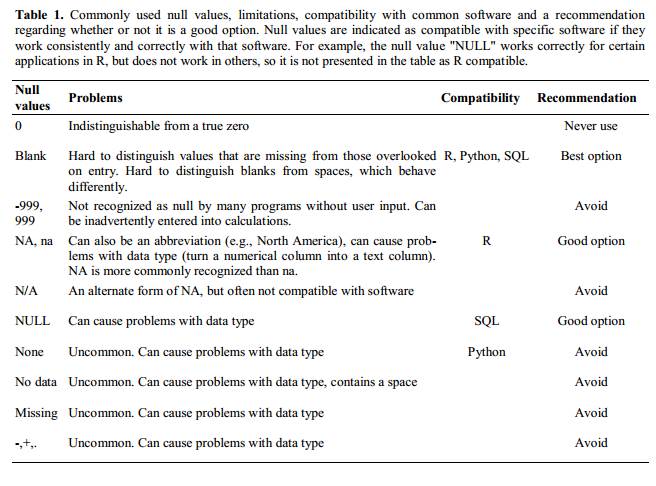
وجہ جو بھی ہو، یہ ایک مسئلہ ہے اگر نامعلوم یا غائب ڈیٹا کو -999، 999، یا 0 کے طور پر ریکارڈ کیا جائے۔
بہت سے شماریاتی پروگرامز یہ پہچاننے میں ناکام رہیں گے کہ ان کا مقصد غائب (null) ویلیوز کی نمائندگی کرنا ہے۔ ان ویلیوز کی تشریح اس سافٹ ویئر پر منحصر ہوگی جسے آپ اپنے ڈیٹا کے تجزیے کے لیے استعمال کرتے ہیں۔ ایک واضح طور پر متعین اور مستقل نل انڈیکیٹر کا استعمال کرنا ضروری ہے۔
خالی جگہیں (زیادہ تر ایپلی کیشنز) اور NA (R کے لیے) اچھے انتخاب ہیں۔ White et al. (2013) اپنے مضمون میں مختلف سافٹ ویئر ایپلی کیشنز کے لیے نل ویلیوز کی نشاندہی کے موزوں انتخاب کی وضاحت کرتے ہیں:
معلومات پہنچانے کے لیے فارمیٹنگ کا استعمال
مثال: ان سیلز، قطاروں یا کالموں کو نمایاں کرنا جنہیں تجزیے سے خارج کیا جانا چاہیے، اور ڈیٹا میں تقسیم کو ظاہر کرنے کے لیے خالی قطاریں چھوڑنا۔
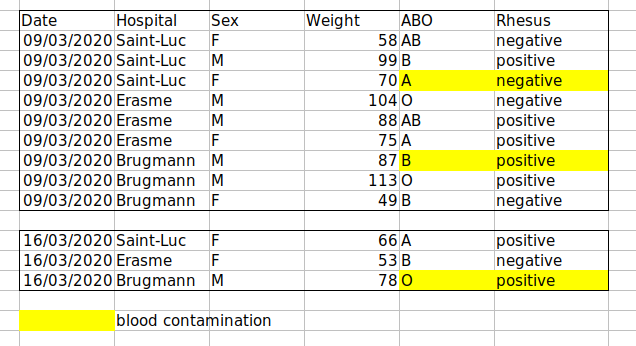
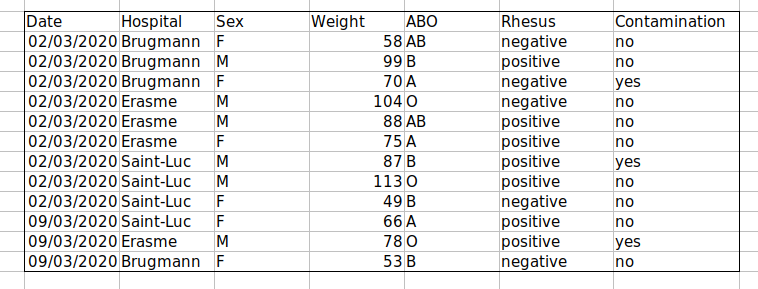
حل: ایک نیا فیلڈ بنائیں تاکہ یہ کوڈ کیا جا سکے کہ کون سا ڈیٹا خارج کیا جانا چاہیے۔
ڈیٹا شیٹ کو خوبصورت بنانے کے لیے فارمیٹنگ کا استعمال
مثال: سیلز کو یکجا کرنا۔
حل: اگر آپ احتیاط نہیں کریں گے، تو ورکشیٹ کو زیادہ خوبصورت بنانے کے لیے فارمیٹنگ کرنے سے آپ کے کمپیوٹر کی ڈیٹا میں تعلقات دیکھنے کی صلاحیت متاثر ہو سکتی ہے۔ مرجڈ سیلز آپ کے ڈیٹا کو شماریاتی سافٹ ویئر کے لیے ناقابلِ پڑھنے بنا دیں گے۔ اپنے ڈیٹا کی دوبارہ ترتیب پر غور کریں تاکہ ڈیٹا کو منظم کرنے کے لیے آپ کو سیلز مرج کرنے کی ضرورت نہ پڑے۔
سیلز میں تبصرے یا یونٹس شامل کرنا
زیادہ تر تجزیاتی سافٹ ویئر Excel یا LibreOffice کے کمنٹس کو نہیں پہچان سکتے، اور ڈیٹا کے سیلز میں رکھے گئے کمنٹس سے الجھ سکتے ہیں۔ فارمیٹنگ کے حوالے سے اوپر بیان کیے گئے طریقے کے مطابق، اگر آپ کو سیلز میں نوٹس شامل کرنے کی ضرورت ہو تو ایک الگ فیلڈ بنائیں۔ اسی طرح، سیلز میں یونٹس شامل نہ کریں: مثالی طور پر، ایک کالم میں رکھے گئے تمام پیمائشی اقدار ایک ہی یونٹ میں ہونی چاہئیں، لیکن اگر کسی وجہ سے وہ ایک ہی نہیں ہیں، تو ایک الگ فیلڈ بنائیں اور اس سیل کے یونٹ کی وضاحت کریں۔
ایک سیل میں ایک سے زیادہ معلومات درج کرنا
مثال: ایک ہی سیل میں ABO اور Rhesus گروپس کو درج کرنا، جیسے کہ A+، B+، A-، …
حل: ایک سیل میں ایک سے زیادہ معلومات شامل نہ کریں۔ ایک سیل میں معلومات کے کئی حصے رکھنے سے ڈیٹا کا تجزیہ کرنے کے طریقے محدود ہو جاتے ہیں۔ اگر آپ کو ان دونوں پیمائشوں کی ضرورت ہے، تو اپنی ڈیٹا شیٹ کو اس طرح ڈیزائن کریں کہ اس میں یہ معلومات شامل ہوں۔ مثال کے طور پر، ABO گروپ کے لیے ایک کالم اور Rhesus گروپ کے لیے ایک کالم شامل کریں۔
مسئلہ پیدا کرنے والے فیلڈ ناموں کا استعمال
فیلڈز کے لیے وضاحتی نام منتخب کریں، لیکن اس بات کا خیال رکھیں کہ ان میں کسی بھی قسم کے خالی جگہ، نمبر یا خصوصی حروف شامل نہ ہوں۔ خالی جگہوں کو ان پارسرز غلط سمجھ سکتے ہیں جو وائٹ اسپیس کو ڈیلیمیٹر کے طور پر استعمال کرتے ہیں، اور کچھ پروگرامز ایسے فیلڈ نام پسند نہیں کرتے جو نمبروں سے شروع ہونے والے ٹیکسٹ اسٹرنگز ہوں۔
انڈر اسکورز (_) سپیسز کا ایک اچھا متبادل ہیں۔ پڑھنے میں
آسانی کے لیے ناموں کو کیمل کیس (camel case) میں لکھنے پر غور کریں (جیسے
کہ: ExampleFileName)۔ یاد رکھیں کہ وہ مخففات جو اس وقت معنی رکھتے ہیں،
شاید 6 ماہ بعد اتنے واضح نہ رہیں، لیکن ناموں کو حد سے زیادہ طویل نہ
کریں۔ فیلڈ کے ناموں میں اکائیوں (units) کو شامل کرنے سے الجھن سے بچا جا
سکتا ہے اور دوسرے لوگ آپ کے فیلڈز کی آسانی سے تشریح کر سکتے ہیں۔
مثالیں
| اچھا نام | بہتر متبادل | سے گریز کریں |
|---|---|---|
| Max_temp_C | MaxTemp | Maximum Temp (°C) |
| Precipitation_mm | Precipitation | precmm |
| Mean_year_growth | MeanYearGrowth | Mean growth/year |
| sex | sex | M/F |
| weight | weight | w. |
| cell_type | CellType | Cell Type |
| Observation_01 | first_observation | 1st Obs |
ڈیٹا میں خصوصی حروف کا استعمال
مثال: آپ نوٹس لکھتے وقت اپنے اسپریڈشیٹ پروگرام کو ورڈ پروسیسر کے طور پر استعمال کرتے ہیں، مثال کے طور پر Word یا دیگر ایپلی کیشنز سے براہِ راست ڈیٹا کاپی کرتے ہیں۔
حل: یہ ایک عام طریقہ کار ہے۔ مثال کے طور پر، جب کسی سیل میں طویل متن لکھا جاتا ہے، تو لوگ اکثر اپنے اسپریڈشیٹ میں لائن بریکس، ایم-ڈیشز وغیرہ شامل کر دیتے ہیں۔ مزید برآں، Word جیسی ایپلی کیشنز سے ڈیٹا کاپی کرتے وقت، فارمیٹنگ اور غیر معیاری خصوصی حروف (جیسے بائیں اور دائیں جانب ترتیب دیے گئے کوٹیشن مارکس) شامل ہو جاتے ہیں۔ جب اس ڈیٹا کو کوڈنگ/سٹیٹسٹیکل ماحول یا ایک ریلیشنل ڈیٹا بیس میں ایکسپورٹ کیا جاتا ہے، تو خطوط کے آدھے ہونے اور انکوڈنگ کی غلطیوں کے پیدا ہونے جیسے خطرناک واقعات پیش آ سکتے ہیں۔
عمومی بہترین طریقہ کار یہ ہے کہ نیو لائنز، ٹیبز اور ورٹیکل ٹیبز جیسے حروف شامل کرنے سے گریز کیا جائے۔ دوسرے الفاظ میں، ایک ٹیکسٹ سیل کو اس طرح سمجھیں جیسے کہ وہ ایک سادہ ویب فارم ہو جو صرف ٹیکسٹ اور سپیسز کا حامل ہو سکے۔
ڈیٹا ٹیبل میں میٹا ڈیٹا کی شمولیت
مثال: آپ اپنے ڈیٹا ٹیبل کے اوپر یا نیچے ایک لیجنڈ شامل کرتے ہیں جس میں کالموں کے معنی، اکائیوں، استثنیٰ وغیرہ کی وضاحت کی جاتی ہے۔
حل: اپنے ڈیٹا کے بارے میں معلومات (“میٹا ڈیٹا”) درج کرنا ضروری ہے۔ ڈیٹا کو جمع کرنے اور اس کا تجزیہ کرنے کے دوران آپ اپنے ڈیٹا سیٹ سے مکمل طور پر واقف ہو سکتے ہیں، لیکن اس بات کا امکان کہ آپ چند مہینوں، ایک سال یا اس سے زیادہ عرصے بعد بھی یاد رکھیں گے کہ مثال کے طور پر، متغیر “sglmemgp” کا مطلب گروپ کا واحد رکن ہے، یا کسی متغیر کو تبدیل کرنے یا ایک مشتقہ متغیر بنانے کے لیے آپ نے جو درست الگورتھم استعمال کیا، اس کا امکان بہت کم ہے۔
مزید برآں، ایسی بہت سی وجوہات ہو سکتی ہیں جن کی بنا پر دوسرے لوگ آپ کے ڈیٹا کا جائزہ لینا یا اسے استعمال کرنا چاہیں گے—آپ کے نتائج کو سمجھنے، ان کی تصدیق کرنے، آپ کی جمع کرائی گئی اشاعت کا جائزہ لینے، آپ کے نتائج کو دوہرا کرنے، ایک ملتی جلتی تحقیق کا ڈیزائن تیار کرنے، یا یہاں تک کہ دوسروں کی رسائی اور دوبارہ استعمال کے لیے اپنے ڈیٹا کو آرکائیو کرنے کے لیے۔ اگرچہ ڈیجیٹل ڈیٹا تعریف کے مطابق مشین کے ذریعے پڑھے جا سکتے ہیں، لیکن ان کے معنی کو سمجھنا انسانوں کا کام ہے۔ آپ کی تحقیق کے اکٹھا کرنے اور تجزیے کے مرحلے کے دوران اپنے ڈیٹا کی دستاویز سازی کی اہمیت کو کبھی بھی کم نہیں سمجھا جا سکتا، خاص طور پر اگر آپ کی تحقیق علمی ریکارڈ کا حصہ بننے والی ہو۔
تاہم، میٹا ڈیٹا کو خود ڈیٹا فائل میں شامل نہیں کیا جانا چاہیے۔ ایک مقالے کے ٹیبل یا اضافی فائل کے برعکس، میٹا ڈیٹا (لیجنڈز کی شکل میں) کو ڈیٹا فائل میں شامل نہیں کیا جانا چاہیے کیونکہ یہ معلومات ڈیٹا نہیں ہیں، اور اسے شامل کرنے سے کمپیوٹر پروگراموں کے ذریعے آپ کی ڈیٹا فائل کی تشریح کے طریقے میں خلل پڑ سکتا ہے۔ اس کے بجائے، میٹا ڈیٹا کو آپ کی ڈیٹا فائل کے اسی ڈائریکٹری میں ایک علیحدہ فائل کے طور پر محفوظ کیا جانا چاہیے، ترجیحاً پلین ٹیکسٹ فارمیٹ میں ایک ایسے نام کے ساتھ جس سے اس کا تعلق آپ کی ڈیٹا فائل سے واضح طور پر ظاہر ہو۔ چونکہ میٹا ڈیٹا فائلیں فری ٹیکسٹ فارمیٹ میں ہوتی ہیں، اس لیے یہ آپ کو تبصرے، یونٹس، اور اس بارے میں معلومات کو انکوڈ کرنے کی اجازت بھی دیتی ہیں کہ نل ویلیوز کو کس طرح انکوڈ کیا جاتا ہے، وغیرہ، جو دستاویز کرنے کے لیے اہم ہوتے ہیں لیکن آپ کی ڈیٹا فائل کی فارمیٹنگ میں خلل پیدا کر سکتے ہیں۔
مزید برآں، فائل یا ڈیٹا بیس کی سطح کا میٹا ڈیٹا یہ بیان کرتا ہے کہ ڈیٹا سیٹ کو تشکیل دینے والی فائلیں ایک دوسرے سے کیسے جڑی ہوئی ہیں؛ وہ کس فارمیٹ میں ہیں؛ اور آیا وہ سابقہ فائلوں کی جگہ لیتی ہیں یا سابقہ فائلیں ان کی جگہ لیتی ہیں۔ فولڈر کی سطح کی readme.txt فائل کسی پروجیکٹ میں تمام فائلوں اور فولڈرز کا حساب رکھنے کا ایک روایتی طریقہ ہے۔
(میٹا ڈیٹا سے متعلق متن EDINA اور یونیورسٹی آف ایڈنبرہ کی ڈیٹا لائبریری کے آن لائن کورس Research Data MANTRA سے لیا گیا ہے۔ MANTRA کو Creative Commons Attribution 4.0 International License کے تحت لائسنس دیا گیا ہے۔)
ڈیٹا کی ایکسپورٹنگ
سوال
- ہم اسپریڈشیٹس سے ڈیٹا کو اس طرح ایکسپورٹ کیسے کر سکتے ہیں جو آنے والی ایپلی کیشنز کے لیے مفید ہو؟
اہداف
- اسپریڈشیٹ ڈیٹا کو یونیورسل فائل فارمیٹس میں محفوظ کریں۔
- اسپریڈشیٹ سے ڈیٹا کو CSV فائل میں ایکسپورٹ کریں۔
اہم نکات
عام اسپریڈشیٹ فارمیٹس میں محفوظ ڈیٹا اکثر ڈیٹا تجزیے کے سافٹ ویئر میں درست طریقے سے پڑھا نہیں جاتا، جس سے آپ کے ڈیٹا میں غلطیاں پیدا ہو جاتی ہیں۔
اسپریڈشیٹس سے ڈیٹا کو CSV یا TSV جیسے فارمیٹس میں ایکسپورٹ کرنے سے وہ ایک ایسے فارمیٹ میں آ جاتا ہے جسے زیادہ تر پروگرامز مستقل طور پر استعمال کر سکتے ہیں۔
اپنے تجزیوں کے لیے استعمال ہونے والے ڈیٹا کو ایکسل کے ڈیفالٹ فائل
فارمیٹ (*.xls یا *.xlsx - ایکسل کے ورژن کے
لحاظ سے) میں محفوظ کرنا ایک اچھا خیال نہیں ہے۔ کیوں؟
کیونکہ یہ ایک پراپرائٹری فارمیٹ ہے، اور یہ ممکن ہے کہ مستقبل میں فائل کھولنے کی ٹیکنالوجی موجود نہیں ہوگی (یا بہت نایاب ہو جائے گی) جس سے اسے کھولنا ناممکن یا کم از کم دشوار ہو جائے گا۔
دیگر اسپریڈشیٹ سافٹ ویئر شاید پراپرائٹری ایکسل فارمیٹ میں محفوظ فائلوں کو کھولنے کے قابل نہ ہوں۔
ایکسل کے مختلف ورژنز ڈیٹا کو مختلف طریقوں سے ہینڈل کر سکتے ہیں، جس سے تضادات پیدا ہو سکتے ہیں۔ Dates ڈیٹا اسٹوریج میں تضادات کی ایک اچھی طرح دستاویزی شکل ہے۔
آخر میں، زیادہ جریدے اور گرانٹ ایجنسیاں آپ سے اپنے ڈیٹا کو ایک ڈیٹا ریپوزٹری میں جمع کروانے کا مطالبہ کر رہی ہیں، اور ان میں سے زیادہ تر ایکسل فارمیٹ قبول نہیں کرتیں۔ اسے نیچے زیرِ بحث فارمیٹس میں سے کسی ایک میں ہونا ضروری ہے۔
مندرجہ بالا نکات دیگر فارمیٹس پر بھی لاگو ہوتے ہیں، جیسے کہ LibreOffice / Open Office کے استعمال کردہ اوپن ڈیٹا فارمیٹس۔ یہ فارمیٹس ساکن نہیں ہوتے اور مختلف سافٹ ویئر پیکیجز انہیں ایک ہی طریقے سے پارس نہیں کرتے۔
ڈیٹا کو ایک عالمگیر، کھلا اور ساکن فارمیٹ میں محفوظ کرنے سے اس مسئلے سے نمٹنے میں مدد ملے گی۔ ٹیب-ڈیلیمیٹڈ (tab separated values یا TSV) یا کوما-ڈیلیمیٹڈ (comma separated values یا CSV) فارمیٹ آزما کر دیکھیں۔ CSV فائلیں سادہ ٹیکسٹ فائلیں ہوتی ہیں جہاں کالموں کو کوموں سے الگ کیا جاتا ہے، اسی لیے انہیں ‘کوما سیپریٹڈ ویلیوز’ یا CSV کہا جاتا ہے۔ Excel/SPSS/وغیرہ کی فائلوں کے مقابلے میں CSV فائل کا فائدہ یہ ہے کہ ہم تقریباً کسی بھی سافٹ ویئر کے ذریعے CSV فائل کھول اور پڑھ سکتے ہیں، بشمول سادہ ٹیکسٹ ایڈیٹرز جیسے کہ TextEdit یا NotePad۔ CSV فائل میں موجود ڈیٹا کو دیگر فارمیٹس اور ماحولوں، جیسے کہ SQLite اور R میں بھی آسانی سے امپورٹ کیا جا سکتا ہے۔ جب ہم CSV فائلوں کے ساتھ کام کرتے ہیں تو ہم کسی مہنگے پروگرام کے کسی مخصوص ورژن سے جڑے نہیں ہوتے، اس لیے زیادہ سے زیادہ پورٹیبلٹی اور اینڈورنس کے لیے یہ ایک بہترین فارمیٹ ہے۔ زیادہ تر اسپریڈشیٹ پروگرامز CSV جیسے ڈیلیمیٹڈ ٹیکسٹ فارمیٹس میں آسانی سے محفوظ کر سکتے ہیں، اگرچہ فائل ایکسپورٹ کے دوران وہ آپ کو ایک وارننگ دے سکتے ہیں۔
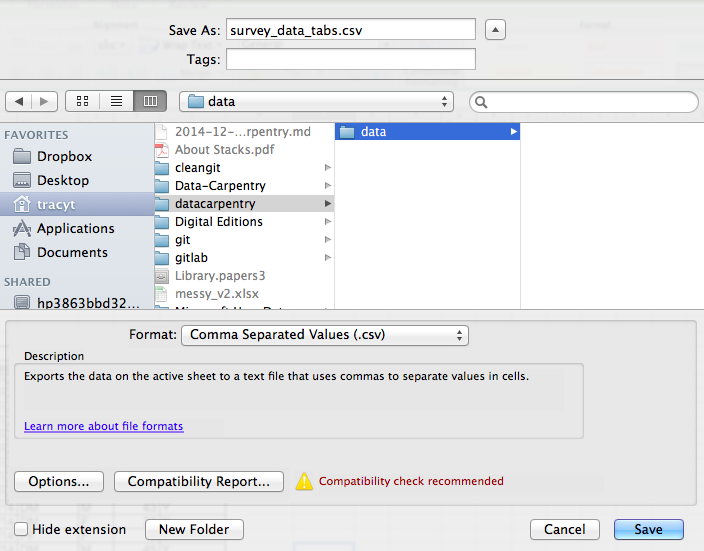
ایکسل میں کھولے ہوئے فائل کو CSV فارمیٹ میں محفوظ کرنے کے لیے:
- اوپر والے مینو سے ‘File’ اور ‘Save as’ منتخب کریں۔
- ‘Format’ فیلڈ میں، فہرست سے ‘Comma Separated Values’
(
*.csv) منتخب کریں۔ - فائل کے نام اور اس مقام کی دوبارہ تصدیق کریں جہاں آپ اسے محفوظ کرنا چاہتے ہیں اور ‘Save’ پر کلک کریں۔
بیک ورڈ کمپیٹیبلٹی کے لیے ایک اہم نوٹ: آپ CSV فائلوں کو Excel میں کھول سکتے ہیں!
R اور xls کے بارے میں ایک نوٹ: ایسے R
پیکیجز موجود ہیں جو xls فائلوں (نیز گوگل اسپریڈشیٹس) کو پڑھ
سکتے ہیں۔ یہاں تک کہ xls دستاویزات میں مختلف ورک شیٹس تک
رسائی حاصل کرنا بھی ممکن ہے۔
لیکن
- ان میں سے کچھ صرف ونڈوز پر کام کرتے ہیں۔
- اس کا مطلب
csvکے لیے ایک (سادہ مگر دستی) ایکسپورٹ کو ڈیٹا تجزیہ کے R کوڈ میں اضافی پیچیدگی/وابستگیوں سے تبدیل کرنا ہے۔ - ڈیٹا فارمیٹنگ کے بہترین طریقہ کار اب بھی لاگو ہوتے ہیں۔
- کیا واقعی کوئی ٹھوس وجہ ہے کہ
csv(یا اس جیسا کوئی اور) کافی نہیں ہے؟
کوموں کے حوالے سے احتیاطی تدابیر
کچھ ڈیٹا سیٹس میں، ڈیٹا کی اقدار میں خود کومے (,) شامل ہو سکتے ہیں۔ ایسی صورت میں، آپ کے استعمال کردہ سافٹ ویئر (بشمول Excel) غالباً ڈیٹا کو غلط طریقے سے کالموں میں ظاہر کرے گا۔ اس کی وجہ یہ ہے کہ ڈیٹا کی اقدار کا حصہ بننے والے کومے کو ڈیلیمیٹرز کے طور پر سمجھا جائے گا۔
مثال کے طور پر، ہمارا ڈیٹا کچھ اس طرح ہو سکتا ہے:
species_id,genus,species,taxa
AB,Amphispiza,bilineata,Bird
AH,Ammospermophilus,harrisi,Rodent, not censused
AS,Ammodramus,savannarum,Bird
BA,Baiomys,taylori,Rodent
ریکارڈ AH,Ammospermophilus,harrisi,Rodent, not censused
میں taxa کی ویلیو میں کوما
(Rodent, not censused) شامل ہے۔ اگر ہم مذکورہ بالا کو ایکسل
(یا کسی دوسرے اسپریڈشیٹ پروگرام) میں پڑھنے کی کوشش کریں گے، تو ہمیں کچھ
اس طرح کی چیز ملے گی:
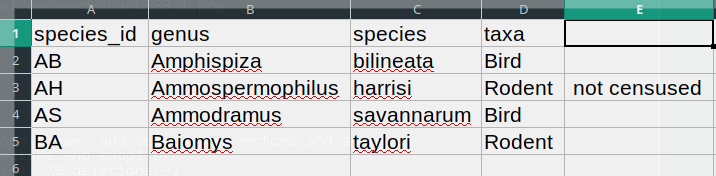
taxa کی ویلیو کو دو کالموں میں تقسیم کر دیا گیا (بجائے
اس کے کہ اسے ایک کالم D میں رکھا جائے)۔ یہ کئی مزید غلطیوں
کا سبب بن سکتا ہے۔ مثال کے طور پر، اس اضافی کالم کو ایسے کالم کے طور پر
سمجھا جائے گا جس میں بہت سی غیر موجود ویلیوز ہوں (اور جس میں کوئی مناسب
ہیڈر نہ ہو)۔ اس کے علاوہ، قطار 3 کے ریکارڈ کے لیے کالم D
میں موجود ویلیو (یعنی وہ ریکارڈ جہاں ‘taxa’ کی ویلیو میں کوما تھا) اب
غلط ہے۔
اگر آپ اپنا ڈیٹا csv فارمیٹ میں محفوظ کرنا چاہتے ہیں اور
یہ توقع رکھتے ہیں کہ آپ کے ڈیٹا کی اقدار میں کومے ہو سکتے ہیں، تو آپ
اقدار کو واوین (““) میں رکھ کر اوپر بحث کی گئی مسئلے سے بچ سکتے ہیں۔ اس
قاعدے کو لاگو کرتے ہوئے، ہمارا ڈیٹا کچھ اس طرح نظر آ سکتا ہے:
species_id,genus,species,taxa
"AB","Amphispiza","bilineata","Bird"
"AH","Ammospermophilus","harrisi","Rodent, not censused"
"AS","Ammodramus","savannarum","Bird"
"BA","Baiomys","taylori","Rodent"
اب اس فائل کو Excel میں csv کے طور پر کھولنے سے کوئی
اضافی کالم نہیں بنے گا، کیونکہ Excel صرف ان کوموں کو علامت کے طور پر
استعمال کرے گا جو کوٹیشن مارکس کے باہر ہوں گے۔
متبادل طور پر، اگر آپ ایسے ڈیٹا کے ساتھ کام کر رہے ہیں جس میں کومے شامل ہیں، تو اسپریڈشیٹ میں کام کرتے وقت آپ کو غالباً کسی دوسرے ڈیلیمیٹر کا استعمال کرنے کی ضرورت ہوگی1۔ اس صورت میں، اپنے ڈیلیمیٹر کے طور پر ٹیبز کے استعمال اور TSV فائلوں کے ساتھ کام کرنے پر غور کریں۔ TSV فائلوں کو اسپریڈشیٹ پروگراموں سے بالکل اسی طرح ایکسپورٹ کیا جا سکتا ہے جیسے CSV فائلوں کو کیا جاتا ہے۔
اگر آپ ایک پہلے سے موجود ڈیٹا سیٹ کے ساتھ کام کر رہے ہیں جس میں ڈیٹا کی اقدار “” میں شامل نہیں ہیں لیکن کومے ڈیلیمیٹرز اور ڈیٹا کی اقدار کے حصوں، دونوں کے طور پر استعمال ہو رہے ہیں، تو آپ ڈیٹا کی صفائی کے حوالے سے ایک بڑے مسئلے کا سامنا کر رہے ہوں گے۔ اگر جس ڈیٹا سیٹ کے ساتھ آپ کام کر رہے ہیں اس میں سینکڑوں یا ہزاروں ریکارڈز شامل ہیں، تو انہیں دستی طور پر صاف کرنے میں (یا تو ڈیٹا کی اقدار سے کومے ہٹانے کے ذریعے یا اقدار کو واوین میں رکھنے کے ذریعے - ““) نہ صرف گھنٹوں اور گھنٹے لگیں گے بلکہ اس کے نتیجے میں آپ غلطی سے بہت سی غلطیاں شامل کر سکتے ہیں۔
ڈیٹا سیٹس کی صفائی کرنا کئی سائنسی شعبوں میں بڑے مسائل میں سے ایک ہے۔ اس کا طریقہ کار تقریباً ہمیشہ مخصوص سیاق و سباق پر منحصر ہوتا ہے۔ تاہم، ڈیٹا کو خودکار طریقے سے صاف کرنا ایک بہتر طریقہ کار ہے، مثال کے طور پر ایک اسکرپٹ لکھ کر اور اسے چلا کر۔ پائتھن اور R کے اسباق آپ کو متعلقہ اسکرپٹس بنانے کی مہارتیں پیدا کرنے کے لیے بنیاد فراہم کریں گے۔
خلاصہ
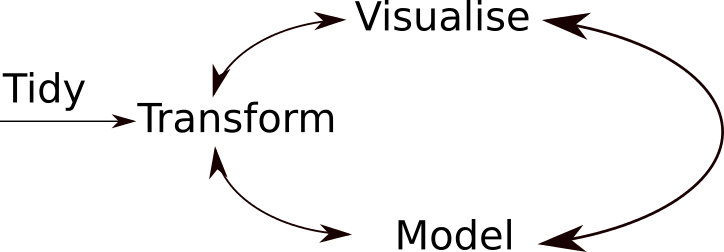
ڈیٹا تجزیے کا ایک معمول کا ورک فلو اعلیٰ شکل میں دکھایا گیا ہے، جہاں ڈیٹا کو بار بار تبدیل، بصری شکل دی اور ماڈل کیا جاتا ہے۔ یہ عمل کئی بار دہرایا جاتا ہے جب تک کہ ڈیٹا کو سمجھ نہ لیا جائے۔ تاہم، کئی حقیقی صورتحال میں، زیادہ تر وقت ڈیٹا کی تصفیہ اور تیاری میں صرف کیا جاتا ہے، بجائے اس کے کہ اس کا عملی طور پر تجزیہ اور سمجھ بوجھ کیا جائے۔
ڈیٹا کے تبدیلی/بصری شکل دینے/ماڈلنگ کے چکر کے کئی تیز رفتار تکرارات پر مبنی ایک چست ڈیٹا تجزیہ کا ورک فلو صرف اس صورت میں ممکن ہوتا ہے جب ڈیٹا ایک قابلِ پیش گوئی طریقے سے فارمیٹ کیا گیا ہو اور ڈیٹا کو دیکھنے اور/یا اسے درست کرنے کے بغیر اس کے بارے میں استدلال کیا جا سکے۔
- ڈیٹا کی بہترین تنظیم کسی بھی تحقیقی منصوبے کی بنیاد ہوتی ہے۔
یہ بات خاص طور پر ان یورپی ممالک میں اہم ہے جہاں کومہ کو اعشاری علامت کے طور پر استعمال کیا جاتا ہے۔ ایسی صورتوں میں، CSV فائل میں ڈیفالٹ ویلیو سیپریٹر سیمی کولن (;) ہوگا، یا ویلیوز کو منظم طریقے سے کوٹس میں رکھا جائے گا۔↩︎
Content from R اور RStudio
Last updated on 2026-11-11 | Edit this page
Overview
Questions
- R اور RStudio کیا ہیں؟
Objectives
- RStudio کے Script، Console، Environment، اور Plots پینز کے مقصد کی وضاحت کریں۔
- تحقیقات کے ایک مجموعے کے لیے فائلوں اور ڈائریکٹریز کو ایک R پروجیکٹ کے طور پر منظم کریں، اور ورکنگ ڈائریکٹری کے مقصد کو سمجھیں۔
- R فانکشنز کے بارے میں مزید معلومات تلاش کرنے کے لیے RStudio کے بلٹ-ان ہیلپ انٹرفیس کا استعمال کریں۔
- یہ دکھائیں کہ R یوزر کمیونٹی کے ساتھ مسائل کے حل کے لیے کافی معلومات کیسے فراہم کی جائیں۔
یہ ایپیسوڈ Data Carpentries کے Data Analysis and Visualisation in R for Ecologists اسباق پر مبنی ہے۔
R کیا ہے؟ RStudio کیا ہے؟
اصطلاح R کا استعمال پروگرامنگ زبان، شماریاتی کمپیوٹنگ کے لیے ماحول اور اس سافٹ ویئر کے لیے کیا جاتا ہے جو اس کے ذریعے لکھے گئے اسکرپٹس کی تشریح کرتا ہے۔
RStudio فی الحال نہ صرف اپنے R اسکرپٹس لکھنے بلکہ R سافٹ ویئر کے ساتھ تعامل کرنے کا ایک بہت مقبول طریقہ ہے1۔ درست طریقے سے کام کرنے کے لیے، RStudio کو R کی ضرورت ہوتی ہے اور اس لیے دونوں کو آپ کے کمپیوٹر پر انسٹال کرنا ضروری ہے۔
RStudio IDE Cheat Sheet میں یہاں دی گئی معلومات کے مقابلے میں کہیں زیادہ معلومات فراہم کی گئی ہیں، لیکن یہ کی بورڈ شارٹ کٹس سیکھنے اور نئی خصوصیات دریافت کرنے کے لیے مفید ہو سکتا ہے۔
R کیوں سیکھیں؟
R میں بہت زیادہ پوائنٹنگ اور کلکنگ کی ضرورت نہیں ہوتی، اور یہ ایک اچھی بات ہے۔
سیکھنے کا عمل دیگر سافٹ ویئر کے مقابلے میں زیادہ مشکل ہو سکتا ہے، لیکن R کے ساتھ، آپ کے تجزیے کے نتائج پوائنٹنگ اور کلک کرنے کے ایک سلسلے کو یاد رکھنے پر نہیں، بلکہ تحریری کمانڈز کے ایک سلسلے پر منحصر ہوتے ہیں، اور یہ ایک اچھی بات ہے! لہٰذا، اگر آپ مزید ڈیٹا جمع کرنے کی وجہ سے اپنا تجزیہ دوبارہ کرنا چاہتے ہیں، تو آپ کو یہ یاد رکھنے کی ضرورت نہیں ہے کہ نتائج حاصل کرنے کے لیے آپ نے کون سا بٹن کس ترتیب میں کلک کیا تھا؛ آپ کو بس اپنا اسکرپٹ دوبارہ چلانا ہوگا۔
اسکرپٹس کے ساتھ کام کرنے سے آپ کی تجزیے میں استعمال کیے گئے مراحل واضح ہو جاتے ہیں، اور آپ کے لکھے ہوئے کوڈ کا جائزہ کسی دوسرے شخص کر سکتا ہے جو آپ کو فیڈ بیک دے سکے اور غلطیوں کی نشاندہی کر سکے۔
اسکرپٹس کے ساتھ کام کرنے سے آپ کو اس بات کی گہری سمجھ بوجھ حاصل کرنے پر مجبور ہوتا ہے کہ آپ کیا کر رہے ہیں، اور یہ آپ کے استعمال کردہ طریقوں کے سیکھنے اور انہیں سمجھنے میں آسانی فراہم کرتا ہے۔
R کوڈ ریپروڈکیبلٹی کے لیے بہترین ہے
تکرار پذیری کا مطلب یہ ہے کہ کوئی دوسرا شخص (بشمول آپ کا مستقبل کا آپ خود) اسی تجزیاتی کوڈ کا استعمال کرتے ہوئے ایک ہی ڈیٹا سیٹ سے وہی نتائج حاصل کر سکتا ہے۔
R دیگر ٹولز کے ساتھ مربوط ہو کر آپ کے کوڈ سے مینو اسکرپٹس یا رپورٹس تیار کرتا ہے۔ اگر آپ مزید ڈیٹا جمع کرتے ہیں، یا اپنے ڈیٹا سیٹ میں کسی غلطی کو درست کرتے ہیں، تو آپ کے مینو اسکرپٹ یا رپورٹ میں موجود اشکال اور شماریاتی ٹیسٹ خود بخود اپ ڈیٹ ہو جاتے ہیں۔
ایک بڑھتی ہوئی تعداد میں جریدے اور فنڈنگ ایجنسیاں یہ توقع رکھتی ہیں کہ تجزیے قابلِ تکرار ہوں، لہذا R کی مہارت آپ کو ان ضروریات کے حوالے سے ایک برتری فراہم کرے گی۔
R بین الشعبہ جاتی اور قابلِ توسیع ہے
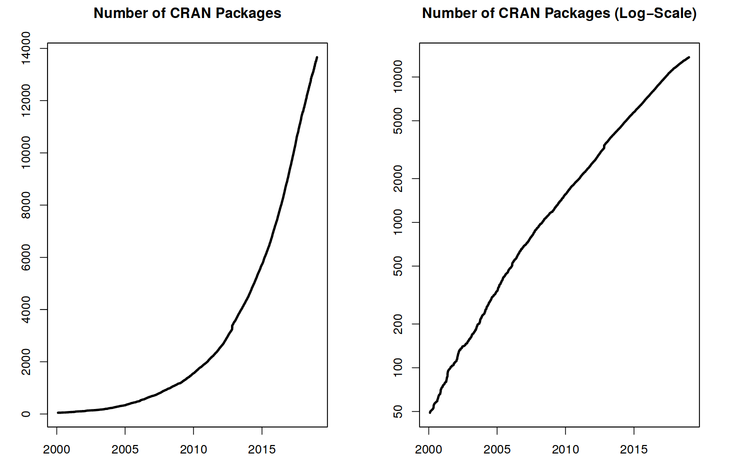
10,000 سے زائد پیکیجز2 کے ذریعے، جنہیں اس کی صلاحیتوں کو وسعت دینے کے لیے انسٹال کیا جا سکتا ہے، R ایک ایسا فریم ورک فراہم کرتا ہے جو آپ کو کئی سائنسی شعبوں کے شماریاتی طریقوں کو ایک ایسے تجزیاتی فریم ورک میں یکجا کرنے کی اجازت دیتا ہے جو آپ کے ڈیٹا کے تجزیے کے لیے ضروری ہو۔ مثال کے طور پر، R میں امیج تجزیہ، GIS، ٹائم سیریز، پاپولیشن جینیٹکس اور بہت سی دیگر چیزوں کے لیے پیکیجز موجود ہیں۔
R ہر قسم اور سائز کے ڈیٹا پر کام کرتا ہے
R کے ذریعے آپ جو مہارتیں سیکھتے ہیں، وہ آپ کے ڈیٹا سیٹ کے سائز کے مطابق آسانی سے ڈھل جاتی ہیں۔ چاہے آپ کے ڈیٹا سیٹ میں سینکڑوں یا لاکھوں لائنیں ہوں، اس سے آپ کے لیے کوئی خاص فرق نہیں پڑے گا۔
R کو ڈیٹا تجزیے کے لیے ڈیزائن کیا گیا ہے۔ یہ مخصوص ڈیٹا ساختوں اور ڈیٹا اقسام کے ساتھ آتا ہے جو غیر موجود ڈیٹا اور شماریاتی فیکٹرز کے انتظام کو آسان بناتے ہیں۔
R آپ کے کمپیوٹر یا ویب پر اسپریڈشیٹس، ڈیٹا بیسز اور کئی دیگر ڈیٹا فارمیٹس سے منسلک ہو سکتا ہے۔
R اعلیٰ معیار کے گرافکس تیار کرتا ہے
R میں پلوٹنگ کی خصوصیات بہت وسیع ہیں، اور یہ آپ کو اپنے گراف کے کسی بھی پہلو کو اس طرح ایڈجسٹ کرنے کی اجازت دیتی ہیں کہ آپ اپنے ڈیٹا سے پیدا ہونے والے پیغام کو سب سے مؤثر طریقے سے پہنچا سکیں۔
R کی ایک بڑی اور خوش آئند کمیونٹی ہے
ہزاروں لوگ روزانہ R استعمال کرتے ہیں۔ ان میں سے بہت سے لوگ میلنگ لسٹس اور Stack Overflow جیسی ویب سائٹس، یا RStudio کمیونٹی کے ذریعے آپ کی مدد کرنے کے لیے تیار ہیں۔ صارفین کی یہ وسیع کمیونٹیز بائیو انفارمیٹکس جیسے مخصوص شعبوں تک بھی پھیلی ہوئی ہیں۔ R کمیونٹی کا ایک ایسا ہی حصہ Bioconductor ہے، جو “موجودہ اور ابھرتے ہوئے حیاتیاتی ٹیسٹوں کے ڈیٹا” کے تجزیے اور سمجھ بوجھ کے لیے ایک سائنسی پروجیکٹ ہے۔ یہ ورکشاپ Bioconductor کمیونٹی کے ارکان نے تیار کی ہے؛ Bioconductor کے بارے میں مزید معلومات کے لیے، براہِ کرم ساتھ موجود ورکشاپ “The Bioconductor Project” دیکھیں۔
R نہ صرف مفت ہے، بلکہ یہ اوپن سورس اور کراس پلیٹ فارم بھی ہے۔
کوئی بھی شخص سورس کوڈ کا معائنہ کر سکتا ہے تاکہ یہ دیکھ سکے کہ R کیسے کام کرتا ہے۔ اس شفافیت کی وجہ سے غلطیوں کے امکانات کم ہوتے ہیں، اور اگر آپ (یا کوئی اور) کوئی غلطیاں مل جائیں، تو آپ ان کی رپورٹ کر سکتے ہیں اور بگز کو درست کر سکتے ہیں۔
RStudio کے استعمال سے واقفیت
آئیے RStudio کے بارے میں جاننے سے آغاز کرتے ہیں، جو R کے ساتھ کام کرنے کے لیے ایک انٹیگریٹڈ ڈویلپمنٹ انوائرمنٹ (IDE) ہے۔
RStudio IDE کا اوپن سورس پروڈکٹ Affero General Public License (AGPL) v3 کے تحت مفت ہے۔ RStudio IDE کمرشل لائسنس اور Posit, Inc. کی جانب سے ترجیحی ای میل سپورٹ کے ساتھ بھی دستیاب ہے۔
ہم کوڈ لکھنے، اپنے کمپیوٹر پر فائلوں تک رسائی حاصل کرنے، ان متغیرات کا جائزہ لینے جنہیں ہم تخلیق کرنے جا رہے ہیں، اور ان پلوٹس کو بصری شکل دینے کے لیے RStudio IDE استعمال کریں گے جو ہم تیار کریں گے۔ RStudio کو دیگر کاموں (مثلاً ورژن کنٹرول، پیکیجز تیار کرنا، Shiny ایپس لکھنا) کے لیے بھی استعمال کیا جا سکتا ہے جن پر ہم ورکشاپ کے دوران بات نہیں کریں گے۔
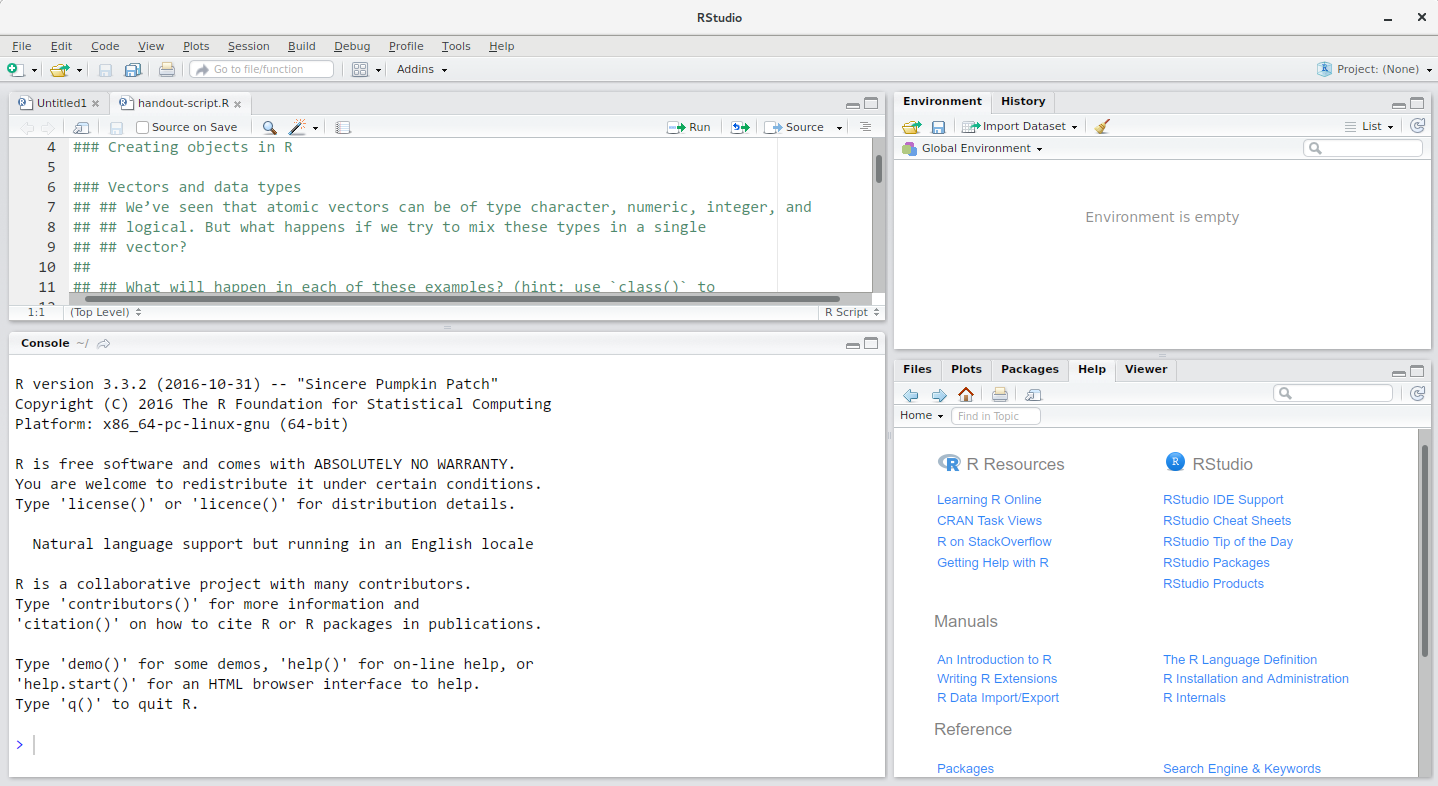
RStudio کی ونڈو 4 “پینز” میں تقسیم ہے:
- آپ کے اسکرپٹس اور دستاویزات کے لیے Source (اوپر بائیں، ڈیفالٹ لے آؤٹ میں)
- آپ کا Environment/History (اوپر دائیں)،
- آپ کے Files/Plots/Packages/Help/Viewer (نیچے دائیں)، اور
- R Console (نیچے بائیں)۔
ان پینز کی ترتیب اور ان کے مواد کو اپنی مرضی کے مطابق تبدیل کیا جا
سکتا ہے (مینو، Tools -> Global Options -> Pane Layout
دیکھیں)۔
RStudio استعمال کرنے کے فوائد میں سے ایک یہ ہے کہ کوڈ لکھنے کے لیے درکار تمام معلومات ایک ہی ونڈو میں دستیاب ہوتی ہیں۔ مزید برآں، R میں ڈویلپمنٹ کے دوران استعمال ہونے والی اہم فائل اقسام کے لیے متعدد شارٹ کٹس، آٹو کمپلیشن، اور ہائی لائٹنگ کی بدولت، RStudio ٹائپنگ کو آسان اور غلطیوں سے پاک بنا دے گا۔
سیٹ اپ کرنا
یہ ایک بہتر طریقہ کار ہے کہ متعلقہ ڈیٹا، تجزیوں اور متن کا ایک مجموعہ ایک ہی فولڈر میں محفوظ رکھا جائے، جسے ورکنگ ڈائریکٹری (working directory) کہا جاتا ہے۔ اس فولڈر کے اندر موجود تمام اسکرپٹس فائلوں کے لیے ریلیٹیو پاتھز (relative paths) استعمال کر سکتے ہیں جو یہ ظاہر کرتے ہیں کہ پروجیکٹ کے اندر فائل کہاں واقع ہے (اس کے برعکس ایبسولیوٹ پاتھز (absolute paths) اس جگہ کی نشاندہی کرتے ہیں جہاں فائل ایک مخصوص کمپیوٹر پر موجود ہوتی ہے)۔ اس طریقے سے کام کرنے سے آپ کے کمپیوٹر پر اپنے پروجیکٹ کو منتقل کرنا اور اسے دوسروں کے ساتھ شیئر کرنا بہت آسان ہو جاتا ہے، اور آپ کو اس بات کی فکر نہیں رہتی کہ بنیادی اسکرپٹس اب بھی کام کریں گے یا نہیں۔
RStudio اپنے “Projects” انٹرفیس کے ذریعے اس کام کے لیے ٹولز کا ایک مفید سیٹ فراہم کرتا ہے، جو نہ صرف آپ کے لیے ایک ورکنگ ڈائریکٹری بناتا ہے، بلکہ اس کے مقام کو بھی یاد رکھتا ہے (جس سے آپ تیزی سے وہاں پہنچ سکتے ہیں) اور اختیاری طور پر کسٹم سیٹنگز اور کھلے ہوئے فائلوں کو محفوظ رکھتا ہے تاکہ وقفے کے بعد کام کو دوبارہ شروع کرنا آسان ہو جائے۔ اس ٹیوٹوریل کے لیے “R Project” بنانے کے مراحل نیچے دیے گئے ہیں۔
- RStudio شروع کریں۔
-
Fileمینو کے تحت،New projectپر کلک کریں۔New directoryکا انتخاب کریں، پھرNew projectکا۔ - اس نئے فولڈر (یا “ڈائریکٹری”) کے لیے ایک نام درج کریں، اور اس کے لیے
ایک مناسب جگہ منتخب کریں۔ یہ اس سیشن (یا پورے کورس) کے لیے آپ کی
ورکنگ ڈائریکٹری ہوگی (مثلاً،
bioc-intro)۔ -
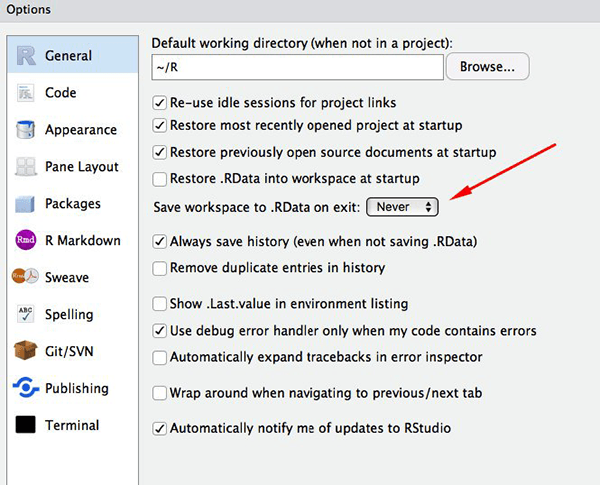
Create projectپر کلک کریں۔ - (اختیاری) ترجیحات کو RStudio میں ورک اسپیس کو ‘Never’ پر سیو کرنے کے لیے سیٹ کریں۔
RStudio کی ڈیفالٹ ترجیحات عام طور پر اچھی کام کرتی ہیں، لیکن ورک اسپیس کو .RData میں محفوظ کرنا دشوار ہو سکتا ہے، خاص طور پر اگر آپ بڑے ڈیٹا سیٹس کے ساتھ کام کر رہے ہیں۔ اسے بند کرنے کے لیے، Tools –> ‘Global Options’ پر جائیں اور ایگزٹ کرتے وقت ‘Save workspace to .RData’ کے لیے ‘Never’ آپشن منتخب کریں۔
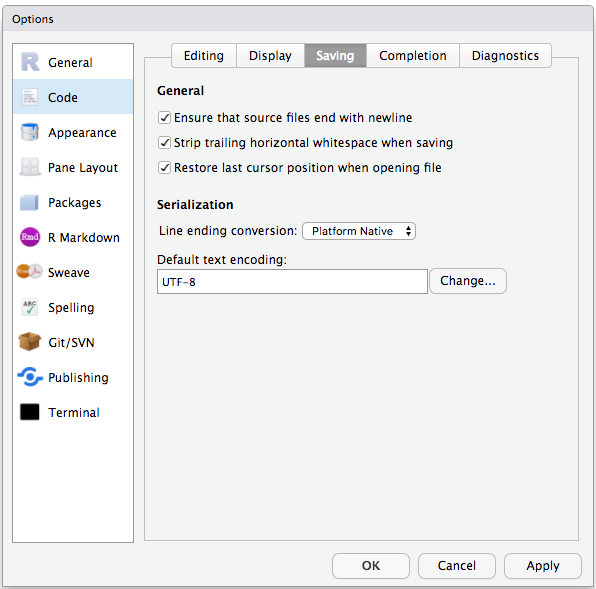
ونڈوز اور دیگر آپریٹنگ سسٹمز کے درمیان کیریکٹر انکوڈنگ کے مسائل سے بچنے کے لیے، ہم ڈیفالٹ طور پر UTF-8 سیٹ کریں گے:
اپنی ورکنگ ڈائریکٹری کی ترتیب
اپنے تمام پروجیکٹس میں ایک مستقل فولڈر اسٹرکچر استعمال کرنے سے چیزوں کو منظم رکھنے میں مدد ملے گی، اور مستقبل میں چیزوں کو تلاش کرنا اور انہیں فائل کرنا بھی آسان ہو جائے گا۔ یہ خاص طور پر تب مددگار ثابت ہو سکتا ہے جب آپ کے پاس متعدد پروجیکٹس ہوں۔ عام طور پر، آپ اسکرپٹس، ڈیٹا، اور دستاویزات کے لیے ڈائریکٹریز (فولڈرز) بنا سکتے ہیں۔
-
data/اس فولڈر کو اپنے خام ڈیٹا اور ان درمیانی ڈیٹا سیٹس کو محفوظ کرنے کے لیے استعمال کریں جو آپ کسی مخصوص تجزیے کی ضرورت کے لیے تیار کر سکتے ہیں۔ شفافیت اور پروویننس کے لیے، آپ کو ہمیشہ اپنے خام ڈیٹا کی ایک کاپی دستیاب رکھنی چاہیے اور اپنے ڈیٹا کی صفائی اور پری پروسیسنگ کا جتنا ہو سکے پروگرامی طور پر (یعنی اسکرپٹس کے ذریعے، دستی طور پر نہیں) کرنا چاہیے۔ خام ڈیٹا کو پروسیس شدہ ڈیٹا سے الگ رکھنا بھی ایک اچھا خیال ہے۔ مثال کے طور پر، آپscripts/01.preprocess.tree_survey.Rاسکرپٹ کے ذریعے تیار کردہdata/processed/tree.survey.csvفائل سے الگdata/raw/tree_survey.plot1.txtاور...plot2.txtفائلیں رکھ سکتے ہیں۔ -
documents/یہ خاکے، ڈرافٹس اور دیگر متن رکھنے کی جگہ ہوگی۔ -
scripts/(یاsrc) یہ وہ مقام ہوگا جہاں آپ مختلف تجزیوں یا پلوٹنگ کے لیے اپنی R اسکرپٹس رکھیں گے، اور ممکنہ طور پر اپنے فنکشنز کے لیے ایک علیحدہ فولڈر بھی (اس کے بارے میں مزید تفصیل بعد میں)۔
آپ کو اپنے پروجیکٹ کی ضروریات کے مطابق اضافی ڈائریکٹریز یا سب ڈائریکٹریز کی ضرورت ہو سکتی ہے، لیکن انہیں آپ کی ورکنگ ڈائریکٹری کا بنیادی ڈھانچہ ہونا چاہیے۔
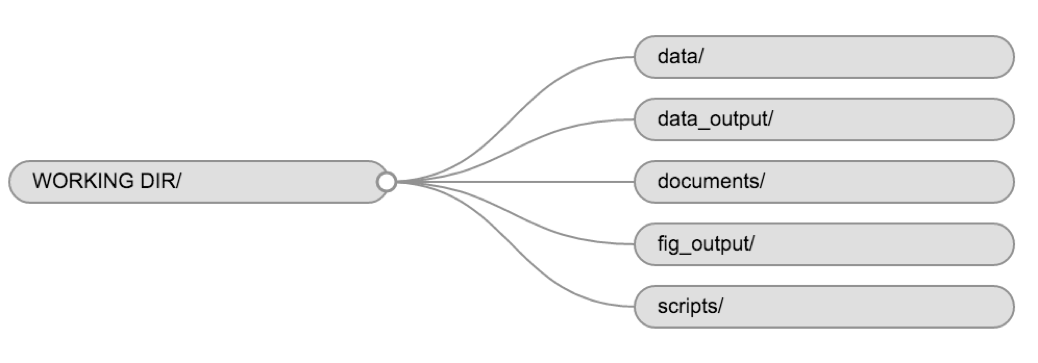
اس کورس کے لیے، ہمیں اپنے خام ڈیٹا کو محفوظ کرنے کے لیے ایک
data/ فولڈر کی ضرورت ہوگی، اور جب ہم ڈیٹا کو CSV فائلوں کے
طور پر ایکسپورٹ کرنا سیکھیں گے تو data_output/ کا استعمال
کریں گے، اور ان فیگرز کے لیے fig_output/ فولڈر استعمال کریں
گے جنہیں ہم محفوظ کریں گے۔
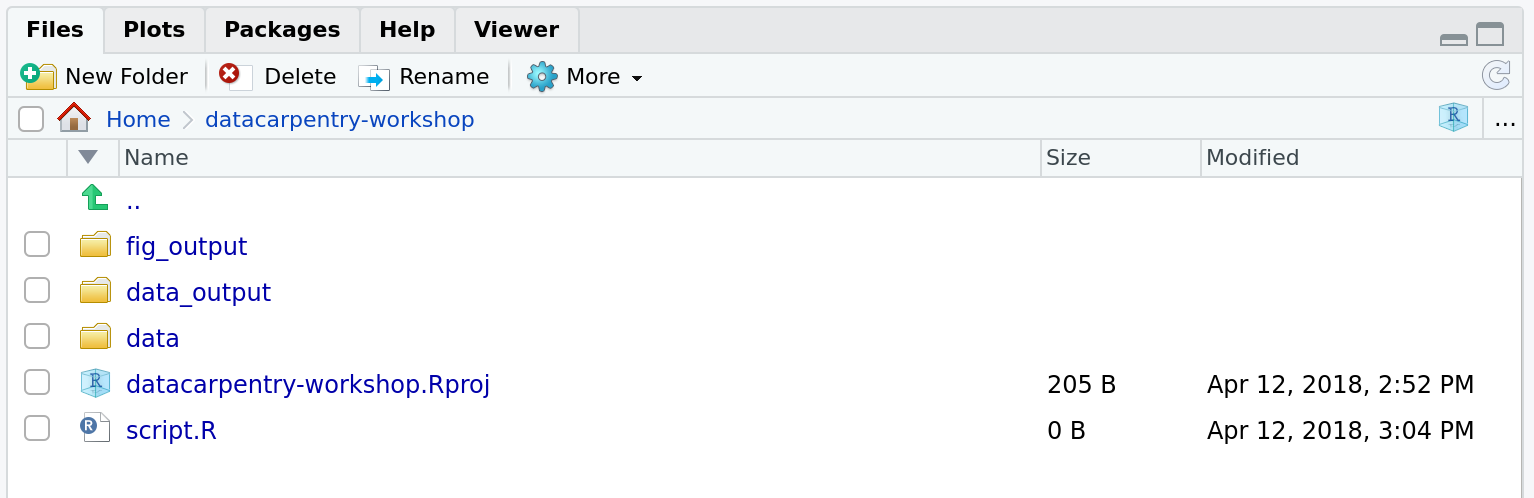
چیلنج: اپنی پروجیکٹ ڈائریکٹری کی ساخت تیار کریں
اسکرین کے دائیں جانب Files ٹیب کے تحت،
New Folder پر کلک کریں اور اپنی نئی بنائی گئی ورکنگ
ڈائریکٹری (مثلاً ~/bioc-intro/data) کے اندر
data نامی ایک فولڈر بنائیں۔ (متبادل طور پر، اپنے R کنسول پر
dir.create("data") ٹائپ کریں۔) ان اقدامات کو دہرا کر
data_output/ اور fig_output فولڈرز بنائیں۔
ہم اسکرپٹ کو اپنی ورکنگ ڈائریکٹری کے رُوٹ میں ہی رکھیں گے کیونکہ ہم صرف ایک فائل استعمال کریں گے اور اس سے کام آسان ہو جائے گا۔
آپ کی ورکنگ ڈائریکٹری اب اس طرح نظر آنی چاہیے:
پروجیکٹ مینجمنٹ ظاہر ہے کہ بائیو انفارمیٹکس کے پروجیکٹس پر بھی قابلِ اطلاق ہے3۔ ولیم نوبل ( Noble (2009) ) درج ذیل ڈائریکٹری ساخت تجویز کرتے ہیں:
ڈائریکٹری کے نام بڑے فونٹ میں ہیں، اور فائل کے نام چھوٹے فونٹ میں ہیں۔ یہاں فائلوں کا صرف ایک حصہ دکھایا گیا ہے۔ نوٹ کریں کہ تاریخوں کو
<year>-<month>-<day>فارمیٹ میں رکھا گیا ہے تاکہ انہیں ترتیبِ زمانی کے مطابق ترتیب دیا جا سکے۔ سورس کوڈsrc/ms-analysis.cکو کمپائل کر کےbin/ms-analysisتیار کیا جاتا ہے اور اس کی دستاویزاتdoc/ms-analysis.htmlمیں موجود ہیں۔ ڈیٹا ڈائریکٹریز میں موجودREADMEفائلیں یہ بتاتی ہیں کہ کس نے کس تاریخ کو کس URL سے ڈیٹا فائلیں ڈاؤن لوڈ کیں۔ ڈرائیور اسکرپٹresults/2009-01-15/runallخود بخود تین سب ڈائریکٹریز split1، split2، اور split3 تیار کرتا ہے، جو تین کراس ویلیڈیشن اسپلٹس کے مطابق ہیں۔bin/parse-sqt.pyاسکرپٹ کو دونوںrunallڈرائیور اسکرپٹس کے ذریعے کال کیا جاتا ہے۔
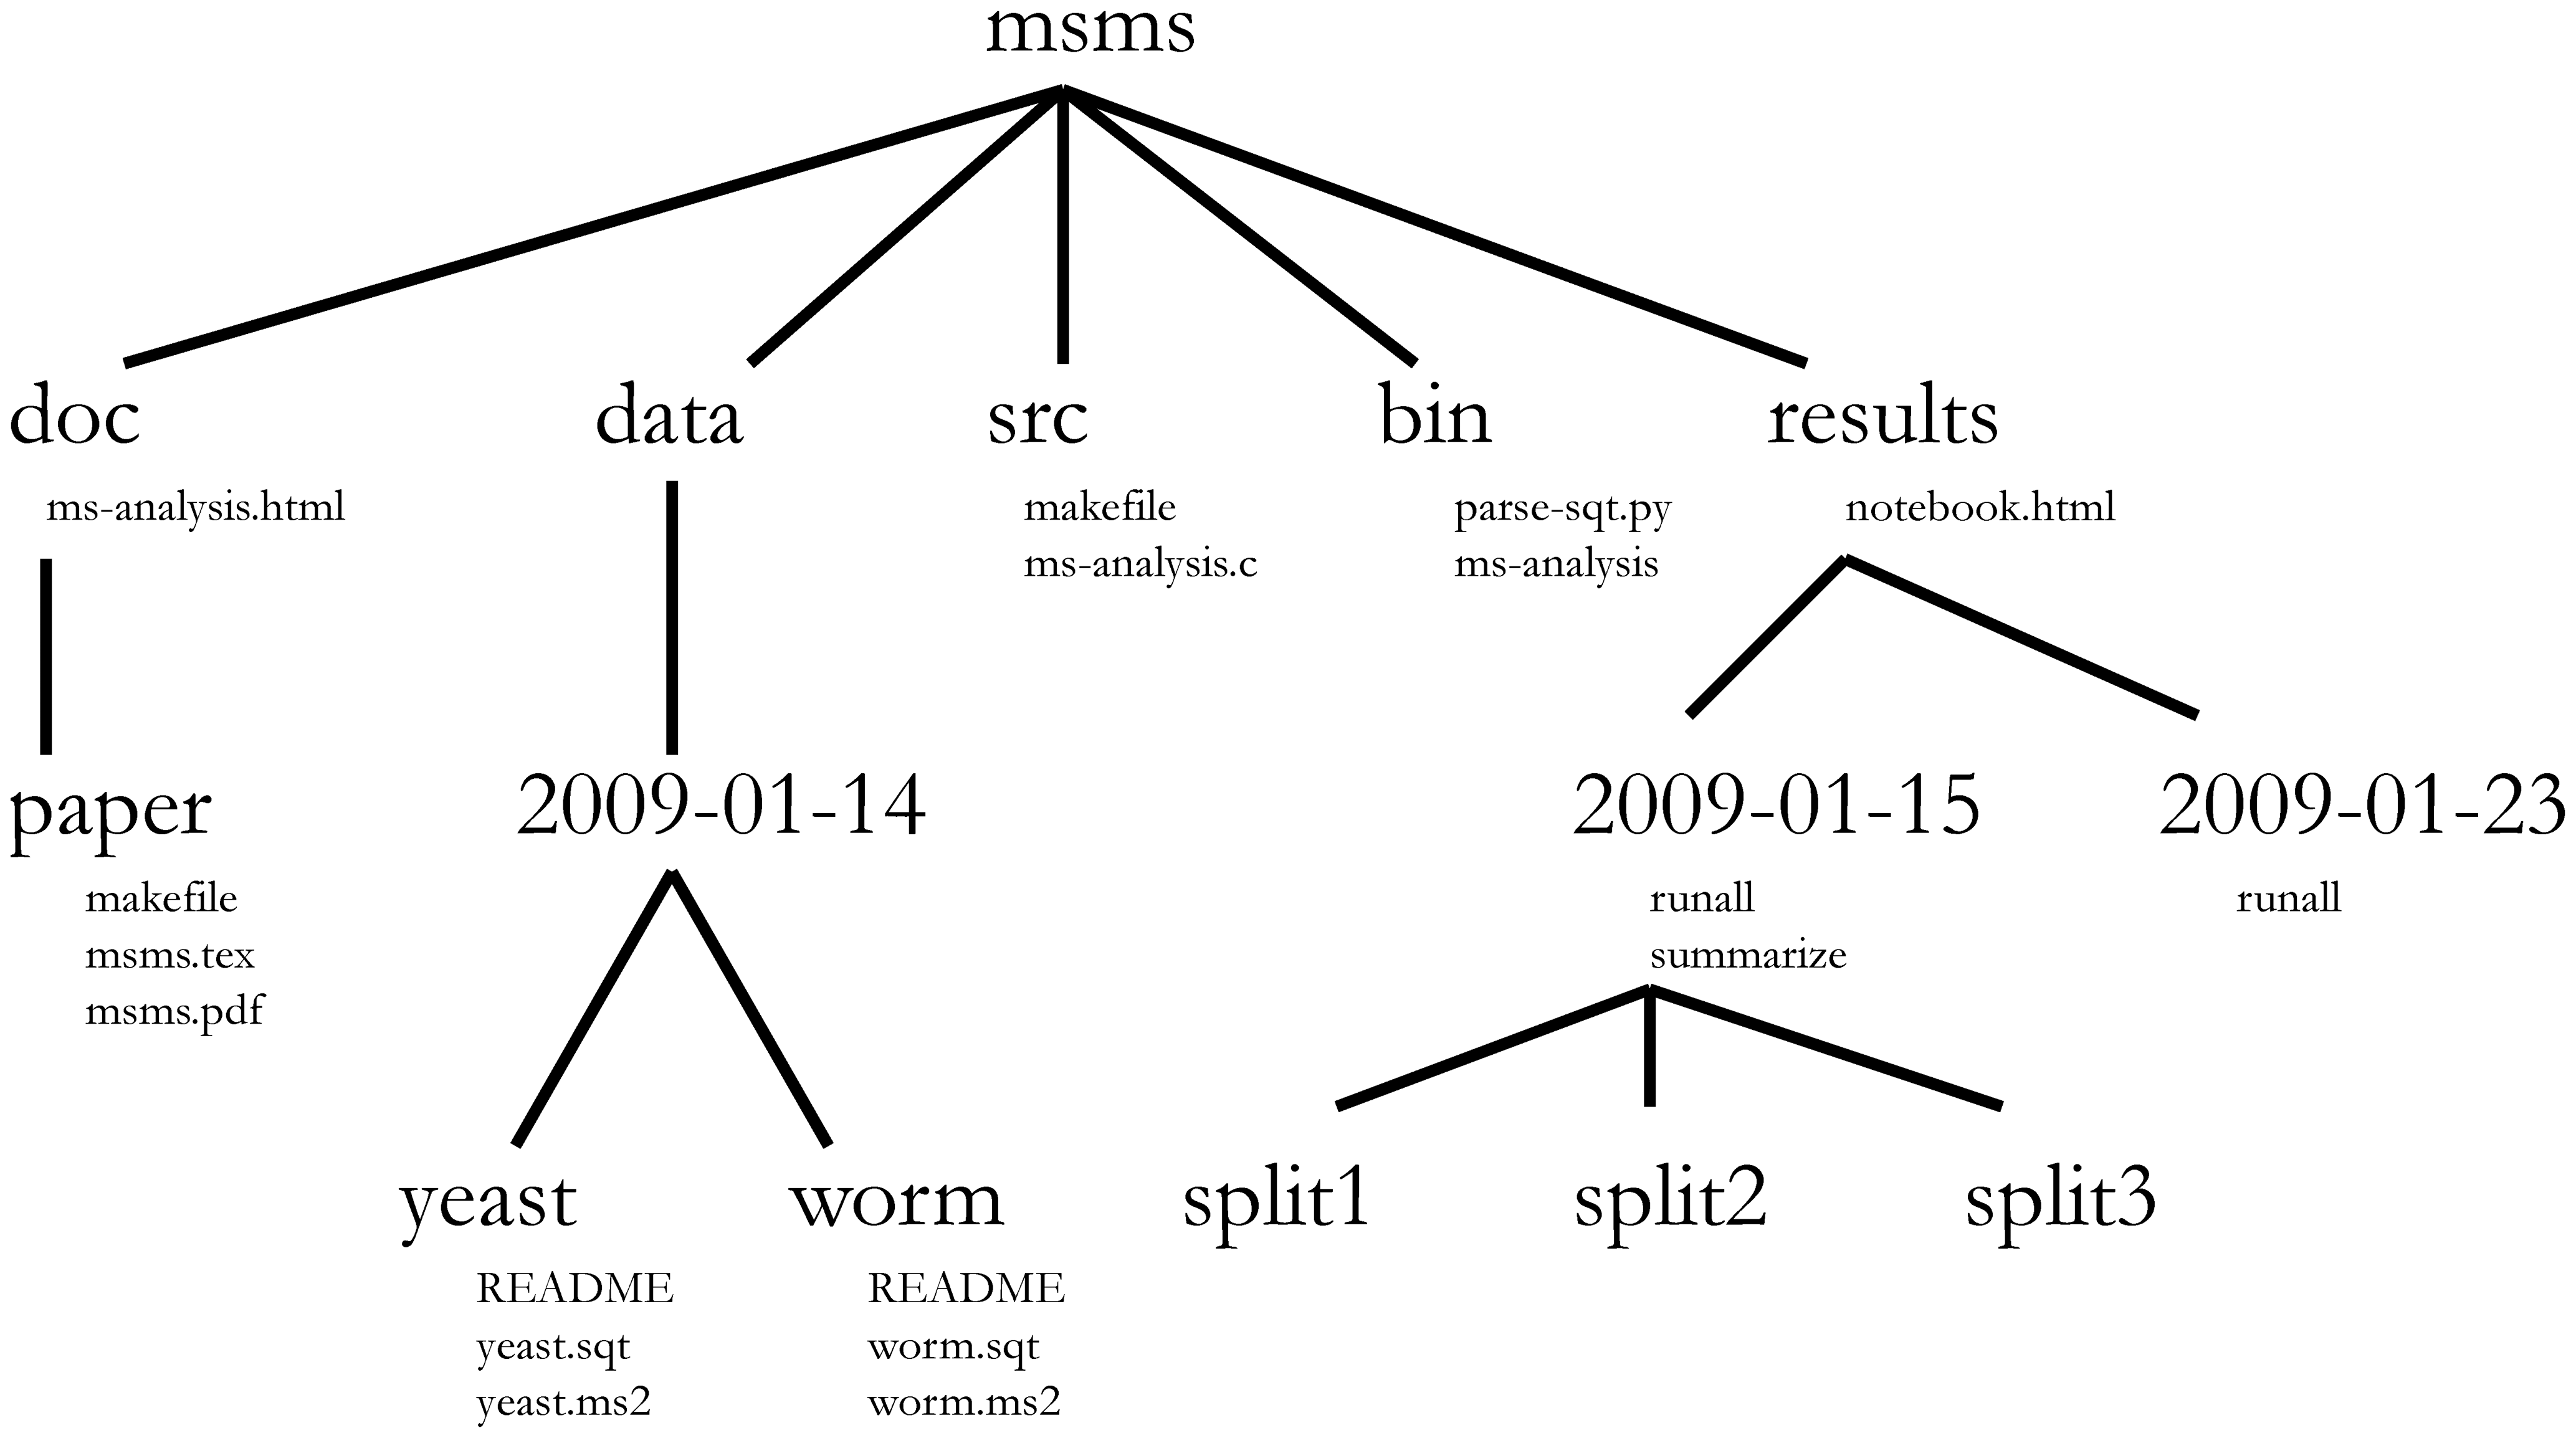
ایک واضح طور پر متعین اور اچھی طرح دستاویز سازی شدہ پروجیکٹ ڈائریکٹری کا سب سے اہم پہلو یہ ہے کہ پروجیکٹ سے ناواقف کسی شخص کو4
سمجھ سکیں کہ پروجیکٹ کس بارے میں ہے، کیا ڈیٹا دستیاب ہے، کون سے تجزیے کیے گئے، اور کیا نتائج حاصل ہوئے، اور سب سے اہم بات یہ کہ
تجزیے کو دوبارہ دہرانا - نئے ڈیٹا کے ساتھ، یا تجزیے کے کچھ پیرامیٹرز کو تبدیل کرتے ہوئے۔
ورکنگ ڈائریکٹری
ورکنگ ڈائریکٹری ایک اہم تصور ہے جسے سمجھنا ضروری ہے۔ یہ وہ جگہ ہے جہاں سے R فائلوں کو تلاش کرے گا اور انہیں محفوظ کرے گا۔ جب آپ اپنے پروجیکٹ کے لیے کوڈ لکھتے ہیں، تو اسے فائلوں کا حوالہ اپنی ورکنگ ڈائریکٹری کے رُوٹ کے حوالے سے دینا چاہیے اور اسے صرف اس ڈھانچے کے اندر موجود فائلوں کی ضرورت ہونی چاہیے۔
RStudio پروجیکٹس کا استعمال اس عمل کو آسان بنا دیتا ہے اور اس بات کو
یقینی بناتا ہے کہ آپ کی ورکنگ ڈائریکٹری درست طریقے سے سیٹ ہو۔ اگر آپ کو
اسے چیک کرنے کی ضرورت ہو، تو آپ getwd() استعمال کر سکتے
ہیں۔ اگر کسی وجہ سے آپ کی ورکنگ ڈائریکٹری وہ نہیں ہے جیسا ہونا چاہیے، تو
آپ RStudio انٹرفیس میں اسے تبدیل کر سکتے ہیں؛ اس کے لیے فائل براؤزر میں
اس جگہ پر جائیں جہاں آپ کی ورکنگ ڈائریکٹری ہونی چاہیے، اور نیلے رنگ کے
گیئر آئیکن More پر کلک کر کے
Set As Working Directory منتخب کریں۔ متبادل طور پر، آپ اپنی
ورکنگ ڈائریکٹری کو ری سیٹ کرنے کے لیے
setwd("/path/to/working/directory") استعمال کر سکتے ہیں۔
تاہم، آپ کے اسکرپٹس میں اس لائن کو شامل نہیں کرنا چاہیے کیونکہ یہ کسی
دوسرے شخص کے کمپیوٹر پر ناکام ہو جائے گی۔
مثال
نیچے دیا گیا خاکہ ورکنگ ڈائریکٹری bioc-intro کی نمائندگی
کرتا ہے جس میں data اور fig_output
سب-ڈائریکٹریز ہیں، اور بعد والی میں 2 فائلیں ہیں:
bioc-intro/data/
          /fig_output/fig1.pdf
          /fig_output/fig2.png
اگر ہم ورکنگ ڈائریکٹری میں ہوتے، تو ہم fig1.pdf فائل کا
حوالہ ریلیٹیو پاتھ bioc-intro/fig_output/fig1.pdf یا
ایبسولیوٹ پاتھ /home/user/bioc-intro/fig_output/fig1.pdf کے
ذریعے کر سکتے تھے۔
اگر ہم data ڈائریکٹری میں ہوتے، تو ہم ریلیٹیو پاتھ
../fig_output/fig1.pdf یا وہی ایبسولیوٹ پاتھ
/home/user/bioc-intro/fig_output/fig1.pdf استعمال کرتے۔
R کے ساتھ تعامل
پروگرامنگ کی بنیاد یہ ہے کہ ہم کمپیوٹر کے لیے ہدایات لکھتے ہیں جن پر وہ عمل کرے، اور پھر ہم کمپیوٹر کو یہ ہدایات پر عمل کرنے کو کہتے ہیں۔ ہم R میں ہدایات لکھتے ہیں، یا ان کا کوڈ تیار کرتے ہیں، کیونکہ یہ ایک ایسی مشترکہ زبان ہے جسے کمپیوٹر اور ہم دونوں سمجھ سکتے ہیں۔ ہم ان ہدایات کو کمانڈز کہتے ہیں اور ہم کمپیوٹر کو ان کمانڈز کو ایگزیکیوٹ (جسے رن بھی کہا جاتا ہے) کر کے ان ہدایات پر عمل کرنے کا کہتے ہیں۔
R کے ساتھ تعامل کے دو بنیادی طریقے ہیں: کنسول کا
استعمال کرنا یا اسکرپٹس (سادہ ٹیکسٹ فائلیں جن میں آپ کا
کوڈ ہوتا ہے) کا استعمال کرنا۔ کنسول پین (RStudio میں، نیچے بائیں پینل)
وہ جگہ ہے جہاں R زبان میں لکھے گئے کمانڈز ٹائپ کیے جا سکتے ہیں اور
کمپیوٹر کے ذریعے فوری طور پر چلائے جا سکتے ہیں۔ یہ وہ جگہ بھی ہے جہاں
چلائے گئے کمانڈز کے نتائج دکھائے جائیں گے۔ آپ کمانڈز براہِ راست کنسول میں
ٹائپ کر سکتے ہیں اور انہیں چلانے کے لیے Enter دبا سکتے ہیں،
لیکن سیشن بند کرنے پر یہ فراموش ہو جائیں گے۔
چونکہ ہم چاہتے ہیں کہ ہمارا کوڈ اور ورک فلو قابلِ تکرار ہو، اس لیے بہتر ہے کہ ہم اپنی مطلوبہ کمانڈز سکرپٹ ایڈیٹر میں ٹائپ کریں اور سکرپٹ کو محفوظ کریں۔ اس طرح، ہم نے جو کچھ کیا ہے اس کا ایک مکمل ریکارڈ موجود ہوتا ہے، اور کوئی بھی شخص (بشمول ہمارے مستقبل کے اپنے آپ!) اپنے کمپیوٹر پر نتائج کو آسانی سے دوہرا سکتا ہے۔ تاہم، نوٹ کریں کہ محض سکرپٹ میں کمانڈز ٹائپ کرنے سے وہ خود بخود رن نہیں ہوتیں - انہیں ایگزیکیوشن کے لیے اب بھی کنسول کو بھیجنا پڑتا ہے۔
RStudio آپ کو Ctrl + Enter شارٹ کٹ کے ذریعے
اسکرپٹ ایڈیٹر سے براہِ راست کمانڈز چلانے کی سہولت فراہم کرتا ہے (Macs پر،
Cmd + Return بھی کام کرے گا)۔ اسکرپٹ میں
موجودہ لائن پر موجود کمانڈ (جس کی نشاندہی کرسر سے ہوتی ہے) یا فی الحال
منتخب کردہ ٹیکسٹ میں موجود تمام کمانڈز کنسول پر بھیجی جائیں گی اور
Ctrl + Enter دبانے پر ان کا ایگزیکیوشن ہو جائے
گا۔ آپ دیگر کی بورڈ شارٹ کٹس اس RStudio
IDE کے بارے میں RStudio چیٹ شیٹ میں پا سکتے ہیں۔
اپنے تجزیے کے دوران کسی بھی مرحلے پر، آپ شاید کسی ویری ایبل کے مواد
یا کسی آبجیکٹ کی ساخت کی جانچ کرنا چاہیں، بغیر اس کا ریکارڈ اپنے اسکرپٹ
میں محفوظ کیے۔ آپ یہ کمانڈز ٹائپ کر کے براہِ راست کنسول میں چلا سکتے ہیں۔
RStudio Ctrl + 1 اور Ctrl +
2 شارٹ کٹس فراہم کرتا ہے جو آپ کو اسکرپٹ اور کنسول پینز کے
درمیان جمپ کرنے کی سہولت دیتے ہیں۔
اگر R کمانڈز وصول کرنے کے لیے تیار ہو، تو R کنسول پر ایک
> پرامپٹ ظاہر ہوتا ہے۔ اگر اسے کوئی کمانڈ موصول ہو جائے
(ٹائپ کر کے، کاپی-پیسٹ کر کے یا اسکرپٹ ایڈیٹر سے Ctrl +
Enter کے ذریعے بھیج کر)، تو R اسے چلانے کی کوشش کرے گا، اور
جب یہ تیار ہو جائے گا، تو نتائج دکھائے گا اور نئی کمانڈز کے انتظار کے
لیے ایک نئے > پرامپٹ کے ساتھ واپس آئے گا۔
اگر R ابھی تک مکمل نہیں ہوا ہے اور آپ کے مزید ڈیٹا درج کرنے کا انتظار
کر رہا ہے، تو کنسول پر + پرامپٹ ظاہر ہوگا۔ اس کا مطلب ہے کہ
آپ نے ایک مکمل کمانڈ درج کرنا مکمل نہیں کیا ہے۔ ایسا اس لیے ہوتا ہے
کیونکہ آپ نے کسی بریکٹ یا کوٹیشن کو ‘بند’ نہیں کیا ہے، یعنی آپ کے پاس
بائیں بریکٹس کی تعداد دائیں بریکٹس کے برابر نہیں ہے، یا کوٹیشن مارکس کی
شروعات اور اختتام کی تعداد برابر نہیں ہے۔ جب ایسا ہو، اور آپ کو لگتا ہو
کہ آپ نے اپنی کمانڈ ٹائپ کرنا مکمل کر لیا ہے، تو کنسول ونڈو کے اندر کلک
کریں اور Esc دبائیں؛ اس سے نامکمل کمانڈ منسوخ ہو جائے گی
اور آپ دوبارہ > پرامپٹ پر واپس آ جائیں گے۔
کورس کے دوران اور اس کے بعد مزید کیسے سیکھیں؟
اس کورس کے دوران ہم جو مواد پیش کریں گے، وہ آپ کو اس بات کا ایک ابتدائی اندازہ دے گا کہ آپ اپنی تحقیق کے لیے ڈیٹا کا تجزیہ کرنے کے لیے R کا استعمال کیسے کر سکتے ہیں۔ تاہم، اعلیٰ آپریشنز کرنے کے لیے، جیسے کہ اپنے ڈیٹا سیٹ کو صاف کرنا، شماریاتی طریقے استعمال کرنا، یا خوبصورت گرافکس بنانا5، آپ کو مزید سیکھنے کی ضرورت ہوگی۔ R میں مہارت اور کارکردگی حاصل کرنے کا بہترین طریقہ، کسی بھی دوسرے ٹول کی طرح، اسے اپنے اصل تحقیقی سوالات کو حل کرنے کے لیے استعمال کرنا ہے۔ ایک مبتدی کے طور پر، بالکل شروع سے اسکرپٹ لکھنا کافی مشکل محسوس ہو سکتا ہے، اور چونکہ بہت سے لوگ اپنا کوڈ آن لائن دستیاب کرتے ہیں، اس لیے اپنے مقصد کے مطابق موجودہ کوڈ میں ترمیم کرنا آپ کے لیے آغاز کرنا آسان بنا سکتا ہے۔
مدد حاصل کرنا
R فانکشنز کے بارے میں مزید معلومات تلاش کرنے کے لیے RStudio کے بلٹ-ان ہیلپ انٹرفیس کا استعمال کریں۔
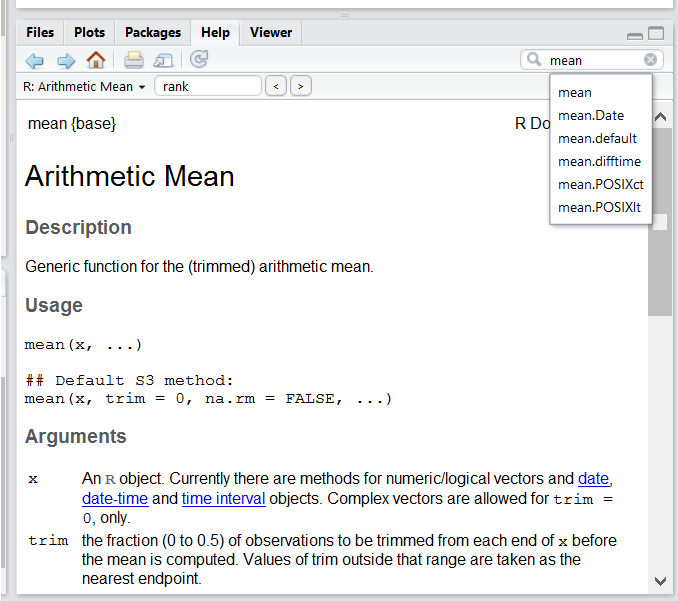
مدد حاصل کرنے کے تیز ترین طریقوں میں سے ایک RStudio ہیلپ انٹرفیس کا استعمال کرنا ہے۔ یہ پینل ڈیفالٹ طور پر RStudio کے نیچے دائیں جانب واقع پینل میں ہوتا ہے۔ جیسا کہ اسکرین شاٹ میں دیکھا جا سکتا ہے، “Mean” کا لفظ ٹائپ کرنے سے RStudio کوشش کرتا ہے کہ آپ کے لیے دلچسپ ہو سکنے والے کئی تجاویز بھی فراہم کرے۔ اس کے بعد وضاحت ڈسپلے ونڈو میں دکھائی جاتی ہے۔
مجھے وہ فنکشن کا نام معلوم ہے جسے میں استعمال کرنا چاہتا ہوں، لیکن مجھے یقین نہیں ہے کہ اسے کیسے استعمال کرنا ہے۔
اگر آپ کو کسی مخصوص فنکشن، مثال کے طور پر barplot() کے
حوالے سے مدد چاہیے، تو آپ یہ ٹائپ کر سکتے ہیں:
R
?barplot
اگر آپ کو صرف آرگومنٹس کے ناموں کو یاد کرنے کی ضرورت ہے، تو آپ اسے استعمال کر سکتے ہیں:
R
args(lm)
میں ایک ایسا فنکشن استعمال کرنا چاہتا ہوں جو X کرے، اس کے لیے یقیناً کوئی فنکشن ہوگا لیکن مجھے نہیں معلوم کہ وہ کون سا ہے…
اگر آپ کسی مخصوص کام کے لیے فانکشن تلاش کر رہے ہیں، تو آپ
help.search() فانکشن استعمال کر سکتے ہیں، جسے ڈبل کوئسشن
مارک ?? کے ذریعے کال کیا جاتا ہے۔ تاہم، یہ صرف انسٹال شدہ
پیکیجز میں ایسے ہیلپ پیجز کو تلاش کرتا ہے جو آپ کی تلاش کی درخواست سے
مطابقت رکھتے ہوں۔
R
??kruskal
اگر آپ کو وہ چیز نہیں مل رہی جو آپ تلاش کر رہے ہیں، تو آپ rdocumentation.org ویب سائٹ استعمال کر سکتے ہیں جو تمام دستیاب پیکجز کی ہیلپ فائلز میں تلاش کرتی ہے۔
آخر میں، گوگل یا انٹرنیٹ پر ایک عمومی تلاش “R <task>” اکثر یا تو آپ کو متعلقہ پیکیج کی دستاویزات تک لے جائے گا یا کسی مددگار فورم تک پہنچائے گا جہاں کسی اور نے پہلے ہی آپ کا سوال پوچھا ہو۔
میں پھنس گیا ہوں… مجھے ایک ایرر میسج مل رہا ہے جسے میں سمجھ نہیں پا رہا
سب سے پہلے ایرر میسج کو گوگل کر کے دیکھیں۔ تاہم، یہ ہمیشہ بہت اچھا کام نہیں کرتا کیونکہ اکثر پیکیج ڈویلپرز R کی فراہم کردہ ایرر کیچنگ پر انحصار کرتے ہیں۔ آپ کو عمومی ایرر میسجز ملتے ہیں جو مسئلے کی تشخیص کے لیے شاید زیادہ مددگار نہ ہوں (مثلاً “subscript out of bounds”)۔ اگر میسج بہت عمومی ہو، تو آپ اپنی کوئری میں اس فنکشن یا پیکیج کا نام بھی شامل کر سکتے ہیں جسے آپ استعمال کر رہے ہیں۔
تاہم، آپ کو Stack Overflow چیک کرنا چاہیے۔ [r] ٹیگ کا
استعمال کرتے ہوئے تلاش کریں۔ زیادہ تر سوالات کے جوابات پہلے ہی مل چکے
ہیں، لیکن چیلنج یہ ہے کہ جوابات تلاش کرنے کے لیے تلاش میں درست الفاظ کا
استعمال کیا جائے:
https://stackoverflow.com/questions/tagged/r
Introduction to R پروگرامنگ کے کم تجربے والے لوگوں کے لیے بھی پیچیدہ ہو سکتا ہے، لیکن یہ R زبان کی بنیادیں سمجھنے کے لیے ایک اچھی جگہ ہے۔
R FAQ بہت تفصیلی اور تکنیکی ہے لیکن یہ مفید معلومات سے بھرا ہوا ہے۔
مدد مانگنا
کسی سے مدد حاصل کرنے کی کلید یہ ہے کہ وہ آپ کے مسئلے کو تیزی سے سمجھ سکے۔ آپ کو اس بات کو جتنا ممکن ہو سکے آسان بنانا چاہیے کہ یہ پہچانا جا سکے کہ مسئلہ کہاں ہو سکتا ہے۔
اپنے مسئلے کی وضاحت کرنے کے لیے درست الفاظ استعمال کرنے کی کوشش کریں۔ مثال کے طور پر، ایک پیکیج کا مطلب لائبریری نہیں ہوتا۔ زیادہ تر لوگ سمجھ جائیں گے کہ آپ کیا مراد رکھے تھے، لیکن کچھ لوگوں کے پاس معنی کے اس فرق کے بارے میں بہت سخت رائے ہوتی ہے۔ اہم نکتہ یہ ہے کہ اس سے آپ کی مدد کرنے والے لوگوں کے لیے معاملہ الجھن پیدا ہو سکتا ہے۔ اپنے مسئلے کی وضاحت کرتے وقت جتنا ممکن ہو سکے درست رہیں۔
اگر ممکن ہو تو کوشش کریں کہ اس چیز کو جو کام نہیں کر رہی، ایک سادہ دوبارہ پیدا کیے جانے والے مثال میں تبدیل کر دیں۔ اگر آپ اپنے 50,000 قطاروں اور 10,000 کالموں والے ڈیٹا فریم کے بجائے ایک بہت چھوٹے ڈیٹا فریم کا استعمال کرتے ہوئے مسئلے کو دوبارہ پیدا کر سکتے ہیں، تو اپنے مسئلے کی وضاحت کے ساتھ وہ چھوٹا فریم فراہم کریں۔ جہاں مناسب ہو، اپنے کام کو عمومی بنانے کی کوشش کریں تاکہ وہ لوگ بھی جو آپ کے شعبے سے نہیں ہیں، سوال کو سمجھ سکیں۔ مثال کے طور پر، اپنے اصل ڈیٹا سیٹ کے ایک سب سیٹ کے بجائے، ایک چھوٹا (3 کالم، 5 قطاریں) عمومی فریم بنائیں۔ دوبارہ پیدا کیے جانے والے مثال کو لکھنے کے طریقے کے بارے میں مزید معلومات کے لیے Hadley Wickham کا یہ مضمون دیکھیں۔
کسی دوسرے شخص کے ساتھ کوئی آبجیکٹ شیئر کرنے کے لیے، اگر وہ نسبتاً
چھوٹا ہو، تو آپ فانکشن dput() استعمال کر سکتے ہیں۔ یہ R کوڈ
آؤٹ پٹ کرے گا جسے میموری میں موجود آبجیکٹ کی بالکل وہی نقل کرنے کے لیے
استعمال کیا جا سکتا ہے:
R
## iris is an example data frame that comes with R and head() is a
## function that returns the first part of the data frame
dput(head(iris))
OUTPUT
structure(list(Sepal.Length = c(5.1, 4.9, 4.7, 4.6, 5, 5.4),
    Sepal.Width = c(3.5, 3, 3.2, 3.1, 3.6, 3.9), Petal.Length = c(1.4,
    1.4, 1.3, 1.5, 1.4, 1.7), Petal.Width = c(0.2, 0.2, 0.2,
    0.2, 0.2, 0.4), Species = structure(c(1L, 1L, 1L, 1L, 1L,
    1L), levels = c("setosa", "versicolor", "virginica"), class = "factor")), row.names = c(NA,
6L), class = "data.frame")
اگر آبجیکٹ بڑا ہو، تو خام فائل (یعنی آپ کی CSV فائل) کے ساتھ اپنا اسکرپٹ بھی ایرر والے مقام تک فراہم کریں (اور اپنے مسئلے سے غیر متعلق تمام چیزیں ہٹا دیں)۔ متبادل طور پر، خاص طور پر اگر آپ کا سوال ڈیٹا فریم سے متعلق نہیں ہے، تو آپ کسی بھی R آبجیکٹ کو فائل میں محفوظ کر سکتے ہیں[^export]:
R
saveRDS(iris, file="/tmp/iris.rds")
تاہم، اس فائل کا مواد انسانی طور پر پڑھنے کے قابل نہیں ہے اور اسے
براہِ راست Stack Overflow پر پوسٹ نہیں کیا جا سکتا۔ اس کے بجائے، اسے ای
میل کے ذریعے کسی کو بھیجا جا سکتا ہے جو اسے readRDS() کمانڈ
کے ذریعے پڑھ سکے (یہاں یہ فرض کیا گیا ہے کہ ڈاؤن لوڈ کی گئی فائل صارف کی
ہوم ڈائریکٹری میں ایک Downloads فولڈر میں موجود ہے):
R
some_data <- readRDS(file="~/Downloads/iris.rds")
آخر میں، لیکن یقیناً کم اہمیت نہیں، ہمیشہ
sessionInfo() کے آؤٹ پٹ کو شامل کریں کیونکہ یہ آپ
کے پلیٹ فارم، R کے ورژنز اور آپ کے استعمال کردہ پیکجز، اور دیگر معلومات
کے بارے میں اہم فہمی فراہم کرتا ہے جو آپ کے مسئلے کو سمجھنے میں بہت
مددگار ثابت ہو سکتی ہیں۔
R
sessionInfo()
OUTPUT
R version 4.6.2 (2026-10-29)
Platform: aarch64-apple-darwin23
Running under: macOS Golden Gate 27.2.1

Matrix products: default
BLAS:   /Library/Frameworks/R.framework/Versions/4.6/Resources/lib/libRblas.0.dylib
LAPACK: /Library/Frameworks/R.framework/Versions/4.6/Resources/lib/libRlapack.dylib;  LAPACK version 3.12.1

locale:
[1] C.UTF-8/C.UTF-8/C.UTF-8/C/C.UTF-8/C.UTF-8

time zone: Asia/Tokyo
tzcode source: internal

attached base packages:
[1] stats     graphics  grDevices utils     datasets  methods   base

loaded via a namespace (and not attached):
[1] compiler_4.6.2 cli_3.6.6      tools_4.6.2    otel_0.2.0     knitr_1.52
[6] xfun_0.62      rlang_1.3.0    png_0.1-9      evaluate_1.0.5
مدد کے لیے کہاں پوچھیں؟
- کورس کے دوران آپ کے برابر بیٹھا ہوا شخص۔ ورکشاپ کے دوران اپنے پڑوسی سے بات کرنے، اپنے جوابات کا موازنہ کرنے اور مدد مانگنے میں ہچکچاہٹ محسوس نہ کریں۔
- آپ کے دوستانہ ساتھی: اگر آپ کسی ایسے شخص کو جانتے ہیں جس کا تجربہ آپ سے زیادہ ہو، تو وہ آپ کی مدد کرنے کے قابل اور خوشی کریں گے۔
- Stack Overflow: اگر آپ کے سوال کا پہلے سے کوئی جواب نہیں ملا ہے اور سوال اچھی طرح تیار کیا گیا ہے، تو امکان ہے کہ آپ کو 5 منٹ سے بھی کم وقت میں جواب مل جائے گا۔ یاد رکھیں کہ ایک اچھا سوال پوچھنے کے طریقے کے حوالے سے ان کی ہدایات پر عمل کریں۔
- R-help میلنگ لسٹ: اسے بہت سے لوگ پڑھتے ہیں (بشمول R کور ٹیم کے زیادہ تر ارکان)، بہت سے لوگ اس پر پوسٹس کرتے ہیں، لیکن اس کا انداز کافی خشک ہو سکتا ہے، اور یہ ہمیشہ نئے صارفین کے لیے بہت خوش آئند نہیں ہوتا۔ اگر آپ کا سوال جائز ہے، تو آپ کو غالباً بہت جلد جواب مل جائے گا، لیکن اس بات کی توقع نہ رکھیں کہ اس کے ساتھ مسکراہٹوں کے علامتیں ہوں گی۔ مزید برآں، یہاں کسی بھی دوسری جگہ کے مقابلے میں، درست ذخیرہ الفاظ کا استعمال کرنا یقینی بنائیں (ورنہ آپ کو اپنے سوال کا جواب دینے کے بجائے آپ کے الفاظ کے غلط استعمال کی نشاندہی کرنے والا جواب مل سکتا ہے)۔ آپ کو مزید کامیابی بھی ملے گی اگر آپ کا سوال کسی مخصوص پیکیج کے بجائے کسی بنیادی فنکشن کے بارے میں ہو۔
- اگر آپ کا سوال کسی مخصوص پیکج کے بارے میں ہے، تو دیکھیں کہ کیا اس کے
لیے کوئی میلنگ لسٹ موجود ہے۔ عام طور پر یہ پیکج کی DESCRIPTION فائل میں
شامل ہوتا ہے جس تک
packageDescription("name-of-package")کے ذریعے رسائی حاصل کی جا سکتی ہے۔ آپ پیکج کے مصنف کو براہِ راست ای میل بھیجنے، یا کوڈ ریپوزٹری (مثلاً GitHub) پر کوئی ایشو کھولنے کی کوشش بھی کر سکتے ہیں۔ - کچھ موضوعات کے لیے مخصوص میلنگ لسٹس (GIS، فائلوجینیٹکس، وغیرہ…) بھی موجود ہیں، ان کی مکمل فہرست R-project میلنگ لسٹ پیج پر دستیاب ہے۔
مزید وسائل
R میلنگ لسٹس کے لیے پوسٹنگ گائیڈ۔
R کی مدد کیسے مانگیں مفید رہنما خطوط۔
جون اسکیٹ کی یہ بلاگ پوسٹ میں پروگرامنگ سے متعلق سوالات پوچھنے کے طریقے کے بارے میں کافی جامع مشورے دیے گئے ہیں۔
مدد مانگتے وقت قابلِ تکرار مثالیں تیار کرنے کے لیے reprex پیکیج بہت مفید ہے۔ rOpenSci کمیونٹی کی کال “How to ask questions so they get answered” (Github لنک اور ویڈیو ریکارڈنگ) میں reprex پیکیج اور اس کے فلسفے کی ایک پریزنٹیشن شامل ہے۔
R پیکیجز
پیکیجز لوڈ کرنا
جیسا کہ ہم نے اوپر دیکھا ہے، R پیکیجز R میں بنیادی کردار ادا کرتے
ہیں۔ کسی پیکیج کی خصوصیات سے فائدہ اٹھانے کے لیے، بشرطیکہ وہ انسٹال ہو
چکا ہو، ہمیں پہلے اسے لوڈ کرنا ہوگا تاکہ اسے استعمال کر سکیں۔ یہ کام
library() فنکشن کے ذریعے کیا جاتا ہے۔ نیچے، ہم
ggplot2 کو لوڈ کرتے ہیں۔
R
library("ggplot2")
پیکیجز کی انسٹالیشن
ڈیفالٹ پیکیج ریپوزٹری Comprehensive R Archive Network (CRAN)
ہے، اور CRAN پر دستیاب کوئی بھی پیکیج install.packages()
فنکشن کے ذریعے انسٹال کیا جا سکتا ہے۔ نیچے، مثال کے طور پر، ہم
dplyr پیکیج انسٹال کرتے ہیں جس کے بارے میں ہم بعد میں جانیں
گے۔
R
install.packages("dplyr")
یہ کمانڈ dplyr پیکیج کے ساتھ ساتھ اس کے تمام ڈیپینڈنسیز،
یعنی وہ تمام پیکیجز جو اس کے کام کرنے کے لیے ضروری ہیں، انسٹال کرے
گی۔
R کا ایک اور بڑا پیکیج ریپوزٹری Bioconductor کے ذریعے برقرار رکھی
جاتی ہے۔ Bioconductor
پیکیجز کو ایک مخصوص پیکیج، یعنی BiocManager کے ذریعے
مینج اور انسٹال کیا جاتا ہے، جسے CRAN سے اس طرح انسٹال کیا جا سکتا ہے
کہ
R
install.packages("BiocManager")
انفرادی پیکیجز جیسے کہ SummarizedExperiment (ہم اسے بعد
میں استعمال کریں گے)، DESeq2 (RNA-Seq تجزیے کے لیے)، اور
Bioconductor یا CRAN سے کوئی بھی دیگر پیکیجز پھر
BiocManager::install کے ذریعے انسٹال کیے جا سکتے ہیں۔
R
BiocManager::install("SummarizedExperiment")
BiocManager::install("DESeq2")
ڈیفالٹ طور پر، BiocManager::install() آپ کے تمام انسٹال
شدہ پیکیجز کی بھی جانچ کرے گا اور دیکھے گا کہ کیا ان کے نئے ورژن دستیاب
ہیں۔ اگر دستیاب ہوں، تو یہ آپ کو انہیں دکھائے گا اور پوچھے گا کہ کیا آپ
Update all/some/none? [a/s/n]: کرنا چاہتے ہیں، اور پھر آپ
کے جواب کا انتظار کرے گا۔ اگرچہ آپ کو پیکیجز کے تازہ ترین ورژنز رکھنے کی
کوشش کرنی چاہیے، لیکن عملی طور پر ہم تجویز کرتے ہیں کہ پیکیجز کو لوڈ
کرنے سے پہلے صرف ایک نئے R سیشن میں ہی پیکیجز کو اپ ڈیٹ کیا جائے۔
- R اور RStudio کا استعمال شروع کریں
کمانڈ لائن کنسول سے براہِ راست R استعمال کرنے کے برعکس، ایسے دیگر سافٹ ویئر بھی موجود ہیں جو R کے ساتھ انٹرفیس کرتے ہیں اور اس کے ساتھ مربوط ہوتے ہیں، لیکن RStudio خاص طور پر مبتدیوں کے لیے انتہائی موزوں ہے اور ساتھ ہی بہت سی انتہائی جدید خصوصیات بھی فراہم کرتا ہے۔↩︎
یعنی ایسے اضافی اجزاء جو R میں نئی صلاحیتیں فراہم کرتے ہیں، جیسے کہ بائیو انفارمیٹکس ڈیٹا تجزیہ۔↩︎
اس کورس میں، ہم بائیو انفارمیٹکس کو بیولوجیکل یا بائیو میڈیکل ڈیٹا پر لاگو کیے گئے ڈیٹا سائنس کے طور پر دیکھتے ہیں۔↩︎
کہ کوئی شخص آپ کا مستقبل کا آپ ہو سکتا ہے، اور بہت امکان ہے کہ وہ چند ماہ یا سالوں بعد، جب تجزیے کیے گئے ہوں، آپ کا مستقبل کا آپ ہی ہوگا۔↩︎
ہم یہاں ان میں سے زیادہ تر (شماریات کے علاوہ) کا تعارف کرائیں گے، لیکن R کے ذریعے جو کچھ بھی ممکن ہے، اس کا محض ایک مختصر جائزہ ہی لے پائیں گے۔↩︎
Content from R کا تعارف
Last updated on 2026-11-11 | Edit this page
Overview
Questions
- R میں پہلی کمانڈز
Objectives
- R سے متعلق درج ذیل اصطلاحات کی تعریف کریں: آبجیکٹ، اسائن، کال، فنکشن، آرگومنٹس، آپشنز۔
- R میں آبجیکٹس کو ویلیوز تفویض کریں۔
- سیکھیں کہ آبجیکٹس کا نام کیسے لگایا جائے
- اسکرپٹ کو معلومات فراہم کرنے کے لیے کمنٹس کا استعمال کریں۔
- R میں سادہ حسابی آپریشنز حل کریں۔
- فنکشنز کو کال کریں اور ان کے ڈیفالٹ آپشنز کو تبدیل کرنے کے لیے آرگومنٹس کا استعمال کریں۔
- ویکٹرز کے مواد کا معائنہ کریں اور ان کے مواد میں تبدیلیاں کریں۔
- ویکٹرز سے سب سیٹس حاصل کریں اور اقدار نکالیں۔
- ناموجود اقدار والے ویکٹرز کا تجزیہ کریں۔
یہ ایپیسوڈ Data Carpentries کے Data Analysis and Visualisation in R for Ecologists اسباق پر مبنی ہے۔
R میں آبجیکٹس کی تخلیق
آپ کنسول میں محض ریاضی ٹائپ کر کے R سے آؤٹ پٹ حاصل کر سکتے ہیں:
R
3 + 5
OUTPUT
[1] 8R
12 / 7
OUTPUT
[1] 1.714286تاہم، مفید اور دلچسپ کام کرنے کے لیے، ہمیں آبجیکٹس کو
ویلیوز تفویض کرنے کی ضرورت ہوتی ہے۔ کسی آبجیکٹ کو بنانے کے لیے،
ہمیں اسے ایک نام دینا ہوگا جس کے بعد ایسائمنٹ آپریٹر <-
اور وہ ویلیو دینی ہوگی جو ہم اسے دینا چاہتے ہیں:
R
weight_kg <- 55
<- اسائنمنٹ آپریٹر ہے۔ یہ دائیں جانب موجود اقدار کو
بائیں جانب موجود آبجیکٹس کو اسائن کرتا ہے۔ چنانچہ،
x <- 3 چلانے کے بعد، x کی اقدار
3 ہو جاتی ہے۔ اس ایرو کو اس طرح سمجھا جا سکتا ہے کہ 3
x میں جاتا ہے۔ تاریخی وجوہات کی بنا پر، آپ
اسائنمنٹس کے لیے = بھی استعمال کر سکتے ہیں، لیکن ہر سیاق و
سباق میں نہیں۔ سنٹیکس میں معمولی
فرق کی وجہ سے، اسائنمنٹس کے لیے ہمیشہ <- استعمال
کرنا ایک بہتر طریقہ کار ہے۔
RStudio میں، Alt + - ٹائپ کرنے سے (-
کی کی کے ساتھ ہی Alt دبائیں) پی سی پر ایک ہی کی اسٹروک میں
<- لکھا جائے گا، جبکہ Mac پر Option +
- ٹائپ کرنے سے (- کی کی کے ساتھ ہی
Option دبائیں) وہی کام ہو جائے گا۔
ویری ایبلز کے نام رکھنا
آبجیکٹس کو کوئی بھی نام دیا جا سکتا ہے جیسے کہ x،
current_temperature، یا subject_id۔ آپ چاہتے
ہیں کہ آپ کے آبجیکٹ کے نام واضح ہوں اور بہت طویل نہ ہوں۔ ان کا آغاز نمبر
سے نہیں ہو سکتا (2x درست نہیں ہے، لیکن x2 درست
ہے)۔ R کیس سینسیٹیو ہے (مثلاً، weight_kg اور
Weight_kg مختلف ہیں)۔ کچھ ایسے نام ہیں جنہیں استعمال نہیں
کیا جا سکتا کیونکہ وہ R میں بنیادی فنکشنز کے نام ہیں (مثلاً،
if، else، for؛ مکمل فہرست کے لیے
Reserved
Words in R مینوئل پیج دیکھیں)۔ عام طور پر، چاہے وہ اجازت یافتہ ہی
کیوں نہ ہو، بہتر ہے کہ دیگر فنکشن کے ناموں (مثلاً، c،
T، mean، data، df،
weights) کا استعمال نہ کیا جائے۔ اگر کوئی شک ہو، تو ہیلپ
چیک کریں تاکہ دیکھا جا سکے کہ آیا وہ نام پہلے سے استعمال میں ہے یا نہیں۔
آبجیکٹ کے نام میں ڈاٹس (.) سے بچنا بھی بہتر ہے جیسا کہ
my.dataset میں ہے۔ تاریخی وجوہات کی بنا پر R میں بہت سے
فنکشنز کے نام میں ڈاٹس ہیں، لیکن چونکہ ڈاٹس کا R (میتھڈز کے لیے) اور
دیگر پروگرامنگ زبانوں میں ایک خاص معنی ہے، اس لیے ان سے بچنا ہی بہتر ہے۔
یہ بھی تجویز کیا جاتا ہے کہ آبجیکٹ کے ناموں کے لیے اسم استعمال کیے
جائیں، اور فنکشن کے ناموں کے لیے فعل۔ اپنے کوڈ کی اسٹائلنگ میں تسلسل
برقرار رکھنا ضروری ہے (جیسے کہ آپ سپیس کہاں رکھتے ہیں، آبجیکٹس کے نام
کیسے رکھتے ہیں، وغیرہ)۔ کوڈنگ کا ایک مستقل انداز استعمال کرنے سے آپ کا
کوڈ آپ کے لیے اور آپ کے ساتھیوں کے لیے پڑھنے میں زیادہ واضح ہو جاتا ہے۔
R میں، کچھ مقبول اسٹائل گائیڈز Google کی، tidyverse کی اسٹائل اور Bioconductor
اسٹائل گائیڈ ہیں۔ tidyverse کی گائیڈ بہت جامع ہے اور شروع میں شاید
بہت زیادہ لگے۔ آپ اپنے کوڈ کی اسٹائلنگ میں مسائل کو خودکار طور پر چیک
کرنے کے لیے lintr
پیکیج انسٹال کر سکتے ہیں۔
آبجیکٹس بمقابلہ ویری ایبلز: جو چیزیں
Rمیںobjectsکے طور پر جانی جاتی ہیں، انہیں بہت سی دیگر پروگرامنگ زبانوں میںvariablesکہا جاتا ہے۔ سیاق و سباق کے لحاظ سے،objectاورvariableکے معنی بالکل مختلف ہو سکتے ہیں۔ تاہم، اس سبق میں، ان دونوں الفاظ کا استعمال مترادف طور پر کیا گیا ہے۔ مزید معلومات کے لیے یہاں دیکھیں۔
کسی آبجیکٹ کو ویلیو تفویض کرتے وقت، R کچھ بھی پرنٹ نہیں کرتا۔ آپ پیرنتھس استعمال کر کے یا آبجیکٹ کا نام ٹائپ کر کے R کو ویلیو پرنٹ کرنے پر مجبور کر سکتے ہیں:
R
weight_kg <- 55    # doesn't print anything
(weight_kg <- 55)  # but putting parenthesis around the call prints the value of `weight_kg`
OUTPUT
[1] 55R
weight_kg # and so does typing the name of the object
OUTPUT
[1] 55اب جب کہ R کے میموری میں weight_kg موجود ہے، تو ہم اس کے
ساتھ حسابی کارروائی کر سکتے ہیں۔ مثال کے طور پر، ہم اس وزن کو پاؤنڈز میں
تبدیل کرنا چاہیں گے (پاؤنڈز میں وزن، کلوگرام میں وزن سے 2.2 گنا ہوتا
ہے):
R
2.2 * weight_kg
OUTPUT
[1] 121ہم کسی آبجیکٹ کی ویلیو کو نئی ویلیو تفویض کر کے بھی تبدیل کر سکتے ہیں:
R
weight_kg <- 57.5
2.2 * weight_kg
OUTPUT
[1] 126.5اس کا مطلب یہ ہے کہ کسی ایک آبجیکٹ کو ویلیو تفویض کرنے سے دیگر
آبجیکٹس کی ویلیوز تبدیل نہیں ہوتیں۔ مثال کے طور پر، آئیے جانور کے وزن کو
پاؤنڈز میں ایک نئے آبجیکٹ، weight_lb میں محفوظ کریں:
R
weight_lb <- 2.2 * weight_kg
اور پھر weight_kg کو 100 میں تبدیل کریں۔
R
weight_kg <- 100
چیلنج:
آپ کے خیال میں آبجیکٹ weight_lb کا موجودہ مواد کیا ہے؟
126.5 یا 220؟
تبصرے
R میں کمنٹ کا کریکٹر # ہے، اسکرپٹ میں # کے
دائیں جانب موجود کوئی بھی چیز R کے ذریعے نظر انداز کر دی جائے گی۔ اپنے
اسکرپٹس میں نوٹس اور وضاحتیں چھوڑنا مفید ہوتا ہے۔
RStudio ایک پیراگراف کو کمنٹ کرنے یا کمنٹ سے آزاد کرنے کو آسان بنا دیتا ہے: جن لائنوں کو آپ کمنٹ کرنا چاہتے ہیں انہیں منتخب کرنے کے بعد، اپنے کی بورڈ پر بیک وقت Ctrl + Shift + C دبائیں۔ اگر آپ صرف ایک لائن کو کمنٹ کرنا چاہتے ہیں، تو آپ کرسر کو اس لائن کی کسی بھی جگہ رکھ سکتے ہیں (یعنی پوری لائن کو منتخب کرنے کی ضرورت نہیں ہے)، پھر Ctrl + Shift + C دبائیں۔
چیلنج
مندرجہ ذیل میں ہر اسٹیٹمنٹ کے بعد کیا ویلیوز ہیں؟
R
mass <- 47.5            # mass?
age  <- 122             # age?
mass <- mass * 2.0      # mass?
age  <- age - 20        # age?
mass_index <- mass/age  # mass_index?
فنکشنز اور ان کے آرگومنٹس
فنکشنز “پہلے سے تیار کردہ اسکرپٹس” ہوتے ہیں جو کمانڈز کے زیادہ پیچیدہ
مجموعوں کو خودکار بناتے ہیں، جن میں مختلف کارروائیاں، اسائنمنٹس وغیرہ
شامل ہیں۔ بہت سے فنکشنز پہلے سے متعین ہوتے ہیں، یا R پیکیجز کو
امپورٹ کر کے دستیاب کیے جا سکتے ہیں (اس کے بارے میں مزید تفصیل بعد میں
دی جائے گی)۔ ایک فنکشن کو عام طور پر ایک یا ایک سے زیادہ ان پٹس ملتے ہیں
جنہیں آرگومنٹس کہا جاتا ہے۔ فنکشنز اکثر (لیکن ہمیشہ نہیں) ایک
ویلیو واپس کرتے ہیں۔ ایک عام مثال sqrt() فنکشن ہو
سکتا ہے۔ ان پٹ (آرگومنٹ) ایک عدد ہونا ضروری ہے، اور واپسی کی ویلیو
(دراصل، آؤٹ پٹ) اس عدد کا مربع جذر ہے۔ کسی فنکشن کو چلانے (‘رن کرنے’) کو
فنکشن کو کال کرنا کہا جاتا ہے۔ فنکشن کال کی ایک مثال یہ ہے:
R
b <- sqrt(a)
یہاں، a کی ویلیو sqrt() فنکشن کو دی جاتی
ہے، sqrt() فنکشن مربع جذر کا حساب لگاتا ہے، اور وہ ویلیو
واپس کرتا ہے جسے پھر آبجیکٹ b کو اسائن کر دیا جاتا ہے۔ یہ
فنکشن بہت سادہ ہے، کیونکہ یہ صرف ایک آرگومنٹ لیتا ہے۔
کسی فنکشن کی واپسی کی ‘ویلیو’ کا عددی ہونا ضروری نہیں ہے (جیسا کہ
sqrt() کی ہے)، اور اس کا ایک ہی آئٹم ہونا بھی ضروری نہیں
ہے: یہ چیزوں کا ایک سیٹ، یا یہاں تک کہ ایک ڈیٹا سیٹ بھی ہو سکتا ہے۔ ہم
اسے تب دیکھیں گے جب ہم R میں ڈیٹا فائلیں پڑھیں گے۔
آرگومنٹس کچھ بھی ہو سکتے ہیں، نہ صرف اعداد یا فائل کے نام، بلکہ دیگر آبجیکٹس بھی۔ ہر آرگومنٹ کا درست مطلب ہر فنکشن کے لحاظ سے مختلف ہوتا ہے، اور اسے دستاویزات میں تلاش کرنا پڑتا ہے (نیچے دیکھیں)۔ کچھ فنکشنز ایسے آرگومنٹس لیتے ہیں جنہیں یا تو صارف کے ذریعے متعین کیا جا سکتا ہے، یا اگر وہ چھوڑ دیے جائیں، تو انہیں ایک ڈیفالٹ ویلیو مل جاتی ہے: انہیں آپشنز کہا جاتا ہے۔ آپشنز کا استعمال عام طور پر فنکشن کے کام کرنے کے طریقے کو تبدیل کرنے کے لیے کیا جاتا ہے، جیسے کہ کیا وہ ‘غلط ویلیوز’ کو نظر انداز کرے، یا پلاٹ میں کس سمبل کا استعمال کرنا ہے۔ تاہم، اگر آپ کسی مخصوص چیز کے خواہش مند ہیں، تو آپ اپنی پسند کی کوئی ویلیو متعین کر سکتے ہیں جو ڈیفالٹ کے بجائے استعمال کی جائے گی۔
آئیے ایک ایسے فنکشن کو آزمائیں جو متعدد آرگومنٹس لے سکے:
round()۔
R
round(3.14159)
OUTPUT
[1] 3یہاں، ہم نے round() کو صرف ایک آرگومنٹ،
3.14159، کے ساتھ کال کیا ہے، اور اس نے 3 کی
ویلیو واپس کر دی ہے۔ اس کی وجہ یہ ہے کہ ڈیفالٹ طریقہ قریب ترین صحیح عدد
تک راؤنڈ کرنا ہے۔ اگر ہمیں مزید ڈیجٹس چاہئیں تو ہم round
فنکشن کے بارے میں معلومات حاصل کر کے دیکھ سکتے ہیں کہ ایسا کیسے کیا
جائے۔ ہم args(round) استعمال کر سکتے ہیں یا
?round کے ذریعے اس فنکشن کی ہیلپ دیکھ سکتے ہیں۔
R
args(round)
OUTPUT
function (x, digits = 0, ...)
NULL
R
?round
ہم دیکھتے ہیں کہ اگر ہمیں ہندسوں کی تعداد بدلنی ہو، تو ہم
digits=2 لکھ سکتے ہیں، یا اس میں اپنی مطلوبہ تعداد مقرر کر
سکتے ہیں۔
R
round(3.14159, digits = 2)
OUTPUT
[1] 3.14اگر آپ آرگومنٹس کو بالکل اسی ترتیب میں فراہم کریں جیسا کہ وہ تعریف کیے گئے ہیں، تو آپ کو ان کے نام لگانے کی ضرورت نہیں ہوتی:
R
round(3.14159, 2)
OUTPUT
[1] 3.14اور اگر آپ آرگومنٹس کے نام لگائیں، تو آپ ان کی ترتیب بدل سکتے ہیں:
R
round(digits = 2, x = 3.14159)
OUTPUT
[1] 3.14یہ ایک بہتر طریقہ کار ہے کہ آپ اپنے فنکشن کال میں لازمی آرگومنٹس (جیسے کہ وہ نمبر جسے آپ راؤنڈ کر رہے ہیں) کو پہلے رکھیں، اور تمام اختیاری آرگومنٹس کے نام واضح کریں۔ اگر آپ ایسا نہیں کرتے، تو آپ کے کوڈ کو پڑھنے والے شخص کو یہ سمجھنے کے لیے کہ آپ کیا کر رہے ہیں، ایسے آرگومنٹس والے فنکشن کی تعریف تلاش کرنی پڑ سکتی ہے جن سے وہ واقف نہ ہوں۔ آرگومنٹس کے نام واضح کر کے آپ فنکشن انٹرفیس میں مستقبل میں ہونے والی ممکنہ تبدیلیوں سے بھی خود کو محفوظ رکھ رہے ہیں، جس کے نتیجے میں موجودہ آرگومنٹس کے درمیان نئے آرگومنٹس شامل ہو سکتے ہیں۔
ویکٹرز اور ڈیٹا اقسام
ویکٹر R میں سب سے عام اور بنیادی ڈیٹا ٹائپ ہے، اور یہ تقریباً R کا
بنیادی ذریعہ ہے۔ ایک ویکٹر اقدار کے ایک سلسلے پر مشتمل ہوتا ہے، جیسے کہ
اعداد یا حروف۔ ہم c() فنکشن کا استعمال کرتے ہوئے ایک ویکٹر
کو اقدار کا ایک سلسلہ تفویض کر سکتے ہیں۔ مثال کے طور پر، ہم جانوروں کے
وزن کا ایک ویکٹر بنا سکتے ہیں اور اسے ایک نئے آبجیکٹ
weight_g کو تفویض کر سکتے ہیں:
R
weight_g <- c(50, 60, 65, 82)
weight_g
OUTPUT
[1] 50 60 65 82ایک ویکٹر میں حروف بھی ہو سکتے ہیں:
R
molecules <- c("dna", "rna", "protein")
molecules
OUTPUT
[1] "dna" "rna" "protein"یہاں “dna”، “rna” وغیرہ کے گرد کوٹیشنز ضروری ہیں۔ کوٹیشنز کے بغیر R
یہ فرض کرے گا کہ dna، rna اور
protein نامی آبجیکٹس موجود ہیں۔ چونکہ یہ آبجیکٹس R کی
میموری میں موجود نہیں ہیں، اس لیے ایک ایرر میسج آئے گا۔
ایسے بہت سے فنکشنز موجود ہیں جو آپ کو ایک ویکٹر کے مواد کا معائنہ
کرنے کی سہولت دیتے ہیں۔ length() آپ کو بتاتا ہے کہ کسی خاص
ویکٹر میں کتنے عناصر موجود ہیں:
R
length(weight_g)
OUTPUT
[1] 4R
length(molecules)
OUTPUT
[1] 3ایک ویکٹر کی ایک اہم خصوصیت یہ ہے کہ اس کے تمام عناصر ایک ہی قسم کا
ڈیٹا ہوتے ہیں۔ فنکشن class() کسی آبجیکٹ کی کلاس (عنصر کی
قسم) کو ظاہر کرتا ہے:
R
class(weight_g)
OUTPUT
[1] "numeric"R
class(molecules)
OUTPUT
[1] "character"فنکشن str() کسی آبجیکٹ کی ساخت اور اس کے عناصر کا ایک
جائزہ فراہم کرتا ہے۔ یہ بڑے اور پیچیدہ آبجیکٹس کے ساتھ کام کرتے وقت ایک
مفید فنکشن ہے:
R
str(weight_g)
OUTPUT
num [1:4] 50 60 65 82R
str(molecules)
OUTPUT
chr [1:3] "dna" "rna" "protein"آپ اپنے ویکٹر میں دیگر عناصر شامل کرنے کے لیے c() فنکشن
استعمال کر سکتے ہیں:
R
weight_g <- c(weight_g, 90) # add to the end of the vector
weight_g <- c(30, weight_g) # add to the beginning of the vector
weight_g
OUTPUT
[1] 30 50 60 65 82 90پہلی لائن میں، ہم اصل ویکٹر weight_g لیتے ہیں، اس کے آخر
میں ویلیو 90 شامل کرتے ہیں، اور نتیجے کو دوبارہ
weight_g میں محفوظ کرتے ہیں۔ پھر ہم اس کے آغاز میں ویلیو
30 شامل کرتے ہیں، اور ایک بار پھر نتیجے کو
weight_g میں محفوظ کرتے ہیں۔
ہم ایک ویکٹر کو بڑھانے یا ڈیٹا سیٹ تیار کرنے کے لیے اسے بار بار کر سکتے ہیں۔ پروگرامنگ کے دوران، یہ ان نتائج کو شامل کرنے کے لیے مفید ہو سکتا ہے جو ہم جمع کر رہے ہیں یا حساب کر رہے ہیں۔
ایک اٹامک ویکٹر R کی سادہ ترین ڈیٹا
ٹائپ ہے اور ایک ہی قسم کا لینیئر ویکٹر ہوتا ہے۔ اوپر، ہم نے ان
6 بنیادی اٹامک ویکٹر اقسام میں سے 2 دیکھے ہیں جو R
استعمال کرتا ہے: "character" اور "numeric" (یا
"double")۔ یہ بنیادی اجزاء ہیں جن سے تمام R آبجیکٹس تیار
کیے جاتے ہیں۔ دیگر 4 اٹامک ویکٹر اقسام یہ ہیں:
-
"logical"TRUEاورFALSEکے لیے (بولین ڈیٹا ٹائپ) -
"integer"صحیح اعداد کے لیے (مثلاً،2L،LR کو یہ ظاہر کرتا ہے کہ یہ ایک صحیح عدد ہے) -
"complex"کے ذریعے حقیقی اور تخیلی حصوں والے پیچیدہ اعداد کی نمائندگی کی جائے گی (مثلاً،1 + 4i) اور ان کے بارے میں ہم صرف اتنا ہی کہیں گے۔ -
"raw"ان بٹ اسٹریمز کے لیے جن پر ہم مزید بحث نہیں کریں گے
آپ typeof() فنکشن کا استعمال کرتے ہوئے اور اپنا ویکٹر
آرگومنٹ کے طور پر فراہم کر کے اپنے ویکٹر کی ٹائپ چیک کر سکتے ہیں۔
ویکٹرز ان بہت سے ڈیٹا اسٹرکچرز میں سے ایک ہیں جو R
استعمال کرتا ہے۔ دیگر اہم اسٹرکچرز میں لسٹس (list)، میٹرکسز
(matrix)، ڈیٹا فریمز (data.frame)، فیکٹرز
(factor) اور ارےز (array) شامل ہیں۔
چیلنج:
ہم نے دیکھا ہے کہ اٹامک ویکٹرز کی اقسام character، numeric (یا double)، integer، اور logical ہو سکتی ہیں۔ لیکن کیا ہوگا اگر ہم ایک ہی ویکٹر میں ان اقسام کو ملا کر استعمال کرنے کی کوشش کریں؟
R انہیں ضمنی طور پر ایک ہی ٹائپ میں تبدیل کر دیتا ہے
چیلنج:
ان میں سے ہر مثال میں کیا ہوگا؟ (اشارہ: اپنے آبجیکٹس کی ڈیٹا ٹائپ چیک
کرنے کے لیے class() استعمال کریں اور ان کے نام لکھ کر
دیکھیں کہ کیا ہوتا ہے):
R
num_char <- c(1, 2, 3, "a")
num_logical <- c(1, 2, 3, TRUE, FALSE)
char_logical <- c("a", "b", "c", TRUE)
tricky <- c(1, 2, 3, "4")
R
class(num_char)
OUTPUT
[1] "character"R
num_char
OUTPUT
[1] "1" "2" "3" "a"R
class(num_logical)
OUTPUT
[1] "numeric"R
num_logical
OUTPUT
[1] 1 2 3 1 0R
class(char_logical)
OUTPUT
[1] "character"R
char_logical
OUTPUT
[1] "a" "b" "c" "TRUE"R
class(tricky)
OUTPUT
[1] "character"R
tricky
OUTPUT
[1] "1" "2" "3" "4"چیلنج:
آپ کے خیال میں یہ کیوں ہوتا ہے؟
ویکٹرز صرف ایک ہی ڈیٹا ٹائپ کے ہو سکتے ہیں۔ R اس ویکٹر کے مواد کو تبدیل (coerce) کرنے کی کوشش کرتا ہے تاکہ ایک ایسی مشترکہ ڈیٹا ٹائپ حاصل کی جا سکے جس میں کوئی معلومات ضائع نہ ہوں۔
چیلنج:
مندرجہ ذیل مثال میں combined_logical کی کتنی اقدار
"TRUE" (ایک کیریکٹر کے طور پر) ہیں:
R
num_logical <- c(1, 2, 3, TRUE)
char_logical <- c("a", "b", "c", TRUE)
combined_logical <- c(num_logical, char_logical)
صرف ایک۔ پچھلے ڈیٹا اقسام کی کوئی یادداشت نہیں رہتی، اور کوئرشن
(coercion) اس وقت ہوتی ہے جب ویکٹر کو پہلی بار ایویلیویٹ (evaluate) کیا
جاتا ہے۔ لہٰذا، num_logical میں موجود TRUE کو
combined_logical میں "1" میں تبدیل ہونے سے
پہلے 1 میں تبدیل کر دیا جاتا ہے۔
R
combined_logical
OUTPUT
[1] "1" "2" "3" "1" "a" "b" "c" "TRUE"چیلنج:
R میں، ہم ایک کلاس سے دوسری کلاس میں آبجیکٹس کو تبدیل کرنے کے عمل کو coercion کہتے ہیں۔ یہ تبدیلیاں ایک ہائرارکی کے مطابق ہوتی ہیں، جس میں کچھ اقسام کو ترجیحی طور پر دیگر اقسام میں تبدیل کیا جاتا ہے۔ کیا آپ ایک ایسا ڈایگرام بنا سکتے ہیں جو اس ہائرارکی کی نمائندگی کرے کہ ان ڈیٹا اقسام کو کس طرح تبدیل کیا جاتا ہے؟
logical → numeric → character ← logical
ویکٹرز کی سبسیٹنگ
اگر ہم ایک ویکٹر سے ایک یا کئی اقدار نکالنا چاہتے ہیں، تو ہمیں مربع بریکٹس میں ایک یا کئی انڈیکسز فراہم کرنے ہوں گے۔ مثال کے طور پر:
R
molecules <- c("dna", "rna", "peptide", "protein")
molecules[2]
OUTPUT
[1] "rna"R
molecules[c(3, 2)]
OUTPUT
[1] "peptide" "rna" ہم انڈیکسز کو دہرا کر ایک ایسا آبجیکٹ بھی بنا سکتے ہیں جس میں اصل آبجیکٹ کے مقابلے میں زیادہ عناصر ہوں:
R
more_molecules <- molecules[c(1, 2, 3, 2, 1, 4)]
more_molecules
OUTPUT
[1] "dna" "rna" "peptide" "rna" "dna" "protein"R کے انڈیکسز 1 سے شروع ہوتے ہیں۔ پروگرامنگ زبانیں جیسے کہ Fortran، MATLAB، Julia اور R، گنتی 1 سے شروع کرتی ہیں، کیونکہ انسان عام طور پر ایسا ہی کرتے ہیں۔ C خاندان کی زبانیں (بشمول C++، Java، Perl اور Python) 0 سے گنتی کرتی ہیں کیونکہ کمپیوٹرز کے لیے یہ زیادہ آسان ہوتا ہے۔
آخر میں، منفی انڈیکسز استعمال کر کے ویکٹر کے کچھ متعین عناصر کو چھوڑ کر باقی تمام عناصر حاصل کرنا بھی ممکن ہے:
R
molecules ## all molecules
OUTPUT
[1] "dna" "rna" "peptide" "protein"R
molecules[-1] ## all but the first one
OUTPUT
[1] "rna" "peptide" "protein"R
molecules[-c(1, 3)] ## all but 1st/3rd ones
OUTPUT
[1] "rna" "protein"R
molecules[c(-1, -3)] ## all but 1st/3rd ones
OUTPUT
[1] "rna" "protein"شرطی سبسیٹنگ
سبسیٹنگ کا ایک اور عام طریقہ لاجیکل ویکٹر کا استعمال کرنا ہے۔
TRUE اسی انڈیکس والے عنصر کو منتخب کرے گا، جبکہ
FALSE ایسا نہیں کرے گا:
R
weight_g <- c(21, 34, 39, 54, 55)
weight_g[c(TRUE, FALSE, TRUE, TRUE, FALSE)]
OUTPUT
[1] 21 39 54عام طور پر، یہ لوجیکل ویکٹرز ہاتھ سے ٹائپ نہیں کیے جاتے، بلکہ دیگر فنکشنز یا لوجیکل ٹیسٹس کا نتیجہ ہوتے ہیں۔ مثال کے طور پر، اگر آپ صرف 50 سے زائد اقدار کا انتخاب کرنا چاہتے ہوں:
R
## will return logicals with TRUE for the indices that meet
## the condition
weight_g > 50
OUTPUT
[1] FALSE FALSE FALSE TRUE TRUER
## so we can use this to select only the values above 50
weight_g[weight_g > 50]
OUTPUT
[1] 54 55آپ & (دونوں شرائط سچ ہیں، AND) یا | (کم
از کم ایک شرط سچ ہے، OR) کا استعمال کرتے ہوئے متعدد ٹیسٹوں کو یکجا کر
سکتے ہیں:
R
weight_g[weight_g < 30 | weight_g > 50]
OUTPUT
[1] 21 54 55R
weight_g[weight_g >= 30 & weight_g == 21]
OUTPUT
numeric(0)یہاں، < کا مطلب “سے چھوٹا”، > کا مطلب
“سے بڑا”، >= کا مطلب “سے بڑا یا اس کے برابر”، اور
== کا مطلب “کے برابر” ہے۔ دوہرے برابر کا نشان
== بائیں اور دائیں جانب کی عددی برابری کی جانچ کرتا ہے، اور
اسے ایک واحد = نشان کے ساتھ خلط ملط نہیں کیا جانا چاہیے، جو
متغیر کی تفویض (variable assignment) کرتا ہے (<- کی
طرح)۔
ایک عام کام ویکٹر میں مخصوص سٹرنگز کی تلاش کرنا ہے۔ کئی اقدار کے ساتھ
برابری کی جانچ کرنے کے لیے “or” آپریٹر | استعمال کیا جا
سکتا ہے، لیکن یہ جلد ہی تھکا دینے والا کام بن سکتا ہے۔ فنکشن
%in% آپ کو یہ جانچنے کی اجازت دیتا ہے کہ کیا سرچ ویکٹر کے
کسی بھی عنصر کو پایا گیا ہے:
R
molecules <- c("dna", "rna", "protein", "peptide")
molecules[molecules == "rna" | molecules == "dna"] # returns both rna and dna
OUTPUT
[1] "dna" "rna"R
molecules %in% c("rna", "dna", "metabolite", "peptide", "glycerol")
OUTPUT
[1] TRUE TRUE FALSE TRUER
molecules[molecules %in% c("rna", "dna", "metabolite", "peptide", "glycerol")]
OUTPUT
[1] "dna" "rna" "peptide"چیلنج:
کیا آپ یہ سمجھ سکتے ہیں کہ "four" > "five" کیوں
TRUE واپس کرتا ہے؟
R
"four" > "five"
OUTPUT
[1] TRUEسٹرنگز پر > یا < استعمال کرتے وقت، R
ان کی حروفِ تہجی کی ترتیب کا موازنہ کرتا ہے۔ یہاں "four"
حروفِ تہجی کی ترتیب میں "five" کے بعد آتا ہے، اور اس لیے یہ
اس سے بڑا ہے۔
نام
ایک ویکٹر کے ہر عنصر کا نام رکھنا ممکن ہے۔ نیچے دیا گیا کوڈ چنک ایک ایسے ابتدائی ویکٹر کو دکھاتا ہے جس میں کوئی نام نہیں ہیں، اور یہ بھی دکھاتا ہے کہ نام کیسے سیٹ کیے جاتے ہیں اور کیسے حاصل کیے جاتے ہیں۔
R
x <- c(1, 5, 3, 5, 10)
names(x) ## no names
OUTPUT
NULLR
names(x) <- c("A", "B", "C", "D", "E")
names(x) ## now we have names
OUTPUT
[1] "A" "B" "C" "D" "E"جب کسی ویکٹر کے نام ہوں، تو ان کے انڈیکس کے علاوہ، ان کے نام کے ذریعے بھی عناصر تک رسائی حاصل کرنا ممکن ہے۔
R
x[c(1, 3)]
OUTPUT
A C
1 3
R
x[c("A", "C")]
OUTPUT
A C
1 3
غیر موجود ڈیٹا
چونکہ R کو ڈیٹا سیٹس کے تجزیے کے لیے ڈیزائن کیا گیا تھا، اس میں مفقود
ڈیٹا کا تصور شامل ہے (جو دیگر پروگرامنگ زبانوں میں غیر معمولی ہے)۔
ویکٹرز میں مفقود ڈیٹا کو NA کے طور پر ظاہر کیا جاتا ہے۔
اعداد و شمار پر آپریشنز کرتے وقت، زیادہ تر فنکشنز NA
واپس کر دیں گے اگر آپ کے پاس موجود ڈیٹا میں غیر موجود اقدار شامل ہوں۔ یہ
خصوصیت ان صورتوں کو نظر انداز کرنا مشکل بنا دیتی ہے جہاں آپ غیر موجود
ڈیٹا کے ساتھ کام کر رہے ہوں۔ آپ غیر موجود اقدار کو نظر انداز کرتے ہوئے
نتیجہ کے لیے آرگومنٹ na.rm = TRUE شامل کر سکتے ہیں۔
R
heights <- c(2, 4, 4, NA, 6)
mean(heights)
OUTPUT
[1] NAR
max(heights)
OUTPUT
[1] NAR
mean(heights, na.rm = TRUE)
OUTPUT
[1] 4R
max(heights, na.rm = TRUE)
OUTPUT
[1] 6اگر آپ کے ڈیٹا میں غیر موجود اقدار شامل ہیں، تو آپ شاید فنکشنز
is.na()، na.omit()، اور
complete.cases() سے واقف ہونا چاہیں گے۔ مثالوں کے لیے نیچے
دیکھیں۔
R
## Extract those elements which are not missing values.
heights[!is.na(heights)]
OUTPUT
[1] 2 4 4 6R
## Returns the object with incomplete cases removed.
## The returned object is an atomic vector of type `"numeric"`
## (or `"double"`).
na.omit(heights)
OUTPUT
[1] 2 4 4 6
attr(,"na.action")
[1] 4
attr(,"class")
[1] "omit"
R
## Extract those elements which are complete cases.
## The returned object is an atomic vector of type `"numeric"`
## (or `"double"`).
heights[complete.cases(heights)]
OUTPUT
[1] 2 4 4 6چیلنج:
- انچ میں قد کے اس ویکٹر کا استعمال کرتے ہوئے، NAs کو ہٹا کر ایک نیا ویکٹر بنائیں۔
R
heights <- c(63, 69, 60, 65, NA, 68, 61, 70, 61, 59, 64, 69, 63, 63, NA, 72, 65, 64, 70, 63, 65)
-
heightsویکٹر کا میڈین حساب کرنے کے لیے فانکشنmedian()کا استعمال کریں۔ - R کا استعمال کرتے ہوئے یہ معلوم کریں کہ اس سیٹ میں کتنے لوگ 67 انچ سے زیادہ قد کے ہیں۔
R
heights_no_na <- heights[!is.na(heights)]
## or
heights_no_na <- na.omit(heights)
R
median(heights, na.rm = TRUE)
OUTPUT
[1] 64R
heights_above_67 <- heights_no_na[heights_no_na > 67]
length(heights_above_67)
OUTPUT
[1] 6ویکٹرز تیار کرنا
کنسٹرکٹرز
مختلف اقسام کے ویکٹرز تیار کرنے کے لیے کچھ فنکشنز موجود ہیں۔ عددی
ویکٹر تیار کرنے کے لیے، numeric() کنسٹرکٹر کا استعمال کیا
جا سکتا ہے، جس میں آؤٹ پٹ ویکٹر کی لمبائی کو پیرامیٹر کے طور پر فراہم
کیا جاتا ہے۔ اقدار کو 0 سے انیشیالائز کیا جائے گا۔
R
numeric(3)
OUTPUT
[1] 0 0 0R
numeric(10)
OUTPUT
[1] 0 0 0 0 0 0 0 0 0 0نوٹ کریں کہ اگر ہم 0 لمبائی کا عددی ویکٹر مانگیں، تو ہمیں بالکل وہی ملتا ہے:
R
numeric(0)
OUTPUT
numeric(0)کیریکٹرز اور لوجیکلز کے لیے بھی اسی طرح کے کنسٹرکٹرز موجود ہیں، جن کے
نام بالترتیب character() اور logical()
ہیں۔
چیلنج:
کیریکٹر اور لوجیکل ویکٹرز کی ابتدائی ڈیفالٹ اقدار کیا ہوتی ہیں؟
R
character(2) ## the empty character
OUTPUT
[1] "" ""R
logical(2) ## FALSE
OUTPUT
[1] FALSE FALSEعناصر کو دہرائیں
rep فنکشن کسی ویلیو کو ایک مخصوص تعداد میں دہرانے کی
اجازت دیتا ہے۔ مثال کے طور پر، اگر ہم -1 کی ویلیو کے ساتھ 5 لمبائی کا
ایک عددی ویکٹر بنانا چاہتے ہیں، تو ہم درج ذیل طریقہ اپنا سکتے ہیں:
R
rep(-1, 5)
OUTPUT
[1] -1 -1 -1 -1 -1اسی طرح، غیر موجود اقدار پر مشتمل ایک ویکٹر تیار کرنے کے لیے، جو اکثر اکٹھا کیے جانے والے ڈیٹا کے بارے میں کوئی مفروضے قائم کیے بغیر آغاز کرنے کا ایک اچھا طریقہ ہوتا ہے:
R
rep(NA, 5)
OUTPUT
[1] NA NA NA NA NArep کسی بھی لمبائی کے ویکٹرز کو ان پٹ کے طور پر لے سکتا
ہے (اوپر، ہم نے 1 لمبائی کے ویکٹرز استعمال کیے) اور کسی بھی ٹائپ کے۔
مثال کے طور پر، اگر ہم 1، 2 اور 3 کی اقدار کو پانچ بار دہرانا چاہتے ہیں،
تو ہم درج ذیل طریقہ اپنائیں گے:
R
rep(c(1, 2, 3), 5)
OUTPUT
[1] 1 2 3 1 2 3 1 2 3 1 2 3 1 2 3چیلنج:
کیا ہوگا اگر ہم 1، 2 اور 3 کی اقدار کو پانچ بار دہرانا چاہیں، لیکن اس
ترتیب میں پانچ 1، پانچ 2 اور پانچ 3 حاصل کرنا چاہیں؟ اس کے دو طریقے ہیں
- مدد کے لیے ?rep یا ?sort دیکھیں۔
R
rep(c(1, 2, 3), each = 5)
OUTPUT
[1] 1 1 1 1 1 2 2 2 2 2 3 3 3 3 3R
sort(rep(c(1, 2, 3), 5))
OUTPUT
[1] 1 1 1 1 1 2 2 2 2 2 3 3 3 3 3سیکوئنس کی تخلیق
ایک اور انتہائی مفید فنکشن seq ہے، جو اعداد کا ایک
سیکوئنس تیار کرتا ہے۔ مثال کے طور پر، 1 سے 20 تک کے صحیح اعداد کا ایک
سیکوئنس 2 کے فاصلے سے تیار کرنے کے لیے، اس کا استعمال کیا جائے گا:
R
seq(from = 1, to = 20, by = 2)
OUTPUT
[1] 1 3 5 7 9 11 13 15 17 19by کی ڈیفالٹ ویلیو 1 ہے اور، چونکہ ایک ویلیو سے دوسری
ویلیو تک 1 کے فاصلوں کے ساتھ سیکوئنس تیار کرنا اکثر استعمال ہوتا ہے، اس
لیے ایک مختصر طریقہ موجود ہے:
R
seq(1, 5, 1)
OUTPUT
[1] 1 2 3 4 5R
seq(1, 5) ## default by
OUTPUT
[1] 1 2 3 4 5R
1:5
OUTPUT
[1] 1 2 3 4 51 سے 20 تک اعداد کا ایک سیکوئنس تیار کرنے کے لیے، جس کی حتمی لمبائی 3 ہو، درج ذیل کا استعمال کیا جائے گا:
R
seq(from = 1, to = 20, length.out = 3)
OUTPUT
[1] 1.0 10.5 20.0رینڈم نمونے اور پرمیوٹیشنز
مفید فنکشنز کا ایک آخری گروپ وہ ہیں جو رینڈم ڈیٹا تیار کرتے ہیں۔
پہلا، sample، ایک دوسرے ویکٹر کی رینڈم پرمیوٹیشن تیار کرتا
ہے۔ مثال کے طور پر، 10 طلبہ کے زبانی امتحان کے لیے ایک رینڈم ترتیب
نکالنے کے لیے، میں پہلے ہر طالب علم کو 1 سے دس تک کا ایک نمبر تفویض کرتا
ہوں (مثلاً ان کے نام کی حروفِ تہجی کی ترتیب کی بنیاد پر) اور پھر:
R
sample(1:10)
OUTPUT
[1] 9 4 7 1 2 5 3 10 6 8مزید آرگومنٹس کے بغیر، sample ویکٹر کے تمام عناصر کی ایک
پرمیوٹیشن (permutation) واپس کرے گا۔ اگر مجھے ایک مخصوص سائز کا رینڈم
سیمپل چاہیے، تو میں اس ویلیو کو دوسرے آرگومنٹ کے طور پر سیٹ کروں گا۔
نیچے، میں پہلے سے متعین شدہ letters ویکٹر میں موجود حروفِ
تہجی سے 5 رینڈم حروف کا سیمپل لیتا ہوں:
R
sample(letters, 5)
OUTPUT
[1] "s" "a" "u" "x" "j"اگر مجھے ان پٹ ویکٹر سے بڑا آؤٹ پٹ چاہیے، یا کچھ عناصر کو کئی بار
منتخب کرنے کی صلاحیت چاہیے، تو مجھے replace آرگومنٹ کو
TRUE پر سیٹ کرنا ہوگا:
R
sample(1:5, 10, replace = TRUE)
OUTPUT
[1] 2 1 5 5 1 1 5 5 2 2چیلنج:
مندرجہ بالا فنکشنز کو آزماتے ہوئے، آپ نے محسوس کیا ہوگا کہ نمونے
واقعی بے ترتیب ہیں اور ایک ہی پرمیوٹیشن دوبارہ نہیں ملتی۔ ان بے ترتیب
نمونوں کو دوبارہ حاصل کرنے کے لیے، بے ترتیب نمونہ نکالنے سے پہلے
set.seed() کے ذریعے رینڈم نمبر جنریشن کے سیڈ کو دستی طور پر
سیٹ کیا جا سکتا ہے۔
اپنے پڑوسی کے ساتھ اس فیچر کو آزمائیں۔ سب سے پہلے 1:10
کی دو رینڈم پرمیوٹیشنز آزادانہ طور پر نکالیں اور دیکھیں کہ آپ کو مختلف
نتائج ملتے ہیں۔
اب، مثال کے طور پر set.seed(123) کے ذریعے سیڈ (seed) سیٹ
کریں اور رینڈم ڈرا کو دہرائیں۔ دیکھیں کہ اب آپ کو ایک جیسے رینڈم ڈرا
حاصل ہو رہے ہیں۔
ایک مختلف سیڈ سیٹ کر کے اسے دہرائیں۔
مختلف پرمیوٹیشنز
R
sample(1:10)
OUTPUT
[1] 9 1 4 3 6 2 5 8 10 7R
sample(1:10)
OUTPUT
[1] 4 9 7 6 1 10 8 3 2 5سیڈ 123 کے ساتھ وہی پرمیوٹیشنز
R
set.seed(123)
sample(1:10)
OUTPUT
[1] 3 10 2 8 6 9 1 7 5 4R
set.seed(123)
sample(1:10)
OUTPUT
[1] 3 10 2 8 6 9 1 7 5 4ایک مختلف سیڈ
R
set.seed(1)
sample(1:10)
OUTPUT
[1] 9 4 7 1 2 5 3 10 6 8R
set.seed(1)
sample(1:10)
OUTPUT
[1] 9 4 7 1 2 5 3 10 6 8نارمل تقسیم سے نمونے نکالنا
آخری فنکشن جو ہم دیکھیں گے وہ rnorm ہے، جو ایک نارمل
تقسیم سے ایک رینڈم نمونہ نکالتا ہے۔ اوسط 0 اور 100 اور اسٹینڈرڈ ڈیوی
ایشنز 1 اور 5 والی دو نارمل تقسیمیں، جنہیں N(0, 1) اور
N(100, 5) سے ظاہر کیا گیا ہے، نیچے دکھائی گئی ہیں۔
تین آرگومنٹس، n، mean اور sd،
نمونے کے سائز اور نارمل تقسیم کے پیرامیٹرز، یعنی اوسط اور اس کے معیاری
انحراف کی تعریف کرتے ہیں۔ بعد والے کی ڈیفالٹ اقدار 0 اور 1 ہیں۔
R
rnorm(5)
OUTPUT
[1] 0.69641761 0.05351568 -1.31028350 -2.12306606 -0.20807859R
rnorm(5, 2, 2)
OUTPUT
[1] 1.3744268 -0.1164714 2.8344472 1.3690969 3.6510983R
rnorm(5, 100, 5)
OUTPUT
[1] 106.45636 96.87448 95.62427 100.71678 107.12595اب جب کہ ہم نے اسکرپٹس لکھنے کا طریقہ اور R کے ڈیٹا اسٹرکچرز کی بنیادی باتیں سیکھ لی ہیں، تو ہم بڑے ڈیٹا کے ساتھ کام شروع کرنے اور ڈیٹا فریمز کے بارے میں جاننے کے لیے تیار ہیں۔
- R کے ساتھ تعامل کیسے کریں
Content from ڈیٹا سے آغاز
Last updated on 2026-11-11 | Edit this page
Overview
Questions
- R میں پہلا ڈیٹا تجزیہ
Objectives
- بتائیں کہ
data.frameکیا ہے۔ - ایک .csv فائل سے بیرونی ڈیٹا کو ڈیٹا فریم میں لوڈ کریں۔
- ایک ڈیٹا فریم کے مواد کا خلاصہ کریں۔
- بتائیں کہ فیکٹر کیا ہوتا ہے۔
- اسٹرنگز اور فیکٹرز کے درمیان تبدیلی کریں۔
- فیکٹرز کی ترتیب بدلیں اور ان کے نام تبدیل کریں۔
- تاریخوں کو فارمیٹ کریں۔
- ڈیٹا کو ایکسپورٹ اور محفوظ کریں۔
یہ ایپیسوڈ Data Carpentries کے Data Analysis and Visualisation in R for Ecologists اسباق پر مبنی ہے۔
جین کے اظہار کے ڈیٹا کی پیشکش
ہم Blackmore et al. (2017) کی شائع کردہ ڈیٹا کے ایک حصے، The effect of upper-respiratory infection on transcriptomic changes in the CNS کا استعمال کریں گے۔ اس مطالعے کا مقصد یہ تعین کرنا تھا کہ اوپری سانس کی نالی کے انفیکشن کا انفیکشن کے بعد سیریبیلم اور سپائنل کارڈ میں ہونے والی RNA ٹرانسکرپشن کی تبدیلیوں پر کیا اثر پڑتا ہے۔ جنس کے لحاظ سے مطابقت رکھنے والے آٹھ ہفتے کے C57BL/6 چوہوں کو انٹراناسل راستے سے سالین یا انفلوئنزا A کے ذریعے انوکیولیٹ کیا گیا، اور سیریبیلم اور سپائنل کارڈ کے ٹشوز میں ٹرانسکرپٹومک تبدیلیوں کا جائزہ 0 (غیر متاثرہ)، 4 اور 8 کے دنوں پر RNA-seq کے ذریعے لیا گیا۔
ڈیٹا سیٹ کو کوما-سیپریٹڈ ویلیوز (CSV) فائل کے طور پر محفوظ کیا گیا ہے۔ ہر قطار میں RNA کے اظہار کی ایک واحد پیمائش کی معلومات شامل ہیں، اور پہلے گیارہ کالم درج ذیل کی نمائندگی کرتے ہیں:
| کالم | تفصیل |
|---|---|
| gene | اس جین کا نام جس کی پیمائش کی گئی تھی |
| sample | اس نمونے کا نام جس میں جین کے اظہار کی پیمائش کی گئی تھی |
| expression | جین کے اظہار کی ویلیو |
| organism | جاندار/نوع - یہاں تمام ڈیٹا چوہوں سے حاصل کیا گیا ہے |
| age | چوہے کی عمر (یہاں تمام چوہے 8 ہفتے کے تھے) |
| sex | چوہے کی جنس |
| infection | چوہے کی انفیکشن کی حالت، یعنی انفلوئنزا اے سے متاثر ہے یا نہیں۔ |
| strain | انفلوئنزا اے کا سٹرین۔ |
| time | انفیکشن کی مدت (دنوں میں)۔ |
| tissue | وہ ٹشو جسے جین کے اظہار کے تجربے کے لیے استعمال کیا گیا، یعنی سیریبلم یا ریڑھ کی ہڈی۔ |
| mouse | چوہے کا منفرد شناختی علامت۔ |
ہم جین کے اظہار کے ڈیٹا پر مشتمل CSV فائل ڈاؤن لوڈ کرنے کے لیے R
فنکشن download.file() استعمال کریں گے، اور CSV فائل کے مواد
کو میموری میں data.frame کلاس کے ایک آبجیکٹ کے طور پر لوڈ
کرنے کے لیے read.csv() استعمال کریں گے۔
download.file کمانڈ کے اندر، پہلا اندراج ایک کیریکٹر اسٹرنگ
ہے جس میں سورس URL درج ہے۔ یہ سورس URL ایک GitHub ریپوزٹری سے CSV فائل
ڈاؤن لوڈ کرتا ہے۔ کومے کے بعد کا متن ("data/rnaseq.csv") آپ
کی لوکل مشین پر فائل محفوظ کرنے کا مقام ہے۔ آپ کو اپنی مشین پر
"data" نامی ایک فولڈر ہونا چاہیے جہاں آپ فائل ڈاؤن لوڈ کریں
گے۔ لہٰذا یہ کمانڈ ریموٹ فائل ڈاؤن لوڈ کرتی ہے، اسے
"rnaseq.csv" نام دیتی ہے اور اسے "data" نامی
پہلے سے موجود فولڈر میں شامل کرتی ہے۔
R
download.file(url = "https://github.com/carpentries-incubator/bioc-intro/raw/main/episodes/data/rnaseq.csv",
              destfile = "data/rnaseq.csv")
اب آپ ڈیٹا لوڈ کرنے کے لیے تیار ہیں:
R
rna <- read.csv("data/rnaseq.csv")
یہ اسٹیٹمنٹ کوئی آؤٹ پٹ پیدا نہیں کرتا کیونکہ، جیسا کہ آپ کو یاد ہوگا، اسائنمنٹس کچھ بھی ظاہر نہیں کرتے۔ اگر ہم یہ چیک کرنا چاہتے ہیں کہ ہمارا ڈیٹا لوڈ ہو گیا ہے، تو ہم ڈیٹا فریم کے نام ٹائپ کر کے اس کے مواد کو دیکھ سکتے ہیں:
R
rna
واہ… آؤٹ پٹ بہت زیادہ تھا۔ کم از کم اس کا مطلب یہ ہے کہ ڈیٹا درست
طریقے سے لوڈ ہو گیا ہے۔ آئیے فانکشن head() کا استعمال کرتے
ہوئے اس ڈیٹا فریم کے اوپری حصے (پہلی 6 لائنیں) کو چیک کرتے ہیں:
R
head(rna)
OUTPUT
     gene     sample expression     organism age    sex  infection  strain time
1     Asl GSM2545336       1170 Mus musculus   8 Female InfluenzaA C57BL/6    8
2    Apod GSM2545336      36194 Mus musculus   8 Female InfluenzaA C57BL/6    8
3 Cyp2d22 GSM2545336       4060 Mus musculus   8 Female InfluenzaA C57BL/6    8
4    Klk6 GSM2545336        287 Mus musculus   8 Female InfluenzaA C57BL/6    8
5   Fcrls GSM2545336         85 Mus musculus   8 Female InfluenzaA C57BL/6    8
6  Slc2a4 GSM2545336        782 Mus musculus   8 Female InfluenzaA C57BL/6    8
      tissue mouse ENTREZID
1 Cerebellum    14   109900
2 Cerebellum    14    11815
3 Cerebellum    14    56448
4 Cerebellum    14    19144
5 Cerebellum    14    80891
6 Cerebellum    14    20528
                                                                       product
1                               argininosuccinate lyase, transcript variant X1
2                                       apolipoprotein D, transcript variant 3
3 cytochrome P450, family 2, subfamily d, polypeptide 22, transcript variant 2
4                         kallikrein related-peptidase 6, transcript variant 2
5                Fc receptor-like S, scavenger receptor, transcript variant X1
6          solute carrier family 2 (facilitated glucose transporter), member 4
     ensembl_gene_id external_synonym chromosome_name   gene_biotype
1 ENSMUSG00000025533    2510006M18Rik               5 protein_coding
2 ENSMUSG00000022548             <NA>              16 protein_coding
3 ENSMUSG00000061740             2D22              15 protein_coding
4 ENSMUSG00000050063             Bssp               7 protein_coding
5 ENSMUSG00000015852    2810439C17Rik               3 protein_coding
6 ENSMUSG00000018566           Glut-4              11 protein_coding
                            phenotype_description
1           abnormal circulating amino acid level
2                      abnormal lipid homeostasis
3                        abnormal skin morphology
4                         abnormal cytokine level
5 decreased CD8-positive alpha-beta T cell number
6              abnormal circulating glucose level
  hsapiens_homolog_associated_gene_name
1                                   ASL
2                                  APOD
3                                CYP2D6
4                                  KLK6
5                                 FCRL2
6                                SLC2A4
R
## Try also
## View(rna)
نوٹ
read.csv() یہ فرض کرتا ہے کہ فیلڈز کو کومے کے ذریعے الگ
کیا جاتا ہے، تاہم، کئی ممالک میں کومے کو اعشاریہ کے علامت کے طور پر اور
سیمی کولن (;) کو فیلڈ کے علامت کے طور پر استعمال کیا جاتا ہے۔ اگر آپ R
میں اس قسم کی فائلوں کو پڑھنا چاہتے ہیں، تو آپ read.csv2()
فنکشن استعمال کر سکتے ہیں۔ یہ بالکل read.csv() کی طرح کام
کرتا ہے لیکن اعشاریہ اور فیلڈ کے علامتوں کے لیے مختلف پیرامیٹرز استعمال
کرتا ہے۔ اگر آپ کسی دوسرے فارمیٹ کے ساتھ کام کر رہے ہیں، تو دونوں کو
صارف کے ذریعے متعین کیا جا سکتا ہے۔ مزید جاننے کے لیے
?read.csv ٹائپ کر کے read.csv() کی ہیلپ
دیکھیں۔ ٹیب کے ذریعے الگ کی گئی ڈیٹا فائلوں کو پڑھنے کے لیے
read.delim() فنکشن بھی موجود ہے۔ یہ نوٹ کرنا ضروری ہے کہ یہ
تمام فنکشنز دراصل مرکزی read.table() فنکشن کے لیے مختلف
آرگومنٹس والے ریپر فنکشنز ہیں۔ اسی لحاظ سے، اوپر دیے گئے ڈیٹا کو
read.table() کا استعمال کرتے ہوئے سیپریشن آرگومنٹ کو
, کے طور پر بھی لوڈ کیا جا سکتا تھا۔ کوڈ درج ذیل ہے:
R
rna <- read.table(file = "data/rnaseq.csv",
                  sep = ",",
                  header = TRUE)
ہیڈر آرگومنٹ کو TRUE پر سیٹ کرنا ضروری ہے تاکہ ہیڈرز کو پڑھا جا سکے،
کیونکہ ڈیفالٹ طور پر read.table() میں ہیڈر آرگومنٹ FALSE پر
سیٹ ہوتا ہے۔
ڈیٹا فریمز کیا ہیں؟
ڈیٹا فریمز زیادہ تر ٹیبل ڈیٹا کے لیے ڈی فیکٹو ڈیٹا اسٹرکچر ہیں، اور ہم انہیں شماریات اور پلوٹنگ کے لیے استعمال کرتے ہیں۔
ایک ڈیٹا فریم کو دستی طور پر بنایا جا سکتا ہے، لیکن زیادہ تر صورتوں
میں انہیں read.csv() یا read.table() فانکشنز
کے ذریعے تیار کیا جاتا ہے؛ دوسرے الفاظ میں، جب آپ اپنی ہارڈ ڈرائیو (یا
ویب) سے اسپریڈشیٹس امپورٹ کرتے ہیں۔
ڈیٹا فریم ڈیٹا کی ایک ایسی نمائندگی ہے جو ٹیبل کے فارمیٹ میں ہوتی ہے جہاں کالمز ویکٹرز ہوتے ہیں اور ان سب کی لمبائی ایک جیسی ہوتی ہے۔ چونکہ کالمز ویکٹرز ہوتے ہیں، اس لیے ہر کالم میں ڈیٹا کی ایک ہی قسم (مثلاً، کیریکٹرز، انٹیجرز، فیکٹرز) ہونی چاہیے۔ مثال کے طور پر، یہاں ایک شکل دکھائی گئی ہے جو عددی، کیریکٹر اور لوجیکل ویکٹرز پر مشتمل ڈیٹا فریم کی عکاسی کرتی ہے۔
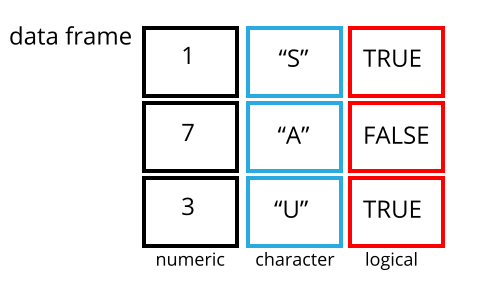
ہم اسے str() فنکشن کے ذریعے ایک ڈیٹا فریم کی
structure کا معائنہ کرتے ہوئے دیکھ سکتے ہیں:
R
str(rna)
OUTPUT
'data.frame':	32428 obs. of  19 variables:
 $ gene                                 : chr  "Asl" "Apod" "Cyp2d22" "Klk6" ...
 $ sample                               : chr  "GSM2545336" "GSM2545336" "GSM2545336" "GSM2545336" ...
 $ expression                           : int  1170 36194 4060 287 85 782 1619 288 43217 1071 ...
 $ organism                             : chr  "Mus musculus" "Mus musculus" "Mus musculus" "Mus musculus" ...
 $ age                                  : int  8 8 8 8 8 8 8 8 8 8 ...
 $ sex                                  : chr  "Female" "Female" "Female" "Female" ...
 $ infection                            : chr  "InfluenzaA" "InfluenzaA" "InfluenzaA" "InfluenzaA" ...
 $ strain                               : chr  "C57BL/6" "C57BL/6" "C57BL/6" "C57BL/6" ...
 $ time                                 : int  8 8 8 8 8 8 8 8 8 8 ...
 $ tissue                               : chr  "Cerebellum" "Cerebellum" "Cerebellum" "Cerebellum" ...
 $ mouse                                : int  14 14 14 14 14 14 14 14 14 14 ...
 $ ENTREZID                             : int  109900 11815 56448 19144 80891 20528 97827 118454 18823 14696 ...
 $ product                              : chr  "argininosuccinate lyase, transcript variant X1" "apolipoprotein D, transcript variant 3" "cytochrome P450, family 2, subfamily d, polypeptide 22, transcript variant 2" "kallikrein related-peptidase 6, transcript variant 2" ...
 $ ensembl_gene_id                      : chr  "ENSMUSG00000025533" "ENSMUSG00000022548" "ENSMUSG00000061740" "ENSMUSG00000050063" ...
 $ external_synonym                     : chr  "2510006M18Rik" NA "2D22" "Bssp" ...
 $ chromosome_name                      : chr  "5" "16" "15" "7" ...
 $ gene_biotype                         : chr  "protein_coding" "protein_coding" "protein_coding" "protein_coding" ...
 $ phenotype_description                : chr  "abnormal circulating amino acid level" "abnormal lipid homeostasis" "abnormal skin morphology" "abnormal cytokine level" ...
 $ hsapiens_homolog_associated_gene_name: chr  "ASL" "APOD" "CYP2D6" "KLK6" ...
data.frame آبجیکٹس کا معائنہ کرنا
ہم پہلے ہی دیکھ چکے ہیں کہ فیکشنز head() اور
str() ایک ڈیٹا فریم کے مواد اور ساخت کی جانچ کرنے میں کیسے
مفید ثابت ہو سکتے ہیں۔ یہاں ڈیٹا کے مواد/ساخت کا اندازہ لگانے کے لیے
فیکشنز کی ایک غیر جامع فہرست دی گئی ہے۔ آئیے انہیں آزما کر دیکھتے
ہیں!
سائز:
-
dim(rna)- ایک ویکٹر واپس کرتا ہے جس میں پہلے عنصر کے طور پر قطاروں کی تعداد اور دوسرے عنصر کے طور پر کالموں کی تعداد ہوتی ہے (آبجیکٹ کی dimensions)۔ -
nrow(rna)- قطاروں کی تعداد واپس کرتا ہے۔ -
ncol(rna)- کالموں کی تعداد واپس کرتا ہے۔
مواد:
-
head(rna)- پہلی 6 قطاریں دکھاتا ہے۔ -
tail(rna)- آخری 6 قطاریں دکھاتا ہے۔
نام:
-
names(rna)- کالموں کے نام واپس کرتا ہے (data.frameآبجیکٹس کے لیےcolnames()کا مترادف)۔ -
rownames(rna)- قطاروں کے نام واپس کرتا ہے۔
خلاصہ:
-
str(rna)- آبجیکٹ کی ساخت اور ہر کالم کی کلاس، لمبائی اور مواد کے بارے میں معلومات۔ -
summary(rna)- ہر کالم کے لیے خلاصہ اعداد و شمار۔
نوٹ: ان میں سے زیادہ تر فنکشنز “جنرک” ہیں، انہیں
data.frame کے علاوہ دیگر اقسام کے آبجیکٹس پر بھی استعمال
کیا جا سکتا ہے۔
چیلنج:
str(rna) کے آؤٹ پٹ کی بنیاد پر، کیا آپ درج ذیل سوالات کے
جواب دے سکتے ہیں؟
- آبجیکٹ
rnaکی کلاس کیا ہے؟ - اس آبجیکٹ میں کتنی قطاریں اور کتنی کالمیں ہیں؟
- کلاس: ڈیٹا فریم
- کتنی قطاریں: 32428، کتنی کالمیں: 19
ڈیٹا فریمز کی انڈیکسنگ اور سبسیٹنگ
ہمارے rna ڈیٹا فریم میں قطاریں اور کالم ہیں (اس کی 2
جہتیں ہیں)؛ اگر ہم اس سے کچھ مخصوص ڈیٹا نکالنا چاہتے ہیں، تو ہمیں اپنی
مطلوبہ “کوآرڈینیٹس” متعین کرنے کی ضرورت ہوتی ہے۔ پہلے قطاروں کے نمبر آتے
ہیں، جس کے بعد کالموں کے نمبر آتے ہیں۔ تاہم، نوٹ کریں کہ ان کوآرڈینیٹس
کو متعین کرنے کے مختلف طریقے مختلف کلاسز والے نتائج کا باعث بنتے
ہیں۔
R
# first element in the first column of the data frame (as a vector)
rna[1, 1]
# first element in the 6th column (as a vector)
rna[1, 6]
# first column of the data frame (as a vector)
rna[, 1]
# first column of the data frame (as a data.frame)
rna[1]
# first three elements in the 7th column (as a vector)
rna[1:3, 7]
# the 3rd row of the data frame (as a data.frame)
rna[3, ]
# equivalent to head_rna <- head(rna)
head_rna <- rna[1:6, ]
head_rna
: ایک خصوصی فنکشن ہے جو بڑھتے ہوئے یا کم ہوتے ہوئے ترتیب
میں صحیح اعداد کے ویکٹرز تیار کرتا ہے، مثال کے طور پر 1:10
اور 10:1 کو آزمائیں۔ تفصیلات کے لیے سیکشن ویکٹرز کی تخلیق
دیکھیں۔
آپ “-” علامت کا استعمال کرتے ہوئے ڈیٹا فریم کے مخصوص
انڈیکسز کو بھی خارج کر سکتے ہیں:
R
rna[, -1]          ## The whole data frame, except the first column
rna[-c(7:66465), ] ## Equivalent to head(rna)
ڈیٹا فریمز کو انڈیکسز کال کر کے (جیسا کہ پہلے دکھایا گیا ہے)، یا ان کے کالم کے ناموں کو براہِ راست کال کر کے بھی سب سیٹ کیا جا سکتا ہے:
R
rna["gene"]       # Result is a data.frame
rna[, "gene"]     # Result is a vector
rna[["gene"]]     # Result is a vector
rna$gene          # Result is a vector
RStudio میں، آپ کالموں کے مکمل اور درست نام حاصل کرنے کے لیے آٹو کمپلیشن فیچر کا استعمال کر سکتے ہیں۔
چیلنج
ایک
data.frame(rna_200) بنائیں جس میں صرفrnaڈیٹا سیٹ کی قطار 200 کا ڈیٹا ہو۔غور کریں کہ
nrow()نے آپ کوdata.frameمیں قطاروں کی تعداد کیسے دی؟
اس نمبر کا استعمال کرتے ہوئے ابتدائی
rnaڈیٹا فریم سے صرف اس آخری قطار کو نکالیں۔اس کا موازنہ
tail()کے ذریعے اس سے کریں جو آپ کو آخری قطار لگتا ہے، تاکہ یقینی بنایا جا سکے کہ یہ توقعات کے مطابق ہے۔قطار کے نمبر کے بجائے
nrow()کا استعمال کرتے ہوئے اس آخری قطار کو نکالیں۔اس آخری قطار سے ایک نیا ڈیٹا فریم (
rna_last) بنائیں۔
nrow()کا استعمال کرتے ہوئےrnaڈیٹا فریم کے درمیان میں موجود قطار کو نکالیں۔ اس قطار کے مواد کوrna_middleنامی ایک آبجیکٹ میں محفوظ کریں۔nrow()کو اوپر دی گئی-نوٹیشن کے ساتھ ملا کرhead(rna)کے رویے کو دوبارہ پیدا کریں، اور rna ڈیٹا سیٹ کی صرف پہلی سے چھٹی قطار تک کو برقرار رکھیں۔
R
## 1.
rna_200 <- rna[200, ]
## 2.
## Saving `n_rows` to improve readability and reduce duplication
n_rows <- nrow(rna)
rna_last <- rna[n_rows, ]
## 3.
rna_middle <- rna[n_rows / 2, ]
## 4.
rna_head <- rna[-(7:n_rows), ]
فیکٹرز
فیکٹرز کیٹیگوریکل ڈیٹا کی نمائندگی کرتے ہیں۔ انہیں لیبلز سے منسلک صحیح اعداد کے طور پر محفوظ کیا جاتا ہے اور یہ ترتیب دیے ہوئے یا غیر ترتیب دیے ہوئے ہو سکتے ہیں۔ اگرچہ فیکٹرز دیکھنے میں (اور اکثر رویے میں بھی) کیریکٹر ویکٹرز کی طرح ہوتے ہیں، لیکن R انہیں دراصل صحیح اعداد کے ویکٹرز کے طور پر سمجھتا ہے۔ لہٰذا، انہیں اسٹرنگز کے طور پر استعمال کرتے وقت آپ کو بہت احتیاط برتنی ہوگی۔
ایک بار بنائے جانے کے بعد، فیکٹرز میں صرف پہلے سے متعین کردہ اقدار کا ایک مجموعہ ہو سکتا ہے، جسے لیولز کہا جاتا ہے۔ ڈیفالٹ طور پر، R ہمیشہ لیولز کو حروفِ تہجی کی ترتیب میں ترتیب دیتا ہے۔ مثال کے طور پر، اگر آپ کے پاس 2 لیولز والا ایک فیکٹر ہو:
R
sex <- factor(c("male", "female", "female", "male", "female"))
R لیول "female" کو 1 اور لیول
"male" کو 2 تفویض کرے گا (کیونکہ
f، m سے پہلے آتا ہے، اگرچہ اس ویکٹر کا پہلا
عنصر "male" ہے)۔ آپ اسے فانکشن levels()
استعمال کر کے دیکھ سکتے ہیں اور لیولز کی تعداد nlevels() کے
ذریعے معلوم کر سکتے ہیں:
R
levels(sex)
OUTPUT
[1] "female" "male" R
nlevels(sex)
OUTPUT
[1] 2کبھی کبھی فیکٹرز کی ترتیب اہمیت نہیں رکھتی، تو کبھی آپ ترتیب کا تعین
کرنا چاہیں گے کیونکہ وہ معنی رکھتی ہو (مثلاً، “low”، “medium”، “high”)،
یا یہ آپ کی ویژولائزیشن کو بہتر بناتی ہے، یا کسی خاص قسم کے تجزیے کے لیے
ضروری ہوتی ہے۔ یہاں، sex ویکٹر میں اپنے لیولز کی ترتیب
بدلنے کا ایک طریقہ یہ ہو سکتا ہے:
R
sex ## current order
OUTPUT
[1] male   female female male   female
Levels: female male
R
sex <- factor(sex, levels = c("male", "female"))
sex ## after re-ordering
OUTPUT
[1] male   female female male   female
Levels: male female
R کی میموری میں، یہ فیکٹرز صحیح اعداد (1, 2, 3) کے ذریعے ظاہر کیے
جاتے ہیں، لیکن یہ صحیح اعداد کے مقابلے میں زیادہ معلوماتی ہوتے ہیں
کیونکہ فیکٹرز خود بیانی ہوتے ہیں: "female" اور
"male"، 1 اور 2 کے مقابلے میں
زیادہ وضاحتی ہیں۔ کون سا “male” (نر) ہے؟ آپ صرف صحیح اعداد کے ڈیٹا سے یہ
بتا نہیں سکتے۔ دوسری طرف، فیکٹرز میں یہ معلومات پہلے سے موجود ہوتی ہیں۔
یہ خاص طور پر تب مددگار ہوتا ہے جب لیولز کی تعداد زیادہ ہو (جیسے ہمارے
مثالی ڈیٹا سیٹ میں جین کی بائیو ٹائپ)۔
جب آپ کا ڈیٹا ایک فیکٹر کے طور پر محفوظ ہو، تو آپ ہر فیکٹر لیول کے
ذریعے ظاہر ہونے والے مشاہدات کی تعداد کا فوری جائزہ لینے کے لیے
plot() فنکشن استعمال کر سکتے ہیں۔ آئیے اپنے ڈیٹا میں نر اور
مادہ کی تعداد دیکھتے ہیں۔
R
plot(sex)
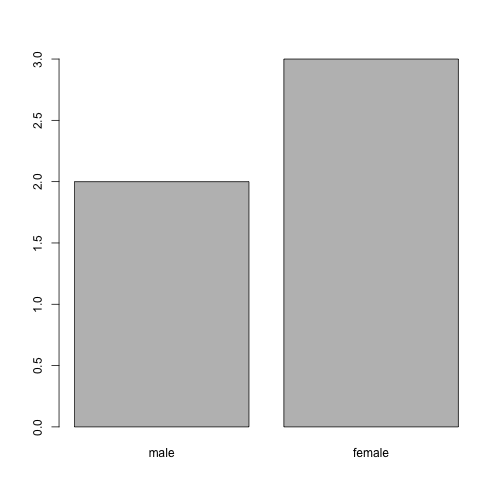
کیریکٹر میں تبدیل کرنا
اگر آپ کو کسی فیکٹر کو کیریکٹر ویکٹر میں تبدیل کرنے کی ضرورت ہو، تو
آپ as.character(x) استعمال کرتے ہیں۔
R
as.character(sex)
OUTPUT
[1] "male" "female" "female" "male" "female"فیکٹرز کے نام تبدیل کرنا
اگر ہم ان فیکٹرز کے نام تبدیل کرنا چاہتے ہیں، تو ان کی لیولز کو تبدیل کرنا کافی ہے:
R
levels(sex)
OUTPUT
[1] "male" "female"R
levels(sex) <- c("M", "F")
sex
OUTPUT
[1] M F F M F
Levels: M F
R
plot(sex)
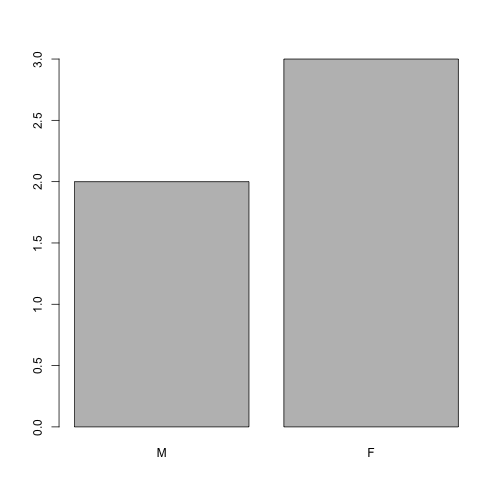
چیلنج:
- “F” اور “M” کے ناموں کو بالترتیب “Female” اور “Male” میں تبدیل کریں۔
R
levels(sex)
OUTPUT
[1] "M" "F"R
levels(sex) <- c("Male", "Female")
چیلنج:
ہم نے دیکھا ہے کہ read.csv() استعمال کرتے ہوئے ڈیٹا
فریمز کیسے بنائے جاتے ہیں، لیکن انہیں data.frame() فنکشن کے
ذریعے دستی طور پر بھی بنایا جا سکتا ہے۔ اس دستی طور پر تیار کردہ
data.frame میں کچھ غلطیاں ہیں۔ کیا آپ انہیں پہچان کر درست
کر سکتے ہیں؟ آزمائش کرنے میں ہچکچاہٹ محسوس نہ کریں!
- جانوروں کے ناموں کے گرد اقتباسی نشانات کی کمی
- “feel” کالم میں ایک اندراج غائب ہے (غالباً کسی روئیں دار جانور کے لیے)
- وزن کے کالم میں ایک کوما غائب ہے
چیلنج:
کیا آپ درج ذیل مثال میں ہر کالم کی کلاس کا اندازہ لگا سکتے ہیں؟
اپنے اندازوں کی تصدیق str(country_climate) کے ذریعے
کریں:
کیا یہ وہی ہیں جن کی آپ نے توقع کی تھی؟ کیوں؟ کیوں نہیں؟
ڈیٹا فریم بناتے وقت آخری ویری ایبل کے بعد
stringsAsFactors = TRUEشامل کر کے دوبارہ کوشش کریں۔ اب کیا ہو رہا ہے؟read.csv()کا استعمال کرتے ہوئے ٹیکسٹ پر مبنی اسپریڈشیٹس کو R میں ریڈ کرتے وقتstringsAsFactorsکو بھی سیٹ کیا جا سکتا ہے۔
R
country_climate <- data.frame(
       country = c("Canada", "Panama", "South Africa", "Australia"),
       climate = c("cold", "hot", "temperate", "hot/temperate"),
       temperature = c(10, 30, 18, "15"),
       northern_hemisphere = c(TRUE, TRUE, FALSE, "FALSE"),
       has_kangaroo = c(FALSE, FALSE, FALSE, 1)
       )
R
country_climate <- data.frame(
       country = c("Canada", "Panama", "South Africa", "Australia"),
       climate = c("cold", "hot", "temperate", "hot/temperate"),
       temperature = c(10, 30, 18, "15"),
       northern_hemisphere = c(TRUE, TRUE, FALSE, "FALSE"),
       has_kangaroo = c(FALSE, FALSE, FALSE, 1)
       )
str(country_climate)
OUTPUT
'data.frame':	4 obs. of  5 variables:
 $ country            : chr  "Canada" "Panama" "South Africa" "Australia"
 $ climate            : chr  "cold" "hot" "temperate" "hot/temperate"
 $ temperature        : chr  "10" "30" "18" "15"
 $ northern_hemisphere: chr  "TRUE" "TRUE" "FALSE" "FALSE"
 $ has_kangaroo       : num  0 0 0 1
ڈیٹا کی قسم کی خودکار تبدیلی کبھی فائدہ مند ہوتی ہے اور کبھی پریشان کن۔ اس بات کا خیال رکھیں کہ یہ سہولت موجود ہے، اس کے قواعد سیکھیں، اور دوبارہ چیک کریں کہ R میں آپ کے امپورٹ کیے گئے ڈیٹا آپ کے ڈیٹا فریم میں درست قسم کے ہیں۔ اگر ایسا نہیں ہے، تو اسے اپنے فائدے کے لیے استعمال کریں تاکہ ان غلطیوں کا پتہ لگایا جا سکے جو ڈیٹا انٹری کے دوران ہو سکتی ہیں (مثال کے طور پر، کسی کالم میں ایک حرف جو صرف اعداد پر مشتمل ہونا چاہیے)۔
مزید معلومات کے لیے اس RStudio ٹیوٹوریل کو دیکھیں۔
میٹرکسز
آگے بڑھنے سے پہلے، اب جب کہ ہم نے ڈیٹا فریمز کے بارے میں سیکھ لیا ہے،
آئیے پیکیج انسٹالیشن کا جائزہ لیں اور ایک نئی ڈیٹا ٹائپ، یعنی
matrix کے بارے میں جانیں۔ data.frame کی طرح،
ایک میٹرکس کے دو ابعاد ہوتے ہیں، قطاریں اور کالم۔ لیکن بڑا فرق یہ ہے کہ
matrix کے تمام سیلز ایک ہی ٹائپ کے ہونے چاہئیں:
numeric، character، logical، … اس
لحاظ سے، میٹرکسز data.frame کے مقابلے میں
vector کے زیادہ قریب ہیں۔
میٹرکس کا ڈیفالٹ کنسٹرکٹر matrix ہے۔ یہ میٹرکس کو بھرنے
کے لیے اقدار کا ایک ویکٹر اور قطاروں اور/یا کالموں کی تعداد1 لیتا ہے۔
اقدار کالم وار بھری جاتی ہیں، جیسا کہ نیچے دکھایا گیا ہے۔
R
m <- matrix(1:9, ncol = 3, nrow = 3)
m
OUTPUT
     [,1] [,2] [,3]
[1,]    1    4    7
[2,]    2    5    8
[3,] 3 6 9چیلنج:
فانکشن installed.packages() کا استعمال کرتے ہوئے، ایک
character میٹرکس بنائیں جس میں آپ کے کمپیوٹر پر فی الحال
انسٹال شدہ تمام پیکیجز کے بارے میں معلومات شامل ہوں۔ اس کا جائزہ
لیں۔
R
## create the matrix
ip <- installed.packages()
head(ip)
## try also View(ip)
## number of package
nrow(ip)
## names of all installed packages
rownames(ip)
## type of information we have about each package
colnames(ip)
ٹیسٹ ڈیٹا کے طور پر بڑے رینڈم ڈیٹا میٹرکسز بنانا اکثر مفید ہوتا ہے۔
نیچے دیا گیا مشق آپ سے ایسا میٹرکس بنانے کا کہتا ہے جس میں ایک اوسط 0
اور اسٹینڈرڈ ڈیوی ایشن 1 والی نارمل تقسیم سے لیے گئے رینڈم ڈیٹا ہوں، جو
rnorm() فنکشن کے ذریعے کیا جا سکتا ہے۔
چیلنج:
نارمل طور پر تقسیم شدہ ڈیٹا (میان 0، اسٹینڈرڈ ڈیوی ایشن 1) کا 1000 ضرب 3 کا ایک میٹرکس تیار کریں۔
R
set.seed(123)
m <- matrix(rnorm(3000), ncol = 3)
dim(m)
OUTPUT
[1] 1000 3R
head(m)
OUTPUT
            [,1]        [,2]       [,3]
[1,] -0.56047565 -0.99579872 -0.5116037
[2,] -0.23017749 -1.03995504  0.2369379
[3,]  1.55870831 -0.01798024 -0.5415892
[4,]  0.07050839 -0.13217513  1.2192276
[5,]  0.12928774 -2.54934277  0.1741359
[6,]  1.71506499  1.04057346 -0.6152683
تاریخوں کی فارمیٹنگ
نئے (اور تجربہ کار!) R صارفین کو جو سب سے عام مسائل کا سامنا کرنا پڑتا ہے، وہ ڈیٹ اور وقت کی معلومات کو ایک ایسے ویری ایبل میں تبدیل کرنا ہے جو تجزیوں کے دوران مناسب اور قابلِ استعمال ہو۔
اسپریڈشیٹ پروگراموں میں تاریخوں کے بارے میں نوٹ
اسپریڈشیٹس میں تاریخیں عام طور پر ایک ہی کالم میں محفوظ کی جاتی ہیں۔ اگرچہ تاریخیں درج کرنے کا یہ سب سے فطری طریقہ معلوم ہوتا ہے، لیکن دراصل یہ بہترین طریقہ کار نہیں ہے۔ ایک اسپریڈشیٹ ایپلی کیشن تاریخوں کو ایسے ظاہر کرے گی جو (ایک انسانی ناظر کے لیے) درست معلوم ہوں، لیکن اس کا تاریخوں کو اصل میں کس طرح ہینڈل کرنا اور محفوظ کرنا مسئلہ بن سکتا ہے۔ اکثر یہ کہیں زیادہ محفوظ ہوتا ہے کہ تاریخوں کو YEAR، MONTH اور DAY کے الگ الگ کالموں میں یا YEAR اور DAY-OF-YEAR کے الگ الگ کالموں میں محفوظ کیا جائے۔
اسپریڈشیٹ پروگرامز جیسے کہ LibreOffice، Microsoft Excel، OpenOffice، Gnumeric، … تاریخوں کو انکوڈ کرنے کے مختلف (اور اکثر غیر ہم آہنگ) طریقے رکھتے ہیں (یہاں تک کہ ایک ہی پروگرام کے مختلف ورژنز اور آپریٹنگ سسٹمز کے درمیان بھی)۔ مزید برآں، Excel ایسی چیزوں کو تاریخوں میں تبدیل کر سکتا ہے جو تاریخ نہیں ہیں ( Zeeberg et al. (2004) )، مثال کے طور پر MAR1، DEC1، OCT4 جیسے نام یا شناختی علامتیں۔ لہٰذا، اگر آپ مجموعی طور پر تاریخ کے فارمیٹ سے گریز کر رہے ہیں، تو ان مسائل کی شناخت کرنا آسان ہو جاتا ہے۔
Data Carpentry اسباق کے Dates as data سیکشن میں اسپریڈشیٹس میں تاریخوں سے وابستہ ممکنہ غلطیوں کے بارے میں مزید معلومات فراہم کی گئی ہیں۔
ہم پیکیج lubridate سے
ymd() فنکشن استعمال کریں گے (جو
tidyverse کا حصہ ہے؛ مزید معلومات tidyverse ویب سائٹ پر حاصل کریں)۔
lubridate
tidyverse کی انسٹالیشن کے حصے کے طور پر
انسٹال ہو جاتا ہے۔ جب آپ tidyverse
(library(tidyverse)) کو لوڈ کرتے ہیں، تو کور پیکیجز (وہ
پیکیجز جو زیادہ تر ڈیٹا تجزیوں میں استعمال ہوتے ہیں) لوڈ ہو جاتے ہیں۔
تاہم، lubridate کور tidyverse کا حصہ نہیں
ہے، اس لیے آپ کو اسے library(lubridate) کے ذریعے واضح طور
پر لوڈ کرنا ہوگا۔
پہلے ضروری پیکیج لوڈ کریں:
R
library("lubridate")
ymd() سال، مہینے اور دن کی نمائندگی کرنے والے ایک ویکٹر
کو لیتا ہے، اور اسے Date ویکٹر میں تبدیل کر دیتا ہے۔
Date ڈیٹا کی ایک ایسی کلاس ہے جسے R تاریخ کے طور پر پہچانتا
ہے اور اس کے ساتھ اسی طرح کام کیا جا سکتا ہے۔ فانکشن کے لیے مطلوبہ
آرگومنٹ لچکدار ہے، لیکن بہترین طریقہ کار کے طور پر، یہ “YYYY-MM-DD”
فارمیٹ میں ایک کریکٹر ویکٹر ہوتا ہے۔
آئیے ایک ڈیٹ آبجیکٹ بنائیں اور اس کی ساخت کا جائزہ لیں:
R
my_date <- ymd("2015-01-01")
str(my_date)
OUTPUT
Date[1:1], format: "2015-01-01"اب آئیے سال، مہینہ اور دن کو الگ الگ پیسٹ کریں - ہمیں وہی نتیجہ ملتا ہے:
R
# sep indicates the character to use to separate each component
my_date <- ymd(paste("2015", "1", "1", sep = "-"))
str(my_date)
OUTPUT
Date[1:1], format: "2015-01-01"آئیے اب ایک عام ڈیٹ مینیپولیشن پائپ لائن سے واقف ہوتے ہیں۔ نیچے دیے
گئے چھوٹے ڈیٹا میں تاریخیں مختلف year، month
اور day کالمز میں محفوظ کی گئی ہیں۔
R
x <- data.frame(year = c(1996, 1992, 1987, 1986, 2000, 1990, 2002, 1994, 1997, 1985),
                month = c(2,  3,  3, 10,  1,  8,  3,  4,  5,  5),
                day = c(24,  8,  1,  5,  8, 17, 13, 10, 11, 24),
                value = c(4,  5,  1,  9,  3,  8, 10,  2,  6,  7))
x
OUTPUT
   year month day value
1  1996     2  24     4
2  1992     3   8     5
3  1987     3   1     1
4  1986    10   5     9
5  2000     1   8     3
6  1990     8  17     8
7  2002     3  13    10
8  1994     4  10     2
9  1997     5  11     6
10 1985     5  24     7
اب ہم اس فنکشن کو x ڈیٹا سیٹ پر لاگو کرتے ہیں۔ ہم پہلے
paste() کا استعمال کرتے ہوئے x کے
year، month، اور day کالمز سے ایک
کریکٹر ویکٹر تیار کرتے ہیں:
R
paste(x$year, x$month, x$day, sep = "-")
OUTPUT
 [1] "1996-2-24" "1992-3-8"  "1987-3-1"  "1986-10-5" "2000-1-8"  "1990-8-17"
 [7] "2002-3-13" "1994-4-10" "1997-5-11" "1985-5-24"
اس کریکٹر ویکٹر کو ymd() کے لیے آرگومنٹ کے طور پر
استعمال کیا جا سکتا ہے:
R
ymd(paste(x$year, x$month, x$day, sep = "-"))
OUTPUT
 [1] "1996-02-24" "1992-03-08" "1987-03-01" "1986-10-05" "2000-01-08"
 [6] "1990-08-17" "2002-03-13" "1994-04-10" "1997-05-11" "1985-05-24"
حاصل شدہ Date ویکٹر کو x میں
date نامی ایک نئے کالم کے طور پر شامل کیا جا سکتا ہے:
R
x$date <- ymd(paste(x$year, x$month, x$day, sep = "-"))
str(x) # notice the new column, with 'date' as the class
OUTPUT
'data.frame':	10 obs. of  5 variables:
 $ year : num  1996 1992 1987 1986 2000 ...
 $ month: num  2 3 3 10 1 8 3 4 5 5
 $ day  : num  24 8 1 5 8 17 13 10 11 24
 $ value: num  4 5 1 9 3 8 10 2 6 7
 $ date : Date, format: "1996-02-24" "1992-03-08" ...
آئیے یقینی بنائیں کہ سب کچھ درست طریقے سے کام کر گیا ہے۔ نئے کالم کا
معائنہ کرنے کا ایک طریقہ summary() استعمال کرنا ہے:
R
summary(x$date)
OUTPUT
        Min.      1st Qu.       Median         Mean      3rd Qu.         Max.
"1985-05-24" "1988-01-11" "1993-03-24" "1993-03-18" "1997-01-20" "2002-03-13"
نوٹ کریں کہ ymd() کے لیے سال، مہینہ اور دن، اسی ترتیب
میں ہونا ضروری ہے۔ اگر آپ کے پاس، مثال کے طور پر، دن، مہینہ اور سال ہو،
تو آپ کو dmy() کی ضرورت ہوگی۔
R
dmy(paste(x$day, x$month, x$year, sep = "-"))
OUTPUT
 [1] "1996-02-24" "1992-03-08" "1987-03-01" "1986-10-05" "2000-01-08"
 [6] "1990-08-17" "2002-03-13" "1994-04-10" "1997-05-11" "1985-05-24"
lubdridate میں تاریخ کی تمام تبدیلیوں سے نمٹنے کے لیے
بہت سے فنکشنز موجود ہیں۔
R آبجیکٹس کا خلاصہ
اب تک، ہم نے R آبجیکٹس کی کئی اقسام دیکھی ہیں جو جہتوں کی تعداد اور اس بات میں مختلف ہیں کہ وہ ایک یا متعدد ڈیٹا اقسام کو محفوظ کر سکتے ہیں یا نہیں:
-
vector: ایک جہت (ان کی ایک لمبائی ہوتی ہے)، ڈیٹا کی ایک ہی قسم۔ -
matrix: دو جہتیں، ڈیٹا کی ایک ہی قسم۔ -
data.frame: دو جہتیں، ہر کالم میں ایک قسم۔
لسٹس
ایک ڈیٹا ٹائپ جسے ہم نے ابھی تک نہیں دیکھا، لیکن اسے جاننا مفید ہے، اور جو ہمارے ابھی دیکھے گئے خلاصے سے ظاہر ہوتا ہے، وہ ہے لسٹس:
-
list: ایک جہت، ہر آئٹم کی ڈیٹا ٹائپ مختلف ہو سکتی ہے۔
ذیل میں، آئیے ایک ایسی لسٹ بنائیں جس میں اعداد کا ایک ویکٹر، حروف، ایک میٹرکس، ایک ڈیٹا فریم اور ایک اور لسٹ شامل ہو:
R
l <- list(1:10, ## numeric
          letters, ## character
          installed.packages(), ## a matrix
          cars, ## a data.frame
          list(1, 2, 3)) ## a list
length(l)
OUTPUT
[1] 5R
str(l)
OUTPUT
List of 5
 $ : int [1:10] 1 2 3 4 5 6 7 8 9 10
 $ : chr [1:26] "a" "b" "c" "d" ...
 $ : chr [1:261, 1:17] "litedown" "metabolomicsWorkbenchR" "mgcv" "MultiAssayExperiment" ...
  ..- attr(*, "dimnames")=List of 2
  .. ..$ : chr [1:261] "litedown" "metabolomicsWorkbenchR" "mgcv" "MultiAssayExperiment" ...
  .. ..$ : chr [1:17] "Package" "LibPath" "Version" "Priority" ...
 $ :'data.frame':	50 obs. of  2 variables:
  ..$ speed: num [1:50] 4 4 7 7 8 9 10 10 10 11 ...
  ..$ dist : num [1:50] 2 10 4 22 16 10 18 26 34 17 ...
 $ :List of 3
  ..$ : num 1
  ..$ : num 2
  ..$ : num 3
لسٹ کی سب سیٹنگ [] کے ذریعے ایک نئی سب لسٹ بنانے کے لیے
یا [[]] کے ذریعے اس لسٹ کا ایک ایکل ایلیمنٹ نکالنے کے لیے
کی جاتی ہے (انڈیکسز یا ناموں کا استعمال کرتے ہوئے، اگر لسٹ کا نام
ہو)۔
R
l[[1]] ## first element
OUTPUT
[1] 1 2 3 4 5 6 7 8 9 10R
l[1:2] ## a list of length 2
OUTPUT
[[1]]
 [1]  1  2  3  4  5  6  7  8  9 10

[[2]]
 [1] "a" "b" "c" "d" "e" "f" "g" "h" "i" "j" "k" "l" "m" "n" "o" "p" "q" "r" "s"
[20] "t" "u" "v" "w" "x" "y" "z"
R
l[1] ## a list of length 1
OUTPUT
[[1]]
 [1]  1  2  3  4  5  6  7  8  9 10
ٹیبلر ڈیٹا کی ایکسپورٹنگ اور سیونگ
ہم نے دیکھا ہے کہ read.table فانکشنز کے خاندان کا
استعمال کرتے ہوئے ایک ٹیکسٹ بیسڈ اسپریڈشیٹ کو R میں کیسے پڑھا جائے۔ ایک
data.frame کو ٹیکسٹ بیسڈ اسپریڈشیٹ میں ایکسپورٹ کرنے کے
لیے، ہم write.table فانکشنز کے سیٹ (write.csv،
write.delim، …) کا استعمال کر سکتے ہیں۔ یہ تمام فانکشنز
ایکسپورٹ کیے جانے والے ویری ایبل اور اس فائل کو آرگومنٹس کے طور پر لیتے
ہیں جس میں ڈیٹا محفوظ کیا جانا ہے۔ مثال کے طور پر، rna ڈیٹا
کو data_output ڈائریکٹری میں my_rna.csv فائل
میں ایکسپورٹ کرنے کے لیے، ہم درج ذیل کمانڈ چلائیں گے:
R
write.csv(rna, file = "data_output/my_rna.csv")
اس نئی csv فائل کو اب ان دیگر تعاون کرنے والوں کے ساتھ شیئر کیا جا
سکتا ہے جو R سے واقف نہیں ہیں۔ نوٹ کریں کہ اگرچہ data.frame
کے کچھ فیلڈز میں کومے موجود ہیں (مثال کے طور پر “product” کالم دیکھیں)،
لیکن R ڈیفالٹ طور پر ہر فیلڈ کو کوٹس میں لپیٹ دے گا، اور اس طرح ہم اسے
دوبارہ R میں درست طریقے سے پڑھ سکیں گے، باوجود اس کے کہ کالم کے علامت کے
طور پر کومے کا استعمال بھی کیا گیا ہے۔
- R میں ٹیبل ڈیٹا
قطاروں یا کالموں میں سے کوئی ایک کی تعداد کافی ہے، کیونکہ دوسرے کا اندازہ اقدار کی لمبائی سے لگایا جا سکتا ہے۔ آزما کر دیکھیں کہ اگر اقدار کی تعداد میٹرکس کی متعین جہتوں سے مطابقت نہ رکھے تو کیا ہوتا ہے۔↩︎
Content from dplyr کے ذریعے ڈیٹا کی ترتیب و تیاری اور تجزیہ
Last updated on 2026-11-11 | Edit this page
Overview
Questions
- tidyverse میٹا-پیکیج کا استعمال کرتے ہوئے R میں ڈیٹا تجزیہ
Objectives
-
dplyrاورtidyrپیکجز کے مقصد کی وضاحت کریں۔ - ان کے ان کئی ایسے فنکشنز کی وضاحت کریں جو ڈیٹا کی مانیپولیشن کے لیے انتہائی مفید ہیں۔
- وائڈ اور لانگ ٹیبل فارمیٹ کے تصور کی وضاحت کریں، اور دیکھیں کہ ایک ڈیٹا فریم کو ایک فارمیٹ سے دوسرے میں کیسے تبدیل کیا جائے۔
- دکھائیں کہ ٹیبلز کو کیسے جوڑا جائے۔
یہ ایپیسوڈ Data Carpentries کے Data Analysis and Visualisation in R for Ecologists اسباق پر مبنی ہے۔
dplyr اور
tidyr کے ذریعے ڈیٹا کی ترتیب و تیاری
بریکٹ سبسیٹنگ مفید ہے، لیکن یہ پیچیدہ اور پڑھنے میں مشکل ہو سکتی ہے، خاص طور پر پیچیدہ آپریشنز کے لیے۔
ڈیٹا کی ترتیب و تیاری کے دوران کچھ پیکیجز ہمارے کام کو نمایاں طور پر
آسان بنا سکتے ہیں۔ R میں پیکیجز بنیادی طور پر اضافی فنکشنز کے مجموعے
ہوتے ہیں جو آپ کو مزید کام کرنے کے قابل بناتے ہیں۔ جن فنکشنز کا ہم اب تک
استعمال کر رہے ہیں، جیسے کہ str() یا
data.frame()، R میں پہلے سے موجود ہوتے ہیں؛ پیکیجز کو لوڈ
کرنے سے آپ کو دیگر مخصوص فنکشنز تک رسائی مل سکتی ہے۔ کسی پیکیج کو پہلی
بار استعمال کرنے سے پہلے آپ کو اسے اپنے مشین پر انسٹال کرنا ہوگا، اور
پھر ہر بعد کے R سیشن میں جب بھی اس کی ضرورت ہو، آپ کو اسے امپورٹ کرنا
چاہیے۔
پیکیج
dplyrڈیٹا کی ترتیب و تیاری کے کاموں کے لیے طاقتور ٹولز فراہم کرتا ہے۔ اسے براہِ راست ڈیٹا فریمز کے ساتھ کام کرنے کے لیے بنایا گیا ہے، جس میں بہت سے ترتیب و تیاری کے کاموں کو بہتر بنایا گیا ہے۔جیسا کہ ہم بعد میں دیکھیں گے، کبھی کبھی ہم چاہتے ہیں کہ کسی مخصوص تجزیوں کے لیے یا بصری نمائش کے لیے ڈیٹا فریم کی شکل تبدیل کی جائے۔ پیکیج
tidyrڈیٹا کی شکل تبدیل کرنے کے اس عام مسئلے کو حل کرتا ہے اور ڈیٹا کو منظم طریقے سے مینیپولیٹ کرنے کے لیے ٹولز فراہم کرتا ہے۔
ورکشاپ کے بعد dplyr اور
tidyr کے بارے میں مزید جاننے کے لیے، آپ اس
dplyr
کے ساتھ ڈیٹا کی تبدیلی کی مفید چیٹ شیٹ اور اس tidyr
سے متعلق چیٹ شیٹ کو دیکھ سکتے ہیں۔
-
tidyverseپیکیج ایک “امبریلا پیکیج” ہے جو ڈیٹا تجزیے کے لیے کئی مفید پیکیجز انسٹال کرتا ہے جو ایک ساتھ بہتر طریقے سے کام کرتے ہیں، جیسے کہtidyr،dplyr،ggplot2،tibbleوغیرہ۔ یہ پیکیجز ہمیں ڈیٹا پر کام کرنے اور اس کے ساتھ تعامل کرنے میں مدد دیتے ہیں۔ یہ ہمیں آپ کے ڈیٹا کے ساتھ بہت سی کامیابیاں انجام دینے کے قابل بناتے ہیں، جیسے کہ سب سیٹنگ، تبدیلی، بصری شکل دینا وغیرہ۔
اگر آپ نے سیٹ اپ کر لیا ہے، تو آپ کو پہلے ہی tidyverse پیکیج انسٹال کر دیا ہوگا۔ اس بات کی تصدیق کرنے کے لیے کہ آیا یہ آپ کے پاس ہے، لائبریری سے لوڈ کرنے کی کوشش کریں:
R
## load the tidyverse packages, incl. dplyr
library("tidyverse")
اگر آپ کو ایرر میسج
there is no package called ‘tidyverse’ ملا ہے، تو اس معاملے
میں آپ نے ابھی تک R کے اس ورژن کے لیے پیکیج انسٹال نہیں کیا ہے۔
tidyverse پیکیج انسٹال کرنے کے لیے درج ذیل
ٹائپ کریں:
R
BiocManager::install("tidyverse")
اگر آپ کو tidyverse پیکج انسٹال کرنا
پڑا ہے، تو اس R سیشن میں اوپر دیے گئے library() کمانڈ کے
ذریعے اسے لوڈ کرنا نہ بھولیں!
tidyverse کے ذریعے ڈیٹا لوڈ کرنا
read.csv() کے بجائے، ہم tidyverse پیکیج
readr سے read_csv() فنکشن
(نوٹ کریں کہ . کے بجائے _ استعمال کیا گیا ہے)
کے ذریعے اپنا ڈیٹا پڑھیں گے۔
R
rna <- read_csv("data/rnaseq.csv")

## view the data
rna
OUTPUT
# A tibble: 32,428 × 19
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…       1170 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 Apod    GSM254…      36194 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 3 Cyp2d22 GSM254…       4060 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 4 Klk6    GSM254…        287 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 5 Fcrls   GSM254…         85 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 6 Slc2a4  GSM254…        782 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 7 Exd2    GSM254…       1619 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 Gjc2    GSM254…        288 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 9 Plp1    GSM254…      43217 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
10 Gnb4    GSM254…       1071 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
نوٹ کریں کہ ڈیٹا کی کلاس کو اب “tibble” کہا جاتا ہے۔
ٹیبلز (Tibbles) ان ڈیٹا فریم آبجیکٹس کے کچھ رویوں میں تبدیلی لاتے ہیں جن کا تعارف ہم نے پہلے کیا تھا۔ ان کی ڈیٹا اسٹرکچر ایک ڈیٹا فریم سے بہت مشابہ ہے۔ ہمارے مقاصد کے لیے واحد فرق یہ ہیں کہ:
یہ ہر کالم کے نام کے نیچے اس کی ڈیٹا ٹائپ ظاہر کرتا ہے۔ نوٹ کریں کہ <
dbl> ایک ایسی ڈیٹا ٹائپ ہے جسے اعشاریہ کے نشان والی عددی اقدار رکھنے کے لیے تعریف کیا گیا ہے۔یہ ڈیٹا کی صرف پہلی چند قطاریں اور صرف اتنی کالمیں پرنٹ کرتا ہے جتنی ایک اسکرین پر سما جائیں۔
اب ہم کچھ سب سے زیادہ عام dplyr فانکشنز
سیکھنے جا رہے ہیں:
-
select(): کالمز کا ذیلی مجموعہ -
filter(): شرائط کی بنیاد پر قطاروں کا ذیلی مجموعہ تیار کریں -
mutate(): دیگر کالموں سے حاصل شدہ معلومات کا استعمال کرتے ہوئے نئے کالم تخلیق کریں -
group_by()اورsummarise(): گروپ شدہ ڈیٹا پر خلاصہ اعداد و شمار تیار کریں -
arrange(): نتائج کو ترتیب دیں -
count(): ڈسکریٹ ویلیوز کی گنتی کریں
کالمز کا انتخاب اور قطاروں کی فلٹرنگ
ڈیٹا فریم کے کالمز کا انتخاب کرنے کے لیے، select()
استعمال کریں۔ اس فنکشن کا پہلا آرگومنٹ ڈیٹا فریم (rna) ہے،
اور بعد کے آرگومنٹس وہ کالمز ہیں جنہیں برقرار رکھنا ہے۔
R
select(rna, gene, sample, tissue, expression)
OUTPUT
# A tibble: 32,428 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545336 Cerebellum       1170
 2 Apod    GSM2545336 Cerebellum      36194
 3 Cyp2d22 GSM2545336 Cerebellum       4060
 4 Klk6    GSM2545336 Cerebellum        287
 5 Fcrls   GSM2545336 Cerebellum         85
 6 Slc2a4  GSM2545336 Cerebellum        782
 7 Exd2    GSM2545336 Cerebellum       1619
 8 Gjc2    GSM2545336 Cerebellum        288
 9 Plp1    GSM2545336 Cerebellum      43217
10 Gnb4    GSM2545336 Cerebellum       1071
# ℹ 32,418 more rows
کچھ مخصوص کالموں کے علاوہ تمام کالموں کو منتخب کرنے کے لیے، ویری ایبل کے سامنے “-” لگائیں تاکہ اسے خارج کیا جا سکے۔
R
select(rna, -tissue, -organism)
OUTPUT
# A tibble: 32,428 × 17
   gene    sample   expression   age sex   infection strain  time mouse ENTREZID
   <chr>   <chr>         <dbl> <dbl> <chr> <chr>     <chr>  <dbl> <dbl>    <dbl>
 1 Asl     GSM2545…       1170     8 Fema… Influenz… C57BL…     8    14   109900
 2 Apod    GSM2545…      36194     8 Fema… Influenz… C57BL…     8    14    11815
 3 Cyp2d22 GSM2545…       4060     8 Fema… Influenz… C57BL…     8    14    56448
 4 Klk6    GSM2545…        287     8 Fema… Influenz… C57BL…     8    14    19144
 5 Fcrls   GSM2545…         85     8 Fema… Influenz… C57BL…     8    14    80891
 6 Slc2a4  GSM2545…        782     8 Fema… Influenz… C57BL…     8    14    20528
 7 Exd2    GSM2545…       1619     8 Fema… Influenz… C57BL…     8    14    97827
 8 Gjc2    GSM2545…        288     8 Fema… Influenz… C57BL…     8    14   118454
 9 Plp1    GSM2545…      43217     8 Fema… Influenz… C57BL…     8    14    18823
10 Gnb4    GSM2545…       1071     8 Fema… Influenz… C57BL…     8    14    14696
# ℹ 32,418 more rows
# ℹ 7 more variables: product <chr>, ensembl_gene_id <chr>,
#   external_synonym <chr>, chromosome_name <chr>, gene_biotype <chr>,
#   phenotype_description <chr>, hsapiens_homolog_associated_gene_name <chr>
اس سے rna کے تمام متغیرات منتخب ہو جائیں گے، سوائے
tissue اور organism کے۔
کسی مخصوص معیار کی بنیاد پر قطاروں کا انتخاب کرنے کے لیے،
filter() استعمال کریں:
R
filter(rna, sex == "Male")
OUTPUT
# A tibble: 14,740 × 19
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…        626 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 2 Apod    GSM254…      13021 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 3 Cyp2d22 GSM254…       2171 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 4 Klk6    GSM254…        448 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 5 Fcrls   GSM254…        180 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 6 Slc2a4  GSM254…        313 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 7 Exd2    GSM254…       2366 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 8 Gjc2    GSM254…        310 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 9 Plp1    GSM254…      53126 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
10 Gnb4    GSM254…       1355 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
# ℹ 14,730 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
R
filter(rna, sex == "Male" & infection == "NonInfected")
OUTPUT
# A tibble: 4,422 × 19
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…        535 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 2 Apod    GSM254…      13668 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 3 Cyp2d22 GSM254…       2008 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 4 Klk6    GSM254…       1101 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 5 Fcrls   GSM254…        375 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 6 Slc2a4  GSM254…        249 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 7 Exd2    GSM254…       3126 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 8 Gjc2    GSM254…        791 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 9 Plp1    GSM254…      98658 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
10 Gnb4    GSM254…       2437 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
# ℹ 4,412 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
اب تصور کرتے ہیں کہ ہم اس ڈیٹا سیٹ میں تجزیہ کیے گئے ماؤس کے جینز کے
انسانی ہومولوگز میں دلچسپی رکھتے ہیں۔ یہ معلومات rna ٹبل کے
آخری کالم میں مل سکتی ہیں، جس کا نام
hsapiens_homolog_associated_gene_name ہے۔ اسے آسانی سے
دیکھنے کے لیے، ہم ایک نیا ٹیبل بنائیں گے جس میں صرف gene
اور hsapiens_homolog_associated_gene_name کے 2 کالم ہوں
گے۔
R
genes <- select(rna, gene, hsapiens_homolog_associated_gene_name)
genes
OUTPUT
# A tibble: 32,428 × 2
   gene    hsapiens_homolog_associated_gene_name
   <chr>   <chr>
 1 Asl     ASL
 2 Apod    APOD
 3 Cyp2d22 CYP2D6
 4 Klk6    KLK6
 5 Fcrls   FCRL2
 6 Slc2a4  SLC2A4
 7 Exd2    EXD2
 8 Gjc2    GJC2
 9 Plp1    PLP1
10 Gnb4    GNB4
# ℹ 32,418 more rows
کچھ چوہوں کے جینز کے کوئی انسانی ہومولوگز نہیں ہوتے۔ انہیں
filter() اور is.na() فنکشن کے ذریعے حاصل کیا
جا سکتا ہے، جو یہ تعین کرتا ہے کہ کوئی چیز NA ہے یا
نہیں۔
R
filter(genes, is.na(hsapiens_homolog_associated_gene_name))
OUTPUT
# A tibble: 4,290 × 2
   gene     hsapiens_homolog_associated_gene_name
   <chr>    <chr>
 1 Prodh    <NA>
 2 Tssk5    <NA>
 3 Vmn2r1   <NA>
 4 Gm10654  <NA>
 5 Hexa     <NA>
 6 Sult1a1  <NA>
 7 Gm6277   <NA>
 8 Tmem198b <NA>
 9 Adam1a   <NA>
10 Ebp      <NA>
# ℹ 4,280 more rows
اگر ہم صرف ان ماؤس جینز کو رکھنا چاہتے ہیں جن کا انسانی ہومولوگ موجود
ہو، تو ہم ایک “!” علامت شامل کر سکتے ہیں جو نتیجے کو نفی کر دیتی ہے،
تاکہ ہم ہر اس قطار کو تلاش کریں جہاں
hsapiens_homolog_associated_gene_name NA نہ
ہو۔
R
filter(genes, !is.na(hsapiens_homolog_associated_gene_name))
OUTPUT
# A tibble: 28,138 × 2
   gene    hsapiens_homolog_associated_gene_name
   <chr>   <chr>
 1 Asl     ASL
 2 Apod    APOD
 3 Cyp2d22 CYP2D6
 4 Klk6    KLK6
 5 Fcrls   FCRL2
 6 Slc2a4  SLC2A4
 7 Exd2    EXD2
 8 Gjc2    GJC2
 9 Plp1    PLP1
10 Gnb4    GNB4
# ℹ 28,128 more rows
پائپس
اگر آپ ایک ساتھ منتخب کرنا اور فلٹر کرنا چاہتے ہیں تو کیا کریں؟ اس کے لیے تین طریقے ہیں: درمیانی مراحل کا استعمال کرنا، نیسٹڈ فنکشنز، یا پائپس۔
درمیانی مراحل کے ذریعے، آپ ایک عارضی ڈیٹا فریم بناتے ہیں اور اسے اگلے فنکشن کے لیے ان پٹ کے طور پر استعمال کرتے ہیں، جیسا کہ یہاں دکھایا گیا ہے:
R
rna2 <- filter(rna, sex == "Male")
rna3 <- select(rna2, gene, sample, tissue, expression)
rna3
OUTPUT
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rows
یہ پڑھنے میں آسان ہے، لیکن اس سے آپ کا ورک اسپیس بہت سے درمیانی آبجیکٹس سے بھر سکتا ہے جنہیں آپ کو الگ الگ نام دینے پڑتے ہیں۔ متعدد مراحل کی صورت میں، ان کا حساب رکھنا مشکل ہو سکتا ہے۔
آپ فنکشنز کو ایک دوسرے کے اندر بھی رکھ سکتے ہیں (یعنی ایک فنکشن دوسرے کے اندر)، اس طرح:
R
rna3 <- select(filter(rna, sex == "Male"), gene, sample, tissue, expression)
rna3
OUTPUT
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rows
یہ مفید ہے، لیکن اگر بہت زیادہ فنکشنز ایک دوسرے کے اندر نیسٹڈ ہوں تو اسے پڑھنا مشکل ہو سکتا ہے، کیونکہ R ایکسپریشن کو اندر سے باہر کی طرف ایویلیویٹ کرتا ہے (اس معاملے میں، فلٹرنگ، پھر سلیکشن)۔
آخری آپشن، پائپس، R میں حال ہی میں شامل کیا گیا ہے۔ پائپس آپ کو ایک فنکشن کے آؤٹ پٹ کو لے کر اسے براہِ راست اگلے فنکشن تک پہنچانے کی سہولت دیتے ہیں، جو اس وقت مفید ہوتا ہے جب آپ کو ایک ہی ڈیٹا سیٹ پر بہت سے کام کرنے کی ضرورت ہو۔
R میں پائپس %>% (جو
magrittr پیکیج کے ذریعے دستیاب ہیں) یا
|> (بیس R کے ذریعے) کی شکل میں ہوتے ہیں۔ اگر آپ RStudio
استعمال کرتے ہیں، تو آپ PC کے صورت میں Ctrl +
Shift + M اور Mac کے صورت میں Cmd +
Shift + M کے ذریعے پائپ ٹائپ کر سکتے ہیں۔
مندرجہ بالا کوڈ میں، ہم پائپ کا استعمال کرتے ہیں تاکہ
rna ڈیٹا سیٹ کو پہلے filter() کے ذریعے بھیجا
جا سکے تاکہ وہ قطاریں محفوظ رہیں جہاں sex Male ہو، اور پھر
select() کے ذریعے بھیجا جا سکے تاکہ صرف gene،
sample، tissue، اور expression
کالمز محفوظ رہیں۔
پائپ |> بائیں جانب موجود آبجیکٹ کو لے کر اسے براہِ
راست دائیں جانب موجود فنکشن کے پہلے آرگومنٹ کے طور پر پاس کر دیتا ہے، اب
ہمیں filter() اور select() فنکشنز کے آرگومنٹ
کے طور پر ڈیٹا فریم کو واضح طور پر شامل کرنے کی ضرورت نہیں رہی۔
R
rna |>
  filter(sex == "Male") |>
  select(gene, sample, tissue, expression)
OUTPUT
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rows
کچھ لوگوں کے لیے پائپ کو “then” کے لفظ کی طرح پڑھنا مددگار ثابت ہو
سکتا ہے۔ مثال کے طور پر، اوپر دی گئی مثال میں، ہم نے ڈیٹا فریم
rna لیا، پھر ہم نے sex == "Male" والی
قطاروں کے لیے filter کیا، پھر ہم نے کالمز
gene، sample، tissue، اور
expression کو select کیا۔
dplyr فنکشنز بذاتِ خود کچھ سادہ ہیں،
لیکن انہیں پائپ کے ذریعے خطی ورک فلوز میں یکجا کر کے، ہم ڈیٹا فریمز کی
زیادہ پیچیدہ مانیپولیشنز انجام دے سکتے ہیں۔
اگر ہم ڈیٹا کے اس چھوٹے ورژن کے ساتھ ایک نیا آبجیکٹ بنانا چاہتے ہیں، تو ہم اسے ایک نیا نام دے سکتے ہیں:
R
rna3 <- rna |>
  filter(sex == "Male") |>
  select(gene, sample, tissue, expression)

rna3
OUTPUT
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rowsچیلنج:
پائپس کا استعمال کرتے ہوئے، rna ڈیٹا کو اس طرح سب سیٹ
کریں کہ وقت 0 پر مادہ چوہوں کے مشاہدات کو برقرار رکھا جائے جہاں جین کا
اظہار 50000 سے زیادہ ہو، اور صرف کالمز gene،
sample، time، expression اور
age کو محفوظ رکھیں۔
R
rna |>
  filter(expression > 50000,
         sex == "Female",
         time == 0 ) |>
  select(gene, sample, time, expression, age)
OUTPUT
# A tibble: 9 × 5
  gene   sample      time expression   age
  <chr>  <chr>      <dbl>      <dbl> <dbl>
1 Plp1   GSM2545337     0     101241     8
2 Atp1b1 GSM2545337     0      53260     8
3 Plp1   GSM2545338     0      96534     8
4 Atp1b1 GSM2545338     0      50614     8
5 Plp1   GSM2545348     0     102790     8
6 Atp1b1 GSM2545348     0      59544     8
7 Plp1   GSM2545353     0      71237     8
8 Glul   GSM2545353     0      52451     8
9 Atp1b1 GSM2545353     0      61451     8
کالم بنانا اور تبدیل کرنا (mutate)
اکثر آپ موجودہ کالموں کی اقدار کی بنیاد پر نئے کالم تخلیق کرنا چاہیں
گے، مثال کے طور پر اکائیوں کی تبدیلی کرنے، یا دو کالموں میں اقدار کا
تناسب معلوم کرنے کے لیے۔ اس کے لیے ہم mutate() استعمال کریں
گے۔
گھنٹوں میں وقت کا ایک نیا کالم بنانے کے لیے:
R
rna |>
  mutate(time_hours = time * 24) |>
  select(time, time_hours)
OUTPUT
# A tibble: 32,428 × 2
    time time_hours
   <dbl>      <dbl>
 1     8        192
 2     8        192
 3     8        192
 4     8        192
 5     8        192
 6     8        192
 7     8        192
 8     8        192
 9     8        192
10     8        192
# ℹ 32,418 more rows
آپ ایک ہی mutate() کال کے اندر، پہلے نئے کالم کی بنیاد
پر دوسرا نیا کالم بھی بنا سکتے ہیں:
R
rna |>
  mutate(time_hours = time * 24,
         time_mn = time_hours * 60) |>
  select(time, time_hours, time_mn)
OUTPUT
# A tibble: 32,428 × 3
    time time_hours time_mn
   <dbl>      <dbl>   <dbl>
 1     8        192   11520
 2     8        192   11520
 3     8        192   11520
 4     8        192   11520
 5     8        192   11520
 6     8        192   11520
 7     8        192   11520
 8     8        192   11520
 9     8        192   11520
10     8        192   11520
# ℹ 32,418 more rowsچیلنج
rna ڈیٹا سے ایک نیا ڈیٹا فریم بنائیں جو درج ذیل معیار پر
پورا اترے: اس میں صرف gene، chromosome_name،
phenotype_description، sample، اور
expression کالمز شامل ہوں۔ اظہار کی اقدار کو لوگارتھمی
تبدیلی کیا جانا چاہیے۔ اس ڈیٹا فریم میں صرف وہ جینز شامل ہونے چاہئیں جو
سیکس کروموسومز پر واقع ہوں، ایک phenotype_description سے منسلک ہوں، اور
جن کا لوگارتھم اظہار 5 سے زیادہ ہو۔
اشارہ: سوچیں کہ اس ڈیٹا فریم کو تیار کرنے کے لیے کمانڈز کی ترتیب کیسی ہونی چاہیے!
R
rna |>
  mutate(expression = log(expression)) |>
  select(gene, chromosome_name, phenotype_description, sample, expression) |>
  filter(chromosome_name == "X" | chromosome_name == "Y") |>
  filter(!is.na(phenotype_description)) |>
  filter(expression > 5)
OUTPUT
# A tibble: 649 × 5
   gene   chromosome_name phenotype_description                sample expression
   <chr>  <chr>           <chr>                                <chr>       <dbl>
 1 Plp1   X               abnormal CNS glial cell morphology   GSM25…      10.7
 2 Slc7a3 X               decreased body length                GSM25…       5.46
 3 Plxnb3 X               abnormal coat appearance             GSM25…       6.58
 4 Rbm3   X               abnormal liver morphology            GSM25…       9.32
 5 Cfp    X               abnormal cardiovascular system phys… GSM25…       6.18
 6 Ebp    X               abnormal embryonic erythrocyte morp… GSM25…       6.68
 7 Cd99l2 X               abnormal cellular extravasation      GSM25…       8.04
 8 Piga   X               abnormal brain development           GSM25…       6.06
 9 Pim2   X               decreased T cell proliferation       GSM25…       7.11
10 Itm2a  X               no abnormal phenotype detected       GSM25…       7.48
# ℹ 639 more rows
اسپلٹ-ایپلائی-کمبائن ڈیٹا تجزیہ
ڈیٹا تجزیے کے بہت سے کاموں کو split-apply-combine پیراڈائم
کے ذریعے انجام دیا جا سکتا ہے: ڈیٹا کو گروہوں میں تقسیم کریں، ہر گروپ پر
کوئی تجزیہ کریں، اور پھر نتائج کو یکجا کریں۔
dplyr group_by() فنکشن کے
استعمال کے ذریعے اسے بہت آسان بنا دیتا ہے۔
R
rna |>
  group_by(gene)
OUTPUT
# A tibble: 32,428 × 19
# Groups:   gene [1,474]
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…       1170 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 Apod    GSM254…      36194 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 3 Cyp2d22 GSM254…       4060 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 4 Klk6    GSM254…        287 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 5 Fcrls   GSM254…         85 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 6 Slc2a4  GSM254…        782 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 7 Exd2    GSM254…       1619 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 Gjc2    GSM254…        288 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 9 Plp1    GSM254…      43217 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
10 Gnb4    GSM254…       1071 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
group_by() فنکشن ڈیٹا کی کوئی پروسیسنگ نہیں کرتا، بلکہ
یہ ڈیٹا کو ذیلی گروہوں میں تقسیم کرتا ہے: اوپر دی گئی مثال میں، 32428 کے
مشاہدات کا ہمارا ابتدائی tibble، gene ویری
ایبل کی بنیاد پر 1474 گروہوں میں تقسیم ہو جاتا ہے۔
ہم اسی طرح ٹیبل کو نمونوں کے لحاظ سے گروپ کرنے کا فیصلہ بھی کر سکتے ہیں:
R
rna |>
  group_by(sample)
OUTPUT
# A tibble: 32,428 × 19
# Groups:   sample [22]
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…       1170 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 Apod    GSM254…      36194 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 3 Cyp2d22 GSM254…       4060 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 4 Klk6    GSM254…        287 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 5 Fcrls   GSM254…         85 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 6 Slc2a4  GSM254…        782 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 7 Exd2    GSM254…       1619 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 Gjc2    GSM254…        288 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 9 Plp1    GSM254…      43217 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
10 Gnb4    GSM254…       1071 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
یہاں ہمارے 32428 مشاہدات کا ابتدائی tibble،
sample متغیر کی بنیاد پر 22 گروپس میں تقسیم کیا جاتا
ہے۔
ایک بار جب ڈیٹا کو گروپ کر لیا جائے، تو بعد کے آپریشنز ہر گروپ پر آزادانہ طور پر لاگو کیے جائیں گے۔
summarise() فنکشن
group_by() کا استعمال اکثر summarise() کے
ساتھ کیا جاتا ہے، جو ہر گروپ کو اس گروپ کے ایک صف کے خلاصے میں تبدیل کر
دیتا ہے۔
group_by() ایسے کالم کے ناموں کو آرگومنٹس کے طور پر لیتا
ہے جن میں وہ کیٹیگوریکل متغیرات موجود ہوں جن کے لیے آپ
خلاصہ اعداد و شمار کا حساب لگانا چاہتے ہیں۔ لہٰذا، جین کے لحاظ سے اوسط
expression کا حساب لگانے کے لیے:
R
rna |>
  group_by(gene) |>
  summarise(mean_expression = mean(expression))
OUTPUT
# A tibble: 1,474 × 2
   gene     mean_expression
   <chr>              <dbl>
 1 AI504432         1053.
 2 AW046200          131.
 3 AW551984          295.
 4 Aamp             4751.
 5 Abca12              4.55
 6 Abcc8            2498.
 7 Abhd14a           525.
 8 Abi2             4909.
 9 Abi3bp           1002.
10 Abl2             2124.
# ℹ 1,464 more rows
ہم ہر نمونے میں تمام جینز کی اوسط اظہار کی سطحوں کا حساب بھی لینا چاہیں گے:
R
rna |>
  group_by(sample) |>
  summarise(mean_expression = mean(expression))
OUTPUT
# A tibble: 22 × 2
   sample     mean_expression
   <chr>                <dbl>
 1 GSM2545336           2062.
 2 GSM2545337           1766.
 3 GSM2545338           1668.
 4 GSM2545339           1696.
 5 GSM2545340           1682.
 6 GSM2545341           1638.
 7 GSM2545342           1594.
 8 GSM2545343           2107.
 9 GSM2545344           1712.
10 GSM2545345           1700.
# ℹ 12 more rows
لیکن ہم متعدد کالمز کے حساب سے بھی گروپ کر سکتے ہیں:
R
rna |>
  group_by(gene, infection, time) |>
  summarise(mean_expression = mean(expression))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, infection, and time.
ℹ Output is grouped by gene and infection.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, infection, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 4,422 × 4
# Groups:   gene, infection [2,948]
   gene     infection    time mean_expression
   <chr>    <chr>       <dbl>           <dbl>
 1 AI504432 InfluenzaA      4           1104.
 2 AI504432 InfluenzaA      8           1014
 3 AI504432 NonInfected     0           1034.
 4 AW046200 InfluenzaA      4            152.
 5 AW046200 InfluenzaA      8             81
 6 AW046200 NonInfected     0            155.
 7 AW551984 InfluenzaA      4            302.
 8 AW551984 InfluenzaA      8            342.
 9 AW551984 NonInfected     0            238
10 Aamp     InfluenzaA      4           4870
# ℹ 4,412 more rows
ایک بار جب ڈیٹا گروپ کر لیا جائے، تو آپ ایک ہی وقت میں متعدد متغیرات
کا خلاصہ بھی کر سکتے ہیں (اور ضروری نہیں کہ وہ ایک ہی متغیر پر ہوں)۔
مثال کے طور پر، ہم جین اور شرط کے لحاظ سے میڈین expression
کو ظاہر کرنے والا ایک کالم شامل کر سکتے ہیں:
R
rna |>
  group_by(gene, infection, time) |>
  summarise(mean_expression = mean(expression),
            median_expression = median(expression))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, infection, and time.
ℹ Output is grouped by gene and infection.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, infection, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 4,422 × 5
# Groups:   gene, infection [2,948]
   gene     infection    time mean_expression median_expression
   <chr>    <chr>       <dbl>           <dbl>             <dbl>
 1 AI504432 InfluenzaA      4           1104.             1094.
 2 AI504432 InfluenzaA      8           1014               985
 3 AI504432 NonInfected     0           1034.             1016
 4 AW046200 InfluenzaA      4            152.              144.
 5 AW046200 InfluenzaA      8             81                82
 6 AW046200 NonInfected     0            155.              163
 7 AW551984 InfluenzaA      4            302.              245
 8 AW551984 InfluenzaA      8            342.              287
 9 AW551984 NonInfected     0            238               265
10 Aamp     InfluenzaA      4           4870              4708
# ℹ 4,412 more rowsچیلنج
ٹائم پوائنٹس کے لحاظ سے جین “Dok3” کی اوسط اظہار کی سطح کا حساب لگائیں۔
R
rna |>
  filter(gene == "Dok3") |>
  group_by(time) |>
  summarise(mean = mean(expression))
OUTPUT
# A tibble: 3 × 2
   time  mean
  <dbl> <dbl>
1     0  169
2     4  156.
3     8   61
گنتی
ڈیٹا کے ساتھ کام کرتے وقت، ہم اکثر ہر فیکٹر یا فیکٹرز کے مجموعے کے
لیے پائے گئے آبزرویشنز کی تعداد جاننا چاہتے ہیں۔ اس کام کے لیے،
dplyr count() فراہم کرتا ہے۔
مثال کے طور پر، اگر ہم ہر متاثرہ اور غیر متاثرہ نمونوں کے لیے ڈیٹا کی
قطاروں کی تعداد گننا چاہتے ہوں، تو ہم یوں کریں گے:
R
rna |>
    count(infection)
OUTPUT
# A tibble: 2 × 2
  infection       n
  <chr>       <int>
1 InfluenzaA  22110
2 NonInfected 10318
count() فنکشن ایک ایسی چیز کا مختصر شکل ہے جسے ہم پہلے
ہی دیکھ چکے ہیں: ایک ویری ایبل کے مطابق گروپنگ کرنا، اور اس گروپ میں
مشاہدات کی تعداد گنتی کر کے اس کا خلاصہ تیار کرنا۔ دوسرے الفاظ میں،
rna |> count(infection) درج ذیل کے مساوی ہے:
R
rna |>
    group_by(infection) |>
    summarise(n = n())
OUTPUT
# A tibble: 2 × 2
  infection       n
  <chr>       <int>
1 InfluenzaA  22110
2 NonInfected 10318
پچھلا مثال count() کے استعمال کو دکھاتا ہے تاکہ
ایک فیکٹر (یعنی infection) کے لیے قطاروں/آبزرویشنز
کی تعداد گنی جا سکے۔ اگر ہم infection اور time
جیسے فیکٹرز کے مجموعے کی تعداد گننا چاہتے، تو ہم پہلے اور دوسرے
فیکٹر کو count() کے آرگومنٹس کے طور پر متعین کریں گے:
R
rna |>
    count(infection, time)
OUTPUT
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      4 11792
2 InfluenzaA      8 10318
3 NonInfected     0 10318
جو اس کے برابر ہے:
R
rna |>
  group_by(infection, time) |>
  summarise(n = n())
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by infection and time.
ℹ Output is grouped by infection.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(infection, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 3 × 3
# Groups:   infection [2]
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      4 11792
2 InfluenzaA      8 10318
3 NonInfected     0 10318
موازنے میں آسانی کے لیے کبھی کبھی نتیجے کو ترتیب دینا مفید ہوتا ہے۔
ہم ٹیبل کو ترتیب دینے کے لیے arrange() کا استعمال کر سکتے
ہیں۔ مثال کے طور پر، ہم اوپر دیے گئے ٹیبل کو وقت کے لحاظ سے ترتیب دینا
چاہیں گے:
R
rna |>
  count(infection, time) |>
  arrange(time)
OUTPUT
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 NonInfected     0 10318
2 InfluenzaA      4 11792
3 InfluenzaA      8 10318
یا گنتیوں کے لحاظ سے:
R
rna |>
  count(infection, time) |>
  arrange(n)
OUTPUT
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      8 10318
2 NonInfected     0 10318
3 InfluenzaA      4 11792
ترتیب کو گرتی ہوئی ترتیب میں ترتیب دینے کے لیے، ہمیں
desc() فنکشن شامل کرنے کی ضرورت ہے:
R
rna |>
  count(infection, time) |>
  arrange(desc(n))
OUTPUT
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      4 11792
2 InfluenzaA      8 10318
3 NonInfected 0 10318چیلنج
- ہر نمونے میں کتنے جینز کا تجزیہ کیا گیا؟
- ہر نمونے میں سیکوئنسنگ ڈیپتھ (تمام گنتیوں کا مجموعہ) کا جائزہ لینے
کے لیے
group_by()اورsummarise()کا استعمال کریں۔ کس نمونے میں سیکوئنسنگ ڈیپتھ سب سے زیادہ ہے؟ - ایک نمونہ منتخب کریں اور بائیو ٹائپ کے لحاظ سے جینز کی تعداد کا جائزہ لیں۔
- “abnormal DNA methylation” فینوٹائپ کی تفصیل سے وابستہ جینز کی شناخت کریں، اور وقت 0، وقت 4 اور وقت 8 پر ان کے اوسط اظہار (log میں) کا حساب لگائیں۔
R
## 1.
rna |>
  count(sample)
OUTPUT
# A tibble: 22 × 2
   sample         n
   <chr>      <int>
 1 GSM2545336  1474
 2 GSM2545337  1474
 3 GSM2545338  1474
 4 GSM2545339  1474
 5 GSM2545340  1474
 6 GSM2545341  1474
 7 GSM2545342  1474
 8 GSM2545343  1474
 9 GSM2545344  1474
10 GSM2545345  1474
# ℹ 12 more rows
R
## 2.
rna |>
  group_by(sample) |>
  summarise(seq_depth = sum(expression)) |>
  arrange(desc(seq_depth))
OUTPUT
# A tibble: 22 × 2
   sample     seq_depth
   <chr>          <dbl>
 1 GSM2545350   3255566
 2 GSM2545352   3216163
 3 GSM2545343   3105652
 4 GSM2545336   3039671
 5 GSM2545380   3036098
 6 GSM2545353   2953249
 7 GSM2545348   2913678
 8 GSM2545362   2913517
 9 GSM2545351   2782464
10 GSM2545349   2758006
# ℹ 12 more rows
R
## 3.
rna |>
  filter(sample == "GSM2545336") |>
  count(gene_biotype) |>
  arrange(desc(n))
OUTPUT
# A tibble: 13 × 2
   gene_biotype                           n
   <chr>                              <int>
 1 protein_coding                      1321
 2 lncRNA                                69
 3 processed_pseudogene                  59
 4 miRNA                                  7
 5 snoRNA                                 5
 6 TEC                                    4
 7 polymorphic_pseudogene                 2
 8 unprocessed_pseudogene                 2
 9 IG_C_gene                              1
10 scaRNA                                 1
11 transcribed_processed_pseudogene       1
12 transcribed_unitary_pseudogene         1
13 transcribed_unprocessed_pseudogene     1
R
## 4.
rna |>
  filter(phenotype_description == "abnormal DNA methylation") |>
  group_by(gene, time) |>
  summarise(mean_expression = mean(log(expression))) |>
  arrange()
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 6 × 3
# Groups:   gene [2]
  gene   time mean_expression
  <chr> <dbl>           <dbl>
1 Xist      0            6.95
2 Xist      4            6.34
3 Xist      8            7.13
4 Zdbf2     0            6.27
5 Zdbf2     4            6.27
6 Zdbf2     8            6.19
ڈیٹا کی تشکیلِ نو
rna ٹبل میں، قطاروں میں اظہار کی اقدار (یونٹ) موجود ہیں
جو 2 دیگر متغیرات: gene اور sample کے مجموعے
سے منسلک ہیں۔
باقی تمام کالمز ایسی متغیرات سے متعلق ہیں جو یا تو نمونے (جیسے کہ جاندار، عمر، جنس، …) یا جین (gene_biotype، ENTREZ_ID، پروڈکٹ، …) کی وضاحت کرتے ہیں۔ وہ متغیرات جو جینز یا نمونوں کے ساتھ تبدیل نہیں ہوتے، تمام قطاروں میں ایک ہی ویلیو رکھتے ہیں۔
R
rna |>
  arrange(gene)
OUTPUT
# A tibble: 32,428 × 19
   gene     sample expression organism   age sex   infection strain  time tissue
   <chr>    <chr>       <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 AI504432 GSM25…       1230 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 AI504432 GSM25…       1085 Mus mus…     8 Fema… NonInfec… C57BL…     0 Cereb…
 3 AI504432 GSM25…        969 Mus mus…     8 Fema… NonInfec… C57BL…     0 Cereb…
 4 AI504432 GSM25…       1284 Mus mus…     8 Fema… Influenz… C57BL…     4 Cereb…
 5 AI504432 GSM25…        966 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 6 AI504432 GSM25…        918 Mus mus…     8 Male  Influenz… C57BL…     8 Cereb…
 7 AI504432 GSM25…        985 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 AI504432 GSM25…        972 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 9 AI504432 GSM25…       1000 Mus mus…     8 Fema… Influenz… C57BL…     4 Cereb…
10 AI504432 GSM25…        816 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
اس ساخت کو long-format کہا جاتا ہے، کیونکہ ایک کالم میں
تمام اقدار شامل ہوتی ہیں، اور دیگر کالم(یں) اقدار کے سیاق و سباق کی
فہرست پیش کرتے ہیں۔
کچھ معاملات میں، long-format حقیقت میں “انسانی طور پر
قابلِ پڑھنے” نہیں ہوتا، اور ڈیٹا کی نمائندگی کے ایک زیادہ جامع طریقے کے
طور پر ایک دوسرے فارمیٹ، wide-format کو ترجیح دی جاتی ہے۔
یہ عام طور پر ان جین کے اظہار کی اقدار کے معاملے میں ہوتا ہے جنہیں
سائنسدان کو میٹرکسز کے طور پر دیکھنے کی عادت ہوتی ہے، جہاں قطاریں جینز
کی نمائندگی کرتی ہیں اور کالم نمونوں کی نمائندگی کرتے ہیں۔
اس فارمیٹ میں، لہٰذا نمونوں کے اندر اور ان کے درمیان جین کے اظہار کی سطحوں کے تعلق کا جائزہ لینا آسان ہو جائے گا۔
OUTPUT
# A tibble: 1,474 × 23
   gene    GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
   <chr>        <dbl>      <dbl>      <dbl>      <dbl>      <dbl>      <dbl>
 1 Asl           1170        361        400        586        626        988
 2 Apod         36194      10347       9173      10620      13021      29594
 3 Cyp2d22       4060       1616       1603       1901       2171       3349
 4 Klk6           287        629        641        578        448        195
 5 Fcrls           85        233        244        237        180         38
 6 Slc2a4         782        231        248        265        313        786
 7 Exd2          1619       2288       2235       2513       2366       1359
 8 Gjc2           288        595        568        551        310        146
 9 Plp1         43217     101241      96534      58354      53126      27173
10 Gnb4          1071       1791       1867       1430       1355        798
# ℹ 1,464 more rows
# ℹ 16 more variables: GSM2545342 <dbl>, GSM2545343 <dbl>, GSM2545344 <dbl>,
#   GSM2545345 <dbl>, GSM2545346 <dbl>, GSM2545347 <dbl>, GSM2545348 <dbl>,
#   GSM2545349 <dbl>, GSM2545350 <dbl>, GSM2545351 <dbl>, GSM2545352 <dbl>,
#   GSM2545353 <dbl>, GSM2545354 <dbl>, GSM2545362 <dbl>, GSM2545363 <dbl>,
#   GSM2545380 <dbl>
جین کے اظہار کی اقدار کو rna سے وائڈ فارمیٹ میں تبدیل
کرنے کے لیے، ہمیں ایک نیا ٹیبل بنانا ہوگا جہاں sample کالم
کی اقدار کالم ویری ایبلز کے نام بن جائیں گی۔
یہاں اہم نکتہ یہ ہے کہ ہم اب بھی ایک منظم ڈیٹا ساخت پر عمل کر رہے ہیں، لیکن ہم نے دلچسپی کے مشاہدات کے مطابق ڈیٹا کو دوبارہ ترتیب دیا ہے: جین کے لحاظ سے اظہار کی سطحوں کو، جین اور سیمپل کے لحاظ سے درج کرنے کے بجائے۔
اس کے برعکس تبدیلی کا مطلب کالم کے ناموں کو ایک نئے ویری ایبل کی اقدار میں تبدیل کرنا ہوگا۔
ہم ان دونوں تبدیلیوں کو دو tidyr فنکشنز،
pivot_longer() اور pivot_wider() کے ذریعے کر
سکتے ہیں (تفصیلات کے لیے tidyr ویب
سائٹ پر پیوٹس سے متعلق مضمون دیکھیں)۔
ڈیٹا کو وائڈ فارمیٹ میں تبدیل کرنا
آئیے rna کے پہلے 3 کالمز کا انتخاب کریں اور
pivot_wider() کا استعمال کرتے ہوئے ڈیٹا کو وائڈ فارمیٹ میں
تبدیل کریں۔
R
rna_exp <- rna |>
  select(gene, sample, expression)
rna_exp
OUTPUT
# A tibble: 32,428 × 3
   gene    sample     expression
   <chr>   <chr>           <dbl>
 1 Asl     GSM2545336       1170
 2 Apod    GSM2545336      36194
 3 Cyp2d22 GSM2545336       4060
 4 Klk6    GSM2545336        287
 5 Fcrls   GSM2545336         85
 6 Slc2a4  GSM2545336        782
 7 Exd2    GSM2545336       1619
 8 Gjc2    GSM2545336        288
 9 Plp1    GSM2545336      43217
10 Gnb4    GSM2545336       1071
# ℹ 32,418 more rows
pivot_wider تین بنیادی آرگومنٹس لیتا ہے:
- تبدیل کیے جانے والے ڈیٹا؛
- the
names_from: وہ کالم جس کی اقدار نئے کالم کے نام بن جائیں گی؛ - the
values_from: وہ کالم جس کی اقدار نئے کالموں کو بھریں گی۔
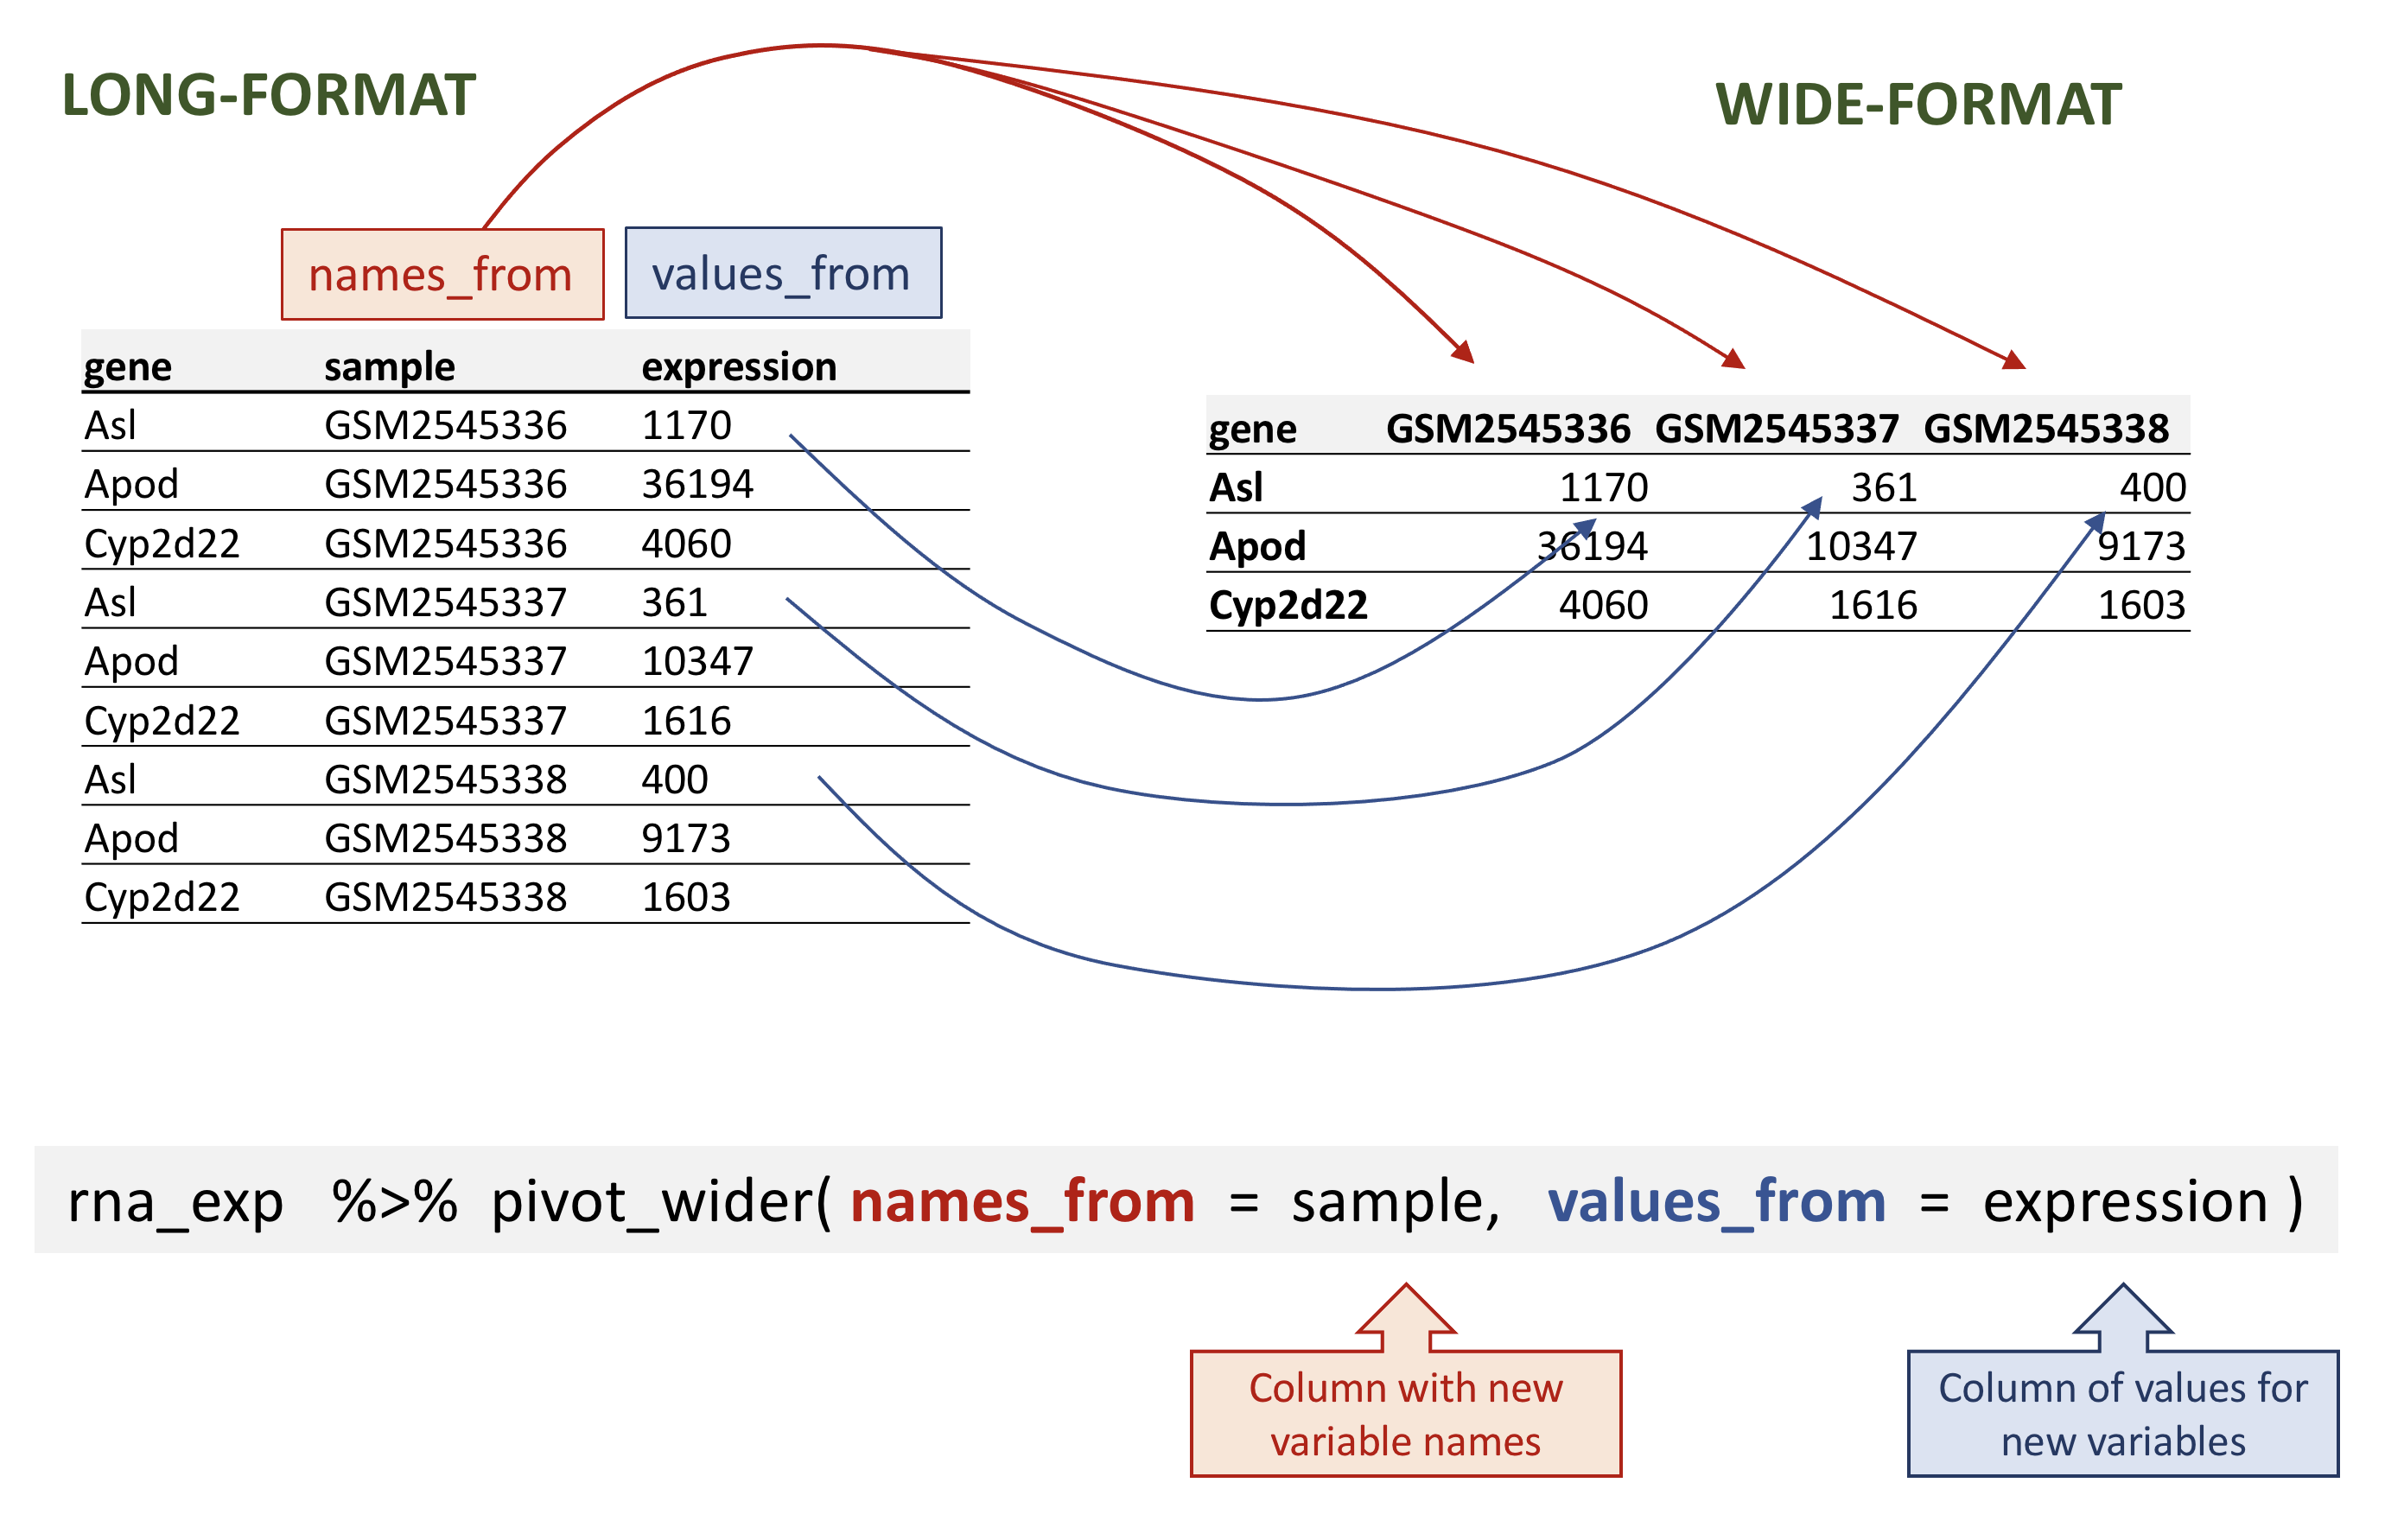
rna data.
R
rna_wide <- rna_exp |>
  pivot_wider(names_from = sample,
              values_from = expression)
rna_wide
OUTPUT
# A tibble: 1,474 × 23
   gene    GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
   <chr>        <dbl>      <dbl>      <dbl>      <dbl>      <dbl>      <dbl>
 1 Asl           1170        361        400        586        626        988
 2 Apod         36194      10347       9173      10620      13021      29594
 3 Cyp2d22       4060       1616       1603       1901       2171       3349
 4 Klk6           287        629        641        578        448        195
 5 Fcrls           85        233        244        237        180         38
 6 Slc2a4         782        231        248        265        313        786
 7 Exd2          1619       2288       2235       2513       2366       1359
 8 Gjc2           288        595        568        551        310        146
 9 Plp1         43217     101241      96534      58354      53126      27173
10 Gnb4          1071       1791       1867       1430       1355        798
# ℹ 1,464 more rows
# ℹ 16 more variables: GSM2545342 <dbl>, GSM2545343 <dbl>, GSM2545344 <dbl>,
#   GSM2545345 <dbl>, GSM2545346 <dbl>, GSM2545347 <dbl>, GSM2545348 <dbl>,
#   GSM2545349 <dbl>, GSM2545350 <dbl>, GSM2545351 <dbl>, GSM2545352 <dbl>,
#   GSM2545353 <dbl>, GSM2545354 <dbl>, GSM2545362 <dbl>, GSM2545363 <dbl>,
#   GSM2545380 <dbl>
نوٹ کریں کہ ڈیفالٹ طور پر، pivot_wider() فنکشن غائب
اقدار کے لیے NA شامل کرے گا۔
تصور کرتے ہیں کہ کسی وجہ سے، ہمارے پاس بعض نمونوں میں کچھ جینز کے لیے اظہار کی کچھ اقدار غائب تھیں۔ درج ذیل فرضی مثال میں، جین Cyp2d22 کی صرف ایک اظہار کی اقدار موجود ہیں، جو GSM2545338 نمونے میں ہیں۔
R
rna_with_missing_values <- rna |>
  select(gene, sample, expression) |>
  filter(gene %in% c("Asl", "Apod", "Cyp2d22")) |>
  filter(sample %in% c("GSM2545336", "GSM2545337", "GSM2545338")) |>
  arrange(sample) |>
  filter(!(gene == "Cyp2d22" & sample != "GSM2545338"))
rna_with_missing_values
OUTPUT
# A tibble: 7 × 3
  gene    sample     expression
  <chr>   <chr>           <dbl>
1 Asl     GSM2545336       1170
2 Apod    GSM2545336      36194
3 Asl     GSM2545337        361
4 Apod    GSM2545337      10347
5 Asl     GSM2545338        400
6 Apod    GSM2545338       9173
7 Cyp2d22 GSM2545338       1603
ڈیفالٹ طور پر، pivot_wider() فنکشن غائب اقدار کے لیے
NA شامل کرے گا۔ اسے pivot_wider() فنکشن کے
values_fill آرگومنٹ کے ذریعے پیرامیٹرائز کیا جا سکتا
ہے۔
R
rna_with_missing_values |>
  pivot_wider(names_from = sample,
              values_from = expression)
OUTPUT
# A tibble: 3 × 4
  gene    GSM2545336 GSM2545337 GSM2545338
  <chr>        <dbl>      <dbl>      <dbl>
1 Asl           1170        361        400
2 Apod         36194      10347       9173
3 Cyp2d22         NA         NA       1603
R
rna_with_missing_values |>
  pivot_wider(names_from = sample,
              values_from = expression,
              values_fill = 0)
OUTPUT
# A tibble: 3 × 4
  gene    GSM2545336 GSM2545337 GSM2545338
  <chr>        <dbl>      <dbl>      <dbl>
1 Asl           1170        361        400
2 Apod         36194      10347       9173
3 Cyp2d22          0          0       1603
ڈیٹا کو لانگ فارمیٹ میں تبدیل کرنا
اس کے برعکس صورتحال میں ہم کالم کے ناموں کا استعمال کر رہے ہیں اور انہیں نئے متغیرات کے ایک جوڑے میں تبدیل کر رہے ہیں۔ ایک متغیر کالم کے ناموں کو اقدار کے طور پر ظاہر کرتا ہے، اور دوسرا متغیر ان اقدار کو شامل کرتا ہے جو پہلے کالم کے ناموں سے وابستہ تھیں۔
pivot_longer() چار بنیادی آرگومنٹس لیتا ہے:
- تبدیل کیے جانے والے ڈیٹا؛
- the
names_to: نیا کالم کا نام جو ہم تخلیق کرنا چاہتے ہیں اور اسے موجودہ کالموں کے ناموں سے بھرنا چاہتے ہیں؛ - the
values_to: نیا کالم کا نام جسے ہم بنانا چاہتے ہیں اور اسے موجودہ اقدار سے بھرنا چاہتے ہیں؛ - ان کالموں کے نام جنہیں
names_toاورvalues_toمتغیرات بھرنے کے لیے استعمال کرنا ہے، یا جنہیں اس انتخاب سے خارج رکھنا ہے۔
rna data.
rna_wide سے rna_long کو دوبارہ تیار کرنے کے
لیے ہم sample نامی ایک کی (key) اور expression
نامی ایک ویلیو (value) بنائیں گے اور کی ویری ایبل کے لیے
gene کے علاوہ تمام کالمز استعمال کریں گے۔ یہاں منفی نشان کے
ذریعے gene کالم کو پِوٹ کیے جانے والے کالموں کے انتخاب سے
خارج رکھتے ہیں۔
غور کریں کہ یہاں نئے ویری ایبلز کے ناموں کو کوٹس (quotes) میں لکھا جائے گا۔
R
rna_long <- rna_wide |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 -gene)
rna_long
OUTPUT
# A tibble: 32,428 × 3
   gene  sample     expression
   <chr> <chr>           <dbl>
 1 Asl   GSM2545336       1170
 2 Asl   GSM2545337        361
 3 Asl   GSM2545338        400
 4 Asl   GSM2545339        586
 5 Asl   GSM2545340        626
 6 Asl   GSM2545341        988
 7 Asl   GSM2545342        836
 8 Asl   GSM2545343        535
 9 Asl   GSM2545344        586
10 Asl   GSM2545345        597
# ℹ 32,418 more rows
ہم یہ بھی کر سکتے تھے کہ کن کالمز شامل کرنے کے لیے ایک تفصیل استعمال
کریں۔ یہ تب مفید ہو سکتا ہے جب آپ کے پاس شناختی کالمز کی تعداد زیادہ ہو،
اور یہ متعین کرنا زیادہ آسان ہوتا ہے کہ کیا اکٹھا کیا جائے اور کیا چھوڑ
دیا جائے۔ یہاں starts_with() فنکشن نمونوں کے نام حاصل کرنے
میں مدد کر سکتا ہے، بغیر ان سب کو فہرست میں لکھے! ایک اور امکان
: آپریٹر کا استعمال کرنا ہو سکتا ہے!
R
rna_wide |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 cols = starts_with("GSM"))
OUTPUT
# A tibble: 32,428 × 3
   gene  sample     expression
   <chr> <chr>           <dbl>
 1 Asl   GSM2545336       1170
 2 Asl   GSM2545337        361
 3 Asl   GSM2545338        400
 4 Asl   GSM2545339        586
 5 Asl   GSM2545340        626
 6 Asl   GSM2545341        988
 7 Asl   GSM2545342        836
 8 Asl   GSM2545343        535
 9 Asl   GSM2545344        586
10 Asl   GSM2545345        597
# ℹ 32,418 more rows
R
rna_wide |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 GSM2545336:GSM2545380)
OUTPUT
# A tibble: 32,428 × 3
   gene  sample     expression
   <chr> <chr>           <dbl>
 1 Asl   GSM2545336       1170
 2 Asl   GSM2545337        361
 3 Asl   GSM2545338        400
 4 Asl   GSM2545339        586
 5 Asl   GSM2545340        626
 6 Asl   GSM2545341        988
 7 Asl   GSM2545342        836
 8 Asl   GSM2545343        535
 9 Asl   GSM2545344        586
10 Asl   GSM2545345        597
# ℹ 32,418 more rows
نوٹ کریں کہ اگر وائڈ فارمیٹ میں غیر موجود اقدار ہوتیں، تو
NA نئے لانگ فارمیٹ میں شامل ہو جاتا۔
ہمارے پچھلے مصنوعی ٹیبل (tible) کو یاد کریں جس میں غیر موجود اقدار (missing values) شامل تھیں:
R
rna_with_missing_values
OUTPUT
# A tibble: 7 × 3
  gene    sample     expression
  <chr>   <chr>           <dbl>
1 Asl     GSM2545336       1170
2 Apod    GSM2545336      36194
3 Asl     GSM2545337        361
4 Apod    GSM2545337      10347
5 Asl     GSM2545338        400
6 Apod    GSM2545338       9173
7 Cyp2d22 GSM2545338       1603
R
wide_with_NA <- rna_with_missing_values |>
  pivot_wider(names_from = sample,
              values_from = expression)
wide_with_NA
OUTPUT
# A tibble: 3 × 4
  gene    GSM2545336 GSM2545337 GSM2545338
  <chr>        <dbl>      <dbl>      <dbl>
1 Asl           1170        361        400
2 Apod         36194      10347       9173
3 Cyp2d22         NA         NA       1603
R
wide_with_NA |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 -gene)
OUTPUT
# A tibble: 9 × 3
  gene    sample     expression
  <chr>   <chr>           <dbl>
1 Asl     GSM2545336       1170
2 Asl     GSM2545337        361
3 Asl     GSM2545338        400
4 Apod    GSM2545336      36194
5 Apod    GSM2545337      10347
6 Apod    GSM2545338       9173
7 Cyp2d22 GSM2545336         NA
8 Cyp2d22 GSM2545337         NA
9 Cyp2d22 GSM2545338       1603
وائڈ اور لانگ فارمیٹس میں تبدیلی کرنا ڈیٹا سیٹ کو متوازن کرنے کا ایک مفید طریقہ ہو سکتا ہے تاکہ ہر ریپلیکیٹ کی ترکیب ایک جیسی رہے۔
سوال
rna ٹیبل سے آغاز کرتے ہوئے، pivot_wider() فنکشن کا
استعمال کرتے ہوئے ایک وائڈ فارمیٹ ٹیبل بنائیں جو ہر چوہے میں جین کے
اظہار کی سطحیں ظاہر کرے۔ پھر pivot_longer() فنکشن کا
استعمال کرتے ہوئے لانگ فارمیٹ ٹیبل کو بحال کریں۔
R
rna1 <- rna |>
select(gene, mouse, expression) |>
pivot_wider(names_from = mouse, values_from = expression)
rna1
OUTPUT
# A tibble: 1,474 × 23
   gene     `14`    `9`  `10`  `15`  `18`   `6`   `5`  `11`  `22`  `13`  `23`
   <chr>   <dbl>  <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
 1 Asl      1170    361   400   586   626   988   836   535   586   597   938
 2 Apod    36194  10347  9173 10620 13021 29594 24959 13668 13230 15868 27769
 3 Cyp2d22  4060   1616  1603  1901  2171  3349  3122  2008  2254  2277  2985
 4 Klk6      287    629   641   578   448   195   186  1101   537   567   327
 5 Fcrls      85    233   244   237   180    38    68   375   199   177    89
 6 Slc2a4    782    231   248   265   313   786   528   249   266   357   654
 7 Exd2     1619   2288  2235  2513  2366  1359  1474  3126  2379  2173  1531
 8 Gjc2      288    595   568   551   310   146   186   791   454   370   240
 9 Plp1    43217 101241 96534 58354 53126 27173 28728 98658 61356 61647 38019
10 Gnb4     1071   1791  1867  1430  1355   798   806  2437  1394  1554   960
# ℹ 1,464 more rows
# ℹ 11 more variables: `24` <dbl>, `8` <dbl>, `7` <dbl>, `1` <dbl>, `16` <dbl>,
#   `21` <dbl>, `4` <dbl>, `2` <dbl>, `20` <dbl>, `12` <dbl>, `19` <dbl>
R
rna1 |>
pivot_longer(names_to = "mouse_id", values_to = "counts", -gene)
OUTPUT
# A tibble: 32,428 × 3
   gene  mouse_id counts
   <chr> <chr>     <dbl>
 1 Asl   14         1170
 2 Asl   9           361
 3 Asl   10          400
 4 Asl   15          586
 5 Asl   18          626
 6 Asl   6           988
 7 Asl   5           836
 8 Asl   11          535
 9 Asl   22          586
10 Asl   13          597
# ℹ 32,418 more rowsسوال
rna ڈیٹا فریم سے X اور Y کروموسومز پر واقع جینز کا ایک
سب سیٹ بنائیں اور ڈیٹا فریم کو sex کو کالموں،
chromosome_name کو قطاروں، اور ہر کروموسوم پر واقع جینز کے
اوسط اظہار کو اقدار کے طور پر استعمال کرتے ہوئے، درج ذیل ٹیبل کی صورت
میں اسپریڈ کریں:
آپ کو ریشیپینگ کرنے سے پہلے خلاصہ تیار کرنے کی ضرورت ہوگی!
آئیے پہلے نر اور مادہ چوہوں کے نمونوں میں X اور Y کروموسومز پر واقع جینز کے اظہار کی اوسط سطح کا حساب لگائیں…
R
 rna |>
  filter(chromosome_name == "Y" | chromosome_name == "X") |>
  group_by(sex, chromosome_name) |>
  summarise(mean = mean(expression))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by sex and chromosome_name.
ℹ Output is grouped by sex.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(sex, chromosome_name))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 4 × 3
# Groups:   sex [2]
  sex    chromosome_name  mean
  <chr>  <chr>           <dbl>
1 Female X               3504.
2 Female Y                  3
3 Male   X               2497.
4 Male   Y               2117.
اور ٹیبل کو وائڈ فارمیٹ میں تبدیل کریں
R
rna_1 <- rna |>
  filter(chromosome_name == "Y" | chromosome_name == "X") |>
  group_by(sex, chromosome_name) |>
  summarise(mean = mean(expression)) |>
  pivot_wider(names_from = sex,
              values_from = mean)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by sex and chromosome_name.
ℹ Output is grouped by sex.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(sex, chromosome_name))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
rna_1
OUTPUT
# A tibble: 2 × 3
  chromosome_name Female  Male
  <chr>            <dbl> <dbl>
1 X                3504. 2497.
2 Y                   3  2117.
اب اس ڈیٹا فریم کو لیں اور اسے pivot_longer() کے ذریعے
تبدیل کریں تاکہ ہر قطار ایک منفرد chromosome_name اور
gender کا مجموعہ ہو۔
R
rna_1 |>
  pivot_longer(names_to = "gender",
               values_to = "mean",
               -chromosome_name)
OUTPUT
# A tibble: 4 × 3
  chromosome_name gender  mean
  <chr>           <chr>  <dbl>
1 X               Female 3504.
2 X               Male   2497.
3 Y               Female    3
4 Y Male 2117.سوال
rna ڈیٹا سیٹ کا استعمال کرتے ہوئے ایک ایکسپریشن میٹرکس
بنائیں جہاں ہر قطار جینز کی اوسط اظہار کی سطحوں کی نمائندگی کرے اور کالم
مختلف وقت کے مقامات کی نمائندگی کریں۔
آئیے پہلے جین کے لحاظ سے اور وقت کے لحاظ سے اوسط اظہار کا حساب لگائیں۔
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 4,422 × 3
# Groups:   gene [1,474]
   gene      time mean_exp
   <chr>    <dbl>    <dbl>
 1 AI504432     0    1034.
 2 AI504432     4    1104.
 3 AI504432     8    1014
 4 AW046200     0     155.
 5 AW046200     4     152.
 6 AW046200     8      81
 7 AW551984     0     238
 8 AW551984     4     302.
 9 AW551984     8     342.
10 Aamp         0    4603.
# ℹ 4,412 more rows
pivot_wider() فنکشن استعمال کرنے سے پہلے
R
rna_time <- rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
rna_time
OUTPUT
# A tibble: 1,474 × 4
# Groups:   gene [1,474]
   gene         `0`     `4`     `8`
   <chr>      <dbl>   <dbl>   <dbl>
 1 AI504432 1034.   1104.   1014
 2 AW046200  155.    152.     81
 3 AW551984  238     302.    342.
 4 Aamp     4603.   4870    4763.
 5 Abca12      5.29    4.25    4.14
 6 Abcc8    2576.   2609.   2292.
 7 Abhd14a   591.    547.    432.
 8 Abi2     4881.   4903.   4945.
 9 Abi3bp   1175.   1061.    762.
10 Abl2     2170.   2078.   2131.
# ℹ 1,464 more rows
نوٹ کریں کہ اس سے ایک ایسا ٹیبل (tibble) بنتا ہے جس کے کچھ کالم کے نام نمبر سے شروع ہوتے ہیں۔ اگر ہم ٹائم پوائنٹس سے متعلق کالم کو منتخب کرنا چاہتے ہوں، تو ہم کالم کے ناموں کو براہِ راست استعمال نہیں کر سکتے… جب ہم کالم 4 کو منتخب کرتے ہیں تو کیا ہوتا ہے؟
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  select(gene, 4)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 1,474 × 2
# Groups:   gene [1,474]
   gene         `8`
   <chr>      <dbl>
 1 AI504432 1014
 2 AW046200   81
 3 AW551984  342.
 4 Aamp     4763.
 5 Abca12      4.14
 6 Abcc8    2292.
 7 Abhd14a   432.
 8 Abi2     4945.
 9 Abi3bp    762.
10 Abl2     2131.
# ℹ 1,464 more rows
ٹائم پوائنٹ 4 کو منتخب کرنے کے لیے، ہمیں کالم کے نام کو کوٹس کرنے پڑیں گے، بیک ٹکس “`” کے ذریعے۔
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  select(gene, `4`)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 1,474 × 2
# Groups:   gene [1,474]
   gene         `4`
   <chr>      <dbl>
 1 AI504432 1104.
 2 AW046200  152.
 3 AW551984  302.
 4 Aamp     4870
 5 Abca12      4.25
 6 Abcc8    2609.
 7 Abhd14a   547.
 8 Abi2     4903.
 9 Abi3bp   1061.
10 Abl2     2078.
# ℹ 1,464 more rows
ایک اور امکان کالم کا نام تبدیل کرنا ہو سکتا ہے، ایسا نام منتخب کرتے ہوئے جو نمبر سے شروع نہ ہو:
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  rename("time0" = `0`, "time4" = `4`, "time8" = `8`) |>
  select(gene, time4)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 1,474 × 2
# Groups:   gene [1,474]
   gene       time4
   <chr>      <dbl>
 1 AI504432 1104.
 2 AW046200  152.
 3 AW551984  302.
 4 Aamp     4870
 5 Abca12      4.25
 6 Abcc8    2609.
 7 Abhd14a   547.
 8 Abi2     4903.
 9 Abi3bp   1061.
10 Abl2     2078.
# ℹ 1,464 more rowsسوال
ہر ٹائم پوائنٹ کے لیے اوسط اظہار کی سطحوں پر مشتمل پچھلے ڈیٹا فریم کا استعمال کریں اور ایک نیا کالم بنائیں جس میں ٹائم پوائنٹ 8 اور ٹائم پوائنٹ 0 کے درمیان فولڈ چینجز، اور ٹائم پوائنٹ 8 اور ٹائم پوائنٹ 4 کے درمیان فولڈ چینجز شامل ہوں۔ اس ٹیبل کو ایک لانگ فارمیٹ ٹیبل میں تبدیل کریں جس میں حساب کیے گئے فولڈ چینجز شامل ہوں۔
rna_time tibble سے آغاز کرتے ہوئے:
R
rna_time
OUTPUT
# A tibble: 1,474 × 4
# Groups:   gene [1,474]
   gene         `0`     `4`     `8`
   <chr>      <dbl>   <dbl>   <dbl>
 1 AI504432 1034.   1104.   1014
 2 AW046200  155.    152.     81
 3 AW551984  238     302.    342.
 4 Aamp     4603.   4870    4763.
 5 Abca12      5.29    4.25    4.14
 6 Abcc8    2576.   2609.   2292.
 7 Abhd14a   591.    547.    432.
 8 Abi2     4881.   4903.   4945.
 9 Abi3bp   1175.   1061.    762.
10 Abl2     2170.   2078.   2131.
# ℹ 1,464 more rows
فولڈ چینجز کا حساب لیں:
R
rna_time |>
  mutate(time_8_vs_0 = `8` / `0`, time_8_vs_4 = `8` / `4`)
OUTPUT
# A tibble: 1,474 × 6
# Groups:   gene [1,474]
   gene         `0`     `4`     `8` time_8_vs_0 time_8_vs_4
   <chr>      <dbl>   <dbl>   <dbl>       <dbl>       <dbl>
 1 AI504432 1034.   1104.   1014          0.981       0.918
 2 AW046200  155.    152.     81          0.522       0.532
 3 AW551984  238     302.    342.         1.44        1.13
 4 Aamp     4603.   4870    4763.         1.03        0.978
 5 Abca12      5.29    4.25    4.14       0.784       0.975
 6 Abcc8    2576.   2609.   2292.         0.889       0.878
 7 Abhd14a   591.    547.    432.         0.731       0.791
 8 Abi2     4881.   4903.   4945.         1.01        1.01
 9 Abi3bp   1175.   1061.    762.         0.649       0.719
10 Abl2     2170.   2078.   2131.         0.982       1.03
# ℹ 1,464 more rows
اور pivot_longer() فنکشن کا استعمال کریں:
R
rna_time |>
  mutate(time_8_vs_0 = `8` / `0`, time_8_vs_4 = `8` / `4`) |>
  pivot_longer(names_to = "comparisons",
               values_to = "Fold_changes",
               time_8_vs_0:time_8_vs_4)
OUTPUT
# A tibble: 2,948 × 6
# Groups:   gene [1,474]
   gene         `0`     `4`     `8` comparisons Fold_changes
   <chr>      <dbl>   <dbl>   <dbl> <chr>              <dbl>
 1 AI504432 1034.   1104.   1014    time_8_vs_0        0.981
 2 AI504432 1034.   1104.   1014    time_8_vs_4        0.918
 3 AW046200  155.    152.     81    time_8_vs_0        0.522
 4 AW046200  155.    152.     81    time_8_vs_4        0.532
 5 AW551984  238     302.    342.   time_8_vs_0        1.44
 6 AW551984  238     302.    342.   time_8_vs_4        1.13
 7 Aamp     4603.   4870    4763.   time_8_vs_0        1.03
 8 Aamp     4603.   4870    4763.   time_8_vs_4        0.978
 9 Abca12      5.29    4.25    4.14 time_8_vs_0        0.784
10 Abca12      5.29    4.25    4.14 time_8_vs_4        0.975
# ℹ 2,938 more rows
ٹیبلز کو جوڑنا
حیاتیاتی دنیا کی بہت سی صورتحال میں، ڈیٹا متعدد ٹیبلز میں پھیلا ہوتا ہے۔ عام طور پر ایسا اس لیے ہوتا ہے کیونکہ مختلف اقسام کی معلومات مختلف ذرائع سے جمع کی جاتی ہیں۔
کچھ تجزیوں کے لیے یہ مطلوب ہو سکتا ہے کہ دو یا دو سے زیادہ ٹیبلز کے ڈیٹا کو ایک ایسے کالم کی بنیاد پر ایک ہی ڈیٹا فریم میں یکجا کیا جائے جو تمام ٹیبلز میں مشترک ہو۔
dplyr پیکیج مخصوص کالموں میں مطابقت کی بنیاد پر دو ڈیٹا
فریمز کو یکجا کرنے کے لیے جوائن فنکشنز کا ایک سیٹ فراہم کرتا ہے۔ یہاں،
ہم جوائنز کا ایک مختصر تعارف پیش کرتے ہیں۔ مزید مطالعے کے لیے، براہِ کرم
ٹیبل
جوائنز سے متعلق باب دیکھیں۔ ڈیٹا
ٹرانسفارمیشن چیٹ شیٹ بھی ٹیبل جوائنز کا ایک مختصر جائزہ فراہم کرتی
ہے۔
ہم ایک چھوٹی ٹیبل، rna_mini کے ذریعے جوڑنے کی وضاحت کریں
گے، جسے ہم اصل rna ٹیبل سے سب سیٹ کر کے تیار کریں گے، جس
میں صرف 3 کالم اور 10 قطاریں رکھی جائیں گی۔
R
rna_mini <- rna |>
   select(gene, sample, expression) |>
   head(10)
rna_mini
OUTPUT
# A tibble: 10 × 3
   gene    sample     expression
   <chr>   <chr>           <dbl>
 1 Asl     GSM2545336       1170
 2 Apod    GSM2545336      36194
 3 Cyp2d22 GSM2545336       4060
 4 Klk6    GSM2545336        287
 5 Fcrls   GSM2545336         85
 6 Slc2a4  GSM2545336        782
 7 Exd2    GSM2545336       1619
 8 Gjc2    GSM2545336        288
 9 Plp1    GSM2545336      43217
10 Gnb4    GSM2545336       1071
دوسرا ٹیبل، annot1، میں 2 کالمز، gene اور
gene_description شامل ہیں۔ آپ یا تو لنک پر کلک کر کے annot1.csv
ڈاؤن لوڈ کر سکتے ہیں اور پھر اسے data/ فولڈر میں منتقل
کر سکتے ہیں، یا پھر آپ نیچے دیے گئے R کوڈ کا استعمال کرتے ہوئے اسے براہِ
راست فولڈر میں ڈاؤن لوڈ کر سکتے ہیں۔
R
download.file(url = "https://carpentries-incubator.github.io/bioc-intro/data/annot1.csv",
              destfile = "data/annot1.csv")
annot1 <- read_csv(file = "data/annot1.csv")
annot1
OUTPUT
# A tibble: 10 × 2
gene gene_description
<chr> <chr>
1 Cyp2d22 cytochrome P450, family 2, subfamily d, polypeptide 22 [Source:MGI S…
2 Klk6 kallikrein related-peptidase 6 [Source:MGI Symbol;Acc:MGI:1343166]
3 Fcrls Fc receptor-like S, scavenger receptor [Source:MGI Symbol;Acc:MGI:19…
4 Plp1 proteolipid protein (myelin) 1 [Source:MGI Symbol;Acc:MGI:97623]
5 Exd2 exonuclease 3'-5' domain containing 2 [Source:MGI Symbol;Acc:MGI:192…
6 Apod apolipoprotein D [Source:MGI Symbol;Acc:MGI:88056]
7 Gnb4 guanine nucleotide binding protein (G protein), beta 4 [Source:MGI S…
8 Slc2a4 solute carrier family 2 (facilitated glucose transporter), member 4 …
9 Asl argininosuccinate lyase [Source:MGI Symbol;Acc:MGI:88084]
10 Gjc2 gap junction protein, gamma 2 [Source:MGI Symbol;Acc:MGI:2153060] اب ہم dplyr پیکیج کے full_join() فنکشن کا
استعمال کرتے ہوئے ان دو ٹیبلز کو ایک ہی ٹیبل میں یکجا کرنا چاہتے ہیں جس
میں تمام متغیرات شامل ہوں۔ یہ فنکشن خود بخود پہلے اور دوسرے ٹیبل کے
کالموں کو میل کرنے کے لیے مشترکہ متغیر کو تلاش کر لے گا۔ اس صورت میں،
gene مشترکہ متغیر ہے۔ ایسے متغیرات کو کیز (keys) کہا جاتا
ہے۔ کیز کا استعمال مختلف ٹیبلز کے درمیان مشاہدات (observations) کو میل
کرنے کے لیے کیا جاتا ہے۔
R
full_join(rna_mini, annot1)
OUTPUT
Joining with `by = join_by(gene)`OUTPUT
# A tibble: 10 × 4
gene sample expression gene_description
<chr> <chr> <dbl> <chr>
1 Asl GSM2545336 1170 argininosuccinate lyase [Source:MGI Symbol;Acc…
2 Apod GSM2545336 36194 apolipoprotein D [Source:MGI Symbol;Acc:MGI:88…
3 Cyp2d22 GSM2545336 4060 cytochrome P450, family 2, subfamily d, polype…
4 Klk6 GSM2545336 287 kallikrein related-peptidase 6 [Source:MGI Sym…
5 Fcrls GSM2545336 85 Fc receptor-like S, scavenger receptor [Source…
6 Slc2a4 GSM2545336 782 solute carrier family 2 (facilitated glucose t…
7 Exd2 GSM2545336 1619 exonuclease 3'-5' domain containing 2 [Source:…
8 Gjc2 GSM2545336 288 gap junction protein, gamma 2 [Source:MGI Symb…
9 Plp1 GSM2545336 43217 proteolipid protein (myelin) 1 [Source:MGI Sym…
10 Gnb4 GSM2545336 1071 guanine nucleotide binding protein (G protein)…حقیقی زندگی میں، جین اینوٹیشنز کو کبھی کبھی مختلف طریقے سے لیبل کیا جاتا ہے۔
annot2 ٹیبل بالکل ویسا ہی ہے جیسا annot1،
سوائے اس کے کہ جینز کے ناموں پر مشتمل ویری ایبل کی لیبلنگ مختلف ہے۔ ایک
بار پھر، یا تو خود annot2.csv
ڈاؤن لوڈ کریں اور اسے data/ میں منتقل کریں یا نیچے دیے
گئے R کوڈ کا استعمال کریں۔
R
download.file(url = "https://carpentries-incubator.github.io/bioc-intro/data/annot2.csv",
destfile = "data/annot2.csv")
annot2 <- read_csv(file = "data/annot2.csv")
annot2
OUTPUT
# A tibble: 10 × 2
external_gene_name description
<chr> <chr>
1 Cyp2d22 cytochrome P450, family 2, subfamily d, polypeptide 22 [S…
2 Klk6 kallikrein related-peptidase 6 [Source:MGI Symbol;Acc:MGI…
3 Fcrls Fc receptor-like S, scavenger receptor [Source:MGI Symbol…
4 Plp1 proteolipid protein (myelin) 1 [Source:MGI Symbol;Acc:MGI…
5 Exd2 exonuclease 3'-5' domain containing 2 [Source:MGI Symbol;…
6 Apod apolipoprotein D [Source:MGI Symbol;Acc:MGI:88056]
7 Gnb4 guanine nucleotide binding protein (G protein), beta 4 [S…
8 Slc2a4 solute carrier family 2 (facilitated glucose transporter)…
9 Asl argininosuccinate lyase [Source:MGI Symbol;Acc:MGI:88084]
10 Gjc2 gap junction protein, gamma 2 [Source:MGI Symbol;Acc:MGI:…اگر متغیرات کے کوئی بھی نام میل نہ کرے، تو ہم میل کرنے کے لیے استعمال
ہونے والے متغیرات کو دستی طور پر سیٹ کر سکتے ہیں۔ ان متغیرات کو
by آرگومنٹ کے ذریعے سیٹ کیا جا سکتا ہے، جیسا کہ نیچے
rna_mini اور annot2 ٹیبلز کے ساتھ دکھایا گیا
ہے۔
R
full_join(rna_mini, annot2, by = c("gene" = "external_gene_name"))
OUTPUT
# A tibble: 10 × 4
gene sample expression description
<chr> <chr> <dbl> <chr>
1 Asl GSM2545336 1170 argininosuccinate lyase [Source:MGI Symbol;Acc…
2 Apod GSM2545336 36194 apolipoprotein D [Source:MGI Symbol;Acc:MGI:88…
3 Cyp2d22 GSM2545336 4060 cytochrome P450, family 2, subfamily d, polype…
4 Klk6 GSM2545336 287 kallikrein related-peptidase 6 [Source:MGI Sym…
5 Fcrls GSM2545336 85 Fc receptor-like S, scavenger receptor [Source…
6 Slc2a4 GSM2545336 782 solute carrier family 2 (facilitated glucose t…
7 Exd2 GSM2545336 1619 exonuclease 3'-5' domain containing 2 [Source:…
8 Gjc2 GSM2545336 288 gap junction protein, gamma 2 [Source:MGI Symb…
9 Plp1 GSM2545336 43217 proteolipid protein (myelin) 1 [Source:MGI Sym…
10 Gnb4 GSM2545336 1071 guanine nucleotide binding protein (G protein)…جیسا کہ اوپر دیکھا جا سکتا ہے، پہلے ٹیبل کا ویری ایبل نام جوڑے ہوئے ٹیبل میں برقرار رہا ہے۔
چیلنج:
اس
لنک پر کلک کر کے annot3 ٹیبل ڈاؤن لوڈ کریں اور اس ٹیبل
کو اپنے data/ ریپوزٹری میں رکھیں۔ full_join() فنکشن کا
استعمال کرتے ہوئے، ٹیبلز rna_mini اور annot3
کو جوڑیں۔ جینز Klk6، mt-Tf، mt-Rnr1،
mt-Tv، mt-Rnr2، اور mt-Tl1 کے ساتھ کیا ہوا
ہے؟
R
annot3 <- read_csv("data/annot3.csv")
full_join(rna_mini, annot3)
OUTPUT
# A tibble: 15 × 4
gene sample expression gene_description
<chr> <chr> <dbl> <chr>
1 Asl GSM2545336 1170 argininosuccinate lyase [Source:MGI Symbol;Acc…
2 Apod GSM2545336 36194 apolipoprotein D [Source:MGI Symbol;Acc:MGI:88…
3 Cyp2d22 GSM2545336 4060 cytochrome P450, family 2, subfamily d, polype…
4 Klk6 GSM2545336 287 <NA>
5 Fcrls GSM2545336 85 Fc receptor-like S, scavenger receptor [Source…
6 Slc2a4 GSM2545336 782 solute carrier family 2 (facilitated glucose t…
7 Exd2 GSM2545336 1619 exonuclease 3'-5' domain containing 2 [Source:…
8 Gjc2 GSM2545336 288 gap junction protein, gamma 2 [Source:MGI Symb…
9 Plp1 GSM2545336 43217 proteolipid protein (myelin) 1 [Source:MGI Sym…
10 Gnb4 GSM2545336 1071 guanine nucleotide binding protein (G protein)…
11 mt-Tf <NA> NA mitochondrially encoded tRNA phenylalanine [So…
12 mt-Rnr1 <NA> NA mitochondrially encoded 12S rRNA [Source:MGI S…
13 mt-Tv <NA> NA mitochondrially encoded tRNA valine [Source:MG…
14 mt-Rnr2 <NA> NA mitochondrially encoded 16S rRNA [Source:MGI S…
15 mt-Tl1 <NA> NA mitochondrially encoded tRNA leucine 1 [Source…جین Klk6 صرف rna_mini میں موجود ہے، جبکہ جینز
mt-Tf، mt-Rnr1، mt-Tv، mt-Rnr2، اور
mt-Tl1 صرف annot3 ٹیبل میں موجود ہیں۔ ٹیبل کے
متغیرات کے لیے ان کی متعلقہ اقدار کو missing کے طور پر کوڈ کیا گیا
ہے۔
ڈیٹا کی ایکسپورٹنگ
اب جب کہ آپ نے اپنے خام ڈیٹا سے معلومات نکالنے یا اس کا خلاصہ تیار
کرنے کے لیے dplyr کا استعمال سیکھ لیا ہے، ہو سکتا ہے کہ آپ
ان نئے ڈیٹا سیٹس کو ایکسپورٹ کرنا چاہیں تاکہ انہیں اپنے ساتھیوں کے ساتھ
شیئر کر سکیں یا آرکائیو کے لیے محفوظ کر سکیں۔
R میں CSV فائلوں کو پڑھنے کے لیے استعمال ہونے والے
read_csv() فنکشن کی طرح، ایک write_csv() فنکشن
بھی موجود ہے جو ڈیٹا فریمز سے CSV فائلیں تیار کرتا ہے۔
write_csv() استعمال کرنے سے پہلے، ہم اپنی ورکنگ
ڈائریکٹری میں ایک نیا فولڈر، data_output، بنائیں گے جس میں
یہ تیار کردہ ڈیٹا سیٹ محفوظ کیا جائے گا۔ ہم تیار کردہ ڈیٹا سیٹس کو اپنے
خام ڈیٹا کے اسی ڈائریکٹری میں نہیں لکھنا چاہتے۔ انہیں الگ رکھنا ایک بہتر
طریقہ کار ہے۔ data فولڈر میں صرف خام اور غیر تبدیل شدہ ڈیٹا
ہونا چاہیے، اور اسے ایسے ہی رہنے دیا جائے تاکہ اس بات کو یقینی بنایا جا
سکے کہ ہم اسے حذف یا تبدیل نہیں کرتے۔ اس کے برعکس، ہمارا اسکرپٹ
data_output ڈائریکٹری کا مواد تیار کرے گا، لہذا اگر اس میں
موجود فائلیں حذف بھی کر دی جائیں، تو ہم انہیں ہمیشہ دوبارہ تیار کر سکتے
ہیں۔
آئیے write_csv() کا استعمال کریں تاکہ اس rna_wide ٹیبل
کو محفوظ کر سکیں جو ہم نے پہلے تیار کیا تھا۔
R
write_csv(rna_wide, file = "data_output/rna_wide.csv")
- tidyverse میٹا-پیکیج کا استعمال کرتے ہوئے R میں ٹیبلر ڈیٹا
Content from ڈیٹا کی بصری عکاسی
Last updated on 2026-11-11 | Edit this page
Overview
Questions
- R میں بصری نمائش
Objectives
- ggplot کا استعمال کرتے ہوئے اسکیٹر پلاٹس، باکس پلاٹس، لائن پلاٹس وغیرہ تیار کریں۔
- پلاٹ کی عمومی سیٹنگز مقرر کریں۔
- بتائیں کہ فیسیٹنگ کیا ہے اور ggplot میں فیسیٹنگ کا استعمال کریں۔
- ایک موجودہ ggplot پلوٹ کی جمالیاتی خصوصیات (بشمول محور کے لیبلز اور رنگ) میں ترمیم کریں۔
- ایک ڈیٹا فریم میں موجود ڈیٹا سے پیچیدہ اور کسٹمائزڈ پلوٹس تیار کریں۔
یہ ایپیسوڈ Data Carpentries کے Data Analysis and Visualisation in R for Ecologists اسباق پر مبنی ہے۔
ڈیٹا کی بصری عکاسی
ہم ضروری پیکجز کو لوڈ کرنے سے آغاز کرتے ہیں۔
ggplot2
tidyverse پیکج میں شامل ہے۔
R
library("tidyverse")
اگر یہ ابھی تک ورک اسپیس میں موجود نہیں ہے، تو پچھلے اسباق میں محفوظ کیے گئے ڈیٹا کو لوڈ کریں۔
R
rna <- read.csv("data/rnaseq.csv")
ڈیٹا
ویژولائزیشن چیٹ شیٹ میں ggplot2 کی بنیادی چیزوں اور
زیادہ جدید خصوصیات کا احاطہ کیا جائے گا، اور یہ ایک یاددہانی کے طور پر
کام کرنے کے ساتھ ساتھ پیکیج میں دستیاب ڈیٹا کی متعدد نمائندگیوں کا جائزہ
لینے میں بھی مددگار ثابت ہوگی۔ تھامس لن پیڈرسن کے درج ذیل ویڈیو
ٹیوٹوریلز (حصہ
1 اور حصہ
2) بھی انتہائی معلوماتی ہیں۔
ggplot2 کے ذریعے پلوٹنگ
ggplot2 ایک پلوٹنگ پیکیج ہے جو ڈیٹا فریم میں موجود ڈیٹا
سے پیچیدہ پلوٹس بنانا آسان بنا دیتا ہے۔ یہ ان متغیرات کی نشاندہی کرنے،
ان کے ظاہر ہونے کے طریقے اور عمومی بصری خصوصیات کے لیے ایک زیادہ
پروگرامی انٹرفیس فراہم کرتا ہے۔ ggplot2 کی حمایت کرنے والی
نظریاتی بنیاد Grammar of Graphics ( Wilkinson (2005) ) ہے۔ اس طریقہ کار کے ذریعے،
اگر بنیادی ڈیٹا تبدیل ہو جائے یا ہم بار پلوٹ سے اسکیٹر پلوٹ میں تبدیلی
کرنے کا فیصلہ کریں، تو ہمیں صرف معمولی تبدیلیوں کی ضرورت ہوتی ہے۔ یہ کم
سے کم ایڈجسٹمنٹس اور تھوڑی سی تبدیلیوں کے ساتھ اشاعتی معیار کے پلوٹس
بنانے میں مدد دیتا ہے۔
ggplot2 ( Wickham (2016) )
کے بارے میں ایک کتاب موجود ہے جو ایک اچھا جائزہ فراہم کرتی ہے، لیکن وہ
پرانی ہو چکی ہے۔ تیسری ایڈیشن تیار کی جا رہی ہے اور یہ آن لائن مفت دستیاب ہوگی۔
ggplot2 کا ویب پیج (https://ggplot2.tidyverse.org)
کافی دستاویزات فراہم کرتا ہے۔
ggplot2 کے فنکشنز ‘لانگ’ فارمیٹ والے ڈیٹا کے ساتھ بہتر
کام کرتے ہیں، یعنی ہر ڈائمنشن کے لیے ایک کالم اور ہر مشاہدے کے لیے ایک
قطار۔ منظم ڈیٹا ggplot2 کے ذریعے فیگرز تیار کرتے وقت آپ کا
بہت سارا وقت بچائے گا۔
ggplot گرافکس نئے عناصر شامل کرتے ہوئے مرحلہ وار تیار کیے جاتے ہیں۔ اس طریقے سے لیئرز شامل کرنے سے پلوٹس میں وسیع لچک اور کسٹمائزیشن کی سہولت ملتی ہے۔
گرافکس کے گرامر کے پیچھے موجود خیال یہ ہے کہ آپ ہر گراف کو انہی 3 اجزاء سے بنا سکتے ہیں: (1) ایک ڈیٹا سیٹ، (2) ایک کوآرڈینیٹ سسٹم، اور (3) جیومز — یعنی ویژول مارکس جو ڈیٹا پوائنٹس کی نمائندگی کرتے ہیں 1
ggplot بنانے کے لیے، ہم درج ذیل بنیادی ٹیمپلیٹ استعمال کریں گے جسے مختلف اقسام کے پلوٹس کے لیے استعمال کیا جا سکتا ہے:
ggplot(data = <DATA>, mapping = aes(<MAPPINGS>)) + <GEOM_FUNCTION>()-
ggplot()فنکشن استعمال کریں اورdataآرگومنٹ کے ذریعے پلوٹ کو ایک مخصوص ڈیٹا فریم سے منسلک کریں۔
R
ggplot(data = rna)
- ایک میپنگ (aesthetic (
aes) فانکشن کا استعمال کرتے ہوئے) متعین کریں، جس میں پلوٹ کیے جانے والے ویری ایبلز کا انتخاب کیا جائے اور یہ تفصیل دی جائے کہ انہیں گراف میں کیسے پیش کیا جائے، مثلاً x/y پوزیشنز کے طور پر یا سائز، شکل، رنگ وغیرہ جیسی خصوصیات کے طور پر۔
R
ggplot(data = rna, mapping = aes(x = expression))
-
‘geoms’ شامل کریں - جیومیٹریز، یا پلاٹ میں ڈیٹا کی گرافیکل نمائندگیاں (پوائنٹس، لائنیں، بارز)۔
ggplot2بہت سے مختلف geoms فراہم کرتا ہے؛ ہم آج کچھ عام استعمال ہونے والے geoms استعمال کریں گے، جن میں شامل ہیں:* `geom_point()` for scatter plots, dot plots, etc. * `geom_histogram()` for histograms * `geom_boxplot()` for, well, boxplots! * `geom_line()` for trend lines, time series, etc.
پلاٹ میں جیومیٹری (geometry) شامل کرنے کے لیے + آپریٹر
استعمال کریں۔ آئیے پہلے geom_histogram() استعمال کرتے
ہیں:
R
ggplot(data = rna, mapping = aes(x = expression)) +
geom_histogram()
OUTPUT
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.
ggplot2 پیکج میں موجود + خاص طور پر مفید ہے
کیونکہ یہ آپ کو موجودہ ggplot آبجیکٹس میں تبدیلی کرنے کی
اجازت دیتا ہے۔ اس کا مطلب ہے کہ آپ آسانی سے پلوٹ ٹیمپلیٹس تیار کر سکتے
ہیں اور مختلف اقسام کے پلوٹس کو آسانی سے کھوج سکتے ہیں، لہذا مذکورہ بالا
پلوٹ کو اس طرح کے کوڈ کے ذریعے بھی تیار کیا جا سکتا ہے:
R
# Assign plot to a variable
rna_plot <- ggplot(data = rna,
mapping = aes(x = expression))
# Draw the plot
rna_plot + geom_histogram()
چیلنج
آپ نے غالباً ایک خودکار پیغام دیکھا ہوگا جو ہسٹوگرام بناتے وقت ظاہر ہوتا ہے:
OUTPUT
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.بائنز کی تعداد یا چوڑائی تبدیل کرنے کے لیے
geom_histogram() کے آرگیومنٹس bins یا
binwidth کو تبدیل کریں۔
R
# change bins
ggplot(rna, aes(x = expression)) +
geom_histogram(bins = 15)
R
# change binwidth
ggplot(rna, aes(x = expression)) +
geom_histogram(binwidth = 2000)
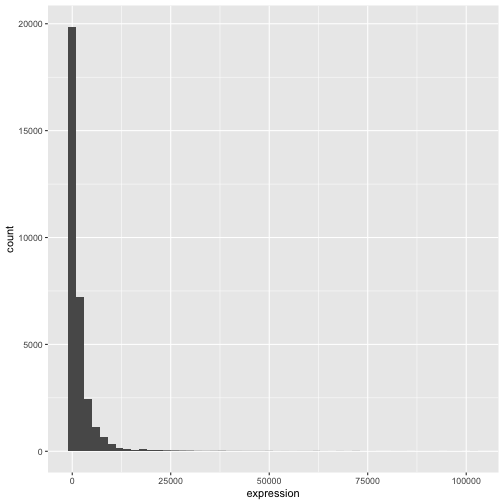
ہم یہاں دیکھ سکتے ہیں کہ ڈیٹا دائیں جانب جھکا ہوا ہے۔ ہم زیادہ متماثل
تقسیم حاصل کرنے کے لیے اساس 2 کی لوگارتھمی تبدیلی لاگو کر سکتے ہیں۔ نوٹ
کریں کہ ہم یہاں ایک چھوٹی مستقل ویلیو (+1) شامل کر رہے ہیں
تاکہ 0 کے برابر اظہار کی ویلیوز کے لیے -Inf ویلیوز واپس نہ
آئیں۔
R
rna <- rna |>
mutate(expression_log = log2(expression + 1))
اگر ہم اب اساس 2 کی لوگارتھمی تبدیلی کے بعد اظہارات کا ہسٹوگرام بنائیں، تو تقسیم واقعی نارمل تقسیم کے زیادہ قریب ہو جاتی ہے۔
R
ggplot(rna, aes(x = expression_log)) + geom_histogram()
OUTPUT
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.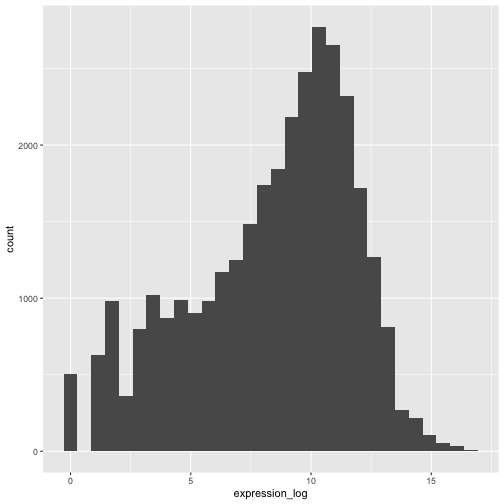
اب سے ہم اساس 2 کی لوگارتھمی تبدیلی شدہ اظہار کی اقدار پر کام کریں گے۔
چیلنج
اس تبدیلی کو بصری شکل میں پیش کرنے کا ایک اور طریقہ یہ ہے کہ مشاہدات کے پیمانے پر غور کیا جائے۔ مثال کے طور پر، پلوٹ کی جگہ میں مشاہدات کی بہتر تقسیم کے لیے محور کے پیمانے کو تبدیل کرنا فائدہ مند ہو سکتا ہے۔ محوروں کے پیمانے کو تبدیل کرنے کا طریقہ دیگر اجزاء کو شامل کرنے یا ترمیم کرنے کے مشابہ ہے (یعنی، کمانڈز کو بتدریج شامل کر کے)۔ اس ترمیم کو کرنے کی کوشش کریں:
- غیر تبدیل شدہ اظہار کو log10 سکیل پر ظاہر کریں؛
scale_x_log10()دیکھیں۔ اس کا موازنہ پچھلے گراف سے کریں۔ اب احتیاطی پیغامات کیوں ظاہر ہو رہے ہیں؟
R
ggplot(data = rna,mapping = aes(x = expression))+
geom_histogram() +
scale_x_log10()
WARNING
Warning in scale_x_log10(): log-10 transformation introduced infinite values.OUTPUT
`stat_bin()` using `bins = 30`. Pick better value `binwidth`.WARNING
Warning: Removed 507 rows containing non-finite outside the scale range
(`stat_bin()`).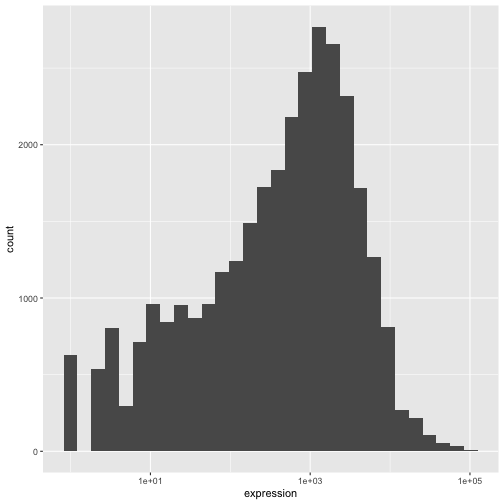
نوٹس
-
ggplot()فنکشن میں آپ جو کچھ بھی لکھتے ہیں، اسے آپ کے شامل کردہ کسی بھی geom لیئرز دیکھ سکتے ہیں (یعنی، یہ پلوٹ کی گلوبل سیٹنگز ہیں)۔ اس میں وہ x- اور y-ایکسیس میپنگ بھی شامل ہے جو آپ نےaes()میں سیٹ کی ہے۔ - آپ
ggplot()فنکشن میں عالمی طور پر متعین کردہ میپنگز سے آزادانہ طور پر کسی مخصوص geom کے لیے میپنگز بھی متعین کر سکتے ہیں۔ - نئی لیئرز شامل کرنے کے لیے استعمال ہونے والے
+علامت کو اس لائن کے آخر میں رکھنا ہوگا جس میں پچھلا لیئر موجود ہو۔ اگر اس کے بجائے،+علامت کو نئے لیئر والی لائن کے آغاز میں شامل کیا جائے، توggplot2نیا لیئر شامل نہیں کرے گا اور ایک ایرر میسج واپس کرے گا۔
R
# This is the correct syntax for adding layers
rna_plot +
geom_histogram()
# This will not add the new layer and will return an error message
rna_plot
+ geom_histogram()
اپنے پلوٹس کو تکراری طور پر تیار کرنا
اب ہم دو مسلسل متغیرات اور geom_point() فنکشن کا استعمال
کرتے ہوئے ایک اسکیٹر پلاٹ بنائیں گے۔ یہ گراف وقت 0 کے مقابلے میں وقت 8،
اور وقت 0 کے مقابلے میں وقت 4 پر اظہار کی log2 فولڈ چینجز کی نمائندگی
کرے گا۔ اس مقصد کے لیے، ہمیں پہلے ہر جین اور وقت کے لحاظ سے لوگارتھمی
تبدیلی شدہ اظہار کی اقدار کی اوسط کا حساب لگانا ہوگا۔ پھر وقت 8 کی اوسط
سے وقت 0 کی اوسط، اور وقت 4 کی اوسط سے وقت 0 کی اوسط منہا کر کے
لوگارتھمی فولڈ چینجز کا حساب لگائیں گے۔ نوٹ کریں کہ ہم یہاں جین
بائیوٹائپ بھی شامل کر رہے ہیں جسے ہم بعد میں جینز کی نمائندگی کے لیے
استعمال کریں گے۔ ہم فولڈ چینجز کو ایک نئے ڈیٹا فریم میں محفوظ کریں گے
جسے rna_fc. کہا جائے گا۔
R
rna_fc <- rna |> select(gene, time,
gene_biotype, expression_log) |>
group_by(gene, time, gene_biotype) |>
summarize(mean_exp = mean(expression_log)) |>
pivot_wider(names_from = time,
values_from = mean_exp) |>
mutate(time_8_vs_0 = `8` - `0`, time_4_vs_0 = `4` - `0`)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, time, and gene_biotype.
ℹ Output is grouped by gene and time.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time, gene_biotype))` for per-operation grouping
(`?dplyr::dplyr_by`) instead.اس کے بعد ہم نئے بنائے گئے ڈیٹا سیٹ rna_fc کے ساتھ ایک
ggplot تیار کر سکتے ہیں۔ ggplot2 کے ذریعے پلوٹس بنانا عام
طور پر ایک تکراری عمل ہوتا ہے۔ ہم اس ڈیٹا سیٹ کی تعریف کر کے آغاز کرتے
ہیں جسے ہم استعمال کریں گے، محوروں کی ترتیب کرتے ہیں، اور ایک geom کا
انتخاب کرتے ہیں:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
geom_point()
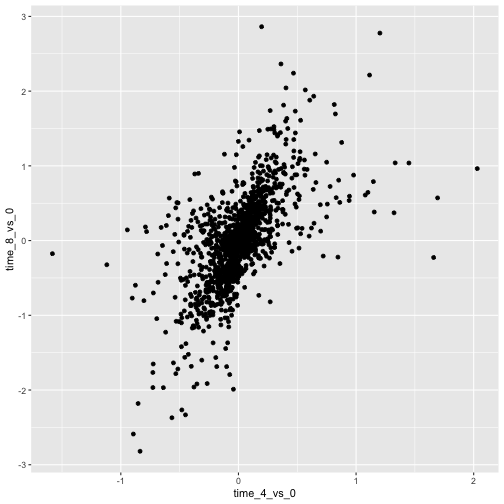
پھر، ہم اس پلاٹ میں ترمیم کرنا شروع کرتے ہیں تاکہ اس سے مزید معلومات
نکال سکیں۔ مثال کے طور پر، ہم اوور پلوٹنگ سے بچنے کے لیے شفافیت
(alpha) شامل کر سکتے ہیں:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
geom_point(alpha = 0.3)
ہم تمام پوائنٹس کے لیے رنگ بھی شامل کر سکتے ہیں:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
geom_point(alpha = 0.3, color = "blue")
یا پلاٹ میں ہر جین کو الگ الگ رنگ دینے کے لیے، آپ
color آرگومنٹ کے ان پٹ کے طور پر ایک ویکٹر استعمال کر
سکتے ہیں۔ ggplot2 ویکٹر کی مختلف اقدار کے مطابق مختلف رنگ
فراہم کرے گا۔ یہاں ایک مثال ہے جہاں ہم gene_biotype کے
ذریعے رنگ دیتے ہیں:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
geom_point(alpha = 0.3, aes(color = gene_biotype))
ہم ggplot() فنکشن میں فراہم کردہ میپنگ کے اندر براہِ راست
رنگ بھی متعین کر سکتے ہیں۔ یہ کسی بھی geom لیئرز کے لیے دیکھا جائے گا
اور میپنگ کا تعین aes() میں سیٹ کیے گئے x- اور y-ایکسز سے
ہوگا۔
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0,
color = gene_biotype)) +
geom_point(alpha = 0.3)
آخر میں، ہم geom_abline() فنکشن کے ذریعے ایک ترچھی لکیر
بھی شامل کر سکتے ہیں:
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0,
color = gene_biotype)) +
geom_point(alpha = 0.3) +
geom_abline(intercept = 0)
نوٹ کریں کہ ہم geom لیئر کو geom_point سے بدل کر
geom_jitter کر سکتے ہیں اور رنگ اب بھی
gene_biotype کے ذریعے طے ہوں گے۔
R
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0,
color = gene_biotype)) +
geom_jitter(alpha = 0.3) +
geom_abline(intercept = 0)
چیلنج
اسکیٹر پلوٹس (Scatter plots) چھوٹے ڈیٹا سیٹس کے لیے مفید ایکسپلوریٹری
ٹولز ہو سکتے ہیں۔ بڑی تعداد میں آبزرویشنز والے ڈیٹا سیٹس، جیسے کہ
rna_fc ڈیٹا سیٹ، میں پوائنٹس کی اوور پلوٹنگ (overplotting)
اسکیٹر پلوٹس کی ایک محدودیت ہو سکتی ہے۔ ایسی صورتحال سے نمٹنے کی ایک
حکمتِ عملی آبزرویشنز کی ہیکساگونل بننگ (hexagonal binning) کا استعمال
کرنا ہے۔ پلوٹ اسپیس کو ہیکساگونز میں تقسیم کیا جاتا ہے۔ ہر ہیکساگون کو
اس کی حدود کے اندر آنے والے آبزرویشنز کی تعداد کی بنیاد پر ایک رنگ تفویض
کیا جاتا ہے۔
ggplot2میں ہیکساگونل بننگ استعمال کرنے کے لیے، پہلے CRAN سے R پیکیجhexbinانسٹال کریں اور اسے لوڈ کریں۔پھر ہیکسبن (hexbin) تصویر تیار کرنے کے لیے
geom_hex()فنکشن کا استعمال کریں۔ایک اسکیٹر پلاٹ کے مقابلے میں ہیکساگونل بائن پلاٹ کی نسبتی خوبیاں اور خامیاں کیا ہیں؟ اوپر دیے گئے اسکیٹر پلاٹ کا جائزہ لیں اور اس کا موازنہ اس ہیکساگونل بائن پلاٹ سے کریں جو آپ نے تیار کیا ہے۔
R
install.packages("hexbin")
R
library("hexbin")
ggplot(data = rna_fc, mapping = aes(x = time_4_vs_0, y = time_8_vs_0)) +
geom_hex() +
geom_abline(intercept = 0)
چیلنج
ابھی سیکھی گئی باتوں کا استعمال کرتے ہوئے rna ڈیٹا سیٹ
سے expression_log کا sample پر ایک اسکیٹر پلاٹ
(scatter plot) بنائیں، جس میں وقت کو مختلف رنگوں میں دکھایا جائے۔ کیا اس
قسم کے ڈیٹا کو دکھانے کا یہ ایک اچھا طریقہ ہے؟
R
ggplot(data = rna, mapping = aes(y = expression_log, x = sample)) +
geom_point(aes(color = time))
باکس پلوٹ
ہم ہر نمونے میں جین کے اظہار کی تقسیم کو بصری شکل میں دیکھنے کے لیے باکس پلوٹس کا استعمال کر سکتے ہیں:
R
ggplot(data = rna,
mapping = aes(y = expression_log, x = sample)) +
geom_boxplot()
باکس پلوٹ میں پوائنٹس شامل کر کے، ہم پیمائشوں کی تعداد اور ان کی تقسیم کے بارے میں بہتر اندازہ لگا سکتے ہیں:
R
ggplot(data = rna,
mapping = aes(y = expression_log, x = sample)) +
geom_jitter(alpha = 0.2, color = "tomato") +
geom_boxplot(alpha = 0)
چیلنج
غور کریں کہ باکس پلاٹ (boxplot) لیئر جٹر (jitter) لیئر سے آگے کیوں ہے؟ باکس پلاٹ کو پوائنٹس کے نیچے رکھنے کے لیے آپ کو کوڈ میں کیا تبدیلی کرنے کی ضرورت ہے؟
ہمیں ان دو geoms کی ترتیب بدلنی چاہیے:
R
ggplot(data = rna,
mapping = aes(y = expression_log, x = sample)) +
geom_boxplot(alpha = 0) +
geom_jitter(alpha = 0.2, color = "tomato")
آپ نے غور کیا ہوگا کہ x-axis پر موجود اقدار اب بھی مناسب طریقے سے پڑھی نہیں جا رہیں۔ آئیے لیبلز کی سمت بدلیں اور انہیں عمودی اور افقی طور پر ایڈجسٹ کریں تاکہ وہ ایک دوسرے کے اوپر نہ آ جائیں۔ آپ 90 ڈگری کا زاویہ استعمال کر سکتے ہیں، یا ترچھی سمت میں موجود لیبلز کے لیے مناسب زاویہ تلاش کرنے کے لیے تجربات کر سکتے ہیں:
R
ggplot(data = rna,
mapping = aes(y = expression_log, x = sample)) +
geom_jitter(alpha = 0.2, color = "tomato") +
geom_boxplot(alpha = 0) +
theme(axis.text.x = element_text(angle = 90, hjust = 0.5, vjust = 0.5))
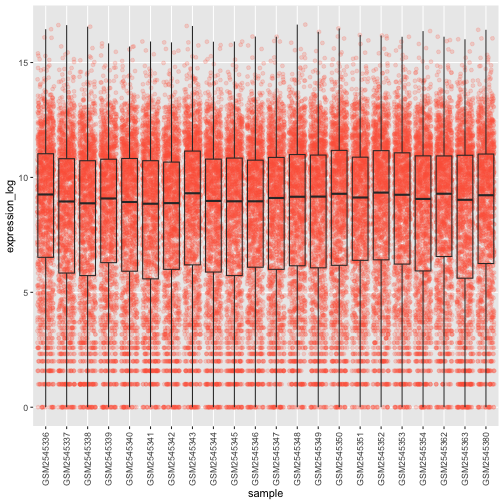
چیلنج
اپنے باکس پلوٹ پر ڈیٹا پوائنٹس کو انفیکشن کی مدت (time)
کے مطابق رنگ شامل کریں۔
اشارہ: time کی کلاس چیک کریں۔ ggplot میپنگ میں
براہِ راست time کی کلاس کو integer سے بدل کر factor کرنے پر
غور کریں۔ یہ تبدیلی R کے گراف بنانے کے طریقے کو کیوں بدل دیتی ہے؟
R
# time as integer
ggplot(data = rna,
mapping = aes(y = expression_log,
x = sample)) +
geom_jitter(alpha = 0.2, aes(color = time)) +
geom_boxplot(alpha = 0) +
theme(axis.text.x = element_text(angle = 90, hjust = 0.5, vjust = 0.5))
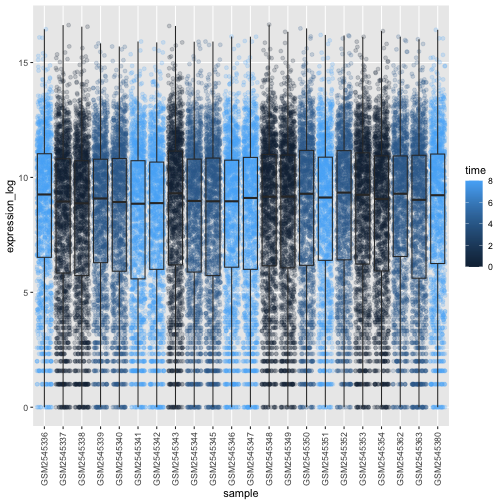
R
# time as factor
ggplot(data = rna,
mapping = aes(y = expression_log,
x = sample)) +
geom_jitter(alpha = 0.2, aes(color = as.factor(time))) +
geom_boxplot(alpha = 0) +
theme(axis.text.x = element_text(angle = 90, hjust = 0.5, vjust = 0.5))
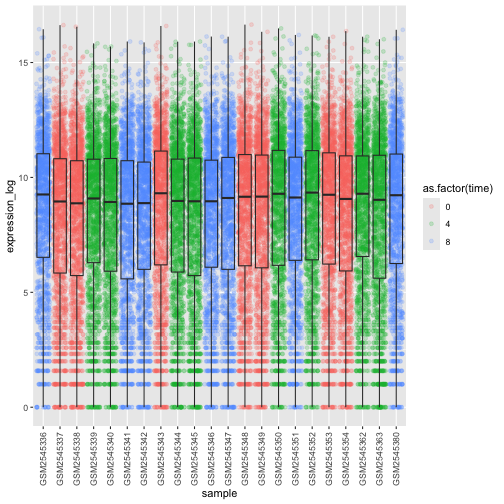
چیلنج
باکس پلوٹس (Boxplots) مفید خلاصے ہوتے ہیں، لیکن وہ تقسیم (distribution) کی شکل کو چھپا دیتے ہیں۔ مثال کے طور پر، اگر تقسیم بائی موڈل (bimodal) ہو، تو ہم اسے باکس پلوٹ میں نہیں دیکھ پائیں گے۔ باکس پلوٹ کا ایک متبادل وائلن پلوٹ (violin plot) ہے، جس میں شکل (پوائنٹس کی کثافت کی) کو دکھایا جاتا ہے۔
- باکس پلوٹ کو وائلن پلوٹ سے تبدیل کریں؛
geom_violin()دیکھیں۔ آرگیومنٹfillکے ذریعے وقت کے مطابق وائلنز کو بھریں۔
R
ggplot(data = rna,
mapping = aes(y = expression_log, x = sample)) +
geom_violin(aes(fill = as.factor(time))) +
theme(axis.text.x = element_text(angle = 90, hjust = 0.5, vjust = 0.5))
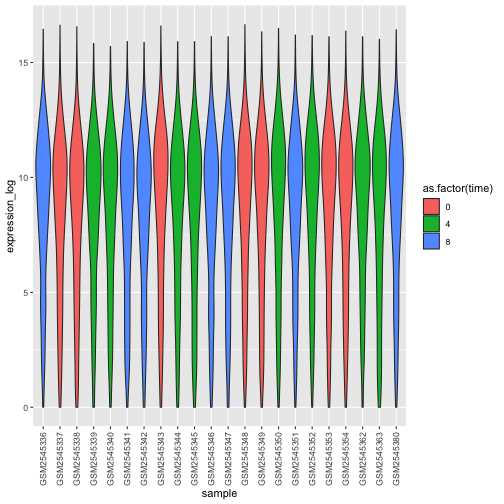
چیلنج
- وائلن پلاٹ کو اس طرح تبدیل کریں کہ
sexکے مطابق وائلنز بھر دیے جائیں۔
R
ggplot(data = rna,
mapping = aes(y = expression_log, x = sample)) +
geom_violin(aes(fill = sex)) +
theme(axis.text.x = element_text(angle = 90, hjust = 0.5, vjust = 0.5))
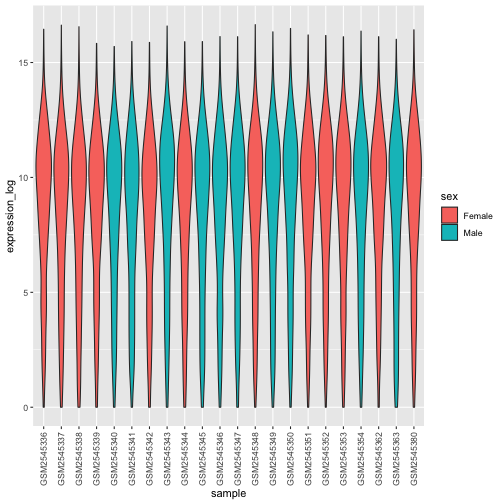
لائن پلوٹس
آئیے ٹائم 8 اور ٹائم 0 کے موازنے میں سب سے زیادہ لوگ فولڈ چینجز رکھنے
والے 10 جینز کے لیے انفیکشن کی مدت کے لحاظ سے اوسط اظہار کا حساب لگائیں۔
سب سے پہلے، ہمیں جینز کا انتخاب کرنا ہوگا اور rna کا ایک سب
سیٹ sub_rna بنانا ہوگا جس میں منتخب کردہ 10 جینز شامل ہوں،
پھر ہمیں ڈیٹا کو گروپ کرنا ہوگا اور ہر گروپ کے اندر جین کے اوسط اظہار کا
حساب لگانا ہوگا:
R
rna_fc <- rna_fc |> arrange(desc(time_8_vs_0))
genes_selected <- rna_fc$gene[1:10]
sub_rna <- rna |>
filter(gene %in% genes_selected)
mean_exp_by_time <- sub_rna |>
group_by(gene,time) |>
summarize(mean_exp = mean(expression_log))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
(`?dplyr::dplyr_by`) instead.R
mean_exp_by_time
OUTPUT
# A tibble: 30 × 3
# Groups: gene [10]
gene time mean_exp
<chr> <int> <dbl>
1 Acr 0 5.07
2 Acr 4 5.54
3 Acr 8 7.31
4 Aipl1 0 3.70
5 Aipl1 4 3.89
6 Aipl1 8 6.56
7 Bst1 0 3.20
8 Bst1 4 3.77
9 Bst1 8 5.22
10 Chil3 0 4.00
# ℹ 20 more rowsہم انفیکشن کی مدت کو x-axis پر اور اوسط اظہار کو y-axis پر رکھ کر لائن پلاٹ تیار کر سکتے ہیں:
R
ggplot(data = mean_exp_by_time, mapping = aes(x = time, y = mean_exp)) +
geom_line()
بدقسمتی سے، یہ کام نہیں کرتا کیونکہ ہم نے تمام جینز کے ڈیٹا کو ایک
ساتھ پلوٹ کیا ہے۔ ہمیں ggplot کو یہ بتانا ہوگا کہ وہ ہر جین کے لیے ایک
لائن کھینچے، جس کے لیے ہمیں ایسٹھیٹک فنکشن میں group = gene
شامل کر کے اسے تبدیل کرنا ہوگا:
R
ggplot(data = mean_exp_by_time,
mapping = aes(x = time, y = mean_exp, group = gene)) +
geom_line()
ہم پلاٹ میں جینز کے درمیان فرق کر سکیں گے اگر ہم رنگ شامل کریں
(color کا استعمال ڈیٹا کو خود بخود گروپ بھی کر دیتا
ہے):
R
ggplot(data = mean_exp_by_time,
mapping = aes(x = time, y = mean_exp, color = gene)) +
geom_line()
فیسیٹنگ
ggplot2 میں ایک خاص تکنیک ہے جسے faceting کہا
جاتا ہے، جو صارف کو ڈیٹا سیٹ میں شامل ایک فیکٹر کی بنیاد پر ایک پلاٹ کو
متعدد (ذیلی) پلاٹس میں تقسیم کرنے کی سہولت دیتی ہے۔ یہ مختلف ذیلی پلاٹس
ایک جیسی خصوصیات (ایکسز کی حدود، ٹکس، …) ورثے میں حاصل کرتے ہیں تاکہ ان
کا براہِ راست موازنہ آسان ہو سکے۔ ہم اسے ہر جین کے لیے وقت کے ساتھ ایک
لائن پلاٹ بنانے کے لیے استعمال کریں گے:
R
ggplot(data = mean_exp_by_time,
mapping = aes(x = time, y = mean_exp)) + geom_line() +
facet_wrap(~ gene)
یہاں تمام سب پلوٹس کے لیے x اور y دونوں محورات کا پیمانہ ایک جیسا ہے۔
آپ scales میں تبدیلی کر کے اس ڈیفالٹ رویے کو بدل سکتے ہیں
تاکہ y-محور کے لیے ایک آزاد پیمانہ کی اجازت مل سکے:
R
ggplot(data = mean_exp_by_time,
mapping = aes(x = time, y = mean_exp)) +
geom_line() +
facet_wrap(~ gene, scales = "free_y")
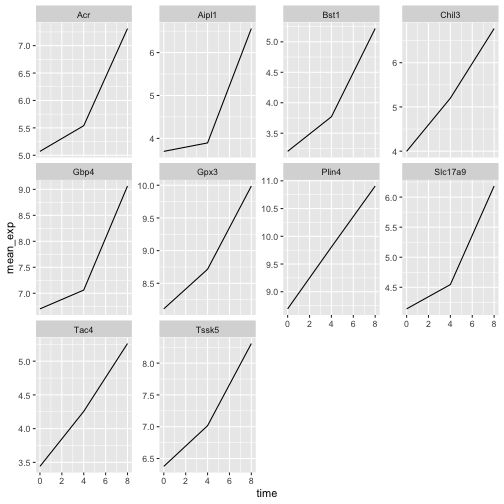
اب ہم ہر پلوٹ میں لائن کو چوہوں کی جنس کے لحاظ سے تقسیم کرنا چاہتے
ہیں۔ ایسا کرنے کے لیے ہمیں ڈیٹا فریم میں gene،
time، اور sex کے گروپس میں تقسیم کر کے اوسط
اظہار کا حساب لینا ہوگا:
R
mean_exp_by_time_sex <- sub_rna |>
group_by(gene, time, sex) |>
summarize(mean_exp = mean(expression_log))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, time, and sex.
ℹ Output is grouped by gene and time.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time, sex))` for per-operation grouping
(`?dplyr::dplyr_by`) instead.R
mean_exp_by_time_sex
OUTPUT
# A tibble: 60 × 4
# Groups: gene, time [30]
gene time sex mean_exp
<chr> <int> <chr> <dbl>
1 Acr 0 Female 5.13
2 Acr 0 Male 5.00
3 Acr 4 Female 5.93
4 Acr 4 Male 5.15
5 Acr 8 Female 7.27
6 Acr 8 Male 7.36
7 Aipl1 0 Female 3.67
8 Aipl1 0 Male 3.73
9 Aipl1 4 Female 4.07
10 Aipl1 4 Male 3.72
# ℹ 50 more rowsاب ہم color کا استعمال کرتے ہوئے مزید جنس کے لحاظ سے
تقسیم کر کے فیسیٹڈ پلاٹ تیار کر سکتے ہیں (ایک ہی پلاٹ کے اندر):
R
ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = sex)) +
geom_line() +
facet_wrap(~ gene, scales = "free_y")
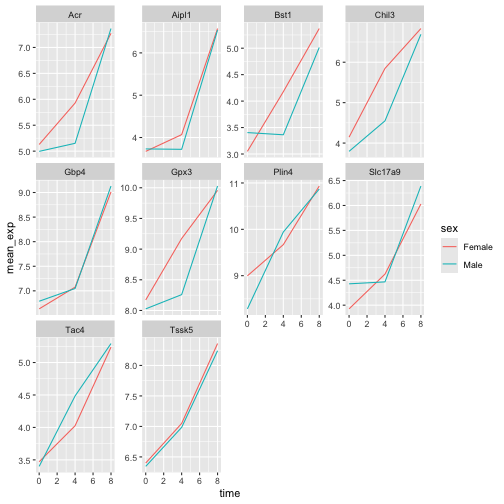
عام طور پر سفید پس منظر والے پلوٹس پرنٹ کرنے پر زیادہ واضح نظر آتے
ہیں۔ ہم فانکشن theme_bw() کا استعمال کرتے ہوئے پس منظر کو
سفید سیٹ کر سکتے ہیں۔ مزید برآں، ہم گرڈ کو ہٹا سکتے ہیں:
R
ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = sex)) +
geom_line() +
facet_wrap(~ gene, scales = "free_y") +
theme_bw() +
theme(panel.grid = element_blank())
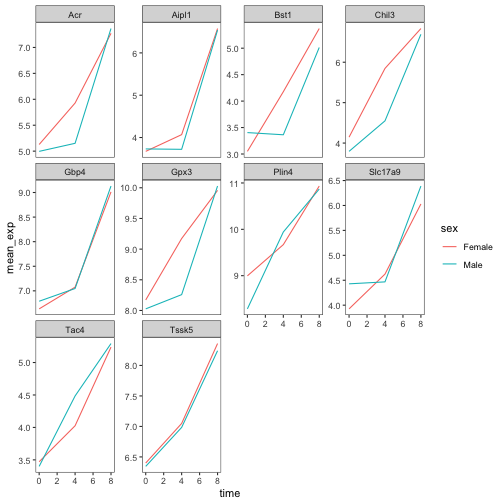
چیلنج
ابھی سیکھی گئی باتوں کا استعمال کرتے ہوئے ایک ایسا پلاٹ بنائیں جو یہ ظاہر کرے کہ انفیکشن کے دوران ہر کروموسوم کے اوسط اظہار میں کیسے تبدیلی آتی ہے۔
R
mean_exp_by_chromosome <- rna |>
group_by(chromosome_name, time) |>
summarize(mean_exp = mean(expression_log))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by chromosome_name and time.
ℹ Output is grouped by chromosome_name.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(chromosome_name, time))` for per-operation grouping
(`?dplyr::dplyr_by`) instead.R
ggplot(data = mean_exp_by_chromosome, mapping = aes(x = time,
y = mean_exp)) +
geom_line() +
facet_wrap(~ chromosome_name, scales = "free_y")
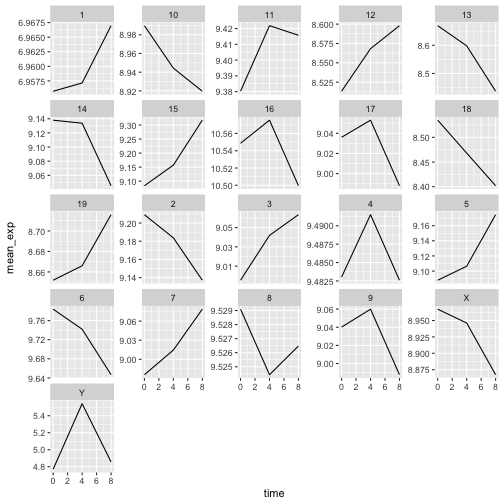
facet_wrap ذیلی پلوٹس کو صفحے پر مناسب ترتیب میں سمیٹتا
ہے تاکہ وہ ایک صفحے پر صاف ستھرا فٹ ہو سکیں۔ دوسری طرف،
facet_grid آپ کو فارمولا نوٹیشن
(rows ~ columns؛ ایک . کو پلیس ہولڈر کے طور پر
استعمال کیا جا سکتا ہے جو صرف ایک قطار یا کالم کی نشاندہی کرتا ہے) کے
ذریعے واضح طور پر متعین کرنے کی اجازت دیتا ہے کہ آپ اپنے پلوٹس کو کس طرح
ترتیب دینا چاہتے ہیں۔
آئیے پچھلے پلاٹ کو تبدیل کریں تاکہ یہ موازنہ کیا جا سکے کہ نر اور مادہ چوہوں میں جین کے اوسط اظہار میں وقت کے ساتھ کیسے تبدیلی آئی ہے:
R
# One column, facet by rows
ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = gene)) +
geom_line() +
facet_grid(sex ~ .)
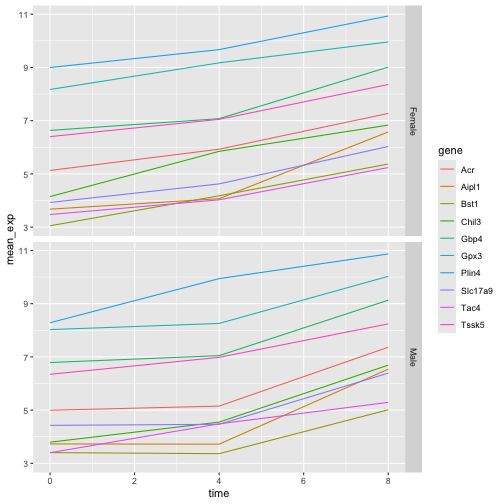
R
# One row, facet by column
ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = gene)) +
geom_line() +
facet_grid(. ~ sex)
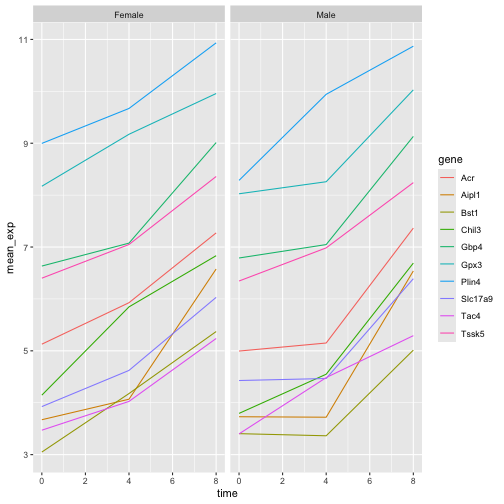
ggplot2 تھیمز
theme_bw() کے علاوہ، جو پلاٹ کے بیک گراؤنڈ کو سفید کر
دیتا ہے، ggplot2 کے ساتھ کئی دیگر تھیمز بھی آتے ہیں جو آپ
کی ویژولائزیشن کی شکل کو تیزی سے تبدیل کرنے میں مفید ثابت ہو سکتے ہیں۔
تھیمز کی مکمل فہرست https://ggplot2.tidyverse.org/reference/ggtheme.html
پر دستیاب ہے۔ theme_minimal() اور
theme_light() مقبول ہیں، اور theme_void() ایک
نیا ہاتھ سے تیار کردہ تھیم بنانے کے لیے ایک آغازی نقطہ کے طور پر مفید ہو
سکتا ہے۔
ggthemes
پیکیج اختیارات کی ایک وسیع رینج فراہم کرتا ہے (بشمول ایکسل 2003 تھیم)۔
ggplot2
ایکسٹینشنز کی ویب سائٹ ان پیکیجز کی فہرست فراہم کرتی ہے جو
ggplot2 کی صلاحیتوں کو وسعت دیتے ہیں، بشمول اضافی
تھیمز۔
کسٹمائزیشن
آئیے وقت اور جین کے لحاظ سے اوسط اظہار کے فیسیٹڈ پلاٹ پر واپس آتے ہیں، جسے جنس کے لحاظ سے رنگا گیا ہے۔
ggplot2
چیٹ شیٹ پر ایک نظر ڈالیں، اور ان طریقوں کے بارے میں سوچیں جن کے
ذریعے آپ پلاٹ کو بہتر بنا سکتے ہیں۔
اب، ہم محوروں کے ناموں کو ‘time’ اور ‘mean_exp’ کے بجائے زیادہ معلوماتی ناموں میں تبدیل کر سکتے ہیں، اور فیگر میں ایک عنوان شامل کر سکتے ہیں:
R
ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = sex)) +
geom_line() +
facet_wrap(~ gene, scales = "free_y") +
theme_bw() +
theme(panel.grid = element_blank()) +
labs(title = "Mean gene expression by duration of the infection",
x = "Duration of the infection (in days)",
y = "Mean gene expression")
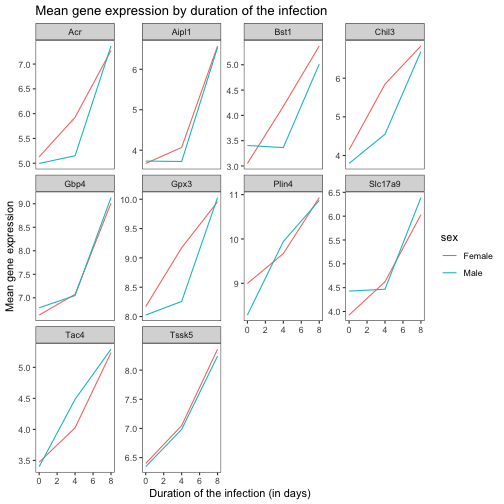
محوروں کے نام زیادہ معلوماتی ہیں، لیکن فونٹ کے سائز کو بڑھا کر ان کی پڑھنے کی صلاحیت کو مزید بہتر بنایا جا سکتا ہے:
R
ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = sex)) +
geom_line() +
facet_wrap(~ gene, scales = "free_y") +
theme_bw() +
theme(panel.grid = element_blank()) +
labs(title = "Mean gene expression by duration of the infection",
x = "Duration of the infection (in days)",
y = "Mean gene expression") +
theme(text = element_text(size = 16))
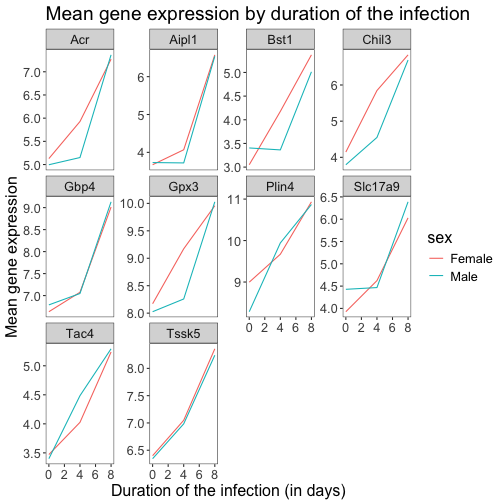
نوٹ کریں کہ آپ اپنے پلوٹس کے فونٹس کو بدلنا بھی ممکن ہے۔ اگر آپ ونڈوز
استعمال کر رہے ہیں، تو ہو سکتا ہے کہ آپ کو extrafont
پیکیج انسٹال کرنا پڑے۔
ہم x- اور y-ایکس کے ٹیکسٹ کے رنگ، گرڈ کے رنگ وغیرہ کو مزید کسٹمائز کر
سکتے ہیں۔ ہم مثال کے طور پر legend.position کو
"top" سیٹ کر کے لیجنڈ کو اوپر منتقل بھی کر سکتے ہیں۔
R
ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = sex)) +
geom_line() +
facet_wrap(~ gene, scales = "free_y") +
theme_bw() +
theme(panel.grid = element_blank()) +
labs(title = "Mean gene expression by duration of the infection",
x = "Duration of the infection (in days)",
y = "Mean gene expression") +
theme(text = element_text(size = 16),
axis.text.x = element_text(colour = "royalblue4", size = 12),
axis.text.y = element_text(colour = "royalblue4", size = 12),
panel.grid = element_line(colour="lightsteelblue1"),
legend.position = "top")
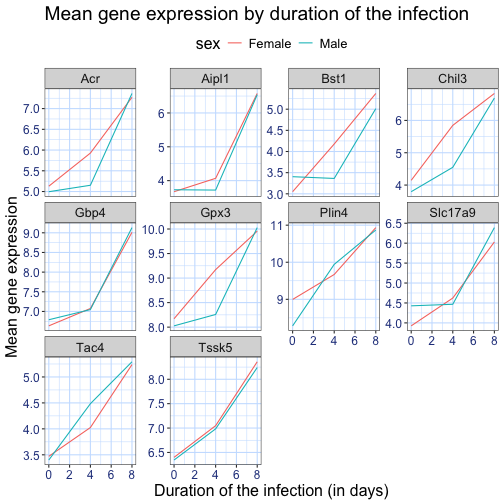
اگر آپ کو اپنی کی گئی تبدیلیاں ڈیفالٹ تھیم کے مقابلے میں زیادہ پسند آئیں، تو آپ انہیں ایک آبجیکٹ کے طور پر محفوظ کر سکتے ہیں تاکہ آپ انہیں دیگر پلوٹس پر آسانی سے لاگو کر سکیں جنہیں آپ بنا سکتے ہیں۔ یہاں ایک مثال ہے جس میں وہ ہسٹوگرام ہے جو ہم نے پہلے بنایا تھا۔
R
blue_theme <- theme(axis.text.x = element_text(colour = "royalblue4",
size = 12),
axis.text.y = element_text(colour = "royalblue4",
size = 12),
text = element_text(size = 16),
panel.grid = element_line(colour="lightsteelblue1"))
ggplot(rna, aes(x = expression_log)) +
geom_histogram(bins = 20) +
blue_theme
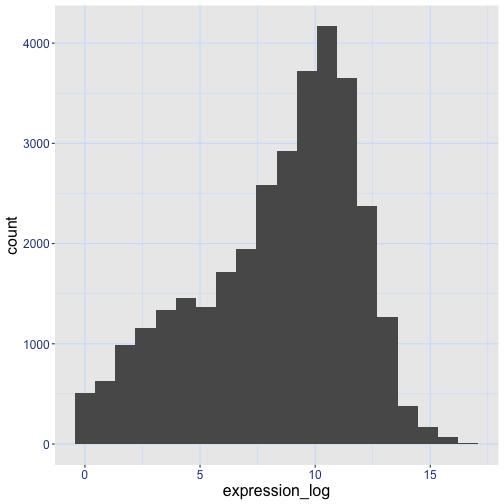
چیلنج
ان تمام معلومات کے حوالے سے، براہِ کرم مزید پانچ منٹ لیں تاکہ یا تو اس
مشق میں تیار کردہ پلوٹس میں سے کسی ایک کو بہتر بنا سکیں یا اپنا ایک
خوبصورت گراف تیار کر سکیں۔ تحریک کے لیے RStudio کے ggplot2
چیٹ شیٹ کا استعمال کریں۔ یہاں کچھ آئیڈیاز دیے گئے ہیں:
- دیکھیں کہ کیا آپ لائنوں کی موٹائی تبدیل کر سکتے ہیں۔
- کیا آپ لیجنڈ کا نام تبدیل کرنے کا کوئی طریقہ ڈھونڈ سکتے ہیں؟ اس کے
لیبلز کے بارے میں کیا؟ (اشارہ:
scale_سے شروع ہونے والے ggplot فنکشن کو تلاش کریں) - کسی مختلف کلر پیلیٹ کا استعمال کرنے یا لائنوں کے لیے رنگوں کو دستی طور پر متعین کرنے کی کوشش کریں (https://www.cookbook-r.com/Graphs/Colors_(ggplot2)/ دیکھیں)۔
مثال کے طور پر، اس پلوٹ کی بنیاد پر:
R
ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = sex)) +
geom_line() +
facet_wrap(~ gene, scales = "free_y") +
theme_bw() +
theme(panel.grid = element_blank())
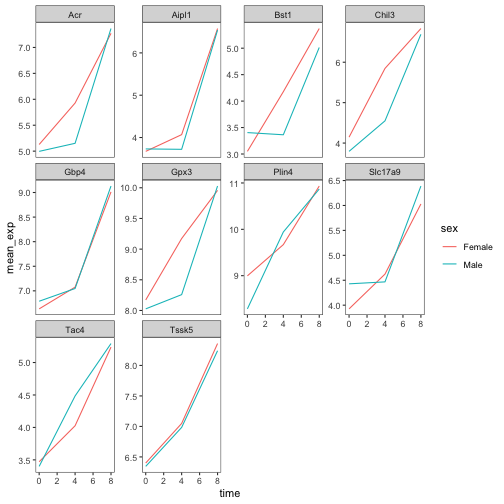
ہم اسے درج ذیل طریقوں سے کسٹمائز کر سکتے ہیں:
R
# change the thickness of the lines
ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = sex)) +
geom_line(size=1.5) +
facet_wrap(~ gene, scales = "free_y") +
theme_bw() +
theme(panel.grid = element_blank())
WARNING
Warning: Using `size` aesthetic for lines was deprecated in ggplot2 3.4.0.
ℹ Please use `linewidth` instead.
This warning is displayed once per session.
Call `lifecycle::last_lifecycle_warnings()` to see where this warning was
generated.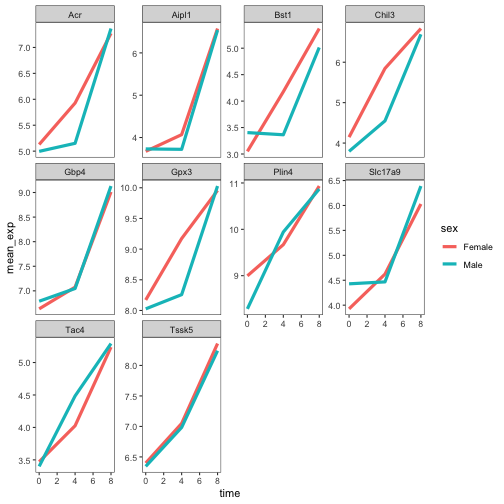
R
# change the name of the legend and the labels
ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = sex)) +
geom_line() +
facet_wrap(~ gene, scales = "free_y") +
theme_bw() +
theme(panel.grid = element_blank()) +
scale_color_discrete(name = "Gender", labels = c("F", "M"))
R
# using a different color palette
ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = sex)) +
geom_line() +
facet_wrap(~ gene, scales = "free_y") +
theme_bw() +
theme(panel.grid = element_blank()) +
scale_color_brewer(name = "Gender", labels = c("F", "M"), palette = "Dark2")
R
# manually specifying the colors
ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = sex)) +
geom_line() +
facet_wrap(~ gene, scales = "free_y") +
theme_bw() +
theme(panel.grid = element_blank()) +
scale_color_manual(name = "Gender", labels = c("F", "M"),
values = c("royalblue", "deeppink"))
پلوٹس کی تشکیل
فیسیٹنگ ایک پلوٹ کو متعدد سب پلوٹس میں تقسیم کرنے کے لیے ایک بہترین ٹول ہے، لیکن کبھی کبھی آپ ایک ایسا واحد فیگر تیار کرنا چاہیں گے جس میں متعدد آزاد پلوٹس شامل ہوں، یعنی ایسے پلوٹس جو مختلف متغیرات یا یہاں تک کہ مختلف ڈیٹا فریمز پر مبنی ہوں۔
آئیے ان دو پلوٹس کو بنانے سے آغاز کرتے ہیں جنہیں ہم ایک دوسرے کے ساتھ ترتیب دینا چاہتے ہیں:
پہلا گراف ہر کروموسوم کے لیے منفرد جینز کی تعداد گنتا ہے۔ ہمیں پہلے
chromosome_name کی لیولز کی ترتیب تبدیل کرنی ہوگی اور ہر
کروموسوم کے لیے منفرد جینز کو فلٹر کرنا ہوگا۔ ہم یہاں تک کہ کہتے ہیں کہ
بہتر پڑھنے کی سہولت کے لیے y-axis کا پیمانہ log10 پیمانے میں تبدیل کر
دیتے ہیں۔
R
rna$chromosome_name <- factor(rna$chromosome_name,
levels = c(1:19,"X","Y"))
count_gene_chromosome <- rna |>
select(chromosome_name, gene) |>
distinct() |> ggplot() +
geom_bar(aes(x = chromosome_name), fill = "seagreen",
position = "dodge", stat = "count") +
labs(y = "log10(n genes)", x = "chromosome") +
scale_y_log10()
count_gene_chromosome
نیچے، ہم legend.position کو "none" سیٹ کر
کے لیجنڈ کو مکمل طور پر ہٹا دیتے ہیں۔
R
exp_boxplot_sex <- ggplot(rna, aes(y=expression_log, x = as.factor(time),
color=sex)) +
geom_boxplot(alpha = 0) +
labs(y = "Mean gene exp",
x = "time") + theme(legend.position = "none")
exp_boxplot_sex
patchwork
پیکیج فیگرز کو ترتیب دینے کے لیے + کا استعمال کرتے ہوئے
انہیں یکجا کرنے کا ایک بہترین طریقہ فراہم کرتا ہے (عام طور پر ایک دوسرے
کے برابر)۔ مزید واضح طور پر، | انہیں واضح طور پر ایک دوسرے
کے برابر ترتیب دیتا ہے اور / انہیں ایک دوسرے کے اوپر ایک
دوسرے کے ساتھ رکھتا ہے۔
R
install.packages("patchwork")
R
library("patchwork")
count_gene_chromosome + exp_boxplot_sex
R
## or count_gene_chromosome | exp_boxplot_sex
R
count_gene_chromosome / exp_boxplot_sex
ہم plot_layout کے ذریعے حتمی ترتیب کے لے آؤٹ پر مزید
کنٹرول کر کے مزید پیچیدہ لے آؤٹس تیار کر سکتے ہیں:
R
count_gene_chromosome + exp_boxplot_sex + plot_layout(ncol = 1)
R
count_gene_chromosome +
(count_gene_chromosome + exp_boxplot_sex) +
exp_boxplot_sex +
plot_layout(ncol = 1)
آخری پلوٹ کو | اور / کمپوزرز کا استعمال
کرتے ہوئے بھی بنایا جا سکتا ہے:
R
count_gene_chromosome /
(count_gene_chromosome | exp_boxplot_sex) /
exp_boxplot_sex
patchwork کے بارے میں مزید معلومات اس کے ویب پیج یا اس ویڈیو سے حاصل
کریں۔
ایک اور آپشن gridExtra پیکیج ہے جو
grid.arrange() کا استعمال کرتے ہوئے الگ الگ ggplots کو ایک
ہی فیگر میں یکجا کرنے کی سہولت فراہم کرتا ہے:
R
install.packages("gridExtra")
R
library("gridExtra")
grid.arrange(count_gene_chromosome, exp_boxplot_sex, ncol = 2)
سادہ ترتیبات بنانے کے لیے استعمال ہونے والے ncol اور
nrow آرگومنٹس کے علاوہ، زیادہ
پیچیدہ لے آؤٹس تیار کرنے کے لیے ٹولز بھی موجود ہیں۔
پلوٹس کی ایکسپورٹنگ
اپنا پلوٹ بنانے کے بعد، آپ اسے اپنی پسند کے فارمیٹ میں ایک فائل میں محفوظ کر سکتے ہیں۔ RStudio کے Plot پین میں موجود Export ٹیب آپ کے پلوٹس کو کم ریزولوشن میں محفوظ کرے گا، جو بہت سے جرنلز کی جانب سے قبول نہیں کیا جائے گا اور پوسٹرز کے لیے مناسب طریقے سے اسکیل نہیں ہو پائے گا۔
اس کے بجائے، ggsave() فنکشن استعمال کریں، جو آپ کو مناسب
آرگومنٹس (width، height اور dpi)
کو ایڈجسٹ کر کے اپنے پلوٹ کے ڈائمنشن اور ریزولوشن کو آسانی سے تبدیل کرنے
کی سہولت فراہم کرتا ہے۔
اس بات کو یقینی بنائیں کہ آپ کی ورکنگ ڈائریکٹری میں
fig_output/ فولڈر موجود ہے۔
R
my_plot <- ggplot(data = mean_exp_by_time_sex,
mapping = aes(x = time, y = mean_exp, color = sex)) +
geom_line() +
facet_wrap(~ gene, scales = "free_y") +
labs(title = "Mean gene expression by duration of the infection",
x = "Duration of the infection (in days)",
y = "Mean gene expression") +
guides(color=guide_legend(title="Gender")) +
theme_bw() +
theme(axis.text.x = element_text(colour = "royalblue4", size = 12),
axis.text.y = element_text(colour = "royalblue4", size = 12),
text = element_text(size = 16),
panel.grid = element_line(colour="lightsteelblue1"),
legend.position = "top")
ggsave("fig_output/mean_exp_by_time_sex.png", my_plot, width = 15,
height = 10)
# This also works for grid.arrange() plots
combo_plot <- grid.arrange(count_gene_chromosome, exp_boxplot_sex,
ncol = 2, widths = c(4, 6))
ggsave("fig_output/combo_plot_chromosome_sex.png", combo_plot,
width = 10, dpi = 300)
نوٹ: پیرامیٹرز width اور height محفوظ کردہ
پلوٹ میں فونٹ کے سائز کا تعین بھی کرتے ہیں۔
ویژولائزیشن کے لیے دیگر پیکیجز
ggplot2 ایک انتہائی طاقتور پیکیج ہے جو ہمارے منظم
ڈیٹا اور منظم ٹولز پائپ لائن میں بہت اچھی طرح فٹ بیٹھتا
ہے۔ R میں ویژولائزیشن کے دیگر پیکیجز بھی ہیں جنہیں نظر انداز نہیں کیا
جانا چاہیے۔
بیس گرافکس
R کے ساتھ آنے والا ڈیفالٹ گرافکس سسٹم، جسے اکثر base R
graphics کہا جاتا ہے، سادہ اور تیز ہے۔ یہ پینٹر یا کینوس
ماڈل پر مبنی ہے، جہاں مختلف آؤٹ پٹس براہِ راست ایک دوسرے کے اوپر
رکھے جاتے ہیں (شکل ذیل میں دیکھیں)۔ یہ
ggplot2 (اور نیچے بیان کیے گئے lattice) کے
ساتھ ایک بنیادی فرق ہے، جو مخصوص آبجیکٹس واپس کرتا ہے، جنہیں اسکرین پر
یا فائل میں رینڈر کیا جاتا ہے، اور انہیں یہاں تک کہ اپ ڈیٹ بھی کیا جا
سکتا ہے۔
R
par(mfrow = c(1, 3))
plot(1:20, main = "First layer, produced with plot(1:20)")
plot(1:20, main = "A horizontal red line, added with abline(h = 10)")
abline(h = 10, col = "red")
plot(1:20, main = "A rectangle, added with rect(5, 5, 15, 15)")
abline(h = 10, col = "red")
rect(5, 5, 15, 15, lwd = 3)
ایک اور بنیادی فرق یہ ہے کہ بیس گرافکس کا پلوٹنگ فنکشن ان کے ان پٹ کی
قسم کی بنیاد پر درست کام کرنے کی کوشش کرتا ہے، یعنی یہ اپنے ان
پٹ کی کلاس کے مطابق اپنے رویے کو ڈھال لیتا ہے۔ یہ ایک بار پھر اس سے بہت
مختلف ہے جو ہمارے پاس ggplot2 میں ہے، جو صرف ڈیٹا فریمز کو
ان پٹ کے طور پر قبول کرتا ہے، اور جس میں پلوٹس کو مرحلہ وار، ایک ایک جزو
شامل کر کے، تیار کرنا ہوتا ہے۔
R
par(mfrow = c(2, 2))
boxplot(rnorm(100),
main = "Boxplot of rnorm(100)")
boxplot(matrix(rnorm(100), ncol = 10),
main = "Boxplot of matrix(rnorm(100), ncol = 10)")
hist(rnorm(100))
hist(matrix(rnorm(100), ncol = 10))
بیس گرافکس (base graphics) میں ڈیفالٹ طریقہ کار سادہ اور معیاری فیگرز
کے لیے بہت مؤثر ہو سکتا ہے، جنہیں کوڈ کی ایک سینگل لائن اور ایک ہی فنکشن
جیسے کہ plot، یا hist، یا
boxplot، … کے ذریعے بہت جلد تیار کیا جا سکتا ہے۔ تاہم،
ڈیفالٹ سیٹنگز ہمیشہ سب سے زیادہ پرکشش نہیں ہوتیں اور فیگرز کی ٹیوننگ،
خاص طور پر جب وہ زیادہ پیچیدہ ہو جائیں (مثال کے طور پر فیسیٹس (facets)
تیار کرنے کے لیے)، طویل اور پیچیدہ ہو سکتی ہے۔
لیٹیس (lattice) پیکیج
lattice پیکیج ggplot2 کے
مشابہ ہے کیونکہ یہ ان پٹ کے طور پر ڈیٹا فریمز استعمال کرتا ہے، گرافیکل
آبجیکٹس واپس کرتا ہے اور فیسیٹنگ کو سپورٹ کرتا ہے۔ تاہم،
lattice گرافکس کے گرامر پر مبنی نہیں ہے اور اس کا انٹرفیس
زیادہ پیچیدہ ہے۔
lattice پیکیج کے لیے ایک اچھا حوالہ Deepayan (2008). ہے۔
- R میں بصری نمائش
ذریعہ: Data Visualization Cheat Sheet۔↩︎
Content from اگلے اقدامات
Last updated on 2026-11-11 | Edit this page
Overview
Questions
-
SummarizedExperimentکیا ہے؟ - Bioconductor کیا ہے؟
Objectives
- Bioconductor پروجیکٹ کا تعارف کرائیں۔
- ڈیٹا کنٹینرز کے تصور کا تعارف کرائیں۔
-
SummarizedExperimentکا ایک جائزہ پیش کریں، جسے اومکس تجزیوں میں بڑے پیمانے پر استعمال کیا جاتا ہے۔
اگلے اقدامات
بائیو انفارمیٹکس میں ڈیٹا اکثر پیچیدہ ہوتا ہے۔ اس سے نمٹنے کے لیے، ڈویلپرز مخصوص ڈیٹا کنٹینرز (جنہیں کلاسز کہا جاتا ہے) تعریف کرتے ہیں جو ان ڈیٹا کی خصوصیات کے مطابق ہوں جنہیں انہیں ہینڈل کرنے کی ضرورت ہوتی ہے۔
یہ پہلو Bioconductor1 پروجیکٹ کے لیے مرکزی ہے، جو تمام پیکجز میں ایک ہی کور ڈیٹا انفراسٹرکچر کا استعمال کرتا ہے۔ اس نے یقیناً Bioconductor کی کامیابی میں اہم کردار ادا کیا ہے۔ Bioconductor پیکج ڈویلپرز کو مشورہ دیا جاتا ہے کہ وہ پورے پروجیکٹ میں ہم آہنگی، باہمی طور پر کام کرنے کی صلاحیت اور استحکام فراہم کرنے کے لیے موجودہ انفراسٹرکچر کا استعمال کریں۔
ایسے اومکس ڈیٹا کنٹینر کی وضاحت کے لیے، ہم
SummarizedExperiment کلاس پیش کریں گے۔
SummarizedExperiment
نیچے دیا گیا شکل SummarizedExperiment کلاس کی ساخت کی نمائندگی کرتا ہے۔

SummarizedExperiment کلاس کے آبجیکٹس میں شامل ہیں:
ایک (یا ایک سے زیادہ) ایسے (assay) جن میں مقداری اومکس ڈیٹا (اظہار کا ڈیٹا) شامل ہوتا ہے، جو ایک میٹرکس نما آبجیکٹ کے طور پر محفوظ کیا گیا ہوتا ہے۔ فیچرز (جینز، ٹرانسکرپٹس، پروٹینز، …) قطاروں کے ساتھ، اور نمونے کالموں کے ساتھ متعین کیے گئے ہیں۔
ایک سیمپل میٹا ڈیٹا سلاٹ جس میں سیمپل کے کو-ویری ایٹس شامل ہیں، اور اسے ایک ڈیٹا فریم کے طور پر محفوظ کیا گیا ہے۔ اس ٹیبل کی قطاریں سیمپلز کی نمائندگی کرتی ہیں (قطاریں اظہار کے ڈیٹا کے کالموں سے بالکل مطابقت رکھتی ہیں)۔
ایک فیچر میٹا ڈیٹا سلاٹ جس میں فیچر کے کو-ویری ایٹس شامل ہیں، اور جو ایک ڈیٹا فریم کے طور پر محفوظ کیا گیا ہے۔ اس ڈیٹا فریم کی قطاریں بالکل اظہار کے ڈیٹا کی قطاروں سے مطابقت رکھتی ہیں۔
SummarizedExperiment کی ہم آہنگ نوعیت اس بات کی ضمانت
دیتی ہے کہ ڈیٹا کی ترتیب و تیاری کے دوران، مختلف سلاٹس کے ابعاد ہمیشہ
میل کھائیں گے (یعنی اظہار کے ڈیٹا میں کالم اور پھر سیمپل میٹا ڈیٹا میں
قطاریں، نیز اظہار کے ڈیٹا اور فیچر میٹا ڈیٹا میں قطاریں)۔ مثال کے طور
پر، اگر ہمیں ایسے کے سے ایک سیمپل کو خارج کرنا پڑے، تو وہ اسی آپریشن میں
سیمپل میٹا ڈیٹا سے خود بخود حذف ہو جائے گا۔
میٹا ڈیٹا سلاٹس میں دیگر ساختوں کو متاثر کیے بغیر اضافی کو-ویری ایٹس (کالمز) شامل کیے جا سکتے ہیں۔
SummarizedExperiment کی تخلیق
SummarizedExperiment بنانے کے لیے، ہم انفرادی اجزاء،
یعنی کاؤنٹ میٹرکس، سیمپل اور جین میٹا ڈیٹا کو CSV فائلوں سے تیار کریں
گے۔ عام طور پر RNA-Seq ڈیٹا اسی طرح فراہم کیا جاتا ہے (کچی ڈیٹا کی
پروسیسنگ کے بعد)۔
-
ایک ایکسپریشن میٹرکس: ہم کاؤنٹ میٹرکس لوڈ کرتے ہیں،
یہ واضح کرتے ہیں کہ پہلے کالم میں قطاروں/جینز کے نام شامل ہیں، اور
data.frameکوmatrixمیں تبدیل کرتے ہیں۔ آپ اسے اس لنک پر کلک کر کے ڈاؤن لوڈ کر سکتے ہیں۔
R
count_matrix <- read.csv("data/count_matrix.csv",
row.names = 1) |>
as.matrix()
count_matrix[1:5, ]
OUTPUT
GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
Asl 1170 361 400 586 626 988
Apod 36194 10347 9173 10620 13021 29594
Cyp2d22 4060 1616 1603 1901 2171 3349
Klk6 287 629 641 578 448 195
Fcrls 85 233 244 237 180 38
GSM2545342 GSM2545343 GSM2545344 GSM2545345 GSM2545346 GSM2545347
Asl 836 535 586 597 938 1035
Apod 24959 13668 13230 15868 27769 34301
Cyp2d22 3122 2008 2254 2277 2985 3452
Klk6 186 1101 537 567 327 233
Fcrls 68 375 199 177 89 67
GSM2545348 GSM2545349 GSM2545350 GSM2545351 GSM2545352 GSM2545353
Asl 494 481 666 937 803 541
Apod 11258 11812 15816 29242 20415 13682
Cyp2d22 1883 2014 2417 3678 2920 2216
Klk6 742 881 828 250 798 710
Fcrls 300 233 231 81 303 285
GSM2545354 GSM2545362 GSM2545363 GSM2545380
Asl 473 748 576 1192
Apod 11088 15916 11166 38148
Cyp2d22 1821 2842 2011 4019
Klk6 894 501 598 259
Fcrls 248 179 184 68R
dim(count_matrix)
OUTPUT
[1] 1474 22- نمونوں کی وضاحت کرنے والا ایک ٹیبل، جو اس لنک پر دستیاب ہے۔
R
sample_metadata <- read.csv("data/sample_metadata.csv")
sample_metadata
OUTPUT
sample organism age sex infection strain time tissue mouse
1 GSM2545336 Mus musculus 8 Female InfluenzaA C57BL/6 8 Cerebellum 14
2 GSM2545337 Mus musculus 8 Female NonInfected C57BL/6 0 Cerebellum 9
3 GSM2545338 Mus musculus 8 Female NonInfected C57BL/6 0 Cerebellum 10
4 GSM2545339 Mus musculus 8 Female InfluenzaA C57BL/6 4 Cerebellum 15
5 GSM2545340 Mus musculus 8 Male InfluenzaA C57BL/6 4 Cerebellum 18
6 GSM2545341 Mus musculus 8 Male InfluenzaA C57BL/6 8 Cerebellum 6
7 GSM2545342 Mus musculus 8 Female InfluenzaA C57BL/6 8 Cerebellum 5
8 GSM2545343 Mus musculus 8 Male NonInfected C57BL/6 0 Cerebellum 11
9 GSM2545344 Mus musculus 8 Female InfluenzaA C57BL/6 4 Cerebellum 22
10 GSM2545345 Mus musculus 8 Male InfluenzaA C57BL/6 4 Cerebellum 13
11 GSM2545346 Mus musculus 8 Male InfluenzaA C57BL/6 8 Cerebellum 23
12 GSM2545347 Mus musculus 8 Male InfluenzaA C57BL/6 8 Cerebellum 24
13 GSM2545348 Mus musculus 8 Female NonInfected C57BL/6 0 Cerebellum 8
14 GSM2545349 Mus musculus 8 Male NonInfected C57BL/6 0 Cerebellum 7
15 GSM2545350 Mus musculus 8 Male InfluenzaA C57BL/6 4 Cerebellum 1
16 GSM2545351 Mus musculus 8 Female InfluenzaA C57BL/6 8 Cerebellum 16
17 GSM2545352 Mus musculus 8 Female InfluenzaA C57BL/6 4 Cerebellum 21
18 GSM2545353 Mus musculus 8 Female NonInfected C57BL/6 0 Cerebellum 4
19 GSM2545354 Mus musculus 8 Male NonInfected C57BL/6 0 Cerebellum 2
20 GSM2545362 Mus musculus 8 Female InfluenzaA C57BL/6 4 Cerebellum 20
21 GSM2545363 Mus musculus 8 Male InfluenzaA C57BL/6 4 Cerebellum 12
22 GSM2545380 Mus musculus 8 Female InfluenzaA C57BL/6 8 Cerebellum 19R
dim(sample_metadata)
OUTPUT
[1] 22 9- جینز کی وضاحت کرنے والی ایک ٹیبل، جو اس لنک پر دستیاب ہے۔
R
gene_metadata <- read.csv("data/gene_metadata.csv")
gene_metadata[1:10, 1:4]
OUTPUT
gene ENTREZID
1 Asl 109900
2 Apod 11815
3 Cyp2d22 56448
4 Klk6 19144
5 Fcrls 80891
6 Slc2a4 20528
7 Exd2 97827
8 Gjc2 118454
9 Plp1 18823
10 Gnb4 14696
product
1 argininosuccinate lyase, transcript variant X1
2 apolipoprotein D, transcript variant 3
3 cytochrome P450, family 2, subfamily d, polypeptide 22, transcript variant 2
4 kallikrein related-peptidase 6, transcript variant 2
5 Fc receptor-like S, scavenger receptor, transcript variant X1
6 solute carrier family 2 (facilitated glucose transporter), member 4
7 exonuclease 3'-5' domain containing 2
8 gap junction protein, gamma 2, transcript variant 1
9 proteolipid protein (myelin) 1, transcript variant 1
10 guanine nucleotide binding protein (G protein), beta 4, transcript variant X2
ensembl_gene_id
1 ENSMUSG00000025533
2 ENSMUSG00000022548
3 ENSMUSG00000061740
4 ENSMUSG00000050063
5 ENSMUSG00000015852
6 ENSMUSG00000018566
7 ENSMUSG00000032705
8 ENSMUSG00000043448
9 ENSMUSG00000031425
10 ENSMUSG00000027669R
dim(gene_metadata)
OUTPUT
[1] 1474 9ہم ان ٹیبلز سے ایک SummarizedExperiment تیار کریں
گے:
کاؤنٹ میٹرکس جو
assayکے طور پر استعمال کیا جائے گانمونوں کی وضاحت کرنے والی ٹیبل کو sample metadata اسلوٹ کے طور پر استعمال کیا جائے گا۔
جینز کی وضاحت کرنے والی ٹیبل کو features metadata اسلوٹ کے طور پر استعمال کیا جائے گا۔
اس کے لیے ہم SummarizedExperiment کنسٹرکٹر کا استعمال
کرتے ہوئے مختلف حصوں کو یکجا کر سکتے ہیں:
R
## BiocManager::install("SummarizedExperiment")
library("SummarizedExperiment")
پہلے، ہم اس بات کو یقینی بناتے ہیں کہ کاؤنٹ میٹرکس اور سیمپل اینوٹیشن میں نمونے ایک ہی ترتیب میں ہوں، اور کاؤنٹ میٹرکس اور جین اینوٹیشن میں جینز کے لیے بھی یہی ترتیب ہو۔
R
stopifnot(rownames(count_matrix) == gene_metadata$gene)
stopifnot(colnames(count_matrix) == sample_metadata$sample)
R
se <- SummarizedExperiment(assays = list(counts = count_matrix),
colData = sample_metadata,
rowData = gene_metadata)
se
OUTPUT
class: SummarizedExperiment
dim: 1474 22
metadata(0):
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(9): sample organism ... tissue mouseڈیٹا کو محفوظ کرنا
ڈیٹا کو اسپریڈشیٹ میں ایکسپورٹ کرنے میں، جیسا کہ ہم نے ایک پچھلے
ایپیسوڈ میں کیا تھا، کئی حدود ہیں، جیسے کہ پہلے باب میں بیان کی گئی ہیں
(اعشاریہ کے علامت کے طور پر , اور . کے ساتھ
ممکنہ تضادات اور متغیرات کی اقسام کی تعریفوں کی کمی)۔ مزید برآں، ڈیٹا کو
اسپریڈشیٹ میں ایکسپورٹ کرنا صرف مستطیل ڈیٹا، جیسے کہ ڈیٹا فریمز اور
میٹرکسز کے لیے موزوں ہے۔
ڈیٹا محفوظ کرنے کا ایک زیادہ عمومی طریقہ، جو خاص طور پر R کے لیے ہے
اور کسی بھی آپریٹنگ سسٹم پر کام کرنے کی ضمانت دیتا ہے،
saveRDS فنکشن کا استعمال کرنا ہے۔ اس طرح کے آبجیکٹس کو
محفوظ کرنے سے ڈسک پر ایک بائنری نمائندگی (یہاں rds فائل
ایکسٹینشن کا استعمال کرتے ہوئے) تیار ہو جائے گی، جسے
readRDS فنکشن کے ذریعے دوبارہ R میں لوڈ کیا جا سکتا ہے۔
R
saveRDS(se, file = "data_output/se.rds")
rm(se)
se <- readRDS("data_output/se.rds")
head(se)
مختصر یہ کہ، جب بات R سے ڈیٹا محفوظ کرنے اور اسے دوبارہ R میں لوڈ
کرنے کی آتی ہے، تو saveRDS اور readRDS کے
ذریعے محفوظ کرنا اور لوڈ کرنا پسندیدہ طریقہ کار ہے۔ اگر ٹیبل ڈیٹا کو کسی
ایسے شخص کے ساتھ شیئر کرنے کی ضرورت ہو جو R استعمال نہیں کر رہا، تو
ٹیکسٹ پر مبنی اسپریڈشیٹ میں ایکسپورٹ کرنا ایک اچھا متبادل ہے۔
اس ڈیٹا اسٹرکچر کا استعمال کرتے ہوئے، ہم assay فنکشن کے
ذریعے ایکسپریشن میٹرکس تک رسائی حاصل کر سکتے ہیں:
R
head(assay(se))
OUTPUT
GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
Asl 1170 361 400 586 626 988
Apod 36194 10347 9173 10620 13021 29594
Cyp2d22 4060 1616 1603 1901 2171 3349
Klk6 287 629 641 578 448 195
Fcrls 85 233 244 237 180 38
Slc2a4 782 231 248 265 313 786
GSM2545342 GSM2545343 GSM2545344 GSM2545345 GSM2545346 GSM2545347
Asl 836 535 586 597 938 1035
Apod 24959 13668 13230 15868 27769 34301
Cyp2d22 3122 2008 2254 2277 2985 3452
Klk6 186 1101 537 567 327 233
Fcrls 68 375 199 177 89 67
Slc2a4 528 249 266 357 654 693
GSM2545348 GSM2545349 GSM2545350 GSM2545351 GSM2545352 GSM2545353
Asl 494 481 666 937 803 541
Apod 11258 11812 15816 29242 20415 13682
Cyp2d22 1883 2014 2417 3678 2920 2216
Klk6 742 881 828 250 798 710
Fcrls 300 233 231 81 303 285
Slc2a4 271 304 349 715 513 320
GSM2545354 GSM2545362 GSM2545363 GSM2545380
Asl 473 748 576 1192
Apod 11088 15916 11166 38148
Cyp2d22 1821 2842 2011 4019
Klk6 894 501 598 259
Fcrls 248 179 184 68
Slc2a4 248 350 317 796R
dim(assay(se))
OUTPUT
[1] 1474 22ہم colData فنکشن کا استعمال کرتے ہوئے سیمپل کے میٹا ڈیٹا
تک رسائی حاصل کر سکتے ہیں:
R
colData(se)
OUTPUT
DataFrame with 22 rows and 9 columns
sample organism age sex infection
<character> <character> <integer> <character> <character>
GSM2545336 GSM2545336 Mus musculus 8 Female InfluenzaA
GSM2545337 GSM2545337 Mus musculus 8 Female NonInfected
GSM2545338 GSM2545338 Mus musculus 8 Female NonInfected
GSM2545339 GSM2545339 Mus musculus 8 Female InfluenzaA
GSM2545340 GSM2545340 Mus musculus 8 Male InfluenzaA
... ... ... ... ... ...
GSM2545353 GSM2545353 Mus musculus 8 Female NonInfected
GSM2545354 GSM2545354 Mus musculus 8 Male NonInfected
GSM2545362 GSM2545362 Mus musculus 8 Female InfluenzaA
GSM2545363 GSM2545363 Mus musculus 8 Male InfluenzaA
GSM2545380 GSM2545380 Mus musculus 8 Female InfluenzaA
strain time tissue mouse
<character> <integer> <character> <integer>
GSM2545336 C57BL/6 8 Cerebellum 14
GSM2545337 C57BL/6 0 Cerebellum 9
GSM2545338 C57BL/6 0 Cerebellum 10
GSM2545339 C57BL/6 4 Cerebellum 15
GSM2545340 C57BL/6 4 Cerebellum 18
... ... ... ... ...
GSM2545353 C57BL/6 0 Cerebellum 4
GSM2545354 C57BL/6 0 Cerebellum 2
GSM2545362 C57BL/6 4 Cerebellum 20
GSM2545363 C57BL/6 4 Cerebellum 12
GSM2545380 C57BL/6 8 Cerebellum 19R
dim(colData(se))
OUTPUT
[1] 22 9ہم rowData فنکشن کے ذریعے فیچر میٹا ڈیٹا تک بھی رسائی
حاصل کر سکتے ہیں:
R
head(rowData(se))
OUTPUT
DataFrame with 6 rows and 9 columns
gene ENTREZID product ensembl_gene_id
<character> <integer> <character> <character>
Asl Asl 109900 argininosuccinate ly.. ENSMUSG00000025533
Apod Apod 11815 apolipoprotein D, tr.. ENSMUSG00000022548
Cyp2d22 Cyp2d22 56448 cytochrome P450, fam.. ENSMUSG00000061740
Klk6 Klk6 19144 kallikrein related-p.. ENSMUSG00000050063
Fcrls Fcrls 80891 Fc receptor-like S, .. ENSMUSG00000015852
Slc2a4 Slc2a4 20528 solute carrier famil.. ENSMUSG00000018566
external_synonym chromosome_name gene_biotype phenotype_description
<character> <character> <character> <character>
Asl 2510006M18Rik 5 protein_coding abnormal circulating..
Apod NA 16 protein_coding abnormal lipid homeo..
Cyp2d22 2D22 15 protein_coding abnormal skin morpho..
Klk6 Bssp 7 protein_coding abnormal cytokine le..
Fcrls 2810439C17Rik 3 protein_coding decreased CD8-positi..
Slc2a4 Glut-4 11 protein_coding abnormal circulating..
hsapiens_homolog_associated_gene_name
<character>
Asl ASL
Apod APOD
Cyp2d22 CYP2D6
Klk6 KLK6
Fcrls FCRL2
Slc2a4 SLC2A4R
dim(rowData(se))
OUTPUT
[1] 1474 9SummarizedExperiment کی سب سیٹنگ
SummarizedExperiment کو بالکل ڈیٹا فریمز کی طرح عددی، کریکٹر یا منطقی انڈیکسز کے ذریعے سب سیٹ کیا جا سکتا ہے۔
نیچے، ہم SummarizedExperiment کلاس کا ایک نیا انسٹنس بناتے ہیں جس میں پہلے 3 نمونوں کی صرف پہلی 5 فیچرز شامل ہیں۔
R
se1 <- se[1:5, 1:3]
se1
OUTPUT
class: SummarizedExperiment
dim: 5 3
metadata(0):
assays(1): counts
rownames(5): Asl Apod Cyp2d22 Klk6 Fcrls
rowData names(9): gene ENTREZID ... phenotype_description
hsapiens_homolog_associated_gene_name
colnames(3): GSM2545336 GSM2545337 GSM2545338
colData names(9): sample organism ... tissue mouseR
colData(se1)
OUTPUT
DataFrame with 3 rows and 9 columns
sample organism age sex infection
<character> <character> <integer> <character> <character>
GSM2545336 GSM2545336 Mus musculus 8 Female InfluenzaA
GSM2545337 GSM2545337 Mus musculus 8 Female NonInfected
GSM2545338 GSM2545338 Mus musculus 8 Female NonInfected
strain time tissue mouse
<character> <integer> <character> <integer>
GSM2545336 C57BL/6 8 Cerebellum 14
GSM2545337 C57BL/6 0 Cerebellum 9
GSM2545338 C57BL/6 0 Cerebellum 10R
rowData(se1)
OUTPUT
DataFrame with 5 rows and 9 columns
gene ENTREZID product ensembl_gene_id
<character> <integer> <character> <character>
Asl Asl 109900 argininosuccinate ly.. ENSMUSG00000025533
Apod Apod 11815 apolipoprotein D, tr.. ENSMUSG00000022548
Cyp2d22 Cyp2d22 56448 cytochrome P450, fam.. ENSMUSG00000061740
Klk6 Klk6 19144 kallikrein related-p.. ENSMUSG00000050063
Fcrls Fcrls 80891 Fc receptor-like S, .. ENSMUSG00000015852
external_synonym chromosome_name gene_biotype phenotype_description
<character> <character> <character> <character>
Asl 2510006M18Rik 5 protein_coding abnormal circulating..
Apod NA 16 protein_coding abnormal lipid homeo..
Cyp2d22 2D22 15 protein_coding abnormal skin morpho..
Klk6 Bssp 7 protein_coding abnormal cytokine le..
Fcrls 2810439C17Rik 3 protein_coding decreased CD8-positi..
hsapiens_homolog_associated_gene_name
<character>
Asl ASL
Apod APOD
Cyp2d22 CYP2D6
Klk6 KLK6
Fcrls FCRL2ہم سیمپل میٹا ڈیٹا میں سے کسی بھی چیز کی بنیاد پر سب سیٹ کرنے کے لیے
colData() فنکشن یا فیچر میٹا ڈیٹا میں سے کسی بھی چیز کی
بنیاد پر سب سیٹ کرنے کے لیے rowData() کا استعمال بھی کر
سکتے ہیں۔ مثال کے طور پر، یہاں ہم صرف miRNAs اور غیر متاثرہ سیمپلز کو
رکھتے ہیں:
R
se1 <- se[rowData(se)$gene_biotype == "miRNA",
colData(se)$infection == "NonInfected"]
se1
OUTPUT
class: SummarizedExperiment
dim: 7 7
metadata(0):
assays(1): counts
rownames(7): Mir1901 Mir378a ... Mir128-1 Mir7682
rowData names(9): gene ENTREZID ... phenotype_description
hsapiens_homolog_associated_gene_name
colnames(7): GSM2545337 GSM2545338 ... GSM2545353 GSM2545354
colData names(9): sample organism ... tissue mouseR
assay(se1)
OUTPUT
GSM2545337 GSM2545338 GSM2545343 GSM2545348 GSM2545349 GSM2545353
Mir1901 45 44 74 55 68 33
Mir378a 11 7 9 4 12 4
Mir133b 4 6 5 4 6 7
Mir30c-2 10 6 16 12 8 17
Mir149 1 2 0 0 0 0
Mir128-1 4 1 2 2 1 2
Mir7682 2 0 4 1 3 5
GSM2545354
Mir1901 60
Mir378a 8
Mir133b 3
Mir30c-2 15
Mir149 2
Mir128-1 1
Mir7682 5R
colData(se1)
OUTPUT
DataFrame with 7 rows and 9 columns
sample organism age sex infection
<character> <character> <integer> <character> <character>
GSM2545337 GSM2545337 Mus musculus 8 Female NonInfected
GSM2545338 GSM2545338 Mus musculus 8 Female NonInfected
GSM2545343 GSM2545343 Mus musculus 8 Male NonInfected
GSM2545348 GSM2545348 Mus musculus 8 Female NonInfected
GSM2545349 GSM2545349 Mus musculus 8 Male NonInfected
GSM2545353 GSM2545353 Mus musculus 8 Female NonInfected
GSM2545354 GSM2545354 Mus musculus 8 Male NonInfected
strain time tissue mouse
<character> <integer> <character> <integer>
GSM2545337 C57BL/6 0 Cerebellum 9
GSM2545338 C57BL/6 0 Cerebellum 10
GSM2545343 C57BL/6 0 Cerebellum 11
GSM2545348 C57BL/6 0 Cerebellum 8
GSM2545349 C57BL/6 0 Cerebellum 7
GSM2545353 C57BL/6 0 Cerebellum 4
GSM2545354 C57BL/6 0 Cerebellum 2R
rowData(se1)
OUTPUT
DataFrame with 7 rows and 9 columns
gene ENTREZID product ensembl_gene_id
<character> <integer> <character> <character>
Mir1901 Mir1901 100316686 microRNA 1901 ENSMUSG00000084565
Mir378a Mir378a 723889 microRNA 378a ENSMUSG00000105200
Mir133b Mir133b 723817 microRNA 133b ENSMUSG00000065480
Mir30c-2 Mir30c-2 723964 microRNA 30c-2 ENSMUSG00000065567
Mir149 Mir149 387167 microRNA 149 ENSMUSG00000065470
Mir128-1 Mir128-1 387147 microRNA 128-1 ENSMUSG00000065520
Mir7682 Mir7682 102466847 microRNA 7682 ENSMUSG00000106406
external_synonym chromosome_name gene_biotype phenotype_description
<character> <character> <character> <character>
Mir1901 Mirn1901 18 miRNA NA
Mir378a Mirn378 18 miRNA abnormal mitochondri..
Mir133b mir 133b 1 miRNA no abnormal phenotyp..
Mir30c-2 mir 30c-2 1 miRNA NA
Mir149 Mirn149 1 miRNA increased circulatin..
Mir128-1 Mirn128 1 miRNA no abnormal phenotyp..
Mir7682 mmu-mir-7682 1 miRNA NA
hsapiens_homolog_associated_gene_name
<character>
Mir1901 NA
Mir378a MIR378A
Mir133b MIR133B
Mir30c-2 MIR30C2
Mir149 NA
Mir128-1 MIR128-1
Mir7682 NAچیلنج
ٹائم 0 اور ٹائم 8 کے نمونوں میں پہلے تین جینز کی جین کے اظہار کی سطحوں کو نکالیں۔
R
assay(se)[1:3, colData(se)$time != 4]
OUTPUT
GSM2545336 GSM2545337 GSM2545338 GSM2545341 GSM2545342 GSM2545343
Asl 1170 361 400 988 836 535
Apod 36194 10347 9173 29594 24959 13668
Cyp2d22 4060 1616 1603 3349 3122 2008
GSM2545346 GSM2545347 GSM2545348 GSM2545349 GSM2545351 GSM2545353
Asl 938 1035 494 481 937 541
Apod 27769 34301 11258 11812 29242 13682
Cyp2d22 2985 3452 1883 2014 3678 2216
GSM2545354 GSM2545380
Asl 473 1192
Apod 11088 38148
Cyp2d22 1821 4019R
# Equivalent to
assay(se)[1:3, colData(se)$time == 0 | colData(se)$time == 8]
OUTPUT
GSM2545336 GSM2545337 GSM2545338 GSM2545341 GSM2545342 GSM2545343
Asl 1170 361 400 988 836 535
Apod 36194 10347 9173 29594 24959 13668
Cyp2d22 4060 1616 1603 3349 3122 2008
GSM2545346 GSM2545347 GSM2545348 GSM2545349 GSM2545351 GSM2545353
Asl 938 1035 494 481 937 541
Apod 27769 34301 11258 11812 29242 13682
Cyp2d22 2985 3452 1883 2014 3678 2216
GSM2545354 GSM2545380
Asl 473 1192
Apod 11088 38148
Cyp2d22 1821 4019چیلنج
تصدیق کریں کہ لانگ rna ٹیبل کا استعمال کرتے ہوئے آپ کو
وہی اقدار ملتی ہیں۔
R
rna |>
filter(gene %in% c("Asl", "Apod", "Cyd2d22")) |>
filter(time != 4) |>
select(expression)
OUTPUT
# A tibble: 28 × 1
expression
<dbl>
1 1170
2 36194
3 361
4 10347
5 400
6 9173
7 988
8 29594
9 836
10 24959
# ℹ 18 more rowsلانگ ٹیبل اور SummarizedExperiment میں ایک ہی معلومات
موجود ہیں، لیکن ان کی ساخت محض مختلف ہے۔ ہر طریقہ کار کے اپنے فوائد ہیں:
پہلا tidyverse پیکیجز کے لیے موزوں ہے، جبکہ دوسرا بہت سے
بائیو انفارمیٹکس اور شماریاتی پروسیسنگ مراحل کے لیے ترجیحی ساخت ہے۔ مثال
کے طور پر، DESeq2 پیکیج کا استعمال کرتے ہوئے ایک معمول کا
RNA-Seq تجزیہ۔
میٹا ڈیٹا میں متغیرات شامل کرنا
ہم میٹا ڈیٹا میں معلومات بھی شامل کر سکتے ہیں۔ فرض کریں کہ آپ اس مرکز کا ذکر شامل کرنا چاہتے ہیں جہاں نمونے جمع کیے گئے تھے…
R
colData(se)$center <- rep("University of Illinois", nrow(colData(se)))
colData(se)
OUTPUT
DataFrame with 22 rows and 10 columns
sample organism age sex infection
<character> <character> <integer> <character> <character>
GSM2545336 GSM2545336 Mus musculus 8 Female InfluenzaA
GSM2545337 GSM2545337 Mus musculus 8 Female NonInfected
GSM2545338 GSM2545338 Mus musculus 8 Female NonInfected
GSM2545339 GSM2545339 Mus musculus 8 Female InfluenzaA
GSM2545340 GSM2545340 Mus musculus 8 Male InfluenzaA
... ... ... ... ... ...
GSM2545353 GSM2545353 Mus musculus 8 Female NonInfected
GSM2545354 GSM2545354 Mus musculus 8 Male NonInfected
GSM2545362 GSM2545362 Mus musculus 8 Female InfluenzaA
GSM2545363 GSM2545363 Mus musculus 8 Male InfluenzaA
GSM2545380 GSM2545380 Mus musculus 8 Female InfluenzaA
strain time tissue mouse center
<character> <integer> <character> <integer> <character>
GSM2545336 C57BL/6 8 Cerebellum 14 University of Illinois
GSM2545337 C57BL/6 0 Cerebellum 9 University of Illinois
GSM2545338 C57BL/6 0 Cerebellum 10 University of Illinois
GSM2545339 C57BL/6 4 Cerebellum 15 University of Illinois
GSM2545340 C57BL/6 4 Cerebellum 18 University of Illinois
... ... ... ... ... ...
GSM2545353 C57BL/6 0 Cerebellum 4 University of Illinois
GSM2545354 C57BL/6 0 Cerebellum 2 University of Illinois
GSM2545362 C57BL/6 4 Cerebellum 20 University of Illinois
GSM2545363 C57BL/6 4 Cerebellum 12 University of Illinois
GSM2545380 C57BL/6 8 Cerebellum 19 University of Illinoisیہ ظاہر کرتا ہے کہ میٹا ڈیٹا سلاٹس دیگر ساختوں کو متاثر کیے بغیر لامحدود طور پر بڑھ سکتے ہیں!
tidySummarizedExperiment
شاید آپ سوچ رہے ہوں کہ کیا ہم SummarizedExperiment
آبجیکٹس کے ساتھ تعامل کے لیے tidyverse کمانڈز استعمال کر سکتے ہیں؟ جواب
ہے ہاں، ہم tidySummarizedExperiment پیکیج کے ذریعے ایسا کر
سکتے ہیں۔
یاد رکھیں کہ ہمارا SummarizedExperiment آبجیکٹ کیسا دکھائی دیتا ہے:
R
se
OUTPUT
class: SummarizedExperiment
dim: 1474 22
metadata(0):
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(10): sample organism ... mouse centertidySummarizedExperiment کو لوڈ کریں اور پھر se آبجیکٹ
کو دوبارہ دیکھیں۔
R
## BiocManager::install("tidySummarizedExperiment")
library("tidySummarizedExperiment")
se
OUTPUT
class: SummarizedExperiment
dim: 1474 22
metadata(0):
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(10): sample organism ... mouse centerیہ اب بھی ایک SummarizedExperiment آبجیکٹ ہے، اس لیے یہ
اپنی موثر ساخت کو برقرار رکھتا ہے، لیکن اب ہم اسے ایک tibble کے طور پر
دیکھ سکتے ہیں۔ نوٹ کریں کہ آؤٹ پٹ کی پہلی لائن میں یہ ذکر ہے کہ یہ ایک
SummarizedExperiment-tibble ابسٹرکشن ہے۔ ہم
آؤٹ پٹ کی دوسری لائن میں ٹرانسکرپٹس اور سیمپلز کی تعداد بھی دیکھ سکتے
ہیں۔
اب ہم SummarizedExperiment آبجیکٹ کے ساتھ تعامل کرنے کے
لیے tidyverse کمانڈز استعمال کر سکتے ہیں۔
ہم کسی شرط کی بنیاد پر قطاروں کو فلٹر کرنے کے لیے filter
استعمال کر سکتے ہیں، مثلاً ایک سیمپل کی تمام قطاریں دیکھنے کے لیے۔
R
se |> filter(sample == "GSM2545336")
OUTPUT
class: SummarizedExperiment
dim: 1474 1
metadata(1): latest_filter_scope_report
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
hsapiens_homolog_associated_gene_name
colnames(1): GSM2545336
colData names(10): sample organism ... mouse centerR
se |> filter(sex == "Female")
OUTPUT
class: SummarizedExperiment
dim: 1474 12
metadata(1): latest_filter_scope_report
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
hsapiens_homolog_associated_gene_name
colnames(12): GSM2545336 GSM2545337 ... GSM2545362 GSM2545380
colData names(10): sample organism ... mouse centerہم دیکھنے کے لیے مطلوبہ کالمز کی نشاندہی کرنے کے لیے
select استعمال کر سکتے ہیں۔
R
se |> select(sample, sex)
WARNING
Warning: `when()` was deprecated in purrr 1.0.0.
ℹ Please use `if` instead.
ℹ The deprecated feature was likely used in the tidySummarizedExperiment
package.
Please report the issue at
<https://github.com/stemangiola/tidySummarizedExperiment/issues>.
This warning is displayed once per session.
Call `lifecycle::last_lifecycle_warnings()` to see where this warning was
generated.OUTPUT
tidySummarizedExperiment says: Key columns are missing. A data frame is returned for independent data analysis.OUTPUT
# A tibble: 32,428 × 2
sample sex
<chr> <chr>
1 GSM2545336 Female
2 GSM2545336 Female
3 GSM2545336 Female
4 GSM2545336 Female
5 GSM2545336 Female
6 GSM2545336 Female
7 GSM2545336 Female
8 GSM2545336 Female
9 GSM2545336 Female
10 GSM2545336 Female
# ℹ 32,418 more rowsہم میٹا ڈیٹا کی معلومات شامل کرنے کے لیے mutate استعمال
کر سکتے ہیں۔
R
se |> mutate(center = "Heidelberg University")
OUTPUT
class: SummarizedExperiment
dim: 1474 22
metadata(1): latest_mutate_scope_report
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(10): sample organism ... mouse centerہم کمانڈز کو tidyverse پائپ |> کے ذریعے بھی یکجا کر
سکتے ہیں۔ مثال کے طور پر، ہم ہر سیمپل کے لیے کل گنتیاں حاصل کرنے کے لیے
group_by اور summarise کو یکجا کر سکتے
ہیں۔
R
se |>
group_by(.sample) |>
summarise(total_counts=sum(counts))
OUTPUT
tidySummarizedExperiment says: A data frame is returned for independent data analysis.OUTPUT
# A tibble: 22 × 2
.sample total_counts
<chr> <int>
1 GSM2545336 3039671
2 GSM2545337 2602360
3 GSM2545338 2458618
4 GSM2545339 2500082
5 GSM2545340 2479024
6 GSM2545341 2413723
7 GSM2545342 2349728
8 GSM2545343 3105652
9 GSM2545344 2524137
10 GSM2545345 2506038
# ℹ 12 more rowsہم tidy SummarizedExperiment آبجیکٹ کو پلوٹنگ کے لیے ایک عام tibble کے طور پر استعمال کر سکتے ہیں۔
یہاں ہم ہر نمونے کے لحاظ سے گنتیوں کی تقسیم کو پلوٹ کرتے ہیں۔
R
se |>
ggplot(aes(counts + 1, group=.sample, color=infection)) +
geom_density() +
scale_x_log10() +
theme_bw()
tidySummarizedExperiment کے بارے میں مزید معلومات کے
لیے، پیکیج کی
ویب سائٹ دیکھیں۔
اہم نکتہ
SummarizedExperimentاومکس ڈیٹا کو محفوظ کرنے اور اسے سنبھالنے کا ایک مؤثر طریقہ ہے۔انہیں بہت سے Bioconductor پیکیجز میں استعمال کیا جاتا ہے۔
اگر آپ RNA سیکوئنسنگ تجزیے پر مرکوز اگلی تربیت کا پیروی کریں گے، تو
آپ Bioconductor DESeq2 پیکیج کا استعمال کر کے کچھ ڈیفرنشل
ایکسپریشن تجزیے کرنا سیکھیں گے۔ DESeq2 پیکیج کا پورا تجزیہ
ایک SummarizedExperiment میں کیا جاتا ہے۔
- Bioconductor ایک ایسا پروجیکٹ ہے جو ہائی تھروپٹ بائیولوجی ڈیٹا کی تفہیم کے لیے معاونت اور پیکیجز فراہم کرتا ہے۔
-
SummarizedExperimentایک ایسی اشیاء کی قسم ہے جو ہائی-تھروپٹ اومکس ڈیٹا کو محفوظ کرنے اور اس کے انتظام کے لیے مفید ہے۔
Bioconductor کا آغاز رابرٹ جینٹل مین نے کیا، جو R زبان کے دو تخلیق کاروں میں سے ایک ہیں۔ Bioconductor اومکس ڈیٹا تجزیے کے لیے مخصوص ٹولز فراہم کرتا ہے۔ Bioconductor R شماریاتی پروگرامنگ زبان کا استعمال کرتا ہے اور یہ اوپن سورس اور اوپن ڈویلپمنٹ پر مبنی ہے۔↩︎