
R کا تعارف
Last updated on 2026-11-11 | Edit this page
Overview
Questions
- R میں پہلی کمانڈز
Objectives
- R سے متعلق درج ذیل اصطلاحات کی تعریف کریں: آبجیکٹ، اسائن، کال، فنکشن، آرگومنٹس، آپشنز۔
- R میں آبجیکٹس کو ویلیوز تفویض کریں۔
- سیکھیں کہ آبجیکٹس کا نام کیسے لگایا جائے
- اسکرپٹ کو معلومات فراہم کرنے کے لیے کمنٹس کا استعمال کریں۔
- R میں سادہ حسابی آپریشنز حل کریں۔
- فنکشنز کو کال کریں اور ان کے ڈیفالٹ آپشنز کو تبدیل کرنے کے لیے آرگومنٹس کا استعمال کریں۔
- ویکٹرز کے مواد کا معائنہ کریں اور ان کے مواد میں تبدیلیاں کریں۔
- ویکٹرز سے سب سیٹس حاصل کریں اور اقدار نکالیں۔
- ناموجود اقدار والے ویکٹرز کا تجزیہ کریں۔
یہ ایپیسوڈ Data Carpentries کے Data Analysis and Visualisation in R for Ecologists اسباق پر مبنی ہے۔
R میں آبجیکٹس کی تخلیق
آپ کنسول میں محض ریاضی ٹائپ کر کے R سے آؤٹ پٹ حاصل کر سکتے ہیں:
R
3 + 5
OUTPUT
[1] 8R
12 / 7
OUTPUT
[1] 1.714286تاہم، مفید اور دلچسپ کام کرنے کے لیے، ہمیں آبجیکٹس کو
ویلیوز تفویض کرنے کی ضرورت ہوتی ہے۔ کسی آبجیکٹ کو بنانے کے لیے،
ہمیں اسے ایک نام دینا ہوگا جس کے بعد ایسائمنٹ آپریٹر <-
اور وہ ویلیو دینی ہوگی جو ہم اسے دینا چاہتے ہیں:
R
weight_kg <- 55
<- اسائنمنٹ آپریٹر ہے۔ یہ دائیں جانب موجود اقدار کو
بائیں جانب موجود آبجیکٹس کو اسائن کرتا ہے۔ چنانچہ،
x <- 3 چلانے کے بعد، x کی اقدار
3 ہو جاتی ہے۔ اس ایرو کو اس طرح سمجھا جا سکتا ہے کہ 3
x میں جاتا ہے۔ تاریخی وجوہات کی بنا پر، آپ
اسائنمنٹس کے لیے = بھی استعمال کر سکتے ہیں، لیکن ہر سیاق و
سباق میں نہیں۔ سنٹیکس میں معمولی
فرق کی وجہ سے، اسائنمنٹس کے لیے ہمیشہ <- استعمال
کرنا ایک بہتر طریقہ کار ہے۔
RStudio میں، Alt + - ٹائپ کرنے سے (-
کی کی کے ساتھ ہی Alt دبائیں) پی سی پر ایک ہی کی اسٹروک میں
<- لکھا جائے گا، جبکہ Mac پر Option +
- ٹائپ کرنے سے (- کی کی کے ساتھ ہی
Option دبائیں) وہی کام ہو جائے گا۔
ویری ایبلز کے نام رکھنا
آبجیکٹس کو کوئی بھی نام دیا جا سکتا ہے جیسے کہ x،
current_temperature، یا subject_id۔ آپ چاہتے
ہیں کہ آپ کے آبجیکٹ کے نام واضح ہوں اور بہت طویل نہ ہوں۔ ان کا آغاز نمبر
سے نہیں ہو سکتا (2x درست نہیں ہے، لیکن x2 درست
ہے)۔ R کیس سینسیٹیو ہے (مثلاً، weight_kg اور
Weight_kg مختلف ہیں)۔ کچھ ایسے نام ہیں جنہیں استعمال نہیں
کیا جا سکتا کیونکہ وہ R میں بنیادی فنکشنز کے نام ہیں (مثلاً،
if، else، for؛ مکمل فہرست کے لیے
Reserved
Words in R مینوئل پیج دیکھیں)۔ عام طور پر، چاہے وہ اجازت یافتہ ہی
کیوں نہ ہو، بہتر ہے کہ دیگر فنکشن کے ناموں (مثلاً، c،
T، mean، data، df،
weights) کا استعمال نہ کیا جائے۔ اگر کوئی شک ہو، تو ہیلپ
چیک کریں تاکہ دیکھا جا سکے کہ آیا وہ نام پہلے سے استعمال میں ہے یا نہیں۔
آبجیکٹ کے نام میں ڈاٹس (.) سے بچنا بھی بہتر ہے جیسا کہ
my.dataset میں ہے۔ تاریخی وجوہات کی بنا پر R میں بہت سے
فنکشنز کے نام میں ڈاٹس ہیں، لیکن چونکہ ڈاٹس کا R (میتھڈز کے لیے) اور
دیگر پروگرامنگ زبانوں میں ایک خاص معنی ہے، اس لیے ان سے بچنا ہی بہتر ہے۔
یہ بھی تجویز کیا جاتا ہے کہ آبجیکٹ کے ناموں کے لیے اسم استعمال کیے
جائیں، اور فنکشن کے ناموں کے لیے فعل۔ اپنے کوڈ کی اسٹائلنگ میں تسلسل
برقرار رکھنا ضروری ہے (جیسے کہ آپ سپیس کہاں رکھتے ہیں، آبجیکٹس کے نام
کیسے رکھتے ہیں، وغیرہ)۔ کوڈنگ کا ایک مستقل انداز استعمال کرنے سے آپ کا
کوڈ آپ کے لیے اور آپ کے ساتھیوں کے لیے پڑھنے میں زیادہ واضح ہو جاتا ہے۔
R میں، کچھ مقبول اسٹائل گائیڈز Google کی، tidyverse کی اسٹائل اور Bioconductor
اسٹائل گائیڈ ہیں۔ tidyverse کی گائیڈ بہت جامع ہے اور شروع میں شاید
بہت زیادہ لگے۔ آپ اپنے کوڈ کی اسٹائلنگ میں مسائل کو خودکار طور پر چیک
کرنے کے لیے lintr
پیکیج انسٹال کر سکتے ہیں۔
آبجیکٹس بمقابلہ ویری ایبلز: جو چیزیں
Rمیںobjectsکے طور پر جانی جاتی ہیں، انہیں بہت سی دیگر پروگرامنگ زبانوں میںvariablesکہا جاتا ہے۔ سیاق و سباق کے لحاظ سے،objectاورvariableکے معنی بالکل مختلف ہو سکتے ہیں۔ تاہم، اس سبق میں، ان دونوں الفاظ کا استعمال مترادف طور پر کیا گیا ہے۔ مزید معلومات کے لیے یہاں دیکھیں۔
کسی آبجیکٹ کو ویلیو تفویض کرتے وقت، R کچھ بھی پرنٹ نہیں کرتا۔ آپ پیرنتھس استعمال کر کے یا آبجیکٹ کا نام ٹائپ کر کے R کو ویلیو پرنٹ کرنے پر مجبور کر سکتے ہیں:
R
weight_kg <- 55    # doesn't print anything
(weight_kg <- 55)  # but putting parenthesis around the call prints the value of `weight_kg`
OUTPUT
[1] 55R
weight_kg # and so does typing the name of the object
OUTPUT
[1] 55اب جب کہ R کے میموری میں weight_kg موجود ہے، تو ہم اس کے
ساتھ حسابی کارروائی کر سکتے ہیں۔ مثال کے طور پر، ہم اس وزن کو پاؤنڈز میں
تبدیل کرنا چاہیں گے (پاؤنڈز میں وزن، کلوگرام میں وزن سے 2.2 گنا ہوتا
ہے):
R
2.2 * weight_kg
OUTPUT
[1] 121ہم کسی آبجیکٹ کی ویلیو کو نئی ویلیو تفویض کر کے بھی تبدیل کر سکتے ہیں:
R
weight_kg <- 57.5
2.2 * weight_kg
OUTPUT
[1] 126.5اس کا مطلب یہ ہے کہ کسی ایک آبجیکٹ کو ویلیو تفویض کرنے سے دیگر
آبجیکٹس کی ویلیوز تبدیل نہیں ہوتیں۔ مثال کے طور پر، آئیے جانور کے وزن کو
پاؤنڈز میں ایک نئے آبجیکٹ، weight_lb میں محفوظ کریں:
R
weight_lb <- 2.2 * weight_kg
اور پھر weight_kg کو 100 میں تبدیل کریں۔
R
weight_kg <- 100
چیلنج:
آپ کے خیال میں آبجیکٹ weight_lb کا موجودہ مواد کیا ہے؟
126.5 یا 220؟
تبصرے
R میں کمنٹ کا کریکٹر # ہے، اسکرپٹ میں # کے
دائیں جانب موجود کوئی بھی چیز R کے ذریعے نظر انداز کر دی جائے گی۔ اپنے
اسکرپٹس میں نوٹس اور وضاحتیں چھوڑنا مفید ہوتا ہے۔
RStudio ایک پیراگراف کو کمنٹ کرنے یا کمنٹ سے آزاد کرنے کو آسان بنا دیتا ہے: جن لائنوں کو آپ کمنٹ کرنا چاہتے ہیں انہیں منتخب کرنے کے بعد، اپنے کی بورڈ پر بیک وقت Ctrl + Shift + C دبائیں۔ اگر آپ صرف ایک لائن کو کمنٹ کرنا چاہتے ہیں، تو آپ کرسر کو اس لائن کی کسی بھی جگہ رکھ سکتے ہیں (یعنی پوری لائن کو منتخب کرنے کی ضرورت نہیں ہے)، پھر Ctrl + Shift + C دبائیں۔
چیلنج
مندرجہ ذیل میں ہر اسٹیٹمنٹ کے بعد کیا ویلیوز ہیں؟
R
mass <- 47.5            # mass?
age  <- 122             # age?
mass <- mass * 2.0      # mass?
age  <- age - 20        # age?
mass_index <- mass/age  # mass_index?
فنکشنز اور ان کے آرگومنٹس
فنکشنز “پہلے سے تیار کردہ اسکرپٹس” ہوتے ہیں جو کمانڈز کے زیادہ پیچیدہ
مجموعوں کو خودکار بناتے ہیں، جن میں مختلف کارروائیاں، اسائنمنٹس وغیرہ
شامل ہیں۔ بہت سے فنکشنز پہلے سے متعین ہوتے ہیں، یا R پیکیجز کو
امپورٹ کر کے دستیاب کیے جا سکتے ہیں (اس کے بارے میں مزید تفصیل بعد میں
دی جائے گی)۔ ایک فنکشن کو عام طور پر ایک یا ایک سے زیادہ ان پٹس ملتے ہیں
جنہیں آرگومنٹس کہا جاتا ہے۔ فنکشنز اکثر (لیکن ہمیشہ نہیں) ایک
ویلیو واپس کرتے ہیں۔ ایک عام مثال sqrt() فنکشن ہو
سکتا ہے۔ ان پٹ (آرگومنٹ) ایک عدد ہونا ضروری ہے، اور واپسی کی ویلیو
(دراصل، آؤٹ پٹ) اس عدد کا مربع جذر ہے۔ کسی فنکشن کو چلانے (‘رن کرنے’) کو
فنکشن کو کال کرنا کہا جاتا ہے۔ فنکشن کال کی ایک مثال یہ ہے:
R
b <- sqrt(a)
یہاں، a کی ویلیو sqrt() فنکشن کو دی جاتی
ہے، sqrt() فنکشن مربع جذر کا حساب لگاتا ہے، اور وہ ویلیو
واپس کرتا ہے جسے پھر آبجیکٹ b کو اسائن کر دیا جاتا ہے۔ یہ
فنکشن بہت سادہ ہے، کیونکہ یہ صرف ایک آرگومنٹ لیتا ہے۔
کسی فنکشن کی واپسی کی ‘ویلیو’ کا عددی ہونا ضروری نہیں ہے (جیسا کہ
sqrt() کی ہے)، اور اس کا ایک ہی آئٹم ہونا بھی ضروری نہیں
ہے: یہ چیزوں کا ایک سیٹ، یا یہاں تک کہ ایک ڈیٹا سیٹ بھی ہو سکتا ہے۔ ہم
اسے تب دیکھیں گے جب ہم R میں ڈیٹا فائلیں پڑھیں گے۔
آرگومنٹس کچھ بھی ہو سکتے ہیں، نہ صرف اعداد یا فائل کے نام، بلکہ دیگر آبجیکٹس بھی۔ ہر آرگومنٹ کا درست مطلب ہر فنکشن کے لحاظ سے مختلف ہوتا ہے، اور اسے دستاویزات میں تلاش کرنا پڑتا ہے (نیچے دیکھیں)۔ کچھ فنکشنز ایسے آرگومنٹس لیتے ہیں جنہیں یا تو صارف کے ذریعے متعین کیا جا سکتا ہے، یا اگر وہ چھوڑ دیے جائیں، تو انہیں ایک ڈیفالٹ ویلیو مل جاتی ہے: انہیں آپشنز کہا جاتا ہے۔ آپشنز کا استعمال عام طور پر فنکشن کے کام کرنے کے طریقے کو تبدیل کرنے کے لیے کیا جاتا ہے، جیسے کہ کیا وہ ‘غلط ویلیوز’ کو نظر انداز کرے، یا پلاٹ میں کس سمبل کا استعمال کرنا ہے۔ تاہم، اگر آپ کسی مخصوص چیز کے خواہش مند ہیں، تو آپ اپنی پسند کی کوئی ویلیو متعین کر سکتے ہیں جو ڈیفالٹ کے بجائے استعمال کی جائے گی۔
آئیے ایک ایسے فنکشن کو آزمائیں جو متعدد آرگومنٹس لے سکے:
round()۔
R
round(3.14159)
OUTPUT
[1] 3یہاں، ہم نے round() کو صرف ایک آرگومنٹ،
3.14159، کے ساتھ کال کیا ہے، اور اس نے 3 کی
ویلیو واپس کر دی ہے۔ اس کی وجہ یہ ہے کہ ڈیفالٹ طریقہ قریب ترین صحیح عدد
تک راؤنڈ کرنا ہے۔ اگر ہمیں مزید ڈیجٹس چاہئیں تو ہم round
فنکشن کے بارے میں معلومات حاصل کر کے دیکھ سکتے ہیں کہ ایسا کیسے کیا
جائے۔ ہم args(round) استعمال کر سکتے ہیں یا
?round کے ذریعے اس فنکشن کی ہیلپ دیکھ سکتے ہیں۔
R
args(round)
OUTPUT
function (x, digits = 0, ...)
NULL
R
?round
ہم دیکھتے ہیں کہ اگر ہمیں ہندسوں کی تعداد بدلنی ہو، تو ہم
digits=2 لکھ سکتے ہیں، یا اس میں اپنی مطلوبہ تعداد مقرر کر
سکتے ہیں۔
R
round(3.14159, digits = 2)
OUTPUT
[1] 3.14اگر آپ آرگومنٹس کو بالکل اسی ترتیب میں فراہم کریں جیسا کہ وہ تعریف کیے گئے ہیں، تو آپ کو ان کے نام لگانے کی ضرورت نہیں ہوتی:
R
round(3.14159, 2)
OUTPUT
[1] 3.14اور اگر آپ آرگومنٹس کے نام لگائیں، تو آپ ان کی ترتیب بدل سکتے ہیں:
R
round(digits = 2, x = 3.14159)
OUTPUT
[1] 3.14یہ ایک بہتر طریقہ کار ہے کہ آپ اپنے فنکشن کال میں لازمی آرگومنٹس (جیسے کہ وہ نمبر جسے آپ راؤنڈ کر رہے ہیں) کو پہلے رکھیں، اور تمام اختیاری آرگومنٹس کے نام واضح کریں۔ اگر آپ ایسا نہیں کرتے، تو آپ کے کوڈ کو پڑھنے والے شخص کو یہ سمجھنے کے لیے کہ آپ کیا کر رہے ہیں، ایسے آرگومنٹس والے فنکشن کی تعریف تلاش کرنی پڑ سکتی ہے جن سے وہ واقف نہ ہوں۔ آرگومنٹس کے نام واضح کر کے آپ فنکشن انٹرفیس میں مستقبل میں ہونے والی ممکنہ تبدیلیوں سے بھی خود کو محفوظ رکھ رہے ہیں، جس کے نتیجے میں موجودہ آرگومنٹس کے درمیان نئے آرگومنٹس شامل ہو سکتے ہیں۔
ویکٹرز اور ڈیٹا اقسام
ویکٹر R میں سب سے عام اور بنیادی ڈیٹا ٹائپ ہے، اور یہ تقریباً R کا
بنیادی ذریعہ ہے۔ ایک ویکٹر اقدار کے ایک سلسلے پر مشتمل ہوتا ہے، جیسے کہ
اعداد یا حروف۔ ہم c() فنکشن کا استعمال کرتے ہوئے ایک ویکٹر
کو اقدار کا ایک سلسلہ تفویض کر سکتے ہیں۔ مثال کے طور پر، ہم جانوروں کے
وزن کا ایک ویکٹر بنا سکتے ہیں اور اسے ایک نئے آبجیکٹ
weight_g کو تفویض کر سکتے ہیں:
R
weight_g <- c(50, 60, 65, 82)
weight_g
OUTPUT
[1] 50 60 65 82ایک ویکٹر میں حروف بھی ہو سکتے ہیں:
R
molecules <- c("dna", "rna", "protein")
molecules
OUTPUT
[1] "dna" "rna" "protein"یہاں “dna”، “rna” وغیرہ کے گرد کوٹیشنز ضروری ہیں۔ کوٹیشنز کے بغیر R
یہ فرض کرے گا کہ dna، rna اور
protein نامی آبجیکٹس موجود ہیں۔ چونکہ یہ آبجیکٹس R کی
میموری میں موجود نہیں ہیں، اس لیے ایک ایرر میسج آئے گا۔
ایسے بہت سے فنکشنز موجود ہیں جو آپ کو ایک ویکٹر کے مواد کا معائنہ
کرنے کی سہولت دیتے ہیں۔ length() آپ کو بتاتا ہے کہ کسی خاص
ویکٹر میں کتنے عناصر موجود ہیں:
R
length(weight_g)
OUTPUT
[1] 4R
length(molecules)
OUTPUT
[1] 3ایک ویکٹر کی ایک اہم خصوصیت یہ ہے کہ اس کے تمام عناصر ایک ہی قسم کا
ڈیٹا ہوتے ہیں۔ فنکشن class() کسی آبجیکٹ کی کلاس (عنصر کی
قسم) کو ظاہر کرتا ہے:
R
class(weight_g)
OUTPUT
[1] "numeric"R
class(molecules)
OUTPUT
[1] "character"فنکشن str() کسی آبجیکٹ کی ساخت اور اس کے عناصر کا ایک
جائزہ فراہم کرتا ہے۔ یہ بڑے اور پیچیدہ آبجیکٹس کے ساتھ کام کرتے وقت ایک
مفید فنکشن ہے:
R
str(weight_g)
OUTPUT
num [1:4] 50 60 65 82R
str(molecules)
OUTPUT
chr [1:3] "dna" "rna" "protein"آپ اپنے ویکٹر میں دیگر عناصر شامل کرنے کے لیے c() فنکشن
استعمال کر سکتے ہیں:
R
weight_g <- c(weight_g, 90) # add to the end of the vector
weight_g <- c(30, weight_g) # add to the beginning of the vector
weight_g
OUTPUT
[1] 30 50 60 65 82 90پہلی لائن میں، ہم اصل ویکٹر weight_g لیتے ہیں، اس کے آخر
میں ویلیو 90 شامل کرتے ہیں، اور نتیجے کو دوبارہ
weight_g میں محفوظ کرتے ہیں۔ پھر ہم اس کے آغاز میں ویلیو
30 شامل کرتے ہیں، اور ایک بار پھر نتیجے کو
weight_g میں محفوظ کرتے ہیں۔
ہم ایک ویکٹر کو بڑھانے یا ڈیٹا سیٹ تیار کرنے کے لیے اسے بار بار کر سکتے ہیں۔ پروگرامنگ کے دوران، یہ ان نتائج کو شامل کرنے کے لیے مفید ہو سکتا ہے جو ہم جمع کر رہے ہیں یا حساب کر رہے ہیں۔
ایک اٹامک ویکٹر R کی سادہ ترین ڈیٹا
ٹائپ ہے اور ایک ہی قسم کا لینیئر ویکٹر ہوتا ہے۔ اوپر، ہم نے ان
6 بنیادی اٹامک ویکٹر اقسام میں سے 2 دیکھے ہیں جو R
استعمال کرتا ہے: "character" اور "numeric" (یا
"double")۔ یہ بنیادی اجزاء ہیں جن سے تمام R آبجیکٹس تیار
کیے جاتے ہیں۔ دیگر 4 اٹامک ویکٹر اقسام یہ ہیں:
-
"logical"TRUEاورFALSEکے لیے (بولین ڈیٹا ٹائپ) -
"integer"صحیح اعداد کے لیے (مثلاً،2L،LR کو یہ ظاہر کرتا ہے کہ یہ ایک صحیح عدد ہے) -
"complex"کے ذریعے حقیقی اور تخیلی حصوں والے پیچیدہ اعداد کی نمائندگی کی جائے گی (مثلاً،1 + 4i) اور ان کے بارے میں ہم صرف اتنا ہی کہیں گے۔ -
"raw"ان بٹ اسٹریمز کے لیے جن پر ہم مزید بحث نہیں کریں گے
آپ typeof() فنکشن کا استعمال کرتے ہوئے اور اپنا ویکٹر
آرگومنٹ کے طور پر فراہم کر کے اپنے ویکٹر کی ٹائپ چیک کر سکتے ہیں۔
ویکٹرز ان بہت سے ڈیٹا اسٹرکچرز میں سے ایک ہیں جو R
استعمال کرتا ہے۔ دیگر اہم اسٹرکچرز میں لسٹس (list)، میٹرکسز
(matrix)، ڈیٹا فریمز (data.frame)، فیکٹرز
(factor) اور ارےز (array) شامل ہیں۔
چیلنج:
ہم نے دیکھا ہے کہ اٹامک ویکٹرز کی اقسام character، numeric (یا double)، integer، اور logical ہو سکتی ہیں۔ لیکن کیا ہوگا اگر ہم ایک ہی ویکٹر میں ان اقسام کو ملا کر استعمال کرنے کی کوشش کریں؟
R انہیں ضمنی طور پر ایک ہی ٹائپ میں تبدیل کر دیتا ہے
چیلنج:
ان میں سے ہر مثال میں کیا ہوگا؟ (اشارہ: اپنے آبجیکٹس کی ڈیٹا ٹائپ چیک
کرنے کے لیے class() استعمال کریں اور ان کے نام لکھ کر
دیکھیں کہ کیا ہوتا ہے):
R
num_char <- c(1, 2, 3, "a")
num_logical <- c(1, 2, 3, TRUE, FALSE)
char_logical <- c("a", "b", "c", TRUE)
tricky <- c(1, 2, 3, "4")
R
class(num_char)
OUTPUT
[1] "character"R
num_char
OUTPUT
[1] "1" "2" "3" "a"R
class(num_logical)
OUTPUT
[1] "numeric"R
num_logical
OUTPUT
[1] 1 2 3 1 0R
class(char_logical)
OUTPUT
[1] "character"R
char_logical
OUTPUT
[1] "a" "b" "c" "TRUE"R
class(tricky)
OUTPUT
[1] "character"R
tricky
OUTPUT
[1] "1" "2" "3" "4"چیلنج:
آپ کے خیال میں یہ کیوں ہوتا ہے؟
ویکٹرز صرف ایک ہی ڈیٹا ٹائپ کے ہو سکتے ہیں۔ R اس ویکٹر کے مواد کو تبدیل (coerce) کرنے کی کوشش کرتا ہے تاکہ ایک ایسی مشترکہ ڈیٹا ٹائپ حاصل کی جا سکے جس میں کوئی معلومات ضائع نہ ہوں۔
چیلنج:
مندرجہ ذیل مثال میں combined_logical کی کتنی اقدار
"TRUE" (ایک کیریکٹر کے طور پر) ہیں:
R
num_logical <- c(1, 2, 3, TRUE)
char_logical <- c("a", "b", "c", TRUE)
combined_logical <- c(num_logical, char_logical)
صرف ایک۔ پچھلے ڈیٹا اقسام کی کوئی یادداشت نہیں رہتی، اور کوئرشن
(coercion) اس وقت ہوتی ہے جب ویکٹر کو پہلی بار ایویلیویٹ (evaluate) کیا
جاتا ہے۔ لہٰذا، num_logical میں موجود TRUE کو
combined_logical میں "1" میں تبدیل ہونے سے
پہلے 1 میں تبدیل کر دیا جاتا ہے۔
R
combined_logical
OUTPUT
[1] "1" "2" "3" "1" "a" "b" "c" "TRUE"چیلنج:
R میں، ہم ایک کلاس سے دوسری کلاس میں آبجیکٹس کو تبدیل کرنے کے عمل کو coercion کہتے ہیں۔ یہ تبدیلیاں ایک ہائرارکی کے مطابق ہوتی ہیں، جس میں کچھ اقسام کو ترجیحی طور پر دیگر اقسام میں تبدیل کیا جاتا ہے۔ کیا آپ ایک ایسا ڈایگرام بنا سکتے ہیں جو اس ہائرارکی کی نمائندگی کرے کہ ان ڈیٹا اقسام کو کس طرح تبدیل کیا جاتا ہے؟
logical → numeric → character ← logical
ویکٹرز کی سبسیٹنگ
اگر ہم ایک ویکٹر سے ایک یا کئی اقدار نکالنا چاہتے ہیں، تو ہمیں مربع بریکٹس میں ایک یا کئی انڈیکسز فراہم کرنے ہوں گے۔ مثال کے طور پر:
R
molecules <- c("dna", "rna", "peptide", "protein")
molecules[2]
OUTPUT
[1] "rna"R
molecules[c(3, 2)]
OUTPUT
[1] "peptide" "rna" ہم انڈیکسز کو دہرا کر ایک ایسا آبجیکٹ بھی بنا سکتے ہیں جس میں اصل آبجیکٹ کے مقابلے میں زیادہ عناصر ہوں:
R
more_molecules <- molecules[c(1, 2, 3, 2, 1, 4)]
more_molecules
OUTPUT
[1] "dna" "rna" "peptide" "rna" "dna" "protein"R کے انڈیکسز 1 سے شروع ہوتے ہیں۔ پروگرامنگ زبانیں جیسے کہ Fortran، MATLAB، Julia اور R، گنتی 1 سے شروع کرتی ہیں، کیونکہ انسان عام طور پر ایسا ہی کرتے ہیں۔ C خاندان کی زبانیں (بشمول C++، Java، Perl اور Python) 0 سے گنتی کرتی ہیں کیونکہ کمپیوٹرز کے لیے یہ زیادہ آسان ہوتا ہے۔
آخر میں، منفی انڈیکسز استعمال کر کے ویکٹر کے کچھ متعین عناصر کو چھوڑ کر باقی تمام عناصر حاصل کرنا بھی ممکن ہے:
R
molecules ## all molecules
OUTPUT
[1] "dna" "rna" "peptide" "protein"R
molecules[-1] ## all but the first one
OUTPUT
[1] "rna" "peptide" "protein"R
molecules[-c(1, 3)] ## all but 1st/3rd ones
OUTPUT
[1] "rna" "protein"R
molecules[c(-1, -3)] ## all but 1st/3rd ones
OUTPUT
[1] "rna" "protein"شرطی سبسیٹنگ
سبسیٹنگ کا ایک اور عام طریقہ لاجیکل ویکٹر کا استعمال کرنا ہے۔
TRUE اسی انڈیکس والے عنصر کو منتخب کرے گا، جبکہ
FALSE ایسا نہیں کرے گا:
R
weight_g <- c(21, 34, 39, 54, 55)
weight_g[c(TRUE, FALSE, TRUE, TRUE, FALSE)]
OUTPUT
[1] 21 39 54عام طور پر، یہ لوجیکل ویکٹرز ہاتھ سے ٹائپ نہیں کیے جاتے، بلکہ دیگر فنکشنز یا لوجیکل ٹیسٹس کا نتیجہ ہوتے ہیں۔ مثال کے طور پر، اگر آپ صرف 50 سے زائد اقدار کا انتخاب کرنا چاہتے ہوں:
R
## will return logicals with TRUE for the indices that meet
## the condition
weight_g > 50
OUTPUT
[1] FALSE FALSE FALSE TRUE TRUER
## so we can use this to select only the values above 50
weight_g[weight_g > 50]
OUTPUT
[1] 54 55آپ & (دونوں شرائط سچ ہیں، AND) یا | (کم
از کم ایک شرط سچ ہے، OR) کا استعمال کرتے ہوئے متعدد ٹیسٹوں کو یکجا کر
سکتے ہیں:
R
weight_g[weight_g < 30 | weight_g > 50]
OUTPUT
[1] 21 54 55R
weight_g[weight_g >= 30 & weight_g == 21]
OUTPUT
numeric(0)یہاں، < کا مطلب “سے چھوٹا”، > کا مطلب
“سے بڑا”، >= کا مطلب “سے بڑا یا اس کے برابر”، اور
== کا مطلب “کے برابر” ہے۔ دوہرے برابر کا نشان
== بائیں اور دائیں جانب کی عددی برابری کی جانچ کرتا ہے، اور
اسے ایک واحد = نشان کے ساتھ خلط ملط نہیں کیا جانا چاہیے، جو
متغیر کی تفویض (variable assignment) کرتا ہے (<- کی
طرح)۔
ایک عام کام ویکٹر میں مخصوص سٹرنگز کی تلاش کرنا ہے۔ کئی اقدار کے ساتھ
برابری کی جانچ کرنے کے لیے “or” آپریٹر | استعمال کیا جا
سکتا ہے، لیکن یہ جلد ہی تھکا دینے والا کام بن سکتا ہے۔ فنکشن
%in% آپ کو یہ جانچنے کی اجازت دیتا ہے کہ کیا سرچ ویکٹر کے
کسی بھی عنصر کو پایا گیا ہے:
R
molecules <- c("dna", "rna", "protein", "peptide")
molecules[molecules == "rna" | molecules == "dna"] # returns both rna and dna
OUTPUT
[1] "dna" "rna"R
molecules %in% c("rna", "dna", "metabolite", "peptide", "glycerol")
OUTPUT
[1] TRUE TRUE FALSE TRUER
molecules[molecules %in% c("rna", "dna", "metabolite", "peptide", "glycerol")]
OUTPUT
[1] "dna" "rna" "peptide"چیلنج:
کیا آپ یہ سمجھ سکتے ہیں کہ "four" > "five" کیوں
TRUE واپس کرتا ہے؟
R
"four" > "five"
OUTPUT
[1] TRUEسٹرنگز پر > یا < استعمال کرتے وقت، R
ان کی حروفِ تہجی کی ترتیب کا موازنہ کرتا ہے۔ یہاں "four"
حروفِ تہجی کی ترتیب میں "five" کے بعد آتا ہے، اور اس لیے یہ
اس سے بڑا ہے۔
نام
ایک ویکٹر کے ہر عنصر کا نام رکھنا ممکن ہے۔ نیچے دیا گیا کوڈ چنک ایک ایسے ابتدائی ویکٹر کو دکھاتا ہے جس میں کوئی نام نہیں ہیں، اور یہ بھی دکھاتا ہے کہ نام کیسے سیٹ کیے جاتے ہیں اور کیسے حاصل کیے جاتے ہیں۔
R
x <- c(1, 5, 3, 5, 10)
names(x) ## no names
OUTPUT
NULLR
names(x) <- c("A", "B", "C", "D", "E")
names(x) ## now we have names
OUTPUT
[1] "A" "B" "C" "D" "E"جب کسی ویکٹر کے نام ہوں، تو ان کے انڈیکس کے علاوہ، ان کے نام کے ذریعے بھی عناصر تک رسائی حاصل کرنا ممکن ہے۔
R
x[c(1, 3)]
OUTPUT
A C
1 3
R
x[c("A", "C")]
OUTPUT
A C
1 3
غیر موجود ڈیٹا
چونکہ R کو ڈیٹا سیٹس کے تجزیے کے لیے ڈیزائن کیا گیا تھا، اس میں مفقود
ڈیٹا کا تصور شامل ہے (جو دیگر پروگرامنگ زبانوں میں غیر معمولی ہے)۔
ویکٹرز میں مفقود ڈیٹا کو NA کے طور پر ظاہر کیا جاتا ہے۔
اعداد و شمار پر آپریشنز کرتے وقت، زیادہ تر فنکشنز NA
واپس کر دیں گے اگر آپ کے پاس موجود ڈیٹا میں غیر موجود اقدار شامل ہوں۔ یہ
خصوصیت ان صورتوں کو نظر انداز کرنا مشکل بنا دیتی ہے جہاں آپ غیر موجود
ڈیٹا کے ساتھ کام کر رہے ہوں۔ آپ غیر موجود اقدار کو نظر انداز کرتے ہوئے
نتیجہ کے لیے آرگومنٹ na.rm = TRUE شامل کر سکتے ہیں۔
R
heights <- c(2, 4, 4, NA, 6)
mean(heights)
OUTPUT
[1] NAR
max(heights)
OUTPUT
[1] NAR
mean(heights, na.rm = TRUE)
OUTPUT
[1] 4R
max(heights, na.rm = TRUE)
OUTPUT
[1] 6اگر آپ کے ڈیٹا میں غیر موجود اقدار شامل ہیں، تو آپ شاید فنکشنز
is.na()، na.omit()، اور
complete.cases() سے واقف ہونا چاہیں گے۔ مثالوں کے لیے نیچے
دیکھیں۔
R
## Extract those elements which are not missing values.
heights[!is.na(heights)]
OUTPUT
[1] 2 4 4 6R
## Returns the object with incomplete cases removed.
## The returned object is an atomic vector of type `"numeric"`
## (or `"double"`).
na.omit(heights)
OUTPUT
[1] 2 4 4 6
attr(,"na.action")
[1] 4
attr(,"class")
[1] "omit"
R
## Extract those elements which are complete cases.
## The returned object is an atomic vector of type `"numeric"`
## (or `"double"`).
heights[complete.cases(heights)]
OUTPUT
[1] 2 4 4 6چیلنج:
- انچ میں قد کے اس ویکٹر کا استعمال کرتے ہوئے، NAs کو ہٹا کر ایک نیا ویکٹر بنائیں۔
R
heights <- c(63, 69, 60, 65, NA, 68, 61, 70, 61, 59, 64, 69, 63, 63, NA, 72, 65, 64, 70, 63, 65)
-
heightsویکٹر کا میڈین حساب کرنے کے لیے فانکشنmedian()کا استعمال کریں۔ - R کا استعمال کرتے ہوئے یہ معلوم کریں کہ اس سیٹ میں کتنے لوگ 67 انچ سے زیادہ قد کے ہیں۔
R
heights_no_na <- heights[!is.na(heights)]
## or
heights_no_na <- na.omit(heights)
R
median(heights, na.rm = TRUE)
OUTPUT
[1] 64R
heights_above_67 <- heights_no_na[heights_no_na > 67]
length(heights_above_67)
OUTPUT
[1] 6ویکٹرز تیار کرنا
کنسٹرکٹرز
مختلف اقسام کے ویکٹرز تیار کرنے کے لیے کچھ فنکشنز موجود ہیں۔ عددی
ویکٹر تیار کرنے کے لیے، numeric() کنسٹرکٹر کا استعمال کیا
جا سکتا ہے، جس میں آؤٹ پٹ ویکٹر کی لمبائی کو پیرامیٹر کے طور پر فراہم
کیا جاتا ہے۔ اقدار کو 0 سے انیشیالائز کیا جائے گا۔
R
numeric(3)
OUTPUT
[1] 0 0 0R
numeric(10)
OUTPUT
[1] 0 0 0 0 0 0 0 0 0 0نوٹ کریں کہ اگر ہم 0 لمبائی کا عددی ویکٹر مانگیں، تو ہمیں بالکل وہی ملتا ہے:
R
numeric(0)
OUTPUT
numeric(0)کیریکٹرز اور لوجیکلز کے لیے بھی اسی طرح کے کنسٹرکٹرز موجود ہیں، جن کے
نام بالترتیب character() اور logical()
ہیں۔
چیلنج:
کیریکٹر اور لوجیکل ویکٹرز کی ابتدائی ڈیفالٹ اقدار کیا ہوتی ہیں؟
R
character(2) ## the empty character
OUTPUT
[1] "" ""R
logical(2) ## FALSE
OUTPUT
[1] FALSE FALSEعناصر کو دہرائیں
rep فنکشن کسی ویلیو کو ایک مخصوص تعداد میں دہرانے کی
اجازت دیتا ہے۔ مثال کے طور پر، اگر ہم -1 کی ویلیو کے ساتھ 5 لمبائی کا
ایک عددی ویکٹر بنانا چاہتے ہیں، تو ہم درج ذیل طریقہ اپنا سکتے ہیں:
R
rep(-1, 5)
OUTPUT
[1] -1 -1 -1 -1 -1اسی طرح، غیر موجود اقدار پر مشتمل ایک ویکٹر تیار کرنے کے لیے، جو اکثر اکٹھا کیے جانے والے ڈیٹا کے بارے میں کوئی مفروضے قائم کیے بغیر آغاز کرنے کا ایک اچھا طریقہ ہوتا ہے:
R
rep(NA, 5)
OUTPUT
[1] NA NA NA NA NArep کسی بھی لمبائی کے ویکٹرز کو ان پٹ کے طور پر لے سکتا
ہے (اوپر، ہم نے 1 لمبائی کے ویکٹرز استعمال کیے) اور کسی بھی ٹائپ کے۔
مثال کے طور پر، اگر ہم 1، 2 اور 3 کی اقدار کو پانچ بار دہرانا چاہتے ہیں،
تو ہم درج ذیل طریقہ اپنائیں گے:
R
rep(c(1, 2, 3), 5)
OUTPUT
[1] 1 2 3 1 2 3 1 2 3 1 2 3 1 2 3چیلنج:
کیا ہوگا اگر ہم 1، 2 اور 3 کی اقدار کو پانچ بار دہرانا چاہیں، لیکن اس
ترتیب میں پانچ 1، پانچ 2 اور پانچ 3 حاصل کرنا چاہیں؟ اس کے دو طریقے ہیں
- مدد کے لیے ?rep یا ?sort دیکھیں۔
R
rep(c(1, 2, 3), each = 5)
OUTPUT
[1] 1 1 1 1 1 2 2 2 2 2 3 3 3 3 3R
sort(rep(c(1, 2, 3), 5))
OUTPUT
[1] 1 1 1 1 1 2 2 2 2 2 3 3 3 3 3سیکوئنس کی تخلیق
ایک اور انتہائی مفید فنکشن seq ہے، جو اعداد کا ایک
سیکوئنس تیار کرتا ہے۔ مثال کے طور پر، 1 سے 20 تک کے صحیح اعداد کا ایک
سیکوئنس 2 کے فاصلے سے تیار کرنے کے لیے، اس کا استعمال کیا جائے گا:
R
seq(from = 1, to = 20, by = 2)
OUTPUT
[1] 1 3 5 7 9 11 13 15 17 19by کی ڈیفالٹ ویلیو 1 ہے اور، چونکہ ایک ویلیو سے دوسری
ویلیو تک 1 کے فاصلوں کے ساتھ سیکوئنس تیار کرنا اکثر استعمال ہوتا ہے، اس
لیے ایک مختصر طریقہ موجود ہے:
R
seq(1, 5, 1)
OUTPUT
[1] 1 2 3 4 5R
seq(1, 5) ## default by
OUTPUT
[1] 1 2 3 4 5R
1:5
OUTPUT
[1] 1 2 3 4 51 سے 20 تک اعداد کا ایک سیکوئنس تیار کرنے کے لیے، جس کی حتمی لمبائی 3 ہو، درج ذیل کا استعمال کیا جائے گا:
R
seq(from = 1, to = 20, length.out = 3)
OUTPUT
[1] 1.0 10.5 20.0رینڈم نمونے اور پرمیوٹیشنز
مفید فنکشنز کا ایک آخری گروپ وہ ہیں جو رینڈم ڈیٹا تیار کرتے ہیں۔
پہلا، sample، ایک دوسرے ویکٹر کی رینڈم پرمیوٹیشن تیار کرتا
ہے۔ مثال کے طور پر، 10 طلبہ کے زبانی امتحان کے لیے ایک رینڈم ترتیب
نکالنے کے لیے، میں پہلے ہر طالب علم کو 1 سے دس تک کا ایک نمبر تفویض کرتا
ہوں (مثلاً ان کے نام کی حروفِ تہجی کی ترتیب کی بنیاد پر) اور پھر:
R
sample(1:10)
OUTPUT
[1] 9 4 7 1 2 5 3 10 6 8مزید آرگومنٹس کے بغیر، sample ویکٹر کے تمام عناصر کی ایک
پرمیوٹیشن (permutation) واپس کرے گا۔ اگر مجھے ایک مخصوص سائز کا رینڈم
سیمپل چاہیے، تو میں اس ویلیو کو دوسرے آرگومنٹ کے طور پر سیٹ کروں گا۔
نیچے، میں پہلے سے متعین شدہ letters ویکٹر میں موجود حروفِ
تہجی سے 5 رینڈم حروف کا سیمپل لیتا ہوں:
R
sample(letters, 5)
OUTPUT
[1] "s" "a" "u" "x" "j"اگر مجھے ان پٹ ویکٹر سے بڑا آؤٹ پٹ چاہیے، یا کچھ عناصر کو کئی بار
منتخب کرنے کی صلاحیت چاہیے، تو مجھے replace آرگومنٹ کو
TRUE پر سیٹ کرنا ہوگا:
R
sample(1:5, 10, replace = TRUE)
OUTPUT
[1] 2 1 5 5 1 1 5 5 2 2چیلنج:
مندرجہ بالا فنکشنز کو آزماتے ہوئے، آپ نے محسوس کیا ہوگا کہ نمونے
واقعی بے ترتیب ہیں اور ایک ہی پرمیوٹیشن دوبارہ نہیں ملتی۔ ان بے ترتیب
نمونوں کو دوبارہ حاصل کرنے کے لیے، بے ترتیب نمونہ نکالنے سے پہلے
set.seed() کے ذریعے رینڈم نمبر جنریشن کے سیڈ کو دستی طور پر
سیٹ کیا جا سکتا ہے۔
اپنے پڑوسی کے ساتھ اس فیچر کو آزمائیں۔ سب سے پہلے 1:10
کی دو رینڈم پرمیوٹیشنز آزادانہ طور پر نکالیں اور دیکھیں کہ آپ کو مختلف
نتائج ملتے ہیں۔
اب، مثال کے طور پر set.seed(123) کے ذریعے سیڈ (seed) سیٹ
کریں اور رینڈم ڈرا کو دہرائیں۔ دیکھیں کہ اب آپ کو ایک جیسے رینڈم ڈرا
حاصل ہو رہے ہیں۔
ایک مختلف سیڈ سیٹ کر کے اسے دہرائیں۔
مختلف پرمیوٹیشنز
R
sample(1:10)
OUTPUT
[1] 9 1 4 3 6 2 5 8 10 7R
sample(1:10)
OUTPUT
[1] 4 9 7 6 1 10 8 3 2 5سیڈ 123 کے ساتھ وہی پرمیوٹیشنز
R
set.seed(123)
sample(1:10)
OUTPUT
[1] 3 10 2 8 6 9 1 7 5 4R
set.seed(123)
sample(1:10)
OUTPUT
[1] 3 10 2 8 6 9 1 7 5 4ایک مختلف سیڈ
R
set.seed(1)
sample(1:10)
OUTPUT
[1] 9 4 7 1 2 5 3 10 6 8R
set.seed(1)
sample(1:10)
OUTPUT
[1] 9 4 7 1 2 5 3 10 6 8نارمل تقسیم سے نمونے نکالنا
آخری فنکشن جو ہم دیکھیں گے وہ rnorm ہے، جو ایک نارمل
تقسیم سے ایک رینڈم نمونہ نکالتا ہے۔ اوسط 0 اور 100 اور اسٹینڈرڈ ڈیوی
ایشنز 1 اور 5 والی دو نارمل تقسیمیں، جنہیں N(0, 1) اور
N(100, 5) سے ظاہر کیا گیا ہے، نیچے دکھائی گئی ہیں۔
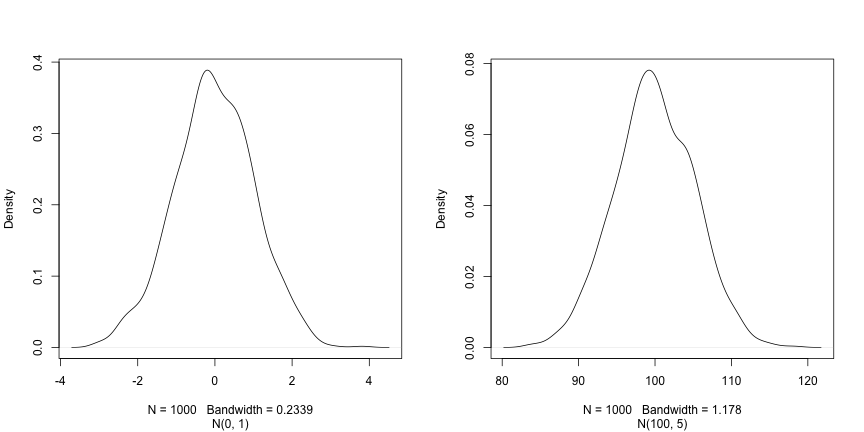
تین آرگومنٹس، n، mean اور sd،
نمونے کے سائز اور نارمل تقسیم کے پیرامیٹرز، یعنی اوسط اور اس کے معیاری
انحراف کی تعریف کرتے ہیں۔ بعد والے کی ڈیفالٹ اقدار 0 اور 1 ہیں۔
R
rnorm(5)
OUTPUT
[1] 0.69641761 0.05351568 -1.31028350 -2.12306606 -0.20807859R
rnorm(5, 2, 2)
OUTPUT
[1] 1.3744268 -0.1164714 2.8344472 1.3690969 3.6510983R
rnorm(5, 100, 5)
OUTPUT
[1] 106.45636 96.87448 95.62427 100.71678 107.12595اب جب کہ ہم نے اسکرپٹس لکھنے کا طریقہ اور R کے ڈیٹا اسٹرکچرز کی بنیادی باتیں سیکھ لی ہیں، تو ہم بڑے ڈیٹا کے ساتھ کام شروع کرنے اور ڈیٹا فریمز کے بارے میں جاننے کے لیے تیار ہیں۔
- R کے ساتھ تعامل کیسے کریں