
ڈیٹا سے آغاز
Last updated on 2026-11-11 | Edit this page
Estimated time: 60 minutes
Overview
Questions
- R میں پہلا ڈیٹا تجزیہ
Objectives
- بتائیں کہ
data.frameکیا ہے۔ - ایک .csv فائل سے بیرونی ڈیٹا کو ڈیٹا فریم میں لوڈ کریں۔
- ایک ڈیٹا فریم کے مواد کا خلاصہ کریں۔
- بتائیں کہ فیکٹر کیا ہوتا ہے۔
- اسٹرنگز اور فیکٹرز کے درمیان تبدیلی کریں۔
- فیکٹرز کی ترتیب بدلیں اور ان کے نام تبدیل کریں۔
- تاریخوں کو فارمیٹ کریں۔
- ڈیٹا کو ایکسپورٹ اور محفوظ کریں۔
یہ ایپیسوڈ Data Carpentries کے Data Analysis and Visualisation in R for Ecologists اسباق پر مبنی ہے۔
جین کے اظہار کے ڈیٹا کی پیشکش
ہم Blackmore et al. (2017) کی شائع کردہ ڈیٹا کے ایک حصے، The effect of upper-respiratory infection on transcriptomic changes in the CNS کا استعمال کریں گے۔ اس مطالعے کا مقصد یہ تعین کرنا تھا کہ اوپری سانس کی نالی کے انفیکشن کا انفیکشن کے بعد سیریبیلم اور سپائنل کارڈ میں ہونے والی RNA ٹرانسکرپشن کی تبدیلیوں پر کیا اثر پڑتا ہے۔ جنس کے لحاظ سے مطابقت رکھنے والے آٹھ ہفتے کے C57BL/6 چوہوں کو انٹراناسل راستے سے سالین یا انفلوئنزا A کے ذریعے انوکیولیٹ کیا گیا، اور سیریبیلم اور سپائنل کارڈ کے ٹشوز میں ٹرانسکرپٹومک تبدیلیوں کا جائزہ 0 (غیر متاثرہ)، 4 اور 8 کے دنوں پر RNA-seq کے ذریعے لیا گیا۔
ڈیٹا سیٹ کو کوما-سیپریٹڈ ویلیوز (CSV) فائل کے طور پر محفوظ کیا گیا ہے۔ ہر قطار میں RNA کے اظہار کی ایک واحد پیمائش کی معلومات شامل ہیں، اور پہلے گیارہ کالم درج ذیل کی نمائندگی کرتے ہیں:
| کالم | تفصیل |
|---|---|
| gene | اس جین کا نام جس کی پیمائش کی گئی تھی |
| sample | اس نمونے کا نام جس میں جین کے اظہار کی پیمائش کی گئی تھی |
| expression | جین کے اظہار کی ویلیو |
| organism | جاندار/نوع - یہاں تمام ڈیٹا چوہوں سے حاصل کیا گیا ہے |
| age | چوہے کی عمر (یہاں تمام چوہے 8 ہفتے کے تھے) |
| sex | چوہے کی جنس |
| infection | چوہے کی انفیکشن کی حالت، یعنی انفلوئنزا اے سے متاثر ہے یا نہیں۔ |
| strain | انفلوئنزا اے کا سٹرین۔ |
| time | انفیکشن کی مدت (دنوں میں)۔ |
| tissue | وہ ٹشو جسے جین کے اظہار کے تجربے کے لیے استعمال کیا گیا، یعنی سیریبلم یا ریڑھ کی ہڈی۔ |
| mouse | چوہے کا منفرد شناختی علامت۔ |
ہم جین کے اظہار کے ڈیٹا پر مشتمل CSV فائل ڈاؤن لوڈ کرنے کے لیے R
فنکشن download.file() استعمال کریں گے، اور CSV فائل کے مواد
کو میموری میں data.frame کلاس کے ایک آبجیکٹ کے طور پر لوڈ
کرنے کے لیے read.csv() استعمال کریں گے۔
download.file کمانڈ کے اندر، پہلا اندراج ایک کیریکٹر اسٹرنگ
ہے جس میں سورس URL درج ہے۔ یہ سورس URL ایک GitHub ریپوزٹری سے CSV فائل
ڈاؤن لوڈ کرتا ہے۔ کومے کے بعد کا متن ("data/rnaseq.csv") آپ
کی لوکل مشین پر فائل محفوظ کرنے کا مقام ہے۔ آپ کو اپنی مشین پر
"data" نامی ایک فولڈر ہونا چاہیے جہاں آپ فائل ڈاؤن لوڈ کریں
گے۔ لہٰذا یہ کمانڈ ریموٹ فائل ڈاؤن لوڈ کرتی ہے، اسے
"rnaseq.csv" نام دیتی ہے اور اسے "data" نامی
پہلے سے موجود فولڈر میں شامل کرتی ہے۔
R
download.file(url = "https://github.com/carpentries-incubator/bioc-intro/raw/main/episodes/data/rnaseq.csv",
              destfile = "data/rnaseq.csv")
اب آپ ڈیٹا لوڈ کرنے کے لیے تیار ہیں:
R
rna <- read.csv("data/rnaseq.csv")
یہ اسٹیٹمنٹ کوئی آؤٹ پٹ پیدا نہیں کرتا کیونکہ، جیسا کہ آپ کو یاد ہوگا، اسائنمنٹس کچھ بھی ظاہر نہیں کرتے۔ اگر ہم یہ چیک کرنا چاہتے ہیں کہ ہمارا ڈیٹا لوڈ ہو گیا ہے، تو ہم ڈیٹا فریم کے نام ٹائپ کر کے اس کے مواد کو دیکھ سکتے ہیں:
R
rna
واہ… آؤٹ پٹ بہت زیادہ تھا۔ کم از کم اس کا مطلب یہ ہے کہ ڈیٹا درست
طریقے سے لوڈ ہو گیا ہے۔ آئیے فانکشن head() کا استعمال کرتے
ہوئے اس ڈیٹا فریم کے اوپری حصے (پہلی 6 لائنیں) کو چیک کرتے ہیں:
R
head(rna)
OUTPUT
     gene     sample expression     organism age    sex  infection  strain time
1     Asl GSM2545336       1170 Mus musculus   8 Female InfluenzaA C57BL/6    8
2    Apod GSM2545336      36194 Mus musculus   8 Female InfluenzaA C57BL/6    8
3 Cyp2d22 GSM2545336       4060 Mus musculus   8 Female InfluenzaA C57BL/6    8
4    Klk6 GSM2545336        287 Mus musculus   8 Female InfluenzaA C57BL/6    8
5   Fcrls GSM2545336         85 Mus musculus   8 Female InfluenzaA C57BL/6    8
6  Slc2a4 GSM2545336        782 Mus musculus   8 Female InfluenzaA C57BL/6    8
      tissue mouse ENTREZID
1 Cerebellum    14   109900
2 Cerebellum    14    11815
3 Cerebellum    14    56448
4 Cerebellum    14    19144
5 Cerebellum    14    80891
6 Cerebellum    14    20528
                                                                       product
1                               argininosuccinate lyase, transcript variant X1
2                                       apolipoprotein D, transcript variant 3
3 cytochrome P450, family 2, subfamily d, polypeptide 22, transcript variant 2
4                         kallikrein related-peptidase 6, transcript variant 2
5                Fc receptor-like S, scavenger receptor, transcript variant X1
6          solute carrier family 2 (facilitated glucose transporter), member 4
     ensembl_gene_id external_synonym chromosome_name   gene_biotype
1 ENSMUSG00000025533    2510006M18Rik               5 protein_coding
2 ENSMUSG00000022548             <NA>              16 protein_coding
3 ENSMUSG00000061740             2D22              15 protein_coding
4 ENSMUSG00000050063             Bssp               7 protein_coding
5 ENSMUSG00000015852    2810439C17Rik               3 protein_coding
6 ENSMUSG00000018566           Glut-4              11 protein_coding
                            phenotype_description
1           abnormal circulating amino acid level
2                      abnormal lipid homeostasis
3                        abnormal skin morphology
4                         abnormal cytokine level
5 decreased CD8-positive alpha-beta T cell number
6              abnormal circulating glucose level
  hsapiens_homolog_associated_gene_name
1                                   ASL
2                                  APOD
3                                CYP2D6
4                                  KLK6
5                                 FCRL2
6                                SLC2A4
R
## Try also
## View(rna)
نوٹ
read.csv() یہ فرض کرتا ہے کہ فیلڈز کو کومے کے ذریعے الگ
کیا جاتا ہے، تاہم، کئی ممالک میں کومے کو اعشاریہ کے علامت کے طور پر اور
سیمی کولن (;) کو فیلڈ کے علامت کے طور پر استعمال کیا جاتا ہے۔ اگر آپ R
میں اس قسم کی فائلوں کو پڑھنا چاہتے ہیں، تو آپ read.csv2()
فنکشن استعمال کر سکتے ہیں۔ یہ بالکل read.csv() کی طرح کام
کرتا ہے لیکن اعشاریہ اور فیلڈ کے علامتوں کے لیے مختلف پیرامیٹرز استعمال
کرتا ہے۔ اگر آپ کسی دوسرے فارمیٹ کے ساتھ کام کر رہے ہیں، تو دونوں کو
صارف کے ذریعے متعین کیا جا سکتا ہے۔ مزید جاننے کے لیے
?read.csv ٹائپ کر کے read.csv() کی ہیلپ
دیکھیں۔ ٹیب کے ذریعے الگ کی گئی ڈیٹا فائلوں کو پڑھنے کے لیے
read.delim() فنکشن بھی موجود ہے۔ یہ نوٹ کرنا ضروری ہے کہ یہ
تمام فنکشنز دراصل مرکزی read.table() فنکشن کے لیے مختلف
آرگومنٹس والے ریپر فنکشنز ہیں۔ اسی لحاظ سے، اوپر دیے گئے ڈیٹا کو
read.table() کا استعمال کرتے ہوئے سیپریشن آرگومنٹ کو
, کے طور پر بھی لوڈ کیا جا سکتا تھا۔ کوڈ درج ذیل ہے:
R
rna <- read.table(file = "data/rnaseq.csv",
                  sep = ",",
                  header = TRUE)
ہیڈر آرگومنٹ کو TRUE پر سیٹ کرنا ضروری ہے تاکہ ہیڈرز کو پڑھا جا سکے،
کیونکہ ڈیفالٹ طور پر read.table() میں ہیڈر آرگومنٹ FALSE پر
سیٹ ہوتا ہے۔
ڈیٹا فریمز کیا ہیں؟
ڈیٹا فریمز زیادہ تر ٹیبل ڈیٹا کے لیے ڈی فیکٹو ڈیٹا اسٹرکچر ہیں، اور ہم انہیں شماریات اور پلوٹنگ کے لیے استعمال کرتے ہیں۔
ایک ڈیٹا فریم کو دستی طور پر بنایا جا سکتا ہے، لیکن زیادہ تر صورتوں
میں انہیں read.csv() یا read.table() فانکشنز
کے ذریعے تیار کیا جاتا ہے؛ دوسرے الفاظ میں، جب آپ اپنی ہارڈ ڈرائیو (یا
ویب) سے اسپریڈشیٹس امپورٹ کرتے ہیں۔
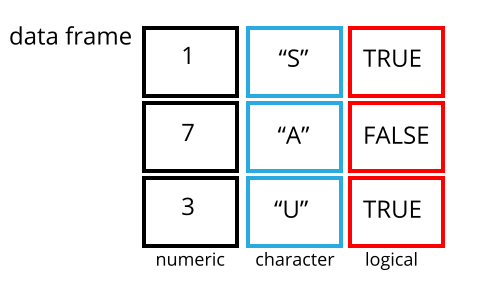
ڈیٹا فریم ڈیٹا کی ایک ایسی نمائندگی ہے جو ٹیبل کے فارمیٹ میں ہوتی ہے جہاں کالمز ویکٹرز ہوتے ہیں اور ان سب کی لمبائی ایک جیسی ہوتی ہے۔ چونکہ کالمز ویکٹرز ہوتے ہیں، اس لیے ہر کالم میں ڈیٹا کی ایک ہی قسم (مثلاً، کیریکٹرز، انٹیجرز، فیکٹرز) ہونی چاہیے۔ مثال کے طور پر، یہاں ایک شکل دکھائی گئی ہے جو عددی، کیریکٹر اور لوجیکل ویکٹرز پر مشتمل ڈیٹا فریم کی عکاسی کرتی ہے۔
ہم اسے str() فنکشن کے ذریعے ایک ڈیٹا فریم کی
structure کا معائنہ کرتے ہوئے دیکھ سکتے ہیں:
R
str(rna)
OUTPUT
'data.frame':	32428 obs. of  19 variables:
 $ gene                                 : chr  "Asl" "Apod" "Cyp2d22" "Klk6" ...
 $ sample                               : chr  "GSM2545336" "GSM2545336" "GSM2545336" "GSM2545336" ...
 $ expression                           : int  1170 36194 4060 287 85 782 1619 288 43217 1071 ...
 $ organism                             : chr  "Mus musculus" "Mus musculus" "Mus musculus" "Mus musculus" ...
 $ age                                  : int  8 8 8 8 8 8 8 8 8 8 ...
 $ sex                                  : chr  "Female" "Female" "Female" "Female" ...
 $ infection                            : chr  "InfluenzaA" "InfluenzaA" "InfluenzaA" "InfluenzaA" ...
 $ strain                               : chr  "C57BL/6" "C57BL/6" "C57BL/6" "C57BL/6" ...
 $ time                                 : int  8 8 8 8 8 8 8 8 8 8 ...
 $ tissue                               : chr  "Cerebellum" "Cerebellum" "Cerebellum" "Cerebellum" ...
 $ mouse                                : int  14 14 14 14 14 14 14 14 14 14 ...
 $ ENTREZID                             : int  109900 11815 56448 19144 80891 20528 97827 118454 18823 14696 ...
 $ product                              : chr  "argininosuccinate lyase, transcript variant X1" "apolipoprotein D, transcript variant 3" "cytochrome P450, family 2, subfamily d, polypeptide 22, transcript variant 2" "kallikrein related-peptidase 6, transcript variant 2" ...
 $ ensembl_gene_id                      : chr  "ENSMUSG00000025533" "ENSMUSG00000022548" "ENSMUSG00000061740" "ENSMUSG00000050063" ...
 $ external_synonym                     : chr  "2510006M18Rik" NA "2D22" "Bssp" ...
 $ chromosome_name                      : chr  "5" "16" "15" "7" ...
 $ gene_biotype                         : chr  "protein_coding" "protein_coding" "protein_coding" "protein_coding" ...
 $ phenotype_description                : chr  "abnormal circulating amino acid level" "abnormal lipid homeostasis" "abnormal skin morphology" "abnormal cytokine level" ...
 $ hsapiens_homolog_associated_gene_name: chr  "ASL" "APOD" "CYP2D6" "KLK6" ...
data.frame آبجیکٹس کا معائنہ کرنا
ہم پہلے ہی دیکھ چکے ہیں کہ فیکشنز head() اور
str() ایک ڈیٹا فریم کے مواد اور ساخت کی جانچ کرنے میں کیسے
مفید ثابت ہو سکتے ہیں۔ یہاں ڈیٹا کے مواد/ساخت کا اندازہ لگانے کے لیے
فیکشنز کی ایک غیر جامع فہرست دی گئی ہے۔ آئیے انہیں آزما کر دیکھتے
ہیں!
سائز:
-
dim(rna)- ایک ویکٹر واپس کرتا ہے جس میں پہلے عنصر کے طور پر قطاروں کی تعداد اور دوسرے عنصر کے طور پر کالموں کی تعداد ہوتی ہے (آبجیکٹ کی dimensions)۔ -
nrow(rna)- قطاروں کی تعداد واپس کرتا ہے۔ -
ncol(rna)- کالموں کی تعداد واپس کرتا ہے۔
مواد:
-
head(rna)- پہلی 6 قطاریں دکھاتا ہے۔ -
tail(rna)- آخری 6 قطاریں دکھاتا ہے۔
نام:
-
names(rna)- کالموں کے نام واپس کرتا ہے (data.frameآبجیکٹس کے لیےcolnames()کا مترادف)۔ -
rownames(rna)- قطاروں کے نام واپس کرتا ہے۔
خلاصہ:
-
str(rna)- آبجیکٹ کی ساخت اور ہر کالم کی کلاس، لمبائی اور مواد کے بارے میں معلومات۔ -
summary(rna)- ہر کالم کے لیے خلاصہ اعداد و شمار۔
نوٹ: ان میں سے زیادہ تر فنکشنز “جنرک” ہیں، انہیں
data.frame کے علاوہ دیگر اقسام کے آبجیکٹس پر بھی استعمال
کیا جا سکتا ہے۔
چیلنج:
str(rna) کے آؤٹ پٹ کی بنیاد پر، کیا آپ درج ذیل سوالات کے
جواب دے سکتے ہیں؟
- آبجیکٹ
rnaکی کلاس کیا ہے؟ - اس آبجیکٹ میں کتنی قطاریں اور کتنی کالمیں ہیں؟
- کلاس: ڈیٹا فریم
- کتنی قطاریں: 32428، کتنی کالمیں: 19
ڈیٹا فریمز کی انڈیکسنگ اور سبسیٹنگ
ہمارے rna ڈیٹا فریم میں قطاریں اور کالم ہیں (اس کی 2
جہتیں ہیں)؛ اگر ہم اس سے کچھ مخصوص ڈیٹا نکالنا چاہتے ہیں، تو ہمیں اپنی
مطلوبہ “کوآرڈینیٹس” متعین کرنے کی ضرورت ہوتی ہے۔ پہلے قطاروں کے نمبر آتے
ہیں، جس کے بعد کالموں کے نمبر آتے ہیں۔ تاہم، نوٹ کریں کہ ان کوآرڈینیٹس
کو متعین کرنے کے مختلف طریقے مختلف کلاسز والے نتائج کا باعث بنتے
ہیں۔
R
# first element in the first column of the data frame (as a vector)
rna[1, 1]
# first element in the 6th column (as a vector)
rna[1, 6]
# first column of the data frame (as a vector)
rna[, 1]
# first column of the data frame (as a data.frame)
rna[1]
# first three elements in the 7th column (as a vector)
rna[1:3, 7]
# the 3rd row of the data frame (as a data.frame)
rna[3, ]
# equivalent to head_rna <- head(rna)
head_rna <- rna[1:6, ]
head_rna
: ایک خصوصی فنکشن ہے جو بڑھتے ہوئے یا کم ہوتے ہوئے ترتیب
میں صحیح اعداد کے ویکٹرز تیار کرتا ہے، مثال کے طور پر 1:10
اور 10:1 کو آزمائیں۔ تفصیلات کے لیے سیکشن ویکٹرز کی تخلیق
دیکھیں۔
آپ “-” علامت کا استعمال کرتے ہوئے ڈیٹا فریم کے مخصوص
انڈیکسز کو بھی خارج کر سکتے ہیں:
R
rna[, -1]          ## The whole data frame, except the first column
rna[-c(7:66465), ] ## Equivalent to head(rna)
ڈیٹا فریمز کو انڈیکسز کال کر کے (جیسا کہ پہلے دکھایا گیا ہے)، یا ان کے کالم کے ناموں کو براہِ راست کال کر کے بھی سب سیٹ کیا جا سکتا ہے:
R
rna["gene"]       # Result is a data.frame
rna[, "gene"]     # Result is a vector
rna[["gene"]]     # Result is a vector
rna$gene          # Result is a vector
RStudio میں، آپ کالموں کے مکمل اور درست نام حاصل کرنے کے لیے آٹو کمپلیشن فیچر کا استعمال کر سکتے ہیں۔
چیلنج
ایک
data.frame(rna_200) بنائیں جس میں صرفrnaڈیٹا سیٹ کی قطار 200 کا ڈیٹا ہو۔غور کریں کہ
nrow()نے آپ کوdata.frameمیں قطاروں کی تعداد کیسے دی؟
اس نمبر کا استعمال کرتے ہوئے ابتدائی
rnaڈیٹا فریم سے صرف اس آخری قطار کو نکالیں۔اس کا موازنہ
tail()کے ذریعے اس سے کریں جو آپ کو آخری قطار لگتا ہے، تاکہ یقینی بنایا جا سکے کہ یہ توقعات کے مطابق ہے۔قطار کے نمبر کے بجائے
nrow()کا استعمال کرتے ہوئے اس آخری قطار کو نکالیں۔اس آخری قطار سے ایک نیا ڈیٹا فریم (
rna_last) بنائیں۔
nrow()کا استعمال کرتے ہوئےrnaڈیٹا فریم کے درمیان میں موجود قطار کو نکالیں۔ اس قطار کے مواد کوrna_middleنامی ایک آبجیکٹ میں محفوظ کریں۔nrow()کو اوپر دی گئی-نوٹیشن کے ساتھ ملا کرhead(rna)کے رویے کو دوبارہ پیدا کریں، اور rna ڈیٹا سیٹ کی صرف پہلی سے چھٹی قطار تک کو برقرار رکھیں۔
R
## 1.
rna_200 <- rna[200, ]
## 2.
## Saving `n_rows` to improve readability and reduce duplication
n_rows <- nrow(rna)
rna_last <- rna[n_rows, ]
## 3.
rna_middle <- rna[n_rows / 2, ]
## 4.
rna_head <- rna[-(7:n_rows), ]
فیکٹرز
فیکٹرز کیٹیگوریکل ڈیٹا کی نمائندگی کرتے ہیں۔ انہیں لیبلز سے منسلک صحیح اعداد کے طور پر محفوظ کیا جاتا ہے اور یہ ترتیب دیے ہوئے یا غیر ترتیب دیے ہوئے ہو سکتے ہیں۔ اگرچہ فیکٹرز دیکھنے میں (اور اکثر رویے میں بھی) کیریکٹر ویکٹرز کی طرح ہوتے ہیں، لیکن R انہیں دراصل صحیح اعداد کے ویکٹرز کے طور پر سمجھتا ہے۔ لہٰذا، انہیں اسٹرنگز کے طور پر استعمال کرتے وقت آپ کو بہت احتیاط برتنی ہوگی۔
ایک بار بنائے جانے کے بعد، فیکٹرز میں صرف پہلے سے متعین کردہ اقدار کا ایک مجموعہ ہو سکتا ہے، جسے لیولز کہا جاتا ہے۔ ڈیفالٹ طور پر، R ہمیشہ لیولز کو حروفِ تہجی کی ترتیب میں ترتیب دیتا ہے۔ مثال کے طور پر، اگر آپ کے پاس 2 لیولز والا ایک فیکٹر ہو:
R
sex <- factor(c("male", "female", "female", "male", "female"))
R لیول "female" کو 1 اور لیول
"male" کو 2 تفویض کرے گا (کیونکہ
f، m سے پہلے آتا ہے، اگرچہ اس ویکٹر کا پہلا
عنصر "male" ہے)۔ آپ اسے فانکشن levels()
استعمال کر کے دیکھ سکتے ہیں اور لیولز کی تعداد nlevels() کے
ذریعے معلوم کر سکتے ہیں:
R
levels(sex)
OUTPUT
[1] "female" "male" R
nlevels(sex)
OUTPUT
[1] 2کبھی کبھی فیکٹرز کی ترتیب اہمیت نہیں رکھتی، تو کبھی آپ ترتیب کا تعین
کرنا چاہیں گے کیونکہ وہ معنی رکھتی ہو (مثلاً، “low”، “medium”، “high”)،
یا یہ آپ کی ویژولائزیشن کو بہتر بناتی ہے، یا کسی خاص قسم کے تجزیے کے لیے
ضروری ہوتی ہے۔ یہاں، sex ویکٹر میں اپنے لیولز کی ترتیب
بدلنے کا ایک طریقہ یہ ہو سکتا ہے:
R
sex ## current order
OUTPUT
[1] male   female female male   female
Levels: female male
R
sex <- factor(sex, levels = c("male", "female"))
sex ## after re-ordering
OUTPUT
[1] male   female female male   female
Levels: male female
R کی میموری میں، یہ فیکٹرز صحیح اعداد (1, 2, 3) کے ذریعے ظاہر کیے
جاتے ہیں، لیکن یہ صحیح اعداد کے مقابلے میں زیادہ معلوماتی ہوتے ہیں
کیونکہ فیکٹرز خود بیانی ہوتے ہیں: "female" اور
"male"، 1 اور 2 کے مقابلے میں
زیادہ وضاحتی ہیں۔ کون سا “male” (نر) ہے؟ آپ صرف صحیح اعداد کے ڈیٹا سے یہ
بتا نہیں سکتے۔ دوسری طرف، فیکٹرز میں یہ معلومات پہلے سے موجود ہوتی ہیں۔
یہ خاص طور پر تب مددگار ہوتا ہے جب لیولز کی تعداد زیادہ ہو (جیسے ہمارے
مثالی ڈیٹا سیٹ میں جین کی بائیو ٹائپ)۔
جب آپ کا ڈیٹا ایک فیکٹر کے طور پر محفوظ ہو، تو آپ ہر فیکٹر لیول کے
ذریعے ظاہر ہونے والے مشاہدات کی تعداد کا فوری جائزہ لینے کے لیے
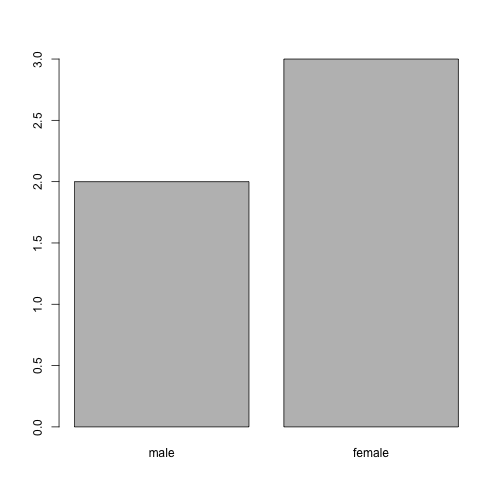
plot() فنکشن استعمال کر سکتے ہیں۔ آئیے اپنے ڈیٹا میں نر اور
مادہ کی تعداد دیکھتے ہیں۔
R
plot(sex)
کیریکٹر میں تبدیل کرنا
اگر آپ کو کسی فیکٹر کو کیریکٹر ویکٹر میں تبدیل کرنے کی ضرورت ہو، تو
آپ as.character(x) استعمال کرتے ہیں۔
R
as.character(sex)
OUTPUT
[1] "male" "female" "female" "male" "female"فیکٹرز کے نام تبدیل کرنا
اگر ہم ان فیکٹرز کے نام تبدیل کرنا چاہتے ہیں، تو ان کی لیولز کو تبدیل کرنا کافی ہے:
R
levels(sex)
OUTPUT
[1] "male" "female"R
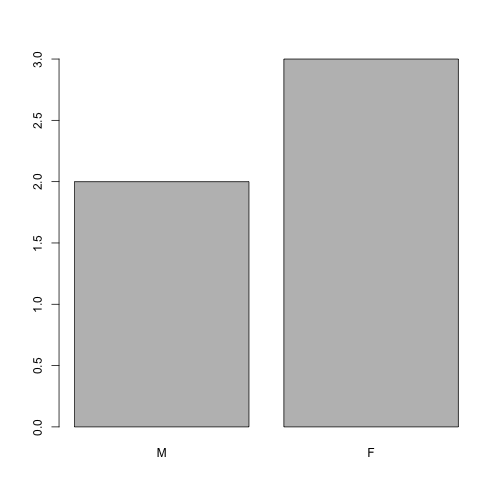
levels(sex) <- c("M", "F")
sex
OUTPUT
[1] M F F M F
Levels: M F
R
plot(sex)
چیلنج:
- “F” اور “M” کے ناموں کو بالترتیب “Female” اور “Male” میں تبدیل کریں۔
R
levels(sex)
OUTPUT
[1] "M" "F"R
levels(sex) <- c("Male", "Female")
چیلنج:
ہم نے دیکھا ہے کہ read.csv() استعمال کرتے ہوئے ڈیٹا
فریمز کیسے بنائے جاتے ہیں، لیکن انہیں data.frame() فنکشن کے
ذریعے دستی طور پر بھی بنایا جا سکتا ہے۔ اس دستی طور پر تیار کردہ
data.frame میں کچھ غلطیاں ہیں۔ کیا آپ انہیں پہچان کر درست
کر سکتے ہیں؟ آزمائش کرنے میں ہچکچاہٹ محسوس نہ کریں!
- جانوروں کے ناموں کے گرد اقتباسی نشانات کی کمی
- “feel” کالم میں ایک اندراج غائب ہے (غالباً کسی روئیں دار جانور کے لیے)
- وزن کے کالم میں ایک کوما غائب ہے
چیلنج:
کیا آپ درج ذیل مثال میں ہر کالم کی کلاس کا اندازہ لگا سکتے ہیں؟
اپنے اندازوں کی تصدیق str(country_climate) کے ذریعے
کریں:
کیا یہ وہی ہیں جن کی آپ نے توقع کی تھی؟ کیوں؟ کیوں نہیں؟
ڈیٹا فریم بناتے وقت آخری ویری ایبل کے بعد
stringsAsFactors = TRUEشامل کر کے دوبارہ کوشش کریں۔ اب کیا ہو رہا ہے؟read.csv()کا استعمال کرتے ہوئے ٹیکسٹ پر مبنی اسپریڈشیٹس کو R میں ریڈ کرتے وقتstringsAsFactorsکو بھی سیٹ کیا جا سکتا ہے۔
R
country_climate <- data.frame(
       country = c("Canada", "Panama", "South Africa", "Australia"),
       climate = c("cold", "hot", "temperate", "hot/temperate"),
       temperature = c(10, 30, 18, "15"),
       northern_hemisphere = c(TRUE, TRUE, FALSE, "FALSE"),
       has_kangaroo = c(FALSE, FALSE, FALSE, 1)
       )
R
country_climate <- data.frame(
       country = c("Canada", "Panama", "South Africa", "Australia"),
       climate = c("cold", "hot", "temperate", "hot/temperate"),
       temperature = c(10, 30, 18, "15"),
       northern_hemisphere = c(TRUE, TRUE, FALSE, "FALSE"),
       has_kangaroo = c(FALSE, FALSE, FALSE, 1)
       )
str(country_climate)
OUTPUT
'data.frame':	4 obs. of  5 variables:
 $ country            : chr  "Canada" "Panama" "South Africa" "Australia"
 $ climate            : chr  "cold" "hot" "temperate" "hot/temperate"
 $ temperature        : chr  "10" "30" "18" "15"
 $ northern_hemisphere: chr  "TRUE" "TRUE" "FALSE" "FALSE"
 $ has_kangaroo       : num  0 0 0 1
ڈیٹا کی قسم کی خودکار تبدیلی کبھی فائدہ مند ہوتی ہے اور کبھی پریشان کن۔ اس بات کا خیال رکھیں کہ یہ سہولت موجود ہے، اس کے قواعد سیکھیں، اور دوبارہ چیک کریں کہ R میں آپ کے امپورٹ کیے گئے ڈیٹا آپ کے ڈیٹا فریم میں درست قسم کے ہیں۔ اگر ایسا نہیں ہے، تو اسے اپنے فائدے کے لیے استعمال کریں تاکہ ان غلطیوں کا پتہ لگایا جا سکے جو ڈیٹا انٹری کے دوران ہو سکتی ہیں (مثال کے طور پر، کسی کالم میں ایک حرف جو صرف اعداد پر مشتمل ہونا چاہیے)۔
مزید معلومات کے لیے اس RStudio ٹیوٹوریل کو دیکھیں۔
میٹرکسز
آگے بڑھنے سے پہلے، اب جب کہ ہم نے ڈیٹا فریمز کے بارے میں سیکھ لیا ہے،
آئیے پیکیج انسٹالیشن کا جائزہ لیں اور ایک نئی ڈیٹا ٹائپ، یعنی
matrix کے بارے میں جانیں۔ data.frame کی طرح،
ایک میٹرکس کے دو ابعاد ہوتے ہیں، قطاریں اور کالم۔ لیکن بڑا فرق یہ ہے کہ
matrix کے تمام سیلز ایک ہی ٹائپ کے ہونے چاہئیں:
numeric، character، logical، … اس
لحاظ سے، میٹرکسز data.frame کے مقابلے میں
vector کے زیادہ قریب ہیں۔
میٹرکس کا ڈیفالٹ کنسٹرکٹر matrix ہے۔ یہ میٹرکس کو بھرنے
کے لیے اقدار کا ایک ویکٹر اور قطاروں اور/یا کالموں کی تعداد1 لیتا ہے۔
اقدار کالم وار بھری جاتی ہیں، جیسا کہ نیچے دکھایا گیا ہے۔
R
m <- matrix(1:9, ncol = 3, nrow = 3)
m
OUTPUT
     [,1] [,2] [,3]
[1,]    1    4    7
[2,]    2    5    8
[3,] 3 6 9چیلنج:
فانکشن installed.packages() کا استعمال کرتے ہوئے، ایک
character میٹرکس بنائیں جس میں آپ کے کمپیوٹر پر فی الحال
انسٹال شدہ تمام پیکیجز کے بارے میں معلومات شامل ہوں۔ اس کا جائزہ
لیں۔
R
## create the matrix
ip <- installed.packages()
head(ip)
## try also View(ip)
## number of package
nrow(ip)
## names of all installed packages
rownames(ip)
## type of information we have about each package
colnames(ip)
ٹیسٹ ڈیٹا کے طور پر بڑے رینڈم ڈیٹا میٹرکسز بنانا اکثر مفید ہوتا ہے۔
نیچے دیا گیا مشق آپ سے ایسا میٹرکس بنانے کا کہتا ہے جس میں ایک اوسط 0
اور اسٹینڈرڈ ڈیوی ایشن 1 والی نارمل تقسیم سے لیے گئے رینڈم ڈیٹا ہوں، جو
rnorm() فنکشن کے ذریعے کیا جا سکتا ہے۔
چیلنج:
نارمل طور پر تقسیم شدہ ڈیٹا (میان 0، اسٹینڈرڈ ڈیوی ایشن 1) کا 1000 ضرب 3 کا ایک میٹرکس تیار کریں۔
R
set.seed(123)
m <- matrix(rnorm(3000), ncol = 3)
dim(m)
OUTPUT
[1] 1000 3R
head(m)
OUTPUT
            [,1]        [,2]       [,3]
[1,] -0.56047565 -0.99579872 -0.5116037
[2,] -0.23017749 -1.03995504  0.2369379
[3,]  1.55870831 -0.01798024 -0.5415892
[4,]  0.07050839 -0.13217513  1.2192276
[5,]  0.12928774 -2.54934277  0.1741359
[6,]  1.71506499  1.04057346 -0.6152683
تاریخوں کی فارمیٹنگ
نئے (اور تجربہ کار!) R صارفین کو جو سب سے عام مسائل کا سامنا کرنا پڑتا ہے، وہ ڈیٹ اور وقت کی معلومات کو ایک ایسے ویری ایبل میں تبدیل کرنا ہے جو تجزیوں کے دوران مناسب اور قابلِ استعمال ہو۔
اسپریڈشیٹ پروگراموں میں تاریخوں کے بارے میں نوٹ
اسپریڈشیٹس میں تاریخیں عام طور پر ایک ہی کالم میں محفوظ کی جاتی ہیں۔ اگرچہ تاریخیں درج کرنے کا یہ سب سے فطری طریقہ معلوم ہوتا ہے، لیکن دراصل یہ بہترین طریقہ کار نہیں ہے۔ ایک اسپریڈشیٹ ایپلی کیشن تاریخوں کو ایسے ظاہر کرے گی جو (ایک انسانی ناظر کے لیے) درست معلوم ہوں، لیکن اس کا تاریخوں کو اصل میں کس طرح ہینڈل کرنا اور محفوظ کرنا مسئلہ بن سکتا ہے۔ اکثر یہ کہیں زیادہ محفوظ ہوتا ہے کہ تاریخوں کو YEAR، MONTH اور DAY کے الگ الگ کالموں میں یا YEAR اور DAY-OF-YEAR کے الگ الگ کالموں میں محفوظ کیا جائے۔
اسپریڈشیٹ پروگرامز جیسے کہ LibreOffice، Microsoft Excel، OpenOffice، Gnumeric، … تاریخوں کو انکوڈ کرنے کے مختلف (اور اکثر غیر ہم آہنگ) طریقے رکھتے ہیں (یہاں تک کہ ایک ہی پروگرام کے مختلف ورژنز اور آپریٹنگ سسٹمز کے درمیان بھی)۔ مزید برآں، Excel ایسی چیزوں کو تاریخوں میں تبدیل کر سکتا ہے جو تاریخ نہیں ہیں ( Zeeberg et al. (2004) )، مثال کے طور پر MAR1، DEC1، OCT4 جیسے نام یا شناختی علامتیں۔ لہٰذا، اگر آپ مجموعی طور پر تاریخ کے فارمیٹ سے گریز کر رہے ہیں، تو ان مسائل کی شناخت کرنا آسان ہو جاتا ہے۔
Data Carpentry اسباق کے Dates as data سیکشن میں اسپریڈشیٹس میں تاریخوں سے وابستہ ممکنہ غلطیوں کے بارے میں مزید معلومات فراہم کی گئی ہیں۔
ہم پیکیج lubridate سے
ymd() فنکشن استعمال کریں گے (جو
tidyverse کا حصہ ہے؛ مزید معلومات tidyverse ویب سائٹ پر حاصل کریں)۔
lubridate
tidyverse کی انسٹالیشن کے حصے کے طور پر
انسٹال ہو جاتا ہے۔ جب آپ tidyverse
(library(tidyverse)) کو لوڈ کرتے ہیں، تو کور پیکیجز (وہ
پیکیجز جو زیادہ تر ڈیٹا تجزیوں میں استعمال ہوتے ہیں) لوڈ ہو جاتے ہیں۔
تاہم، lubridate کور tidyverse کا حصہ نہیں
ہے، اس لیے آپ کو اسے library(lubridate) کے ذریعے واضح طور
پر لوڈ کرنا ہوگا۔
پہلے ضروری پیکیج لوڈ کریں:
R
library("lubridate")
ymd() سال، مہینے اور دن کی نمائندگی کرنے والے ایک ویکٹر
کو لیتا ہے، اور اسے Date ویکٹر میں تبدیل کر دیتا ہے۔
Date ڈیٹا کی ایک ایسی کلاس ہے جسے R تاریخ کے طور پر پہچانتا
ہے اور اس کے ساتھ اسی طرح کام کیا جا سکتا ہے۔ فانکشن کے لیے مطلوبہ
آرگومنٹ لچکدار ہے، لیکن بہترین طریقہ کار کے طور پر، یہ “YYYY-MM-DD”
فارمیٹ میں ایک کریکٹر ویکٹر ہوتا ہے۔
آئیے ایک ڈیٹ آبجیکٹ بنائیں اور اس کی ساخت کا جائزہ لیں:
R
my_date <- ymd("2015-01-01")
str(my_date)
OUTPUT
Date[1:1], format: "2015-01-01"اب آئیے سال، مہینہ اور دن کو الگ الگ پیسٹ کریں - ہمیں وہی نتیجہ ملتا ہے:
R
# sep indicates the character to use to separate each component
my_date <- ymd(paste("2015", "1", "1", sep = "-"))
str(my_date)
OUTPUT
Date[1:1], format: "2015-01-01"آئیے اب ایک عام ڈیٹ مینیپولیشن پائپ لائن سے واقف ہوتے ہیں۔ نیچے دیے
گئے چھوٹے ڈیٹا میں تاریخیں مختلف year، month
اور day کالمز میں محفوظ کی گئی ہیں۔
R
x <- data.frame(year = c(1996, 1992, 1987, 1986, 2000, 1990, 2002, 1994, 1997, 1985),
                month = c(2,  3,  3, 10,  1,  8,  3,  4,  5,  5),
                day = c(24,  8,  1,  5,  8, 17, 13, 10, 11, 24),
                value = c(4,  5,  1,  9,  3,  8, 10,  2,  6,  7))
x
OUTPUT
   year month day value
1  1996     2  24     4
2  1992     3   8     5
3  1987     3   1     1
4  1986    10   5     9
5  2000     1   8     3
6  1990     8  17     8
7  2002     3  13    10
8  1994     4  10     2
9  1997     5  11     6
10 1985     5  24     7
اب ہم اس فنکشن کو x ڈیٹا سیٹ پر لاگو کرتے ہیں۔ ہم پہلے
paste() کا استعمال کرتے ہوئے x کے
year، month، اور day کالمز سے ایک
کریکٹر ویکٹر تیار کرتے ہیں:
R
paste(x$year, x$month, x$day, sep = "-")
OUTPUT
 [1] "1996-2-24" "1992-3-8"  "1987-3-1"  "1986-10-5" "2000-1-8"  "1990-8-17"
 [7] "2002-3-13" "1994-4-10" "1997-5-11" "1985-5-24"
اس کریکٹر ویکٹر کو ymd() کے لیے آرگومنٹ کے طور پر
استعمال کیا جا سکتا ہے:
R
ymd(paste(x$year, x$month, x$day, sep = "-"))
OUTPUT
 [1] "1996-02-24" "1992-03-08" "1987-03-01" "1986-10-05" "2000-01-08"
 [6] "1990-08-17" "2002-03-13" "1994-04-10" "1997-05-11" "1985-05-24"
حاصل شدہ Date ویکٹر کو x میں
date نامی ایک نئے کالم کے طور پر شامل کیا جا سکتا ہے:
R
x$date <- ymd(paste(x$year, x$month, x$day, sep = "-"))
str(x) # notice the new column, with 'date' as the class
OUTPUT
'data.frame':	10 obs. of  5 variables:
 $ year : num  1996 1992 1987 1986 2000 ...
 $ month: num  2 3 3 10 1 8 3 4 5 5
 $ day  : num  24 8 1 5 8 17 13 10 11 24
 $ value: num  4 5 1 9 3 8 10 2 6 7
 $ date : Date, format: "1996-02-24" "1992-03-08" ...
آئیے یقینی بنائیں کہ سب کچھ درست طریقے سے کام کر گیا ہے۔ نئے کالم کا
معائنہ کرنے کا ایک طریقہ summary() استعمال کرنا ہے:
R
summary(x$date)
OUTPUT
        Min.      1st Qu.       Median         Mean      3rd Qu.         Max.
"1985-05-24" "1988-01-11" "1993-03-24" "1993-03-18" "1997-01-20" "2002-03-13"
نوٹ کریں کہ ymd() کے لیے سال، مہینہ اور دن، اسی ترتیب
میں ہونا ضروری ہے۔ اگر آپ کے پاس، مثال کے طور پر، دن، مہینہ اور سال ہو،
تو آپ کو dmy() کی ضرورت ہوگی۔
R
dmy(paste(x$day, x$month, x$year, sep = "-"))
OUTPUT
 [1] "1996-02-24" "1992-03-08" "1987-03-01" "1986-10-05" "2000-01-08"
 [6] "1990-08-17" "2002-03-13" "1994-04-10" "1997-05-11" "1985-05-24"
lubdridate میں تاریخ کی تمام تبدیلیوں سے نمٹنے کے لیے
بہت سے فنکشنز موجود ہیں۔
R آبجیکٹس کا خلاصہ
اب تک، ہم نے R آبجیکٹس کی کئی اقسام دیکھی ہیں جو جہتوں کی تعداد اور اس بات میں مختلف ہیں کہ وہ ایک یا متعدد ڈیٹا اقسام کو محفوظ کر سکتے ہیں یا نہیں:
-
vector: ایک جہت (ان کی ایک لمبائی ہوتی ہے)، ڈیٹا کی ایک ہی قسم۔ -
matrix: دو جہتیں، ڈیٹا کی ایک ہی قسم۔ -
data.frame: دو جہتیں، ہر کالم میں ایک قسم۔
لسٹس
ایک ڈیٹا ٹائپ جسے ہم نے ابھی تک نہیں دیکھا، لیکن اسے جاننا مفید ہے، اور جو ہمارے ابھی دیکھے گئے خلاصے سے ظاہر ہوتا ہے، وہ ہے لسٹس:
-
list: ایک جہت، ہر آئٹم کی ڈیٹا ٹائپ مختلف ہو سکتی ہے۔
ذیل میں، آئیے ایک ایسی لسٹ بنائیں جس میں اعداد کا ایک ویکٹر، حروف، ایک میٹرکس، ایک ڈیٹا فریم اور ایک اور لسٹ شامل ہو:
R
l <- list(1:10, ## numeric
          letters, ## character
          installed.packages(), ## a matrix
          cars, ## a data.frame
          list(1, 2, 3)) ## a list
length(l)
OUTPUT
[1] 5R
str(l)
OUTPUT
List of 5
 $ : int [1:10] 1 2 3 4 5 6 7 8 9 10
 $ : chr [1:26] "a" "b" "c" "d" ...
 $ : chr [1:261, 1:17] "litedown" "metabolomicsWorkbenchR" "mgcv" "MultiAssayExperiment" ...
  ..- attr(*, "dimnames")=List of 2
  .. ..$ : chr [1:261] "litedown" "metabolomicsWorkbenchR" "mgcv" "MultiAssayExperiment" ...
  .. ..$ : chr [1:17] "Package" "LibPath" "Version" "Priority" ...
 $ :'data.frame':	50 obs. of  2 variables:
  ..$ speed: num [1:50] 4 4 7 7 8 9 10 10 10 11 ...
  ..$ dist : num [1:50] 2 10 4 22 16 10 18 26 34 17 ...
 $ :List of 3
  ..$ : num 1
  ..$ : num 2
  ..$ : num 3
لسٹ کی سب سیٹنگ [] کے ذریعے ایک نئی سب لسٹ بنانے کے لیے
یا [[]] کے ذریعے اس لسٹ کا ایک ایکل ایلیمنٹ نکالنے کے لیے
کی جاتی ہے (انڈیکسز یا ناموں کا استعمال کرتے ہوئے، اگر لسٹ کا نام
ہو)۔
R
l[[1]] ## first element
OUTPUT
[1] 1 2 3 4 5 6 7 8 9 10R
l[1:2] ## a list of length 2
OUTPUT
[[1]]
 [1]  1  2  3  4  5  6  7  8  9 10

[[2]]
 [1] "a" "b" "c" "d" "e" "f" "g" "h" "i" "j" "k" "l" "m" "n" "o" "p" "q" "r" "s"
[20] "t" "u" "v" "w" "x" "y" "z"
R
l[1] ## a list of length 1
OUTPUT
[[1]]
 [1]  1  2  3  4  5  6  7  8  9 10
ٹیبلر ڈیٹا کی ایکسپورٹنگ اور سیونگ
ہم نے دیکھا ہے کہ read.table فانکشنز کے خاندان کا
استعمال کرتے ہوئے ایک ٹیکسٹ بیسڈ اسپریڈشیٹ کو R میں کیسے پڑھا جائے۔ ایک
data.frame کو ٹیکسٹ بیسڈ اسپریڈشیٹ میں ایکسپورٹ کرنے کے
لیے، ہم write.table فانکشنز کے سیٹ (write.csv،
write.delim، …) کا استعمال کر سکتے ہیں۔ یہ تمام فانکشنز
ایکسپورٹ کیے جانے والے ویری ایبل اور اس فائل کو آرگومنٹس کے طور پر لیتے
ہیں جس میں ڈیٹا محفوظ کیا جانا ہے۔ مثال کے طور پر، rna ڈیٹا
کو data_output ڈائریکٹری میں my_rna.csv فائل
میں ایکسپورٹ کرنے کے لیے، ہم درج ذیل کمانڈ چلائیں گے:
R
write.csv(rna, file = "data_output/my_rna.csv")
اس نئی csv فائل کو اب ان دیگر تعاون کرنے والوں کے ساتھ شیئر کیا جا
سکتا ہے جو R سے واقف نہیں ہیں۔ نوٹ کریں کہ اگرچہ data.frame
کے کچھ فیلڈز میں کومے موجود ہیں (مثال کے طور پر “product” کالم دیکھیں)،
لیکن R ڈیفالٹ طور پر ہر فیلڈ کو کوٹس میں لپیٹ دے گا، اور اس طرح ہم اسے
دوبارہ R میں درست طریقے سے پڑھ سکیں گے، باوجود اس کے کہ کالم کے علامت کے
طور پر کومے کا استعمال بھی کیا گیا ہے۔
- R میں ٹیبل ڈیٹا
قطاروں یا کالموں میں سے کوئی ایک کی تعداد کافی ہے، کیونکہ دوسرے کا اندازہ اقدار کی لمبائی سے لگایا جا سکتا ہے۔ آزما کر دیکھیں کہ اگر اقدار کی تعداد میٹرکس کی متعین جہتوں سے مطابقت نہ رکھے تو کیا ہوتا ہے۔↩︎