
dplyr کے ذریعے ڈیٹا کی ترتیب و تیاری اور تجزیہ
Last updated on 2026-11-11 | Edit this page
Estimated time: 150 minutes
Overview
Questions
- tidyverse میٹا-پیکیج کا استعمال کرتے ہوئے R میں ڈیٹا تجزیہ
Objectives
-
dplyrاورtidyrپیکجز کے مقصد کی وضاحت کریں۔ - ان کے ان کئی ایسے فنکشنز کی وضاحت کریں جو ڈیٹا کی مانیپولیشن کے لیے انتہائی مفید ہیں۔
- وائڈ اور لانگ ٹیبل فارمیٹ کے تصور کی وضاحت کریں، اور دیکھیں کہ ایک ڈیٹا فریم کو ایک فارمیٹ سے دوسرے میں کیسے تبدیل کیا جائے۔
- دکھائیں کہ ٹیبلز کو کیسے جوڑا جائے۔
یہ ایپیسوڈ Data Carpentries کے Data Analysis and Visualisation in R for Ecologists اسباق پر مبنی ہے۔
dplyr اور
tidyr کے ذریعے ڈیٹا کی ترتیب و تیاری
بریکٹ سبسیٹنگ مفید ہے، لیکن یہ پیچیدہ اور پڑھنے میں مشکل ہو سکتی ہے، خاص طور پر پیچیدہ آپریشنز کے لیے۔
ڈیٹا کی ترتیب و تیاری کے دوران کچھ پیکیجز ہمارے کام کو نمایاں طور پر
آسان بنا سکتے ہیں۔ R میں پیکیجز بنیادی طور پر اضافی فنکشنز کے مجموعے
ہوتے ہیں جو آپ کو مزید کام کرنے کے قابل بناتے ہیں۔ جن فنکشنز کا ہم اب تک
استعمال کر رہے ہیں، جیسے کہ str() یا
data.frame()، R میں پہلے سے موجود ہوتے ہیں؛ پیکیجز کو لوڈ
کرنے سے آپ کو دیگر مخصوص فنکشنز تک رسائی مل سکتی ہے۔ کسی پیکیج کو پہلی
بار استعمال کرنے سے پہلے آپ کو اسے اپنے مشین پر انسٹال کرنا ہوگا، اور
پھر ہر بعد کے R سیشن میں جب بھی اس کی ضرورت ہو، آپ کو اسے امپورٹ کرنا
چاہیے۔
پیکیج
dplyrڈیٹا کی ترتیب و تیاری کے کاموں کے لیے طاقتور ٹولز فراہم کرتا ہے۔ اسے براہِ راست ڈیٹا فریمز کے ساتھ کام کرنے کے لیے بنایا گیا ہے، جس میں بہت سے ترتیب و تیاری کے کاموں کو بہتر بنایا گیا ہے۔جیسا کہ ہم بعد میں دیکھیں گے، کبھی کبھی ہم چاہتے ہیں کہ کسی مخصوص تجزیوں کے لیے یا بصری نمائش کے لیے ڈیٹا فریم کی شکل تبدیل کی جائے۔ پیکیج
tidyrڈیٹا کی شکل تبدیل کرنے کے اس عام مسئلے کو حل کرتا ہے اور ڈیٹا کو منظم طریقے سے مینیپولیٹ کرنے کے لیے ٹولز فراہم کرتا ہے۔
ورکشاپ کے بعد dplyr اور
tidyr کے بارے میں مزید جاننے کے لیے، آپ اس
dplyr
کے ساتھ ڈیٹا کی تبدیلی کی مفید چیٹ شیٹ اور اس tidyr
سے متعلق چیٹ شیٹ کو دیکھ سکتے ہیں۔
-
tidyverseپیکیج ایک “امبریلا پیکیج” ہے جو ڈیٹا تجزیے کے لیے کئی مفید پیکیجز انسٹال کرتا ہے جو ایک ساتھ بہتر طریقے سے کام کرتے ہیں، جیسے کہtidyr،dplyr،ggplot2،tibbleوغیرہ۔ یہ پیکیجز ہمیں ڈیٹا پر کام کرنے اور اس کے ساتھ تعامل کرنے میں مدد دیتے ہیں۔ یہ ہمیں آپ کے ڈیٹا کے ساتھ بہت سی کامیابیاں انجام دینے کے قابل بناتے ہیں، جیسے کہ سب سیٹنگ، تبدیلی، بصری شکل دینا وغیرہ۔
اگر آپ نے سیٹ اپ کر لیا ہے، تو آپ کو پہلے ہی tidyverse پیکیج انسٹال کر دیا ہوگا۔ اس بات کی تصدیق کرنے کے لیے کہ آیا یہ آپ کے پاس ہے، لائبریری سے لوڈ کرنے کی کوشش کریں:
R
## load the tidyverse packages, incl. dplyr
library("tidyverse")
اگر آپ کو ایرر میسج
there is no package called ‘tidyverse’ ملا ہے، تو اس معاملے
میں آپ نے ابھی تک R کے اس ورژن کے لیے پیکیج انسٹال نہیں کیا ہے۔
tidyverse پیکیج انسٹال کرنے کے لیے درج ذیل
ٹائپ کریں:
R
BiocManager::install("tidyverse")
اگر آپ کو tidyverse پیکج انسٹال کرنا
پڑا ہے، تو اس R سیشن میں اوپر دیے گئے library() کمانڈ کے
ذریعے اسے لوڈ کرنا نہ بھولیں!
tidyverse کے ذریعے ڈیٹا لوڈ کرنا
read.csv() کے بجائے، ہم tidyverse پیکیج
readr سے read_csv() فنکشن
(نوٹ کریں کہ . کے بجائے _ استعمال کیا گیا ہے)
کے ذریعے اپنا ڈیٹا پڑھیں گے۔
R
rna <- read_csv("data/rnaseq.csv")

## view the data
rna
OUTPUT
# A tibble: 32,428 × 19
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…       1170 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 Apod    GSM254…      36194 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 3 Cyp2d22 GSM254…       4060 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 4 Klk6    GSM254…        287 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 5 Fcrls   GSM254…         85 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 6 Slc2a4  GSM254…        782 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 7 Exd2    GSM254…       1619 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 Gjc2    GSM254…        288 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 9 Plp1    GSM254…      43217 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
10 Gnb4    GSM254…       1071 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
نوٹ کریں کہ ڈیٹا کی کلاس کو اب “tibble” کہا جاتا ہے۔
ٹیبلز (Tibbles) ان ڈیٹا فریم آبجیکٹس کے کچھ رویوں میں تبدیلی لاتے ہیں جن کا تعارف ہم نے پہلے کیا تھا۔ ان کی ڈیٹا اسٹرکچر ایک ڈیٹا فریم سے بہت مشابہ ہے۔ ہمارے مقاصد کے لیے واحد فرق یہ ہیں کہ:
یہ ہر کالم کے نام کے نیچے اس کی ڈیٹا ٹائپ ظاہر کرتا ہے۔ نوٹ کریں کہ <
dbl> ایک ایسی ڈیٹا ٹائپ ہے جسے اعشاریہ کے نشان والی عددی اقدار رکھنے کے لیے تعریف کیا گیا ہے۔یہ ڈیٹا کی صرف پہلی چند قطاریں اور صرف اتنی کالمیں پرنٹ کرتا ہے جتنی ایک اسکرین پر سما جائیں۔
اب ہم کچھ سب سے زیادہ عام dplyr فانکشنز
سیکھنے جا رہے ہیں:
-
select(): کالمز کا ذیلی مجموعہ -
filter(): شرائط کی بنیاد پر قطاروں کا ذیلی مجموعہ تیار کریں -
mutate(): دیگر کالموں سے حاصل شدہ معلومات کا استعمال کرتے ہوئے نئے کالم تخلیق کریں -
group_by()اورsummarise(): گروپ شدہ ڈیٹا پر خلاصہ اعداد و شمار تیار کریں -
arrange(): نتائج کو ترتیب دیں -
count(): ڈسکریٹ ویلیوز کی گنتی کریں
کالمز کا انتخاب اور قطاروں کی فلٹرنگ
ڈیٹا فریم کے کالمز کا انتخاب کرنے کے لیے، select()
استعمال کریں۔ اس فنکشن کا پہلا آرگومنٹ ڈیٹا فریم (rna) ہے،
اور بعد کے آرگومنٹس وہ کالمز ہیں جنہیں برقرار رکھنا ہے۔
R
select(rna, gene, sample, tissue, expression)
OUTPUT
# A tibble: 32,428 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545336 Cerebellum       1170
 2 Apod    GSM2545336 Cerebellum      36194
 3 Cyp2d22 GSM2545336 Cerebellum       4060
 4 Klk6    GSM2545336 Cerebellum        287
 5 Fcrls   GSM2545336 Cerebellum         85
 6 Slc2a4  GSM2545336 Cerebellum        782
 7 Exd2    GSM2545336 Cerebellum       1619
 8 Gjc2    GSM2545336 Cerebellum        288
 9 Plp1    GSM2545336 Cerebellum      43217
10 Gnb4    GSM2545336 Cerebellum       1071
# ℹ 32,418 more rows
کچھ مخصوص کالموں کے علاوہ تمام کالموں کو منتخب کرنے کے لیے، ویری ایبل کے سامنے “-” لگائیں تاکہ اسے خارج کیا جا سکے۔
R
select(rna, -tissue, -organism)
OUTPUT
# A tibble: 32,428 × 17
   gene    sample   expression   age sex   infection strain  time mouse ENTREZID
   <chr>   <chr>         <dbl> <dbl> <chr> <chr>     <chr>  <dbl> <dbl>    <dbl>
 1 Asl     GSM2545…       1170     8 Fema… Influenz… C57BL…     8    14   109900
 2 Apod    GSM2545…      36194     8 Fema… Influenz… C57BL…     8    14    11815
 3 Cyp2d22 GSM2545…       4060     8 Fema… Influenz… C57BL…     8    14    56448
 4 Klk6    GSM2545…        287     8 Fema… Influenz… C57BL…     8    14    19144
 5 Fcrls   GSM2545…         85     8 Fema… Influenz… C57BL…     8    14    80891
 6 Slc2a4  GSM2545…        782     8 Fema… Influenz… C57BL…     8    14    20528
 7 Exd2    GSM2545…       1619     8 Fema… Influenz… C57BL…     8    14    97827
 8 Gjc2    GSM2545…        288     8 Fema… Influenz… C57BL…     8    14   118454
 9 Plp1    GSM2545…      43217     8 Fema… Influenz… C57BL…     8    14    18823
10 Gnb4    GSM2545…       1071     8 Fema… Influenz… C57BL…     8    14    14696
# ℹ 32,418 more rows
# ℹ 7 more variables: product <chr>, ensembl_gene_id <chr>,
#   external_synonym <chr>, chromosome_name <chr>, gene_biotype <chr>,
#   phenotype_description <chr>, hsapiens_homolog_associated_gene_name <chr>
اس سے rna کے تمام متغیرات منتخب ہو جائیں گے، سوائے
tissue اور organism کے۔
کسی مخصوص معیار کی بنیاد پر قطاروں کا انتخاب کرنے کے لیے،
filter() استعمال کریں:
R
filter(rna, sex == "Male")
OUTPUT
# A tibble: 14,740 × 19
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…        626 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 2 Apod    GSM254…      13021 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 3 Cyp2d22 GSM254…       2171 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 4 Klk6    GSM254…        448 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 5 Fcrls   GSM254…        180 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 6 Slc2a4  GSM254…        313 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 7 Exd2    GSM254…       2366 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 8 Gjc2    GSM254…        310 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 9 Plp1    GSM254…      53126 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
10 Gnb4    GSM254…       1355 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
# ℹ 14,730 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
R
filter(rna, sex == "Male" & infection == "NonInfected")
OUTPUT
# A tibble: 4,422 × 19
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…        535 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 2 Apod    GSM254…      13668 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 3 Cyp2d22 GSM254…       2008 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 4 Klk6    GSM254…       1101 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 5 Fcrls   GSM254…        375 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 6 Slc2a4  GSM254…        249 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 7 Exd2    GSM254…       3126 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 8 Gjc2    GSM254…        791 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 9 Plp1    GSM254…      98658 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
10 Gnb4    GSM254…       2437 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
# ℹ 4,412 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
اب تصور کرتے ہیں کہ ہم اس ڈیٹا سیٹ میں تجزیہ کیے گئے ماؤس کے جینز کے
انسانی ہومولوگز میں دلچسپی رکھتے ہیں۔ یہ معلومات rna ٹبل کے
آخری کالم میں مل سکتی ہیں، جس کا نام
hsapiens_homolog_associated_gene_name ہے۔ اسے آسانی سے
دیکھنے کے لیے، ہم ایک نیا ٹیبل بنائیں گے جس میں صرف gene
اور hsapiens_homolog_associated_gene_name کے 2 کالم ہوں
گے۔
R
genes <- select(rna, gene, hsapiens_homolog_associated_gene_name)
genes
OUTPUT
# A tibble: 32,428 × 2
   gene    hsapiens_homolog_associated_gene_name
   <chr>   <chr>
 1 Asl     ASL
 2 Apod    APOD
 3 Cyp2d22 CYP2D6
 4 Klk6    KLK6
 5 Fcrls   FCRL2
 6 Slc2a4  SLC2A4
 7 Exd2    EXD2
 8 Gjc2    GJC2
 9 Plp1    PLP1
10 Gnb4    GNB4
# ℹ 32,418 more rows
کچھ چوہوں کے جینز کے کوئی انسانی ہومولوگز نہیں ہوتے۔ انہیں
filter() اور is.na() فنکشن کے ذریعے حاصل کیا
جا سکتا ہے، جو یہ تعین کرتا ہے کہ کوئی چیز NA ہے یا
نہیں۔
R
filter(genes, is.na(hsapiens_homolog_associated_gene_name))
OUTPUT
# A tibble: 4,290 × 2
   gene     hsapiens_homolog_associated_gene_name
   <chr>    <chr>
 1 Prodh    <NA>
 2 Tssk5    <NA>
 3 Vmn2r1   <NA>
 4 Gm10654  <NA>
 5 Hexa     <NA>
 6 Sult1a1  <NA>
 7 Gm6277   <NA>
 8 Tmem198b <NA>
 9 Adam1a   <NA>
10 Ebp      <NA>
# ℹ 4,280 more rows
اگر ہم صرف ان ماؤس جینز کو رکھنا چاہتے ہیں جن کا انسانی ہومولوگ موجود
ہو، تو ہم ایک “!” علامت شامل کر سکتے ہیں جو نتیجے کو نفی کر دیتی ہے،
تاکہ ہم ہر اس قطار کو تلاش کریں جہاں
hsapiens_homolog_associated_gene_name NA نہ
ہو۔
R
filter(genes, !is.na(hsapiens_homolog_associated_gene_name))
OUTPUT
# A tibble: 28,138 × 2
   gene    hsapiens_homolog_associated_gene_name
   <chr>   <chr>
 1 Asl     ASL
 2 Apod    APOD
 3 Cyp2d22 CYP2D6
 4 Klk6    KLK6
 5 Fcrls   FCRL2
 6 Slc2a4  SLC2A4
 7 Exd2    EXD2
 8 Gjc2    GJC2
 9 Plp1    PLP1
10 Gnb4    GNB4
# ℹ 28,128 more rows
پائپس
اگر آپ ایک ساتھ منتخب کرنا اور فلٹر کرنا چاہتے ہیں تو کیا کریں؟ اس کے لیے تین طریقے ہیں: درمیانی مراحل کا استعمال کرنا، نیسٹڈ فنکشنز، یا پائپس۔
درمیانی مراحل کے ذریعے، آپ ایک عارضی ڈیٹا فریم بناتے ہیں اور اسے اگلے فنکشن کے لیے ان پٹ کے طور پر استعمال کرتے ہیں، جیسا کہ یہاں دکھایا گیا ہے:
R
rna2 <- filter(rna, sex == "Male")
rna3 <- select(rna2, gene, sample, tissue, expression)
rna3
OUTPUT
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rows
یہ پڑھنے میں آسان ہے، لیکن اس سے آپ کا ورک اسپیس بہت سے درمیانی آبجیکٹس سے بھر سکتا ہے جنہیں آپ کو الگ الگ نام دینے پڑتے ہیں۔ متعدد مراحل کی صورت میں، ان کا حساب رکھنا مشکل ہو سکتا ہے۔
آپ فنکشنز کو ایک دوسرے کے اندر بھی رکھ سکتے ہیں (یعنی ایک فنکشن دوسرے کے اندر)، اس طرح:
R
rna3 <- select(filter(rna, sex == "Male"), gene, sample, tissue, expression)
rna3
OUTPUT
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rows
یہ مفید ہے، لیکن اگر بہت زیادہ فنکشنز ایک دوسرے کے اندر نیسٹڈ ہوں تو اسے پڑھنا مشکل ہو سکتا ہے، کیونکہ R ایکسپریشن کو اندر سے باہر کی طرف ایویلیویٹ کرتا ہے (اس معاملے میں، فلٹرنگ، پھر سلیکشن)۔
آخری آپشن، پائپس، R میں حال ہی میں شامل کیا گیا ہے۔ پائپس آپ کو ایک فنکشن کے آؤٹ پٹ کو لے کر اسے براہِ راست اگلے فنکشن تک پہنچانے کی سہولت دیتے ہیں، جو اس وقت مفید ہوتا ہے جب آپ کو ایک ہی ڈیٹا سیٹ پر بہت سے کام کرنے کی ضرورت ہو۔
R میں پائپس %>% (جو
magrittr پیکیج کے ذریعے دستیاب ہیں) یا
|> (بیس R کے ذریعے) کی شکل میں ہوتے ہیں۔ اگر آپ RStudio
استعمال کرتے ہیں، تو آپ PC کے صورت میں Ctrl +
Shift + M اور Mac کے صورت میں Cmd +
Shift + M کے ذریعے پائپ ٹائپ کر سکتے ہیں۔
مندرجہ بالا کوڈ میں، ہم پائپ کا استعمال کرتے ہیں تاکہ
rna ڈیٹا سیٹ کو پہلے filter() کے ذریعے بھیجا
جا سکے تاکہ وہ قطاریں محفوظ رہیں جہاں sex Male ہو، اور پھر
select() کے ذریعے بھیجا جا سکے تاکہ صرف gene،
sample، tissue، اور expression
کالمز محفوظ رہیں۔
پائپ |> بائیں جانب موجود آبجیکٹ کو لے کر اسے براہِ
راست دائیں جانب موجود فنکشن کے پہلے آرگومنٹ کے طور پر پاس کر دیتا ہے، اب
ہمیں filter() اور select() فنکشنز کے آرگومنٹ
کے طور پر ڈیٹا فریم کو واضح طور پر شامل کرنے کی ضرورت نہیں رہی۔
R
rna |>
  filter(sex == "Male") |>
  select(gene, sample, tissue, expression)
OUTPUT
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rows
کچھ لوگوں کے لیے پائپ کو “then” کے لفظ کی طرح پڑھنا مددگار ثابت ہو
سکتا ہے۔ مثال کے طور پر، اوپر دی گئی مثال میں، ہم نے ڈیٹا فریم
rna لیا، پھر ہم نے sex == "Male" والی
قطاروں کے لیے filter کیا، پھر ہم نے کالمز
gene، sample، tissue، اور
expression کو select کیا۔
dplyr فنکشنز بذاتِ خود کچھ سادہ ہیں،
لیکن انہیں پائپ کے ذریعے خطی ورک فلوز میں یکجا کر کے، ہم ڈیٹا فریمز کی
زیادہ پیچیدہ مانیپولیشنز انجام دے سکتے ہیں۔
اگر ہم ڈیٹا کے اس چھوٹے ورژن کے ساتھ ایک نیا آبجیکٹ بنانا چاہتے ہیں، تو ہم اسے ایک نیا نام دے سکتے ہیں:
R
rna3 <- rna |>
  filter(sex == "Male") |>
  select(gene, sample, tissue, expression)

rna3
OUTPUT
# A tibble: 14,740 × 4
   gene    sample     tissue     expression
   <chr>   <chr>      <chr>           <dbl>
 1 Asl     GSM2545340 Cerebellum        626
 2 Apod    GSM2545340 Cerebellum      13021
 3 Cyp2d22 GSM2545340 Cerebellum       2171
 4 Klk6    GSM2545340 Cerebellum        448
 5 Fcrls   GSM2545340 Cerebellum        180
 6 Slc2a4  GSM2545340 Cerebellum        313
 7 Exd2    GSM2545340 Cerebellum       2366
 8 Gjc2    GSM2545340 Cerebellum        310
 9 Plp1    GSM2545340 Cerebellum      53126
10 Gnb4    GSM2545340 Cerebellum       1355
# ℹ 14,730 more rowsچیلنج:
پائپس کا استعمال کرتے ہوئے، rna ڈیٹا کو اس طرح سب سیٹ
کریں کہ وقت 0 پر مادہ چوہوں کے مشاہدات کو برقرار رکھا جائے جہاں جین کا
اظہار 50000 سے زیادہ ہو، اور صرف کالمز gene،
sample، time، expression اور
age کو محفوظ رکھیں۔
R
rna |>
  filter(expression > 50000,
         sex == "Female",
         time == 0 ) |>
  select(gene, sample, time, expression, age)
OUTPUT
# A tibble: 9 × 5
  gene   sample      time expression   age
  <chr>  <chr>      <dbl>      <dbl> <dbl>
1 Plp1   GSM2545337     0     101241     8
2 Atp1b1 GSM2545337     0      53260     8
3 Plp1   GSM2545338     0      96534     8
4 Atp1b1 GSM2545338     0      50614     8
5 Plp1   GSM2545348     0     102790     8
6 Atp1b1 GSM2545348     0      59544     8
7 Plp1   GSM2545353     0      71237     8
8 Glul   GSM2545353     0      52451     8
9 Atp1b1 GSM2545353     0      61451     8
کالم بنانا اور تبدیل کرنا (mutate)
اکثر آپ موجودہ کالموں کی اقدار کی بنیاد پر نئے کالم تخلیق کرنا چاہیں
گے، مثال کے طور پر اکائیوں کی تبدیلی کرنے، یا دو کالموں میں اقدار کا
تناسب معلوم کرنے کے لیے۔ اس کے لیے ہم mutate() استعمال کریں
گے۔
گھنٹوں میں وقت کا ایک نیا کالم بنانے کے لیے:
R
rna |>
  mutate(time_hours = time * 24) |>
  select(time, time_hours)
OUTPUT
# A tibble: 32,428 × 2
    time time_hours
   <dbl>      <dbl>
 1     8        192
 2     8        192
 3     8        192
 4     8        192
 5     8        192
 6     8        192
 7     8        192
 8     8        192
 9     8        192
10     8        192
# ℹ 32,418 more rows
آپ ایک ہی mutate() کال کے اندر، پہلے نئے کالم کی بنیاد
پر دوسرا نیا کالم بھی بنا سکتے ہیں:
R
rna |>
  mutate(time_hours = time * 24,
         time_mn = time_hours * 60) |>
  select(time, time_hours, time_mn)
OUTPUT
# A tibble: 32,428 × 3
    time time_hours time_mn
   <dbl>      <dbl>   <dbl>
 1     8        192   11520
 2     8        192   11520
 3     8        192   11520
 4     8        192   11520
 5     8        192   11520
 6     8        192   11520
 7     8        192   11520
 8     8        192   11520
 9     8        192   11520
10     8        192   11520
# ℹ 32,418 more rowsچیلنج
rna ڈیٹا سے ایک نیا ڈیٹا فریم بنائیں جو درج ذیل معیار پر
پورا اترے: اس میں صرف gene، chromosome_name،
phenotype_description، sample، اور
expression کالمز شامل ہوں۔ اظہار کی اقدار کو لوگارتھمی
تبدیلی کیا جانا چاہیے۔ اس ڈیٹا فریم میں صرف وہ جینز شامل ہونے چاہئیں جو
سیکس کروموسومز پر واقع ہوں، ایک phenotype_description سے منسلک ہوں، اور
جن کا لوگارتھم اظہار 5 سے زیادہ ہو۔
اشارہ: سوچیں کہ اس ڈیٹا فریم کو تیار کرنے کے لیے کمانڈز کی ترتیب کیسی ہونی چاہیے!
R
rna |>
  mutate(expression = log(expression)) |>
  select(gene, chromosome_name, phenotype_description, sample, expression) |>
  filter(chromosome_name == "X" | chromosome_name == "Y") |>
  filter(!is.na(phenotype_description)) |>
  filter(expression > 5)
OUTPUT
# A tibble: 649 × 5
   gene   chromosome_name phenotype_description                sample expression
   <chr>  <chr>           <chr>                                <chr>       <dbl>
 1 Plp1   X               abnormal CNS glial cell morphology   GSM25…      10.7
 2 Slc7a3 X               decreased body length                GSM25…       5.46
 3 Plxnb3 X               abnormal coat appearance             GSM25…       6.58
 4 Rbm3   X               abnormal liver morphology            GSM25…       9.32
 5 Cfp    X               abnormal cardiovascular system phys… GSM25…       6.18
 6 Ebp    X               abnormal embryonic erythrocyte morp… GSM25…       6.68
 7 Cd99l2 X               abnormal cellular extravasation      GSM25…       8.04
 8 Piga   X               abnormal brain development           GSM25…       6.06
 9 Pim2   X               decreased T cell proliferation       GSM25…       7.11
10 Itm2a  X               no abnormal phenotype detected       GSM25…       7.48
# ℹ 639 more rows
اسپلٹ-ایپلائی-کمبائن ڈیٹا تجزیہ
ڈیٹا تجزیے کے بہت سے کاموں کو split-apply-combine پیراڈائم
کے ذریعے انجام دیا جا سکتا ہے: ڈیٹا کو گروہوں میں تقسیم کریں، ہر گروپ پر
کوئی تجزیہ کریں، اور پھر نتائج کو یکجا کریں۔
dplyr group_by() فنکشن کے
استعمال کے ذریعے اسے بہت آسان بنا دیتا ہے۔
R
rna |>
  group_by(gene)
OUTPUT
# A tibble: 32,428 × 19
# Groups:   gene [1,474]
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…       1170 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 Apod    GSM254…      36194 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 3 Cyp2d22 GSM254…       4060 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 4 Klk6    GSM254…        287 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 5 Fcrls   GSM254…         85 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 6 Slc2a4  GSM254…        782 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 7 Exd2    GSM254…       1619 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 Gjc2    GSM254…        288 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 9 Plp1    GSM254…      43217 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
10 Gnb4    GSM254…       1071 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
group_by() فنکشن ڈیٹا کی کوئی پروسیسنگ نہیں کرتا، بلکہ
یہ ڈیٹا کو ذیلی گروہوں میں تقسیم کرتا ہے: اوپر دی گئی مثال میں، 32428 کے
مشاہدات کا ہمارا ابتدائی tibble، gene ویری
ایبل کی بنیاد پر 1474 گروہوں میں تقسیم ہو جاتا ہے۔
ہم اسی طرح ٹیبل کو نمونوں کے لحاظ سے گروپ کرنے کا فیصلہ بھی کر سکتے ہیں:
R
rna |>
  group_by(sample)
OUTPUT
# A tibble: 32,428 × 19
# Groups:   sample [22]
   gene    sample  expression organism   age sex   infection strain  time tissue
   <chr>   <chr>        <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 Asl     GSM254…       1170 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 Apod    GSM254…      36194 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 3 Cyp2d22 GSM254…       4060 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 4 Klk6    GSM254…        287 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 5 Fcrls   GSM254…         85 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 6 Slc2a4  GSM254…        782 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 7 Exd2    GSM254…       1619 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 Gjc2    GSM254…        288 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 9 Plp1    GSM254…      43217 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
10 Gnb4    GSM254…       1071 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
یہاں ہمارے 32428 مشاہدات کا ابتدائی tibble،
sample متغیر کی بنیاد پر 22 گروپس میں تقسیم کیا جاتا
ہے۔
ایک بار جب ڈیٹا کو گروپ کر لیا جائے، تو بعد کے آپریشنز ہر گروپ پر آزادانہ طور پر لاگو کیے جائیں گے۔
summarise() فنکشن
group_by() کا استعمال اکثر summarise() کے
ساتھ کیا جاتا ہے، جو ہر گروپ کو اس گروپ کے ایک صف کے خلاصے میں تبدیل کر
دیتا ہے۔
group_by() ایسے کالم کے ناموں کو آرگومنٹس کے طور پر لیتا
ہے جن میں وہ کیٹیگوریکل متغیرات موجود ہوں جن کے لیے آپ
خلاصہ اعداد و شمار کا حساب لگانا چاہتے ہیں۔ لہٰذا، جین کے لحاظ سے اوسط
expression کا حساب لگانے کے لیے:
R
rna |>
  group_by(gene) |>
  summarise(mean_expression = mean(expression))
OUTPUT
# A tibble: 1,474 × 2
   gene     mean_expression
   <chr>              <dbl>
 1 AI504432         1053.
 2 AW046200          131.
 3 AW551984          295.
 4 Aamp             4751.
 5 Abca12              4.55
 6 Abcc8            2498.
 7 Abhd14a           525.
 8 Abi2             4909.
 9 Abi3bp           1002.
10 Abl2             2124.
# ℹ 1,464 more rows
ہم ہر نمونے میں تمام جینز کی اوسط اظہار کی سطحوں کا حساب بھی لینا چاہیں گے:
R
rna |>
  group_by(sample) |>
  summarise(mean_expression = mean(expression))
OUTPUT
# A tibble: 22 × 2
   sample     mean_expression
   <chr>                <dbl>
 1 GSM2545336           2062.
 2 GSM2545337           1766.
 3 GSM2545338           1668.
 4 GSM2545339           1696.
 5 GSM2545340           1682.
 6 GSM2545341           1638.
 7 GSM2545342           1594.
 8 GSM2545343           2107.
 9 GSM2545344           1712.
10 GSM2545345           1700.
# ℹ 12 more rows
لیکن ہم متعدد کالمز کے حساب سے بھی گروپ کر سکتے ہیں:
R
rna |>
  group_by(gene, infection, time) |>
  summarise(mean_expression = mean(expression))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, infection, and time.
ℹ Output is grouped by gene and infection.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, infection, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 4,422 × 4
# Groups:   gene, infection [2,948]
   gene     infection    time mean_expression
   <chr>    <chr>       <dbl>           <dbl>
 1 AI504432 InfluenzaA      4           1104.
 2 AI504432 InfluenzaA      8           1014
 3 AI504432 NonInfected     0           1034.
 4 AW046200 InfluenzaA      4            152.
 5 AW046200 InfluenzaA      8             81
 6 AW046200 NonInfected     0            155.
 7 AW551984 InfluenzaA      4            302.
 8 AW551984 InfluenzaA      8            342.
 9 AW551984 NonInfected     0            238
10 Aamp     InfluenzaA      4           4870
# ℹ 4,412 more rows
ایک بار جب ڈیٹا گروپ کر لیا جائے، تو آپ ایک ہی وقت میں متعدد متغیرات
کا خلاصہ بھی کر سکتے ہیں (اور ضروری نہیں کہ وہ ایک ہی متغیر پر ہوں)۔
مثال کے طور پر، ہم جین اور شرط کے لحاظ سے میڈین expression
کو ظاہر کرنے والا ایک کالم شامل کر سکتے ہیں:
R
rna |>
  group_by(gene, infection, time) |>
  summarise(mean_expression = mean(expression),
            median_expression = median(expression))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene, infection, and time.
ℹ Output is grouped by gene and infection.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, infection, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 4,422 × 5
# Groups:   gene, infection [2,948]
   gene     infection    time mean_expression median_expression
   <chr>    <chr>       <dbl>           <dbl>             <dbl>
 1 AI504432 InfluenzaA      4           1104.             1094.
 2 AI504432 InfluenzaA      8           1014               985
 3 AI504432 NonInfected     0           1034.             1016
 4 AW046200 InfluenzaA      4            152.              144.
 5 AW046200 InfluenzaA      8             81                82
 6 AW046200 NonInfected     0            155.              163
 7 AW551984 InfluenzaA      4            302.              245
 8 AW551984 InfluenzaA      8            342.              287
 9 AW551984 NonInfected     0            238               265
10 Aamp     InfluenzaA      4           4870              4708
# ℹ 4,412 more rowsچیلنج
ٹائم پوائنٹس کے لحاظ سے جین “Dok3” کی اوسط اظہار کی سطح کا حساب لگائیں۔
R
rna |>
  filter(gene == "Dok3") |>
  group_by(time) |>
  summarise(mean = mean(expression))
OUTPUT
# A tibble: 3 × 2
   time  mean
  <dbl> <dbl>
1     0  169
2     4  156.
3     8   61
گنتی
ڈیٹا کے ساتھ کام کرتے وقت، ہم اکثر ہر فیکٹر یا فیکٹرز کے مجموعے کے
لیے پائے گئے آبزرویشنز کی تعداد جاننا چاہتے ہیں۔ اس کام کے لیے،
dplyr count() فراہم کرتا ہے۔
مثال کے طور پر، اگر ہم ہر متاثرہ اور غیر متاثرہ نمونوں کے لیے ڈیٹا کی
قطاروں کی تعداد گننا چاہتے ہوں، تو ہم یوں کریں گے:
R
rna |>
    count(infection)
OUTPUT
# A tibble: 2 × 2
  infection       n
  <chr>       <int>
1 InfluenzaA  22110
2 NonInfected 10318
count() فنکشن ایک ایسی چیز کا مختصر شکل ہے جسے ہم پہلے
ہی دیکھ چکے ہیں: ایک ویری ایبل کے مطابق گروپنگ کرنا، اور اس گروپ میں
مشاہدات کی تعداد گنتی کر کے اس کا خلاصہ تیار کرنا۔ دوسرے الفاظ میں،
rna |> count(infection) درج ذیل کے مساوی ہے:
R
rna |>
    group_by(infection) |>
    summarise(n = n())
OUTPUT
# A tibble: 2 × 2
  infection       n
  <chr>       <int>
1 InfluenzaA  22110
2 NonInfected 10318
پچھلا مثال count() کے استعمال کو دکھاتا ہے تاکہ
ایک فیکٹر (یعنی infection) کے لیے قطاروں/آبزرویشنز
کی تعداد گنی جا سکے۔ اگر ہم infection اور time
جیسے فیکٹرز کے مجموعے کی تعداد گننا چاہتے، تو ہم پہلے اور دوسرے
فیکٹر کو count() کے آرگومنٹس کے طور پر متعین کریں گے:
R
rna |>
    count(infection, time)
OUTPUT
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      4 11792
2 InfluenzaA      8 10318
3 NonInfected     0 10318
جو اس کے برابر ہے:
R
rna |>
  group_by(infection, time) |>
  summarise(n = n())
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by infection and time.
ℹ Output is grouped by infection.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(infection, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 3 × 3
# Groups:   infection [2]
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      4 11792
2 InfluenzaA      8 10318
3 NonInfected     0 10318
موازنے میں آسانی کے لیے کبھی کبھی نتیجے کو ترتیب دینا مفید ہوتا ہے۔
ہم ٹیبل کو ترتیب دینے کے لیے arrange() کا استعمال کر سکتے
ہیں۔ مثال کے طور پر، ہم اوپر دیے گئے ٹیبل کو وقت کے لحاظ سے ترتیب دینا
چاہیں گے:
R
rna |>
  count(infection, time) |>
  arrange(time)
OUTPUT
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 NonInfected     0 10318
2 InfluenzaA      4 11792
3 InfluenzaA      8 10318
یا گنتیوں کے لحاظ سے:
R
rna |>
  count(infection, time) |>
  arrange(n)
OUTPUT
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      8 10318
2 NonInfected     0 10318
3 InfluenzaA      4 11792
ترتیب کو گرتی ہوئی ترتیب میں ترتیب دینے کے لیے، ہمیں
desc() فنکشن شامل کرنے کی ضرورت ہے:
R
rna |>
  count(infection, time) |>
  arrange(desc(n))
OUTPUT
# A tibble: 3 × 3
  infection    time     n
  <chr>       <dbl> <int>
1 InfluenzaA      4 11792
2 InfluenzaA      8 10318
3 NonInfected 0 10318چیلنج
- ہر نمونے میں کتنے جینز کا تجزیہ کیا گیا؟
- ہر نمونے میں سیکوئنسنگ ڈیپتھ (تمام گنتیوں کا مجموعہ) کا جائزہ لینے
کے لیے
group_by()اورsummarise()کا استعمال کریں۔ کس نمونے میں سیکوئنسنگ ڈیپتھ سب سے زیادہ ہے؟ - ایک نمونہ منتخب کریں اور بائیو ٹائپ کے لحاظ سے جینز کی تعداد کا جائزہ لیں۔
- “abnormal DNA methylation” فینوٹائپ کی تفصیل سے وابستہ جینز کی شناخت کریں، اور وقت 0، وقت 4 اور وقت 8 پر ان کے اوسط اظہار (log میں) کا حساب لگائیں۔
R
## 1.
rna |>
  count(sample)
OUTPUT
# A tibble: 22 × 2
   sample         n
   <chr>      <int>
 1 GSM2545336  1474
 2 GSM2545337  1474
 3 GSM2545338  1474
 4 GSM2545339  1474
 5 GSM2545340  1474
 6 GSM2545341  1474
 7 GSM2545342  1474
 8 GSM2545343  1474
 9 GSM2545344  1474
10 GSM2545345  1474
# ℹ 12 more rows
R
## 2.
rna |>
  group_by(sample) |>
  summarise(seq_depth = sum(expression)) |>
  arrange(desc(seq_depth))
OUTPUT
# A tibble: 22 × 2
   sample     seq_depth
   <chr>          <dbl>
 1 GSM2545350   3255566
 2 GSM2545352   3216163
 3 GSM2545343   3105652
 4 GSM2545336   3039671
 5 GSM2545380   3036098
 6 GSM2545353   2953249
 7 GSM2545348   2913678
 8 GSM2545362   2913517
 9 GSM2545351   2782464
10 GSM2545349   2758006
# ℹ 12 more rows
R
## 3.
rna |>
  filter(sample == "GSM2545336") |>
  count(gene_biotype) |>
  arrange(desc(n))
OUTPUT
# A tibble: 13 × 2
   gene_biotype                           n
   <chr>                              <int>
 1 protein_coding                      1321
 2 lncRNA                                69
 3 processed_pseudogene                  59
 4 miRNA                                  7
 5 snoRNA                                 5
 6 TEC                                    4
 7 polymorphic_pseudogene                 2
 8 unprocessed_pseudogene                 2
 9 IG_C_gene                              1
10 scaRNA                                 1
11 transcribed_processed_pseudogene       1
12 transcribed_unitary_pseudogene         1
13 transcribed_unprocessed_pseudogene     1
R
## 4.
rna |>
  filter(phenotype_description == "abnormal DNA methylation") |>
  group_by(gene, time) |>
  summarise(mean_expression = mean(log(expression))) |>
  arrange()
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 6 × 3
# Groups:   gene [2]
  gene   time mean_expression
  <chr> <dbl>           <dbl>
1 Xist      0            6.95
2 Xist      4            6.34
3 Xist      8            7.13
4 Zdbf2     0            6.27
5 Zdbf2     4            6.27
6 Zdbf2     8            6.19
ڈیٹا کی تشکیلِ نو
rna ٹبل میں، قطاروں میں اظہار کی اقدار (یونٹ) موجود ہیں
جو 2 دیگر متغیرات: gene اور sample کے مجموعے
سے منسلک ہیں۔
باقی تمام کالمز ایسی متغیرات سے متعلق ہیں جو یا تو نمونے (جیسے کہ جاندار، عمر، جنس، …) یا جین (gene_biotype، ENTREZ_ID، پروڈکٹ، …) کی وضاحت کرتے ہیں۔ وہ متغیرات جو جینز یا نمونوں کے ساتھ تبدیل نہیں ہوتے، تمام قطاروں میں ایک ہی ویلیو رکھتے ہیں۔
R
rna |>
  arrange(gene)
OUTPUT
# A tibble: 32,428 × 19
   gene     sample expression organism   age sex   infection strain  time tissue
   <chr>    <chr>       <dbl> <chr>    <dbl> <chr> <chr>     <chr>  <dbl> <chr>
 1 AI504432 GSM25…       1230 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 2 AI504432 GSM25…       1085 Mus mus…     8 Fema… NonInfec… C57BL…     0 Cereb…
 3 AI504432 GSM25…        969 Mus mus…     8 Fema… NonInfec… C57BL…     0 Cereb…
 4 AI504432 GSM25…       1284 Mus mus…     8 Fema… Influenz… C57BL…     4 Cereb…
 5 AI504432 GSM25…        966 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
 6 AI504432 GSM25…        918 Mus mus…     8 Male  Influenz… C57BL…     8 Cereb…
 7 AI504432 GSM25…        985 Mus mus…     8 Fema… Influenz… C57BL…     8 Cereb…
 8 AI504432 GSM25…        972 Mus mus…     8 Male  NonInfec… C57BL…     0 Cereb…
 9 AI504432 GSM25…       1000 Mus mus…     8 Fema… Influenz… C57BL…     4 Cereb…
10 AI504432 GSM25…        816 Mus mus…     8 Male  Influenz… C57BL…     4 Cereb…
# ℹ 32,418 more rows
# ℹ 9 more variables: mouse <dbl>, ENTREZID <dbl>, product <chr>,
#   ensembl_gene_id <chr>, external_synonym <chr>, chromosome_name <chr>,
#   gene_biotype <chr>, phenotype_description <chr>,
#   hsapiens_homolog_associated_gene_name <chr>
اس ساخت کو long-format کہا جاتا ہے، کیونکہ ایک کالم میں
تمام اقدار شامل ہوتی ہیں، اور دیگر کالم(یں) اقدار کے سیاق و سباق کی
فہرست پیش کرتے ہیں۔
کچھ معاملات میں، long-format حقیقت میں “انسانی طور پر
قابلِ پڑھنے” نہیں ہوتا، اور ڈیٹا کی نمائندگی کے ایک زیادہ جامع طریقے کے
طور پر ایک دوسرے فارمیٹ، wide-format کو ترجیح دی جاتی ہے۔
یہ عام طور پر ان جین کے اظہار کی اقدار کے معاملے میں ہوتا ہے جنہیں
سائنسدان کو میٹرکسز کے طور پر دیکھنے کی عادت ہوتی ہے، جہاں قطاریں جینز
کی نمائندگی کرتی ہیں اور کالم نمونوں کی نمائندگی کرتے ہیں۔
اس فارمیٹ میں، لہٰذا نمونوں کے اندر اور ان کے درمیان جین کے اظہار کی سطحوں کے تعلق کا جائزہ لینا آسان ہو جائے گا۔
OUTPUT
# A tibble: 1,474 × 23
   gene    GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
   <chr>        <dbl>      <dbl>      <dbl>      <dbl>      <dbl>      <dbl>
 1 Asl           1170        361        400        586        626        988
 2 Apod         36194      10347       9173      10620      13021      29594
 3 Cyp2d22       4060       1616       1603       1901       2171       3349
 4 Klk6           287        629        641        578        448        195
 5 Fcrls           85        233        244        237        180         38
 6 Slc2a4         782        231        248        265        313        786
 7 Exd2          1619       2288       2235       2513       2366       1359
 8 Gjc2           288        595        568        551        310        146
 9 Plp1         43217     101241      96534      58354      53126      27173
10 Gnb4          1071       1791       1867       1430       1355        798
# ℹ 1,464 more rows
# ℹ 16 more variables: GSM2545342 <dbl>, GSM2545343 <dbl>, GSM2545344 <dbl>,
#   GSM2545345 <dbl>, GSM2545346 <dbl>, GSM2545347 <dbl>, GSM2545348 <dbl>,
#   GSM2545349 <dbl>, GSM2545350 <dbl>, GSM2545351 <dbl>, GSM2545352 <dbl>,
#   GSM2545353 <dbl>, GSM2545354 <dbl>, GSM2545362 <dbl>, GSM2545363 <dbl>,
#   GSM2545380 <dbl>
جین کے اظہار کی اقدار کو rna سے وائڈ فارمیٹ میں تبدیل
کرنے کے لیے، ہمیں ایک نیا ٹیبل بنانا ہوگا جہاں sample کالم
کی اقدار کالم ویری ایبلز کے نام بن جائیں گی۔
یہاں اہم نکتہ یہ ہے کہ ہم اب بھی ایک منظم ڈیٹا ساخت پر عمل کر رہے ہیں، لیکن ہم نے دلچسپی کے مشاہدات کے مطابق ڈیٹا کو دوبارہ ترتیب دیا ہے: جین کے لحاظ سے اظہار کی سطحوں کو، جین اور سیمپل کے لحاظ سے درج کرنے کے بجائے۔
اس کے برعکس تبدیلی کا مطلب کالم کے ناموں کو ایک نئے ویری ایبل کی اقدار میں تبدیل کرنا ہوگا۔
ہم ان دونوں تبدیلیوں کو دو tidyr فنکشنز،
pivot_longer() اور pivot_wider() کے ذریعے کر
سکتے ہیں (تفصیلات کے لیے tidyr ویب
سائٹ پر پیوٹس سے متعلق مضمون دیکھیں)۔
ڈیٹا کو وائڈ فارمیٹ میں تبدیل کرنا
آئیے rna کے پہلے 3 کالمز کا انتخاب کریں اور
pivot_wider() کا استعمال کرتے ہوئے ڈیٹا کو وائڈ فارمیٹ میں
تبدیل کریں۔
R
rna_exp <- rna |>
  select(gene, sample, expression)
rna_exp
OUTPUT
# A tibble: 32,428 × 3
   gene    sample     expression
   <chr>   <chr>           <dbl>
 1 Asl     GSM2545336       1170
 2 Apod    GSM2545336      36194
 3 Cyp2d22 GSM2545336       4060
 4 Klk6    GSM2545336        287
 5 Fcrls   GSM2545336         85
 6 Slc2a4  GSM2545336        782
 7 Exd2    GSM2545336       1619
 8 Gjc2    GSM2545336        288
 9 Plp1    GSM2545336      43217
10 Gnb4    GSM2545336       1071
# ℹ 32,418 more rows
pivot_wider تین بنیادی آرگومنٹس لیتا ہے:
- تبدیل کیے جانے والے ڈیٹا؛
- the
names_from: وہ کالم جس کی اقدار نئے کالم کے نام بن جائیں گی؛ - the
values_from: وہ کالم جس کی اقدار نئے کالموں کو بھریں گی۔
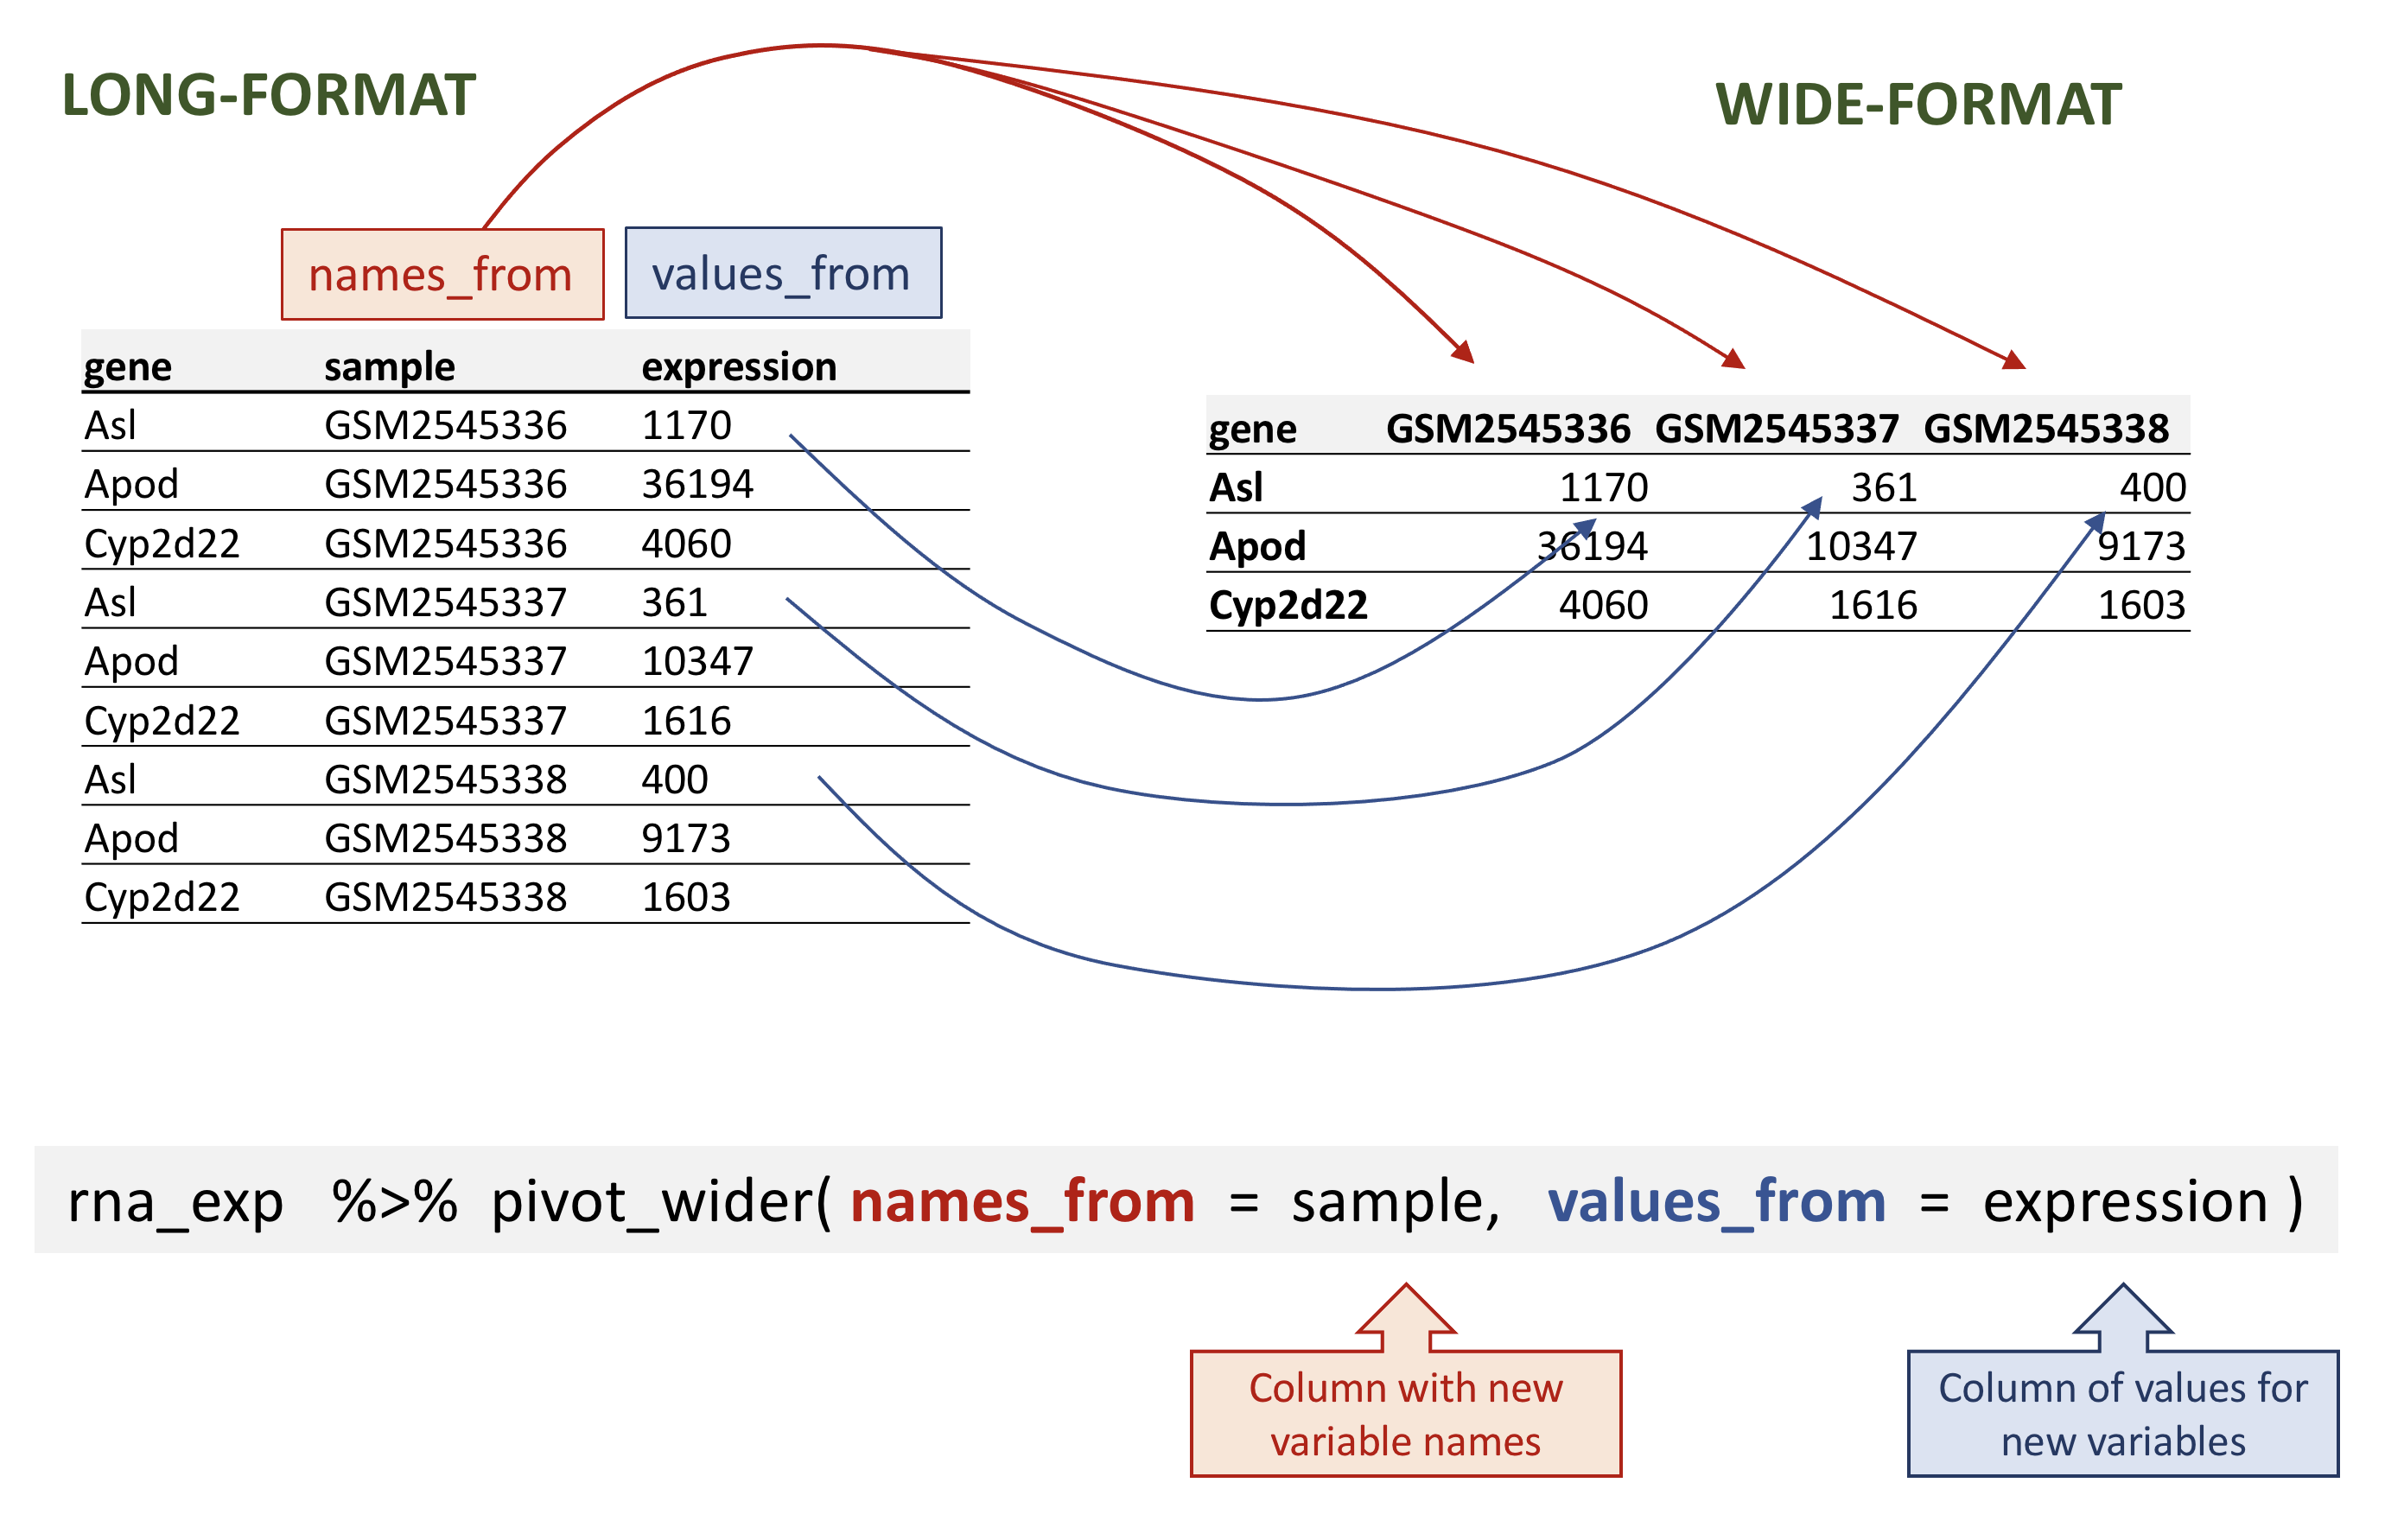
rna data.
R
rna_wide <- rna_exp |>
  pivot_wider(names_from = sample,
              values_from = expression)
rna_wide
OUTPUT
# A tibble: 1,474 × 23
   gene    GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
   <chr>        <dbl>      <dbl>      <dbl>      <dbl>      <dbl>      <dbl>
 1 Asl           1170        361        400        586        626        988
 2 Apod         36194      10347       9173      10620      13021      29594
 3 Cyp2d22       4060       1616       1603       1901       2171       3349
 4 Klk6           287        629        641        578        448        195
 5 Fcrls           85        233        244        237        180         38
 6 Slc2a4         782        231        248        265        313        786
 7 Exd2          1619       2288       2235       2513       2366       1359
 8 Gjc2           288        595        568        551        310        146
 9 Plp1         43217     101241      96534      58354      53126      27173
10 Gnb4          1071       1791       1867       1430       1355        798
# ℹ 1,464 more rows
# ℹ 16 more variables: GSM2545342 <dbl>, GSM2545343 <dbl>, GSM2545344 <dbl>,
#   GSM2545345 <dbl>, GSM2545346 <dbl>, GSM2545347 <dbl>, GSM2545348 <dbl>,
#   GSM2545349 <dbl>, GSM2545350 <dbl>, GSM2545351 <dbl>, GSM2545352 <dbl>,
#   GSM2545353 <dbl>, GSM2545354 <dbl>, GSM2545362 <dbl>, GSM2545363 <dbl>,
#   GSM2545380 <dbl>
نوٹ کریں کہ ڈیفالٹ طور پر، pivot_wider() فنکشن غائب
اقدار کے لیے NA شامل کرے گا۔
تصور کرتے ہیں کہ کسی وجہ سے، ہمارے پاس بعض نمونوں میں کچھ جینز کے لیے اظہار کی کچھ اقدار غائب تھیں۔ درج ذیل فرضی مثال میں، جین Cyp2d22 کی صرف ایک اظہار کی اقدار موجود ہیں، جو GSM2545338 نمونے میں ہیں۔
R
rna_with_missing_values <- rna |>
  select(gene, sample, expression) |>
  filter(gene %in% c("Asl", "Apod", "Cyp2d22")) |>
  filter(sample %in% c("GSM2545336", "GSM2545337", "GSM2545338")) |>
  arrange(sample) |>
  filter(!(gene == "Cyp2d22" & sample != "GSM2545338"))
rna_with_missing_values
OUTPUT
# A tibble: 7 × 3
  gene    sample     expression
  <chr>   <chr>           <dbl>
1 Asl     GSM2545336       1170
2 Apod    GSM2545336      36194
3 Asl     GSM2545337        361
4 Apod    GSM2545337      10347
5 Asl     GSM2545338        400
6 Apod    GSM2545338       9173
7 Cyp2d22 GSM2545338       1603
ڈیفالٹ طور پر، pivot_wider() فنکشن غائب اقدار کے لیے
NA شامل کرے گا۔ اسے pivot_wider() فنکشن کے
values_fill آرگومنٹ کے ذریعے پیرامیٹرائز کیا جا سکتا
ہے۔
R
rna_with_missing_values |>
  pivot_wider(names_from = sample,
              values_from = expression)
OUTPUT
# A tibble: 3 × 4
  gene    GSM2545336 GSM2545337 GSM2545338
  <chr>        <dbl>      <dbl>      <dbl>
1 Asl           1170        361        400
2 Apod         36194      10347       9173
3 Cyp2d22         NA         NA       1603
R
rna_with_missing_values |>
  pivot_wider(names_from = sample,
              values_from = expression,
              values_fill = 0)
OUTPUT
# A tibble: 3 × 4
  gene    GSM2545336 GSM2545337 GSM2545338
  <chr>        <dbl>      <dbl>      <dbl>
1 Asl           1170        361        400
2 Apod         36194      10347       9173
3 Cyp2d22          0          0       1603
ڈیٹا کو لانگ فارمیٹ میں تبدیل کرنا
اس کے برعکس صورتحال میں ہم کالم کے ناموں کا استعمال کر رہے ہیں اور انہیں نئے متغیرات کے ایک جوڑے میں تبدیل کر رہے ہیں۔ ایک متغیر کالم کے ناموں کو اقدار کے طور پر ظاہر کرتا ہے، اور دوسرا متغیر ان اقدار کو شامل کرتا ہے جو پہلے کالم کے ناموں سے وابستہ تھیں۔
pivot_longer() چار بنیادی آرگومنٹس لیتا ہے:
- تبدیل کیے جانے والے ڈیٹا؛
- the
names_to: نیا کالم کا نام جو ہم تخلیق کرنا چاہتے ہیں اور اسے موجودہ کالموں کے ناموں سے بھرنا چاہتے ہیں؛ - the
values_to: نیا کالم کا نام جسے ہم بنانا چاہتے ہیں اور اسے موجودہ اقدار سے بھرنا چاہتے ہیں؛ - ان کالموں کے نام جنہیں
names_toاورvalues_toمتغیرات بھرنے کے لیے استعمال کرنا ہے، یا جنہیں اس انتخاب سے خارج رکھنا ہے۔
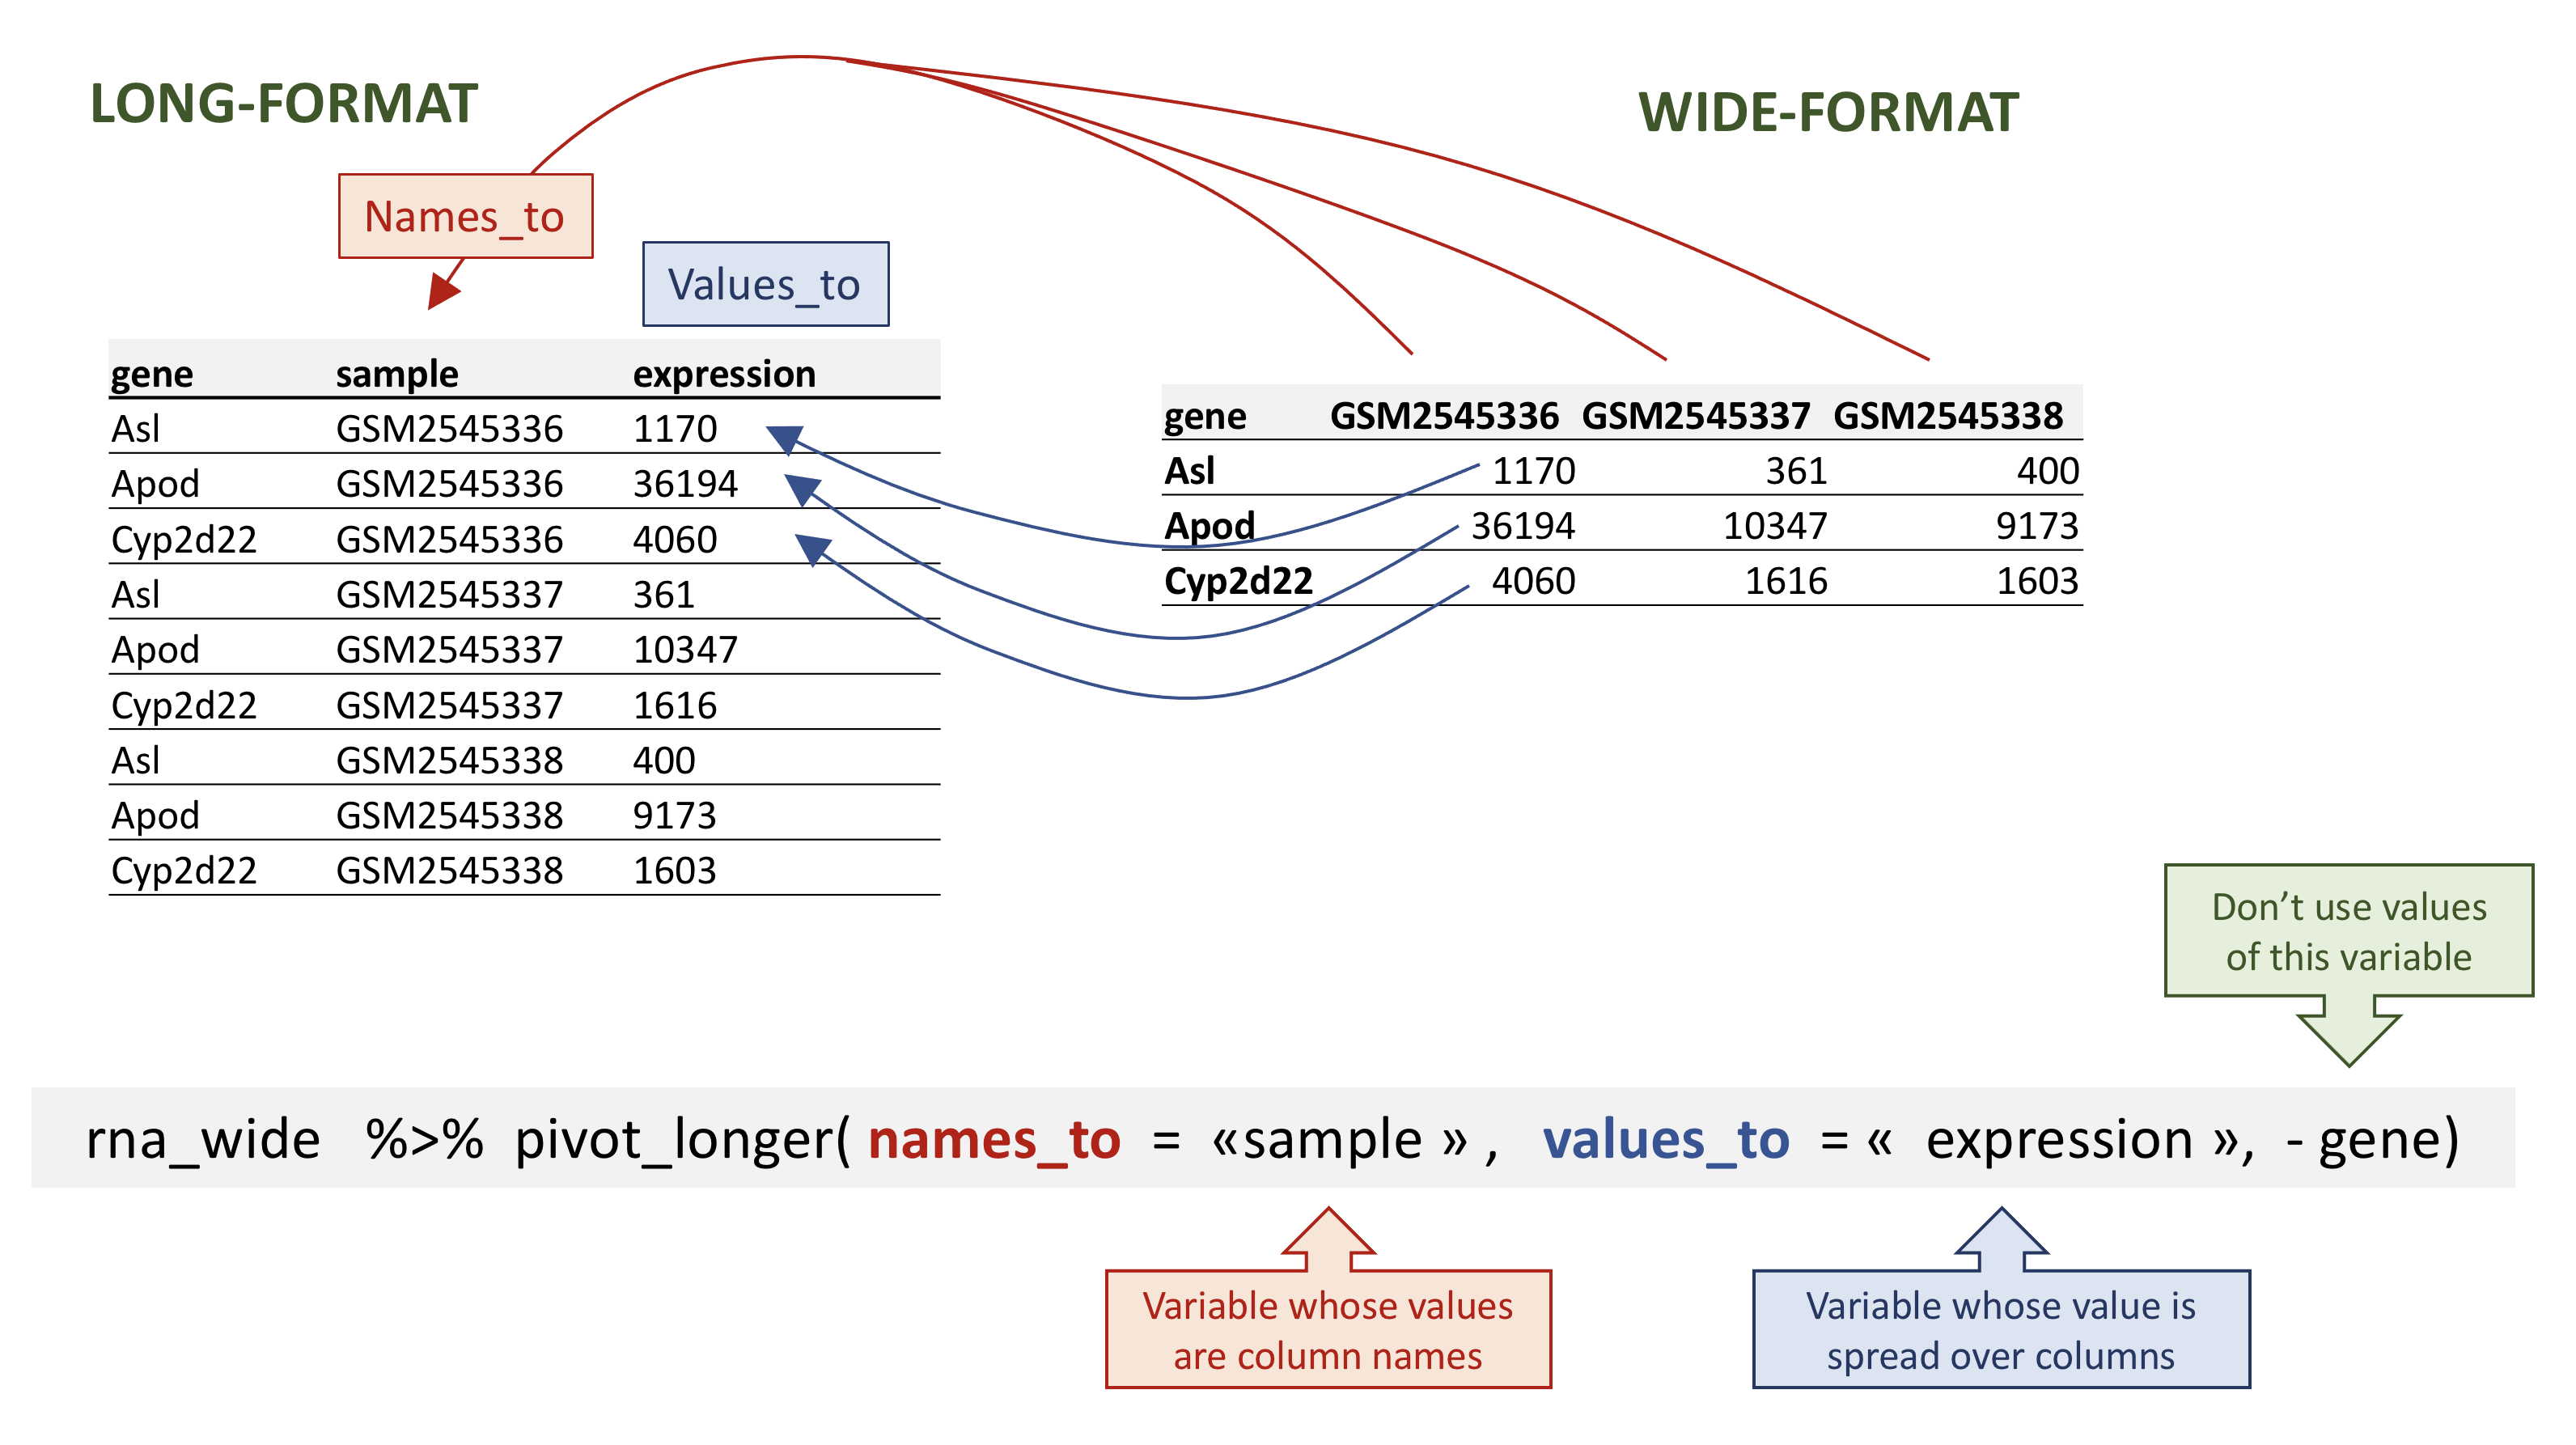
rna data.
rna_wide سے rna_long کو دوبارہ تیار کرنے کے
لیے ہم sample نامی ایک کی (key) اور expression
نامی ایک ویلیو (value) بنائیں گے اور کی ویری ایبل کے لیے
gene کے علاوہ تمام کالمز استعمال کریں گے۔ یہاں منفی نشان کے
ذریعے gene کالم کو پِوٹ کیے جانے والے کالموں کے انتخاب سے
خارج رکھتے ہیں۔
غور کریں کہ یہاں نئے ویری ایبلز کے ناموں کو کوٹس (quotes) میں لکھا جائے گا۔
R
rna_long <- rna_wide |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 -gene)
rna_long
OUTPUT
# A tibble: 32,428 × 3
   gene  sample     expression
   <chr> <chr>           <dbl>
 1 Asl   GSM2545336       1170
 2 Asl   GSM2545337        361
 3 Asl   GSM2545338        400
 4 Asl   GSM2545339        586
 5 Asl   GSM2545340        626
 6 Asl   GSM2545341        988
 7 Asl   GSM2545342        836
 8 Asl   GSM2545343        535
 9 Asl   GSM2545344        586
10 Asl   GSM2545345        597
# ℹ 32,418 more rows
ہم یہ بھی کر سکتے تھے کہ کن کالمز شامل کرنے کے لیے ایک تفصیل استعمال
کریں۔ یہ تب مفید ہو سکتا ہے جب آپ کے پاس شناختی کالمز کی تعداد زیادہ ہو،
اور یہ متعین کرنا زیادہ آسان ہوتا ہے کہ کیا اکٹھا کیا جائے اور کیا چھوڑ
دیا جائے۔ یہاں starts_with() فنکشن نمونوں کے نام حاصل کرنے
میں مدد کر سکتا ہے، بغیر ان سب کو فہرست میں لکھے! ایک اور امکان
: آپریٹر کا استعمال کرنا ہو سکتا ہے!
R
rna_wide |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 cols = starts_with("GSM"))
OUTPUT
# A tibble: 32,428 × 3
   gene  sample     expression
   <chr> <chr>           <dbl>
 1 Asl   GSM2545336       1170
 2 Asl   GSM2545337        361
 3 Asl   GSM2545338        400
 4 Asl   GSM2545339        586
 5 Asl   GSM2545340        626
 6 Asl   GSM2545341        988
 7 Asl   GSM2545342        836
 8 Asl   GSM2545343        535
 9 Asl   GSM2545344        586
10 Asl   GSM2545345        597
# ℹ 32,418 more rows
R
rna_wide |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 GSM2545336:GSM2545380)
OUTPUT
# A tibble: 32,428 × 3
   gene  sample     expression
   <chr> <chr>           <dbl>
 1 Asl   GSM2545336       1170
 2 Asl   GSM2545337        361
 3 Asl   GSM2545338        400
 4 Asl   GSM2545339        586
 5 Asl   GSM2545340        626
 6 Asl   GSM2545341        988
 7 Asl   GSM2545342        836
 8 Asl   GSM2545343        535
 9 Asl   GSM2545344        586
10 Asl   GSM2545345        597
# ℹ 32,418 more rows
نوٹ کریں کہ اگر وائڈ فارمیٹ میں غیر موجود اقدار ہوتیں، تو
NA نئے لانگ فارمیٹ میں شامل ہو جاتا۔
ہمارے پچھلے مصنوعی ٹیبل (tible) کو یاد کریں جس میں غیر موجود اقدار (missing values) شامل تھیں:
R
rna_with_missing_values
OUTPUT
# A tibble: 7 × 3
  gene    sample     expression
  <chr>   <chr>           <dbl>
1 Asl     GSM2545336       1170
2 Apod    GSM2545336      36194
3 Asl     GSM2545337        361
4 Apod    GSM2545337      10347
5 Asl     GSM2545338        400
6 Apod    GSM2545338       9173
7 Cyp2d22 GSM2545338       1603
R
wide_with_NA <- rna_with_missing_values |>
  pivot_wider(names_from = sample,
              values_from = expression)
wide_with_NA
OUTPUT
# A tibble: 3 × 4
  gene    GSM2545336 GSM2545337 GSM2545338
  <chr>        <dbl>      <dbl>      <dbl>
1 Asl           1170        361        400
2 Apod         36194      10347       9173
3 Cyp2d22         NA         NA       1603
R
wide_with_NA |>
    pivot_longer(names_to = "sample",
                 values_to = "expression",
                 -gene)
OUTPUT
# A tibble: 9 × 3
  gene    sample     expression
  <chr>   <chr>           <dbl>
1 Asl     GSM2545336       1170
2 Asl     GSM2545337        361
3 Asl     GSM2545338        400
4 Apod    GSM2545336      36194
5 Apod    GSM2545337      10347
6 Apod    GSM2545338       9173
7 Cyp2d22 GSM2545336         NA
8 Cyp2d22 GSM2545337         NA
9 Cyp2d22 GSM2545338       1603
وائڈ اور لانگ فارمیٹس میں تبدیلی کرنا ڈیٹا سیٹ کو متوازن کرنے کا ایک مفید طریقہ ہو سکتا ہے تاکہ ہر ریپلیکیٹ کی ترکیب ایک جیسی رہے۔
سوال
rna ٹیبل سے آغاز کرتے ہوئے، pivot_wider() فنکشن کا
استعمال کرتے ہوئے ایک وائڈ فارمیٹ ٹیبل بنائیں جو ہر چوہے میں جین کے
اظہار کی سطحیں ظاہر کرے۔ پھر pivot_longer() فنکشن کا
استعمال کرتے ہوئے لانگ فارمیٹ ٹیبل کو بحال کریں۔
R
rna1 <- rna |>
select(gene, mouse, expression) |>
pivot_wider(names_from = mouse, values_from = expression)
rna1
OUTPUT
# A tibble: 1,474 × 23
   gene     `14`    `9`  `10`  `15`  `18`   `6`   `5`  `11`  `22`  `13`  `23`
   <chr>   <dbl>  <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
 1 Asl      1170    361   400   586   626   988   836   535   586   597   938
 2 Apod    36194  10347  9173 10620 13021 29594 24959 13668 13230 15868 27769
 3 Cyp2d22  4060   1616  1603  1901  2171  3349  3122  2008  2254  2277  2985
 4 Klk6      287    629   641   578   448   195   186  1101   537   567   327
 5 Fcrls      85    233   244   237   180    38    68   375   199   177    89
 6 Slc2a4    782    231   248   265   313   786   528   249   266   357   654
 7 Exd2     1619   2288  2235  2513  2366  1359  1474  3126  2379  2173  1531
 8 Gjc2      288    595   568   551   310   146   186   791   454   370   240
 9 Plp1    43217 101241 96534 58354 53126 27173 28728 98658 61356 61647 38019
10 Gnb4     1071   1791  1867  1430  1355   798   806  2437  1394  1554   960
# ℹ 1,464 more rows
# ℹ 11 more variables: `24` <dbl>, `8` <dbl>, `7` <dbl>, `1` <dbl>, `16` <dbl>,
#   `21` <dbl>, `4` <dbl>, `2` <dbl>, `20` <dbl>, `12` <dbl>, `19` <dbl>
R
rna1 |>
pivot_longer(names_to = "mouse_id", values_to = "counts", -gene)
OUTPUT
# A tibble: 32,428 × 3
   gene  mouse_id counts
   <chr> <chr>     <dbl>
 1 Asl   14         1170
 2 Asl   9           361
 3 Asl   10          400
 4 Asl   15          586
 5 Asl   18          626
 6 Asl   6           988
 7 Asl   5           836
 8 Asl   11          535
 9 Asl   22          586
10 Asl   13          597
# ℹ 32,418 more rowsسوال
rna ڈیٹا فریم سے X اور Y کروموسومز پر واقع جینز کا ایک
سب سیٹ بنائیں اور ڈیٹا فریم کو sex کو کالموں،
chromosome_name کو قطاروں، اور ہر کروموسوم پر واقع جینز کے
اوسط اظہار کو اقدار کے طور پر استعمال کرتے ہوئے، درج ذیل ٹیبل کی صورت
میں اسپریڈ کریں:
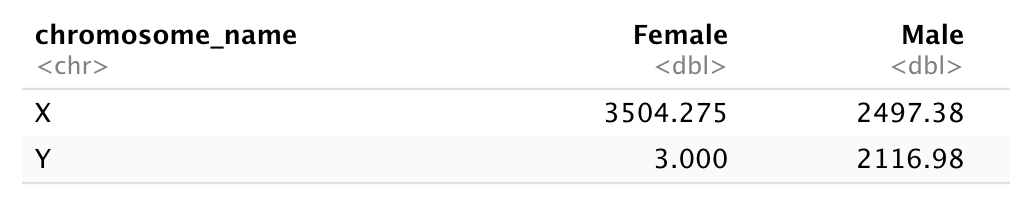
آپ کو ریشیپینگ کرنے سے پہلے خلاصہ تیار کرنے کی ضرورت ہوگی!
آئیے پہلے نر اور مادہ چوہوں کے نمونوں میں X اور Y کروموسومز پر واقع جینز کے اظہار کی اوسط سطح کا حساب لگائیں…
R
 rna |>
  filter(chromosome_name == "Y" | chromosome_name == "X") |>
  group_by(sex, chromosome_name) |>
  summarise(mean = mean(expression))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by sex and chromosome_name.
ℹ Output is grouped by sex.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(sex, chromosome_name))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 4 × 3
# Groups:   sex [2]
  sex    chromosome_name  mean
  <chr>  <chr>           <dbl>
1 Female X               3504.
2 Female Y                  3
3 Male   X               2497.
4 Male   Y               2117.
اور ٹیبل کو وائڈ فارمیٹ میں تبدیل کریں
R
rna_1 <- rna |>
  filter(chromosome_name == "Y" | chromosome_name == "X") |>
  group_by(sex, chromosome_name) |>
  summarise(mean = mean(expression)) |>
  pivot_wider(names_from = sex,
              values_from = mean)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by sex and chromosome_name.
ℹ Output is grouped by sex.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(sex, chromosome_name))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
rna_1
OUTPUT
# A tibble: 2 × 3
  chromosome_name Female  Male
  <chr>            <dbl> <dbl>
1 X                3504. 2497.
2 Y                   3  2117.
اب اس ڈیٹا فریم کو لیں اور اسے pivot_longer() کے ذریعے
تبدیل کریں تاکہ ہر قطار ایک منفرد chromosome_name اور
gender کا مجموعہ ہو۔
R
rna_1 |>
  pivot_longer(names_to = "gender",
               values_to = "mean",
               -chromosome_name)
OUTPUT
# A tibble: 4 × 3
  chromosome_name gender  mean
  <chr>           <chr>  <dbl>
1 X               Female 3504.
2 X               Male   2497.
3 Y               Female    3
4 Y Male 2117.سوال
rna ڈیٹا سیٹ کا استعمال کرتے ہوئے ایک ایکسپریشن میٹرکس
بنائیں جہاں ہر قطار جینز کی اوسط اظہار کی سطحوں کی نمائندگی کرے اور کالم
مختلف وقت کے مقامات کی نمائندگی کریں۔
آئیے پہلے جین کے لحاظ سے اور وقت کے لحاظ سے اوسط اظہار کا حساب لگائیں۔
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression))
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 4,422 × 3
# Groups:   gene [1,474]
   gene      time mean_exp
   <chr>    <dbl>    <dbl>
 1 AI504432     0    1034.
 2 AI504432     4    1104.
 3 AI504432     8    1014
 4 AW046200     0     155.
 5 AW046200     4     152.
 6 AW046200     8      81
 7 AW551984     0     238
 8 AW551984     4     302.
 9 AW551984     8     342.
10 Aamp         0    4603.
# ℹ 4,412 more rows
pivot_wider() فنکشن استعمال کرنے سے پہلے
R
rna_time <- rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
R
rna_time
OUTPUT
# A tibble: 1,474 × 4
# Groups:   gene [1,474]
   gene         `0`     `4`     `8`
   <chr>      <dbl>   <dbl>   <dbl>
 1 AI504432 1034.   1104.   1014
 2 AW046200  155.    152.     81
 3 AW551984  238     302.    342.
 4 Aamp     4603.   4870    4763.
 5 Abca12      5.29    4.25    4.14
 6 Abcc8    2576.   2609.   2292.
 7 Abhd14a   591.    547.    432.
 8 Abi2     4881.   4903.   4945.
 9 Abi3bp   1175.   1061.    762.
10 Abl2     2170.   2078.   2131.
# ℹ 1,464 more rows
نوٹ کریں کہ اس سے ایک ایسا ٹیبل (tibble) بنتا ہے جس کے کچھ کالم کے نام نمبر سے شروع ہوتے ہیں۔ اگر ہم ٹائم پوائنٹس سے متعلق کالم کو منتخب کرنا چاہتے ہوں، تو ہم کالم کے ناموں کو براہِ راست استعمال نہیں کر سکتے… جب ہم کالم 4 کو منتخب کرتے ہیں تو کیا ہوتا ہے؟
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  select(gene, 4)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 1,474 × 2
# Groups:   gene [1,474]
   gene         `8`
   <chr>      <dbl>
 1 AI504432 1014
 2 AW046200   81
 3 AW551984  342.
 4 Aamp     4763.
 5 Abca12      4.14
 6 Abcc8    2292.
 7 Abhd14a   432.
 8 Abi2     4945.
 9 Abi3bp    762.
10 Abl2     2131.
# ℹ 1,464 more rows
ٹائم پوائنٹ 4 کو منتخب کرنے کے لیے، ہمیں کالم کے نام کو کوٹس کرنے پڑیں گے، بیک ٹکس “`” کے ذریعے۔
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  select(gene, `4`)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 1,474 × 2
# Groups:   gene [1,474]
   gene         `4`
   <chr>      <dbl>
 1 AI504432 1104.
 2 AW046200  152.
 3 AW551984  302.
 4 Aamp     4870
 5 Abca12      4.25
 6 Abcc8    2609.
 7 Abhd14a   547.
 8 Abi2     4903.
 9 Abi3bp   1061.
10 Abl2     2078.
# ℹ 1,464 more rows
ایک اور امکان کالم کا نام تبدیل کرنا ہو سکتا ہے، ایسا نام منتخب کرتے ہوئے جو نمبر سے شروع نہ ہو:
R
rna |>
  group_by(gene, time) |>
  summarise(mean_exp = mean(expression)) |>
  pivot_wider(names_from = time,
              values_from = mean_exp) |>
  rename("time0" = `0`, "time4" = `4`, "time8" = `8`) |>
  select(gene, time4)
OUTPUT
`summarise()` has regrouped the output.
ℹ Summaries were computed grouped by gene and time.
ℹ Output is grouped by gene.
ℹ Use `summarise(.groups = "drop_last")` to silence this message.
ℹ Use `summarise(.by = c(gene, time))` for per-operation grouping
  (`?dplyr::dplyr_by`) instead.
OUTPUT
# A tibble: 1,474 × 2
# Groups:   gene [1,474]
   gene       time4
   <chr>      <dbl>
 1 AI504432 1104.
 2 AW046200  152.
 3 AW551984  302.
 4 Aamp     4870
 5 Abca12      4.25
 6 Abcc8    2609.
 7 Abhd14a   547.
 8 Abi2     4903.
 9 Abi3bp   1061.
10 Abl2     2078.
# ℹ 1,464 more rowsسوال
ہر ٹائم پوائنٹ کے لیے اوسط اظہار کی سطحوں پر مشتمل پچھلے ڈیٹا فریم کا استعمال کریں اور ایک نیا کالم بنائیں جس میں ٹائم پوائنٹ 8 اور ٹائم پوائنٹ 0 کے درمیان فولڈ چینجز، اور ٹائم پوائنٹ 8 اور ٹائم پوائنٹ 4 کے درمیان فولڈ چینجز شامل ہوں۔ اس ٹیبل کو ایک لانگ فارمیٹ ٹیبل میں تبدیل کریں جس میں حساب کیے گئے فولڈ چینجز شامل ہوں۔
rna_time tibble سے آغاز کرتے ہوئے:
R
rna_time
OUTPUT
# A tibble: 1,474 × 4
# Groups:   gene [1,474]
   gene         `0`     `4`     `8`
   <chr>      <dbl>   <dbl>   <dbl>
 1 AI504432 1034.   1104.   1014
 2 AW046200  155.    152.     81
 3 AW551984  238     302.    342.
 4 Aamp     4603.   4870    4763.
 5 Abca12      5.29    4.25    4.14
 6 Abcc8    2576.   2609.   2292.
 7 Abhd14a   591.    547.    432.
 8 Abi2     4881.   4903.   4945.
 9 Abi3bp   1175.   1061.    762.
10 Abl2     2170.   2078.   2131.
# ℹ 1,464 more rows
فولڈ چینجز کا حساب لیں:
R
rna_time |>
  mutate(time_8_vs_0 = `8` / `0`, time_8_vs_4 = `8` / `4`)
OUTPUT
# A tibble: 1,474 × 6
# Groups:   gene [1,474]
   gene         `0`     `4`     `8` time_8_vs_0 time_8_vs_4
   <chr>      <dbl>   <dbl>   <dbl>       <dbl>       <dbl>
 1 AI504432 1034.   1104.   1014          0.981       0.918
 2 AW046200  155.    152.     81          0.522       0.532
 3 AW551984  238     302.    342.         1.44        1.13
 4 Aamp     4603.   4870    4763.         1.03        0.978
 5 Abca12      5.29    4.25    4.14       0.784       0.975
 6 Abcc8    2576.   2609.   2292.         0.889       0.878
 7 Abhd14a   591.    547.    432.         0.731       0.791
 8 Abi2     4881.   4903.   4945.         1.01        1.01
 9 Abi3bp   1175.   1061.    762.         0.649       0.719
10 Abl2     2170.   2078.   2131.         0.982       1.03
# ℹ 1,464 more rows
اور pivot_longer() فنکشن کا استعمال کریں:
R
rna_time |>
  mutate(time_8_vs_0 = `8` / `0`, time_8_vs_4 = `8` / `4`) |>
  pivot_longer(names_to = "comparisons",
               values_to = "Fold_changes",
               time_8_vs_0:time_8_vs_4)
OUTPUT
# A tibble: 2,948 × 6
# Groups:   gene [1,474]
   gene         `0`     `4`     `8` comparisons Fold_changes
   <chr>      <dbl>   <dbl>   <dbl> <chr>              <dbl>
 1 AI504432 1034.   1104.   1014    time_8_vs_0        0.981
 2 AI504432 1034.   1104.   1014    time_8_vs_4        0.918
 3 AW046200  155.    152.     81    time_8_vs_0        0.522
 4 AW046200  155.    152.     81    time_8_vs_4        0.532
 5 AW551984  238     302.    342.   time_8_vs_0        1.44
 6 AW551984  238     302.    342.   time_8_vs_4        1.13
 7 Aamp     4603.   4870    4763.   time_8_vs_0        1.03
 8 Aamp     4603.   4870    4763.   time_8_vs_4        0.978
 9 Abca12      5.29    4.25    4.14 time_8_vs_0        0.784
10 Abca12      5.29    4.25    4.14 time_8_vs_4        0.975
# ℹ 2,938 more rows
ٹیبلز کو جوڑنا
حیاتیاتی دنیا کی بہت سی صورتحال میں، ڈیٹا متعدد ٹیبلز میں پھیلا ہوتا ہے۔ عام طور پر ایسا اس لیے ہوتا ہے کیونکہ مختلف اقسام کی معلومات مختلف ذرائع سے جمع کی جاتی ہیں۔
کچھ تجزیوں کے لیے یہ مطلوب ہو سکتا ہے کہ دو یا دو سے زیادہ ٹیبلز کے ڈیٹا کو ایک ایسے کالم کی بنیاد پر ایک ہی ڈیٹا فریم میں یکجا کیا جائے جو تمام ٹیبلز میں مشترک ہو۔
dplyr پیکیج مخصوص کالموں میں مطابقت کی بنیاد پر دو ڈیٹا
فریمز کو یکجا کرنے کے لیے جوائن فنکشنز کا ایک سیٹ فراہم کرتا ہے۔ یہاں،
ہم جوائنز کا ایک مختصر تعارف پیش کرتے ہیں۔ مزید مطالعے کے لیے، براہِ کرم
ٹیبل
جوائنز سے متعلق باب دیکھیں۔ ڈیٹا
ٹرانسفارمیشن چیٹ شیٹ بھی ٹیبل جوائنز کا ایک مختصر جائزہ فراہم کرتی
ہے۔
ہم ایک چھوٹی ٹیبل، rna_mini کے ذریعے جوڑنے کی وضاحت کریں
گے، جسے ہم اصل rna ٹیبل سے سب سیٹ کر کے تیار کریں گے، جس
میں صرف 3 کالم اور 10 قطاریں رکھی جائیں گی۔
R
rna_mini <- rna |>
   select(gene, sample, expression) |>
   head(10)
rna_mini
OUTPUT
# A tibble: 10 × 3
   gene    sample     expression
   <chr>   <chr>           <dbl>
 1 Asl     GSM2545336       1170
 2 Apod    GSM2545336      36194
 3 Cyp2d22 GSM2545336       4060
 4 Klk6    GSM2545336        287
 5 Fcrls   GSM2545336         85
 6 Slc2a4  GSM2545336        782
 7 Exd2    GSM2545336       1619
 8 Gjc2    GSM2545336        288
 9 Plp1    GSM2545336      43217
10 Gnb4    GSM2545336       1071
دوسرا ٹیبل، annot1، میں 2 کالمز، gene اور
gene_description شامل ہیں۔ آپ یا تو لنک پر کلک کر کے annot1.csv
ڈاؤن لوڈ کر سکتے ہیں اور پھر اسے data/ فولڈر میں منتقل
کر سکتے ہیں، یا پھر آپ نیچے دیے گئے R کوڈ کا استعمال کرتے ہوئے اسے براہِ
راست فولڈر میں ڈاؤن لوڈ کر سکتے ہیں۔
R
download.file(url = "https://carpentries-incubator.github.io/bioc-intro/data/annot1.csv",
              destfile = "data/annot1.csv")
annot1 <- read_csv(file = "data/annot1.csv")
annot1
OUTPUT
# A tibble: 10 × 2
   gene    gene_description
   <chr>   <chr>
 1 Cyp2d22 cytochrome P450, family 2, subfamily d, polypeptide 22 [Source:MGI S…
 2 Klk6    kallikrein related-peptidase 6 [Source:MGI Symbol;Acc:MGI:1343166]
 3 Fcrls   Fc receptor-like S, scavenger receptor [Source:MGI Symbol;Acc:MGI:19…
 4 Plp1    proteolipid protein (myelin) 1 [Source:MGI Symbol;Acc:MGI:97623]
 5 Exd2    exonuclease 3'-5' domain containing 2 [Source:MGI Symbol;Acc:MGI:192…
 6 Apod    apolipoprotein D [Source:MGI Symbol;Acc:MGI:88056]
 7 Gnb4    guanine nucleotide binding protein (G protein), beta 4 [Source:MGI S…
 8 Slc2a4  solute carrier family 2 (facilitated glucose transporter), member 4 …
 9 Asl     argininosuccinate lyase [Source:MGI Symbol;Acc:MGI:88084]
10 Gjc2    gap junction protein, gamma 2 [Source:MGI Symbol;Acc:MGI:2153060]
اب ہم dplyr پیکیج کے full_join() فنکشن کا
استعمال کرتے ہوئے ان دو ٹیبلز کو ایک ہی ٹیبل میں یکجا کرنا چاہتے ہیں جس
میں تمام متغیرات شامل ہوں۔ یہ فنکشن خود بخود پہلے اور دوسرے ٹیبل کے
کالموں کو میل کرنے کے لیے مشترکہ متغیر کو تلاش کر لے گا۔ اس صورت میں،
gene مشترکہ متغیر ہے۔ ایسے متغیرات کو کیز (keys) کہا جاتا
ہے۔ کیز کا استعمال مختلف ٹیبلز کے درمیان مشاہدات (observations) کو میل
کرنے کے لیے کیا جاتا ہے۔
R
full_join(rna_mini, annot1)
OUTPUT
Joining with `by = join_by(gene)`OUTPUT
# A tibble: 10 × 4
   gene    sample     expression gene_description
   <chr>   <chr>           <dbl> <chr>
 1 Asl     GSM2545336       1170 argininosuccinate lyase [Source:MGI Symbol;Acc…
 2 Apod    GSM2545336      36194 apolipoprotein D [Source:MGI Symbol;Acc:MGI:88…
 3 Cyp2d22 GSM2545336       4060 cytochrome P450, family 2, subfamily d, polype…
 4 Klk6    GSM2545336        287 kallikrein related-peptidase 6 [Source:MGI Sym…
 5 Fcrls   GSM2545336         85 Fc receptor-like S, scavenger receptor [Source…
 6 Slc2a4  GSM2545336        782 solute carrier family 2 (facilitated glucose t…
 7 Exd2    GSM2545336       1619 exonuclease 3'-5' domain containing 2 [Source:…
 8 Gjc2    GSM2545336        288 gap junction protein, gamma 2 [Source:MGI Symb…
 9 Plp1    GSM2545336      43217 proteolipid protein (myelin) 1 [Source:MGI Sym…
10 Gnb4    GSM2545336       1071 guanine nucleotide binding protein (G protein)…
حقیقی زندگی میں، جین اینوٹیشنز کو کبھی کبھی مختلف طریقے سے لیبل کیا جاتا ہے۔
annot2 ٹیبل بالکل ویسا ہی ہے جیسا annot1،
سوائے اس کے کہ جینز کے ناموں پر مشتمل ویری ایبل کی لیبلنگ مختلف ہے۔ ایک
بار پھر، یا تو خود annot2.csv
ڈاؤن لوڈ کریں اور اسے data/ میں منتقل کریں یا نیچے دیے
گئے R کوڈ کا استعمال کریں۔
R
download.file(url = "https://carpentries-incubator.github.io/bioc-intro/data/annot2.csv",
              destfile = "data/annot2.csv")
annot2 <- read_csv(file = "data/annot2.csv")
annot2
OUTPUT
# A tibble: 10 × 2
   external_gene_name description
   <chr>              <chr>
 1 Cyp2d22            cytochrome P450, family 2, subfamily d, polypeptide 22 [S…
 2 Klk6               kallikrein related-peptidase 6 [Source:MGI Symbol;Acc:MGI…
 3 Fcrls              Fc receptor-like S, scavenger receptor [Source:MGI Symbol…
 4 Plp1               proteolipid protein (myelin) 1 [Source:MGI Symbol;Acc:MGI…
 5 Exd2               exonuclease 3'-5' domain containing 2 [Source:MGI Symbol;…
 6 Apod               apolipoprotein D [Source:MGI Symbol;Acc:MGI:88056]
 7 Gnb4               guanine nucleotide binding protein (G protein), beta 4 [S…
 8 Slc2a4             solute carrier family 2 (facilitated glucose transporter)…
 9 Asl                argininosuccinate lyase [Source:MGI Symbol;Acc:MGI:88084]
10 Gjc2               gap junction protein, gamma 2 [Source:MGI Symbol;Acc:MGI:…
اگر متغیرات کے کوئی بھی نام میل نہ کرے، تو ہم میل کرنے کے لیے استعمال
ہونے والے متغیرات کو دستی طور پر سیٹ کر سکتے ہیں۔ ان متغیرات کو
by آرگومنٹ کے ذریعے سیٹ کیا جا سکتا ہے، جیسا کہ نیچے
rna_mini اور annot2 ٹیبلز کے ساتھ دکھایا گیا
ہے۔
R
full_join(rna_mini, annot2, by = c("gene" = "external_gene_name"))
OUTPUT
# A tibble: 10 × 4
   gene    sample     expression description
   <chr>   <chr>           <dbl> <chr>
 1 Asl     GSM2545336       1170 argininosuccinate lyase [Source:MGI Symbol;Acc…
 2 Apod    GSM2545336      36194 apolipoprotein D [Source:MGI Symbol;Acc:MGI:88…
 3 Cyp2d22 GSM2545336       4060 cytochrome P450, family 2, subfamily d, polype…
 4 Klk6    GSM2545336        287 kallikrein related-peptidase 6 [Source:MGI Sym…
 5 Fcrls   GSM2545336         85 Fc receptor-like S, scavenger receptor [Source…
 6 Slc2a4  GSM2545336        782 solute carrier family 2 (facilitated glucose t…
 7 Exd2    GSM2545336       1619 exonuclease 3'-5' domain containing 2 [Source:…
 8 Gjc2    GSM2545336        288 gap junction protein, gamma 2 [Source:MGI Symb…
 9 Plp1    GSM2545336      43217 proteolipid protein (myelin) 1 [Source:MGI Sym…
10 Gnb4    GSM2545336       1071 guanine nucleotide binding protein (G protein)…
جیسا کہ اوپر دیکھا جا سکتا ہے، پہلے ٹیبل کا ویری ایبل نام جوڑے ہوئے ٹیبل میں برقرار رہا ہے۔
چیلنج:
اس
لنک پر کلک کر کے annot3 ٹیبل ڈاؤن لوڈ کریں اور اس ٹیبل
کو اپنے data/ ریپوزٹری میں رکھیں۔ full_join() فنکشن کا
استعمال کرتے ہوئے، ٹیبلز rna_mini اور annot3
کو جوڑیں۔ جینز Klk6، mt-Tf، mt-Rnr1،
mt-Tv، mt-Rnr2، اور mt-Tl1 کے ساتھ کیا ہوا
ہے؟
R
annot3 <- read_csv("data/annot3.csv")
full_join(rna_mini, annot3)
OUTPUT
# A tibble: 15 × 4
   gene    sample     expression gene_description
   <chr>   <chr>           <dbl> <chr>
 1 Asl     GSM2545336       1170 argininosuccinate lyase [Source:MGI Symbol;Acc…
 2 Apod    GSM2545336      36194 apolipoprotein D [Source:MGI Symbol;Acc:MGI:88…
 3 Cyp2d22 GSM2545336       4060 cytochrome P450, family 2, subfamily d, polype…
 4 Klk6    GSM2545336        287 <NA>
 5 Fcrls   GSM2545336         85 Fc receptor-like S, scavenger receptor [Source…
 6 Slc2a4  GSM2545336        782 solute carrier family 2 (facilitated glucose t…
 7 Exd2    GSM2545336       1619 exonuclease 3'-5' domain containing 2 [Source:…
 8 Gjc2    GSM2545336        288 gap junction protein, gamma 2 [Source:MGI Symb…
 9 Plp1    GSM2545336      43217 proteolipid protein (myelin) 1 [Source:MGI Sym…
10 Gnb4    GSM2545336       1071 guanine nucleotide binding protein (G protein)…
11 mt-Tf   <NA>               NA mitochondrially encoded tRNA phenylalanine [So…
12 mt-Rnr1 <NA>               NA mitochondrially encoded 12S rRNA [Source:MGI S…
13 mt-Tv   <NA>               NA mitochondrially encoded tRNA valine [Source:MG…
14 mt-Rnr2 <NA>               NA mitochondrially encoded 16S rRNA [Source:MGI S…
15 mt-Tl1  <NA>               NA mitochondrially encoded tRNA leucine 1 [Source…
جین Klk6 صرف rna_mini میں موجود ہے، جبکہ جینز
mt-Tf، mt-Rnr1، mt-Tv، mt-Rnr2، اور
mt-Tl1 صرف annot3 ٹیبل میں موجود ہیں۔ ٹیبل کے
متغیرات کے لیے ان کی متعلقہ اقدار کو missing کے طور پر کوڈ کیا گیا
ہے۔
ڈیٹا کی ایکسپورٹنگ
اب جب کہ آپ نے اپنے خام ڈیٹا سے معلومات نکالنے یا اس کا خلاصہ تیار
کرنے کے لیے dplyr کا استعمال سیکھ لیا ہے، ہو سکتا ہے کہ آپ
ان نئے ڈیٹا سیٹس کو ایکسپورٹ کرنا چاہیں تاکہ انہیں اپنے ساتھیوں کے ساتھ
شیئر کر سکیں یا آرکائیو کے لیے محفوظ کر سکیں۔
R میں CSV فائلوں کو پڑھنے کے لیے استعمال ہونے والے
read_csv() فنکشن کی طرح، ایک write_csv() فنکشن
بھی موجود ہے جو ڈیٹا فریمز سے CSV فائلیں تیار کرتا ہے۔
write_csv() استعمال کرنے سے پہلے، ہم اپنی ورکنگ
ڈائریکٹری میں ایک نیا فولڈر، data_output، بنائیں گے جس میں
یہ تیار کردہ ڈیٹا سیٹ محفوظ کیا جائے گا۔ ہم تیار کردہ ڈیٹا سیٹس کو اپنے
خام ڈیٹا کے اسی ڈائریکٹری میں نہیں لکھنا چاہتے۔ انہیں الگ رکھنا ایک بہتر
طریقہ کار ہے۔ data فولڈر میں صرف خام اور غیر تبدیل شدہ ڈیٹا
ہونا چاہیے، اور اسے ایسے ہی رہنے دیا جائے تاکہ اس بات کو یقینی بنایا جا
سکے کہ ہم اسے حذف یا تبدیل نہیں کرتے۔ اس کے برعکس، ہمارا اسکرپٹ
data_output ڈائریکٹری کا مواد تیار کرے گا، لہذا اگر اس میں
موجود فائلیں حذف بھی کر دی جائیں، تو ہم انہیں ہمیشہ دوبارہ تیار کر سکتے
ہیں۔
آئیے write_csv() کا استعمال کریں تاکہ اس rna_wide ٹیبل
کو محفوظ کر سکیں جو ہم نے پہلے تیار کیا تھا۔
R
write_csv(rna_wide, file = "data_output/rna_wide.csv")
- tidyverse میٹا-پیکیج کا استعمال کرتے ہوئے R میں ٹیبلر ڈیٹا