
اگلے اقدامات
Last updated on 2026-11-11 | Edit this page
Estimated time: 90 minutes
Overview
Questions
-
SummarizedExperimentکیا ہے؟ - Bioconductor کیا ہے؟
Objectives
- Bioconductor پروجیکٹ کا تعارف کرائیں۔
- ڈیٹا کنٹینرز کے تصور کا تعارف کرائیں۔
-
SummarizedExperimentکا ایک جائزہ پیش کریں، جسے اومکس تجزیوں میں بڑے پیمانے پر استعمال کیا جاتا ہے۔
اگلے اقدامات
بائیو انفارمیٹکس میں ڈیٹا اکثر پیچیدہ ہوتا ہے۔ اس سے نمٹنے کے لیے، ڈویلپرز مخصوص ڈیٹا کنٹینرز (جنہیں کلاسز کہا جاتا ہے) تعریف کرتے ہیں جو ان ڈیٹا کی خصوصیات کے مطابق ہوں جنہیں انہیں ہینڈل کرنے کی ضرورت ہوتی ہے۔
یہ پہلو Bioconductor1 پروجیکٹ کے لیے مرکزی ہے، جو تمام پیکجز میں ایک ہی کور ڈیٹا انفراسٹرکچر کا استعمال کرتا ہے۔ اس نے یقیناً Bioconductor کی کامیابی میں اہم کردار ادا کیا ہے۔ Bioconductor پیکج ڈویلپرز کو مشورہ دیا جاتا ہے کہ وہ پورے پروجیکٹ میں ہم آہنگی، باہمی طور پر کام کرنے کی صلاحیت اور استحکام فراہم کرنے کے لیے موجودہ انفراسٹرکچر کا استعمال کریں۔
ایسے اومکس ڈیٹا کنٹینر کی وضاحت کے لیے، ہم
SummarizedExperiment کلاس پیش کریں گے۔
SummarizedExperiment
نیچے دیا گیا شکل SummarizedExperiment کلاس کی ساخت کی نمائندگی کرتا ہے۔

SummarizedExperiment کلاس کے آبجیکٹس میں شامل ہیں:
ایک (یا ایک سے زیادہ) ایسے (assay) جن میں مقداری اومکس ڈیٹا (اظہار کا ڈیٹا) شامل ہوتا ہے، جو ایک میٹرکس نما آبجیکٹ کے طور پر محفوظ کیا گیا ہوتا ہے۔ فیچرز (جینز، ٹرانسکرپٹس، پروٹینز، …) قطاروں کے ساتھ، اور نمونے کالموں کے ساتھ متعین کیے گئے ہیں۔
ایک سیمپل میٹا ڈیٹا سلاٹ جس میں سیمپل کے کو-ویری ایٹس شامل ہیں، اور اسے ایک ڈیٹا فریم کے طور پر محفوظ کیا گیا ہے۔ اس ٹیبل کی قطاریں سیمپلز کی نمائندگی کرتی ہیں (قطاریں اظہار کے ڈیٹا کے کالموں سے بالکل مطابقت رکھتی ہیں)۔
ایک فیچر میٹا ڈیٹا سلاٹ جس میں فیچر کے کو-ویری ایٹس شامل ہیں، اور جو ایک ڈیٹا فریم کے طور پر محفوظ کیا گیا ہے۔ اس ڈیٹا فریم کی قطاریں بالکل اظہار کے ڈیٹا کی قطاروں سے مطابقت رکھتی ہیں۔
SummarizedExperiment کی ہم آہنگ نوعیت اس بات کی ضمانت
دیتی ہے کہ ڈیٹا کی ترتیب و تیاری کے دوران، مختلف سلاٹس کے ابعاد ہمیشہ
میل کھائیں گے (یعنی اظہار کے ڈیٹا میں کالم اور پھر سیمپل میٹا ڈیٹا میں
قطاریں، نیز اظہار کے ڈیٹا اور فیچر میٹا ڈیٹا میں قطاریں)۔ مثال کے طور
پر، اگر ہمیں ایسے کے سے ایک سیمپل کو خارج کرنا پڑے، تو وہ اسی آپریشن میں
سیمپل میٹا ڈیٹا سے خود بخود حذف ہو جائے گا۔
میٹا ڈیٹا سلاٹس میں دیگر ساختوں کو متاثر کیے بغیر اضافی کو-ویری ایٹس (کالمز) شامل کیے جا سکتے ہیں۔
SummarizedExperiment کی تخلیق
SummarizedExperiment بنانے کے لیے، ہم انفرادی اجزاء،
یعنی کاؤنٹ میٹرکس، سیمپل اور جین میٹا ڈیٹا کو CSV فائلوں سے تیار کریں
گے۔ عام طور پر RNA-Seq ڈیٹا اسی طرح فراہم کیا جاتا ہے (کچی ڈیٹا کی
پروسیسنگ کے بعد)۔
-
ایک ایکسپریشن میٹرکس: ہم کاؤنٹ میٹرکس لوڈ کرتے ہیں،
یہ واضح کرتے ہیں کہ پہلے کالم میں قطاروں/جینز کے نام شامل ہیں، اور
data.frameکوmatrixمیں تبدیل کرتے ہیں۔ آپ اسے اس لنک پر کلک کر کے ڈاؤن لوڈ کر سکتے ہیں۔
R
count_matrix <- read.csv("data/count_matrix.csv",
                         row.names = 1) |>
    as.matrix()

count_matrix[1:5, ]
OUTPUT
        GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
Asl           1170        361        400        586        626        988
Apod         36194      10347       9173      10620      13021      29594
Cyp2d22       4060       1616       1603       1901       2171       3349
Klk6           287        629        641        578        448        195
Fcrls           85        233        244        237        180         38
        GSM2545342 GSM2545343 GSM2545344 GSM2545345 GSM2545346 GSM2545347
Asl            836        535        586        597        938       1035
Apod         24959      13668      13230      15868      27769      34301
Cyp2d22       3122       2008       2254       2277       2985       3452
Klk6           186       1101        537        567        327        233
Fcrls           68        375        199        177         89         67
        GSM2545348 GSM2545349 GSM2545350 GSM2545351 GSM2545352 GSM2545353
Asl            494        481        666        937        803        541
Apod         11258      11812      15816      29242      20415      13682
Cyp2d22       1883       2014       2417       3678       2920       2216
Klk6           742        881        828        250        798        710
Fcrls          300        233        231         81        303        285
        GSM2545354 GSM2545362 GSM2545363 GSM2545380
Asl            473        748        576       1192
Apod         11088      15916      11166      38148
Cyp2d22       1821       2842       2011       4019
Klk6           894        501        598        259
Fcrls          248        179        184         68
R
dim(count_matrix)
OUTPUT
[1] 1474 22- نمونوں کی وضاحت کرنے والا ایک ٹیبل، جو اس لنک پر دستیاب ہے۔
R
sample_metadata <- read.csv("data/sample_metadata.csv")
sample_metadata
OUTPUT
       sample     organism age    sex   infection  strain time     tissue mouse
1  GSM2545336 Mus musculus   8 Female  InfluenzaA C57BL/6    8 Cerebellum    14
2  GSM2545337 Mus musculus   8 Female NonInfected C57BL/6    0 Cerebellum     9
3  GSM2545338 Mus musculus   8 Female NonInfected C57BL/6    0 Cerebellum    10
4  GSM2545339 Mus musculus   8 Female  InfluenzaA C57BL/6    4 Cerebellum    15
5  GSM2545340 Mus musculus   8   Male  InfluenzaA C57BL/6    4 Cerebellum    18
6  GSM2545341 Mus musculus   8   Male  InfluenzaA C57BL/6    8 Cerebellum     6
7  GSM2545342 Mus musculus   8 Female  InfluenzaA C57BL/6    8 Cerebellum     5
8  GSM2545343 Mus musculus   8   Male NonInfected C57BL/6    0 Cerebellum    11
9  GSM2545344 Mus musculus   8 Female  InfluenzaA C57BL/6    4 Cerebellum    22
10 GSM2545345 Mus musculus   8   Male  InfluenzaA C57BL/6    4 Cerebellum    13
11 GSM2545346 Mus musculus   8   Male  InfluenzaA C57BL/6    8 Cerebellum    23
12 GSM2545347 Mus musculus   8   Male  InfluenzaA C57BL/6    8 Cerebellum    24
13 GSM2545348 Mus musculus   8 Female NonInfected C57BL/6    0 Cerebellum     8
14 GSM2545349 Mus musculus   8   Male NonInfected C57BL/6    0 Cerebellum     7
15 GSM2545350 Mus musculus   8   Male  InfluenzaA C57BL/6    4 Cerebellum     1
16 GSM2545351 Mus musculus   8 Female  InfluenzaA C57BL/6    8 Cerebellum    16
17 GSM2545352 Mus musculus   8 Female  InfluenzaA C57BL/6    4 Cerebellum    21
18 GSM2545353 Mus musculus   8 Female NonInfected C57BL/6    0 Cerebellum     4
19 GSM2545354 Mus musculus   8   Male NonInfected C57BL/6    0 Cerebellum     2
20 GSM2545362 Mus musculus   8 Female  InfluenzaA C57BL/6    4 Cerebellum    20
21 GSM2545363 Mus musculus   8   Male  InfluenzaA C57BL/6    4 Cerebellum    12
22 GSM2545380 Mus musculus   8 Female  InfluenzaA C57BL/6    8 Cerebellum    19
R
dim(sample_metadata)
OUTPUT
[1] 22 9- جینز کی وضاحت کرنے والی ایک ٹیبل، جو اس لنک پر دستیاب ہے۔
R
gene_metadata <- read.csv("data/gene_metadata.csv")
gene_metadata[1:10, 1:4]
OUTPUT
      gene ENTREZID
1      Asl   109900
2     Apod    11815
3  Cyp2d22    56448
4     Klk6    19144
5    Fcrls    80891
6   Slc2a4    20528
7     Exd2    97827
8     Gjc2   118454
9     Plp1    18823
10    Gnb4    14696
                                                                         product
1                                 argininosuccinate lyase, transcript variant X1
2                                         apolipoprotein D, transcript variant 3
3   cytochrome P450, family 2, subfamily d, polypeptide 22, transcript variant 2
4                           kallikrein related-peptidase 6, transcript variant 2
5                  Fc receptor-like S, scavenger receptor, transcript variant X1
6            solute carrier family 2 (facilitated glucose transporter), member 4
7                                          exonuclease 3'-5' domain containing 2
8                            gap junction protein, gamma 2, transcript variant 1
9                           proteolipid protein (myelin) 1, transcript variant 1
10 guanine nucleotide binding protein (G protein), beta 4, transcript variant X2
      ensembl_gene_id
1  ENSMUSG00000025533
2  ENSMUSG00000022548
3  ENSMUSG00000061740
4  ENSMUSG00000050063
5  ENSMUSG00000015852
6  ENSMUSG00000018566
7  ENSMUSG00000032705
8  ENSMUSG00000043448
9  ENSMUSG00000031425
10 ENSMUSG00000027669
R
dim(gene_metadata)
OUTPUT
[1] 1474 9ہم ان ٹیبلز سے ایک SummarizedExperiment تیار کریں
گے:
کاؤنٹ میٹرکس جو
assayکے طور پر استعمال کیا جائے گانمونوں کی وضاحت کرنے والی ٹیبل کو sample metadata اسلوٹ کے طور پر استعمال کیا جائے گا۔
جینز کی وضاحت کرنے والی ٹیبل کو features metadata اسلوٹ کے طور پر استعمال کیا جائے گا۔
اس کے لیے ہم SummarizedExperiment کنسٹرکٹر کا استعمال
کرتے ہوئے مختلف حصوں کو یکجا کر سکتے ہیں:
R
## BiocManager::install("SummarizedExperiment")
library("SummarizedExperiment")
پہلے، ہم اس بات کو یقینی بناتے ہیں کہ کاؤنٹ میٹرکس اور سیمپل اینوٹیشن میں نمونے ایک ہی ترتیب میں ہوں، اور کاؤنٹ میٹرکس اور جین اینوٹیشن میں جینز کے لیے بھی یہی ترتیب ہو۔
R
stopifnot(rownames(count_matrix) == gene_metadata$gene)
stopifnot(colnames(count_matrix) == sample_metadata$sample)
R
se <- SummarizedExperiment(assays = list(counts = count_matrix),
                           colData = sample_metadata,
                           rowData = gene_metadata)
se
OUTPUT
class: SummarizedExperiment
dim: 1474 22
metadata(0):
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(9): sample organism ... tissue mouse
ڈیٹا کو محفوظ کرنا
ڈیٹا کو اسپریڈشیٹ میں ایکسپورٹ کرنے میں، جیسا کہ ہم نے ایک پچھلے
ایپیسوڈ میں کیا تھا، کئی حدود ہیں، جیسے کہ پہلے باب میں بیان کی گئی ہیں
(اعشاریہ کے علامت کے طور پر , اور . کے ساتھ
ممکنہ تضادات اور متغیرات کی اقسام کی تعریفوں کی کمی)۔ مزید برآں، ڈیٹا کو
اسپریڈشیٹ میں ایکسپورٹ کرنا صرف مستطیل ڈیٹا، جیسے کہ ڈیٹا فریمز اور
میٹرکسز کے لیے موزوں ہے۔
ڈیٹا محفوظ کرنے کا ایک زیادہ عمومی طریقہ، جو خاص طور پر R کے لیے ہے
اور کسی بھی آپریٹنگ سسٹم پر کام کرنے کی ضمانت دیتا ہے،
saveRDS فنکشن کا استعمال کرنا ہے۔ اس طرح کے آبجیکٹس کو
محفوظ کرنے سے ڈسک پر ایک بائنری نمائندگی (یہاں rds فائل
ایکسٹینشن کا استعمال کرتے ہوئے) تیار ہو جائے گی، جسے
readRDS فنکشن کے ذریعے دوبارہ R میں لوڈ کیا جا سکتا ہے۔
R
saveRDS(se, file = "data_output/se.rds")
rm(se)
se <- readRDS("data_output/se.rds")
head(se)
مختصر یہ کہ، جب بات R سے ڈیٹا محفوظ کرنے اور اسے دوبارہ R میں لوڈ
کرنے کی آتی ہے، تو saveRDS اور readRDS کے
ذریعے محفوظ کرنا اور لوڈ کرنا پسندیدہ طریقہ کار ہے۔ اگر ٹیبل ڈیٹا کو کسی
ایسے شخص کے ساتھ شیئر کرنے کی ضرورت ہو جو R استعمال نہیں کر رہا، تو
ٹیکسٹ پر مبنی اسپریڈشیٹ میں ایکسپورٹ کرنا ایک اچھا متبادل ہے۔
اس ڈیٹا اسٹرکچر کا استعمال کرتے ہوئے، ہم assay فنکشن کے
ذریعے ایکسپریشن میٹرکس تک رسائی حاصل کر سکتے ہیں:
R
head(assay(se))
OUTPUT
        GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
Asl           1170        361        400        586        626        988
Apod         36194      10347       9173      10620      13021      29594
Cyp2d22       4060       1616       1603       1901       2171       3349
Klk6           287        629        641        578        448        195
Fcrls           85        233        244        237        180         38
Slc2a4         782        231        248        265        313        786
        GSM2545342 GSM2545343 GSM2545344 GSM2545345 GSM2545346 GSM2545347
Asl            836        535        586        597        938       1035
Apod         24959      13668      13230      15868      27769      34301
Cyp2d22       3122       2008       2254       2277       2985       3452
Klk6           186       1101        537        567        327        233
Fcrls           68        375        199        177         89         67
Slc2a4         528        249        266        357        654        693
        GSM2545348 GSM2545349 GSM2545350 GSM2545351 GSM2545352 GSM2545353
Asl            494        481        666        937        803        541
Apod         11258      11812      15816      29242      20415      13682
Cyp2d22       1883       2014       2417       3678       2920       2216
Klk6           742        881        828        250        798        710
Fcrls          300        233        231         81        303        285
Slc2a4         271        304        349        715        513        320
        GSM2545354 GSM2545362 GSM2545363 GSM2545380
Asl            473        748        576       1192
Apod         11088      15916      11166      38148
Cyp2d22       1821       2842       2011       4019
Klk6           894        501        598        259
Fcrls          248        179        184         68
Slc2a4         248        350        317        796
R
dim(assay(se))
OUTPUT
[1] 1474 22ہم colData فنکشن کا استعمال کرتے ہوئے سیمپل کے میٹا ڈیٹا
تک رسائی حاصل کر سکتے ہیں:
R
colData(se)
OUTPUT
DataFrame with 22 rows and 9 columns
                sample     organism       age         sex   infection
           <character>  <character> <integer> <character> <character>
GSM2545336  GSM2545336 Mus musculus         8      Female  InfluenzaA
GSM2545337  GSM2545337 Mus musculus         8      Female NonInfected
GSM2545338  GSM2545338 Mus musculus         8      Female NonInfected
GSM2545339  GSM2545339 Mus musculus         8      Female  InfluenzaA
GSM2545340  GSM2545340 Mus musculus         8        Male  InfluenzaA
...                ...          ...       ...         ...         ...
GSM2545353  GSM2545353 Mus musculus         8      Female NonInfected
GSM2545354  GSM2545354 Mus musculus         8        Male NonInfected
GSM2545362  GSM2545362 Mus musculus         8      Female  InfluenzaA
GSM2545363  GSM2545363 Mus musculus         8        Male  InfluenzaA
GSM2545380  GSM2545380 Mus musculus         8      Female  InfluenzaA
                strain      time      tissue     mouse
           <character> <integer> <character> <integer>
GSM2545336     C57BL/6         8  Cerebellum        14
GSM2545337     C57BL/6         0  Cerebellum         9
GSM2545338     C57BL/6         0  Cerebellum        10
GSM2545339     C57BL/6         4  Cerebellum        15
GSM2545340     C57BL/6         4  Cerebellum        18
...                ...       ...         ...       ...
GSM2545353     C57BL/6         0  Cerebellum         4
GSM2545354     C57BL/6         0  Cerebellum         2
GSM2545362     C57BL/6         4  Cerebellum        20
GSM2545363     C57BL/6         4  Cerebellum        12
GSM2545380     C57BL/6         8  Cerebellum        19
R
dim(colData(se))
OUTPUT
[1] 22 9ہم rowData فنکشن کے ذریعے فیچر میٹا ڈیٹا تک بھی رسائی
حاصل کر سکتے ہیں:
R
head(rowData(se))
OUTPUT
DataFrame with 6 rows and 9 columns
               gene  ENTREZID                product    ensembl_gene_id
        <character> <integer>            <character>        <character>
Asl             Asl    109900 argininosuccinate ly.. ENSMUSG00000025533
Apod           Apod     11815 apolipoprotein D, tr.. ENSMUSG00000022548
Cyp2d22     Cyp2d22     56448 cytochrome P450, fam.. ENSMUSG00000061740
Klk6           Klk6     19144 kallikrein related-p.. ENSMUSG00000050063
Fcrls         Fcrls     80891 Fc receptor-like S, .. ENSMUSG00000015852
Slc2a4       Slc2a4     20528 solute carrier famil.. ENSMUSG00000018566
        external_synonym chromosome_name   gene_biotype  phenotype_description
             <character>     <character>    <character>            <character>
Asl        2510006M18Rik               5 protein_coding abnormal circulating..
Apod                  NA              16 protein_coding abnormal lipid homeo..
Cyp2d22             2D22              15 protein_coding abnormal skin morpho..
Klk6                Bssp               7 protein_coding abnormal cytokine le..
Fcrls      2810439C17Rik               3 protein_coding decreased CD8-positi..
Slc2a4            Glut-4              11 protein_coding abnormal circulating..
        hsapiens_homolog_associated_gene_name
                                  <character>
Asl                                       ASL
Apod                                     APOD
Cyp2d22                                CYP2D6
Klk6                                     KLK6
Fcrls                                   FCRL2
Slc2a4                                 SLC2A4
R
dim(rowData(se))
OUTPUT
[1] 1474 9SummarizedExperiment کی سب سیٹنگ
SummarizedExperiment کو بالکل ڈیٹا فریمز کی طرح عددی، کریکٹر یا منطقی انڈیکسز کے ذریعے سب سیٹ کیا جا سکتا ہے۔
نیچے، ہم SummarizedExperiment کلاس کا ایک نیا انسٹنس بناتے ہیں جس میں پہلے 3 نمونوں کی صرف پہلی 5 فیچرز شامل ہیں۔
R
se1 <- se[1:5, 1:3]
se1
OUTPUT
class: SummarizedExperiment
dim: 5 3
metadata(0):
assays(1): counts
rownames(5): Asl Apod Cyp2d22 Klk6 Fcrls
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(3): GSM2545336 GSM2545337 GSM2545338
colData names(9): sample organism ... tissue mouse
R
colData(se1)
OUTPUT
DataFrame with 3 rows and 9 columns
                sample     organism       age         sex   infection
           <character>  <character> <integer> <character> <character>
GSM2545336  GSM2545336 Mus musculus         8      Female  InfluenzaA
GSM2545337  GSM2545337 Mus musculus         8      Female NonInfected
GSM2545338  GSM2545338 Mus musculus         8      Female NonInfected
                strain      time      tissue     mouse
           <character> <integer> <character> <integer>
GSM2545336     C57BL/6         8  Cerebellum        14
GSM2545337     C57BL/6         0  Cerebellum         9
GSM2545338     C57BL/6         0  Cerebellum        10
R
rowData(se1)
OUTPUT
DataFrame with 5 rows and 9 columns
               gene  ENTREZID                product    ensembl_gene_id
        <character> <integer>            <character>        <character>
Asl             Asl    109900 argininosuccinate ly.. ENSMUSG00000025533
Apod           Apod     11815 apolipoprotein D, tr.. ENSMUSG00000022548
Cyp2d22     Cyp2d22     56448 cytochrome P450, fam.. ENSMUSG00000061740
Klk6           Klk6     19144 kallikrein related-p.. ENSMUSG00000050063
Fcrls         Fcrls     80891 Fc receptor-like S, .. ENSMUSG00000015852
        external_synonym chromosome_name   gene_biotype  phenotype_description
             <character>     <character>    <character>            <character>
Asl        2510006M18Rik               5 protein_coding abnormal circulating..
Apod                  NA              16 protein_coding abnormal lipid homeo..
Cyp2d22             2D22              15 protein_coding abnormal skin morpho..
Klk6                Bssp               7 protein_coding abnormal cytokine le..
Fcrls      2810439C17Rik               3 protein_coding decreased CD8-positi..
        hsapiens_homolog_associated_gene_name
                                  <character>
Asl                                       ASL
Apod                                     APOD
Cyp2d22                                CYP2D6
Klk6                                     KLK6
Fcrls                                   FCRL2
ہم سیمپل میٹا ڈیٹا میں سے کسی بھی چیز کی بنیاد پر سب سیٹ کرنے کے لیے
colData() فنکشن یا فیچر میٹا ڈیٹا میں سے کسی بھی چیز کی
بنیاد پر سب سیٹ کرنے کے لیے rowData() کا استعمال بھی کر
سکتے ہیں۔ مثال کے طور پر، یہاں ہم صرف miRNAs اور غیر متاثرہ سیمپلز کو
رکھتے ہیں:
R
se1 <- se[rowData(se)$gene_biotype == "miRNA",
          colData(se)$infection == "NonInfected"]
se1
OUTPUT
class: SummarizedExperiment
dim: 7 7
metadata(0):
assays(1): counts
rownames(7): Mir1901 Mir378a ... Mir128-1 Mir7682
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(7): GSM2545337 GSM2545338 ... GSM2545353 GSM2545354
colData names(9): sample organism ... tissue mouse
R
assay(se1)
OUTPUT
         GSM2545337 GSM2545338 GSM2545343 GSM2545348 GSM2545349 GSM2545353
Mir1901          45         44         74         55         68         33
Mir378a          11          7          9          4         12          4
Mir133b           4          6          5          4          6          7
Mir30c-2         10          6         16         12          8         17
Mir149            1          2          0          0          0          0
Mir128-1          4          1          2          2          1          2
Mir7682           2          0          4          1          3          5
         GSM2545354
Mir1901          60
Mir378a           8
Mir133b           3
Mir30c-2         15
Mir149            2
Mir128-1          1
Mir7682           5
R
colData(se1)
OUTPUT
DataFrame with 7 rows and 9 columns
                sample     organism       age         sex   infection
           <character>  <character> <integer> <character> <character>
GSM2545337  GSM2545337 Mus musculus         8      Female NonInfected
GSM2545338  GSM2545338 Mus musculus         8      Female NonInfected
GSM2545343  GSM2545343 Mus musculus         8        Male NonInfected
GSM2545348  GSM2545348 Mus musculus         8      Female NonInfected
GSM2545349  GSM2545349 Mus musculus         8        Male NonInfected
GSM2545353  GSM2545353 Mus musculus         8      Female NonInfected
GSM2545354  GSM2545354 Mus musculus         8        Male NonInfected
                strain      time      tissue     mouse
           <character> <integer> <character> <integer>
GSM2545337     C57BL/6         0  Cerebellum         9
GSM2545338     C57BL/6         0  Cerebellum        10
GSM2545343     C57BL/6         0  Cerebellum        11
GSM2545348     C57BL/6         0  Cerebellum         8
GSM2545349     C57BL/6         0  Cerebellum         7
GSM2545353     C57BL/6         0  Cerebellum         4
GSM2545354     C57BL/6         0  Cerebellum         2
R
rowData(se1)
OUTPUT
DataFrame with 7 rows and 9 columns
                gene  ENTREZID        product    ensembl_gene_id
         <character> <integer>    <character>        <character>
Mir1901      Mir1901 100316686  microRNA 1901 ENSMUSG00000084565
Mir378a      Mir378a    723889  microRNA 378a ENSMUSG00000105200
Mir133b      Mir133b    723817  microRNA 133b ENSMUSG00000065480
Mir30c-2    Mir30c-2    723964 microRNA 30c-2 ENSMUSG00000065567
Mir149        Mir149    387167   microRNA 149 ENSMUSG00000065470
Mir128-1    Mir128-1    387147 microRNA 128-1 ENSMUSG00000065520
Mir7682      Mir7682 102466847  microRNA 7682 ENSMUSG00000106406
         external_synonym chromosome_name gene_biotype  phenotype_description
              <character>     <character>  <character>            <character>
Mir1901          Mirn1901              18        miRNA                     NA
Mir378a           Mirn378              18        miRNA abnormal mitochondri..
Mir133b          mir 133b               1        miRNA no abnormal phenotyp..
Mir30c-2        mir 30c-2               1        miRNA                     NA
Mir149            Mirn149               1        miRNA increased circulatin..
Mir128-1          Mirn128               1        miRNA no abnormal phenotyp..
Mir7682      mmu-mir-7682               1        miRNA                     NA
         hsapiens_homolog_associated_gene_name
                                   <character>
Mir1901                                     NA
Mir378a                                MIR378A
Mir133b                                MIR133B
Mir30c-2                               MIR30C2
Mir149                                      NA
Mir128-1                              MIR128-1
Mir7682 NAچیلنج
ٹائم 0 اور ٹائم 8 کے نمونوں میں پہلے تین جینز کی جین کے اظہار کی سطحوں کو نکالیں۔
R
assay(se)[1:3, colData(se)$time != 4]
OUTPUT
        GSM2545336 GSM2545337 GSM2545338 GSM2545341 GSM2545342 GSM2545343
Asl           1170        361        400        988        836        535
Apod         36194      10347       9173      29594      24959      13668
Cyp2d22       4060       1616       1603       3349       3122       2008
        GSM2545346 GSM2545347 GSM2545348 GSM2545349 GSM2545351 GSM2545353
Asl            938       1035        494        481        937        541
Apod         27769      34301      11258      11812      29242      13682
Cyp2d22       2985       3452       1883       2014       3678       2216
        GSM2545354 GSM2545380
Asl            473       1192
Apod         11088      38148
Cyp2d22       1821       4019
R
# Equivalent to
assay(se)[1:3, colData(se)$time == 0 | colData(se)$time == 8]
OUTPUT
        GSM2545336 GSM2545337 GSM2545338 GSM2545341 GSM2545342 GSM2545343
Asl           1170        361        400        988        836        535
Apod         36194      10347       9173      29594      24959      13668
Cyp2d22       4060       1616       1603       3349       3122       2008
        GSM2545346 GSM2545347 GSM2545348 GSM2545349 GSM2545351 GSM2545353
Asl            938       1035        494        481        937        541
Apod         27769      34301      11258      11812      29242      13682
Cyp2d22       2985       3452       1883       2014       3678       2216
        GSM2545354 GSM2545380
Asl            473       1192
Apod         11088      38148
Cyp2d22 1821 4019چیلنج
تصدیق کریں کہ لانگ rna ٹیبل کا استعمال کرتے ہوئے آپ کو
وہی اقدار ملتی ہیں۔
R
rna |>
    filter(gene %in% c("Asl", "Apod", "Cyd2d22")) |>
    filter(time != 4) |>
    select(expression)
OUTPUT
# A tibble: 28 × 1
   expression
        <dbl>
 1       1170
 2      36194
 3        361
 4      10347
 5        400
 6       9173
 7        988
 8      29594
 9        836
10      24959
# ℹ 18 more rows
لانگ ٹیبل اور SummarizedExperiment میں ایک ہی معلومات
موجود ہیں، لیکن ان کی ساخت محض مختلف ہے۔ ہر طریقہ کار کے اپنے فوائد ہیں:
پہلا tidyverse پیکیجز کے لیے موزوں ہے، جبکہ دوسرا بہت سے
بائیو انفارمیٹکس اور شماریاتی پروسیسنگ مراحل کے لیے ترجیحی ساخت ہے۔ مثال
کے طور پر، DESeq2 پیکیج کا استعمال کرتے ہوئے ایک معمول کا
RNA-Seq تجزیہ۔
میٹا ڈیٹا میں متغیرات شامل کرنا
ہم میٹا ڈیٹا میں معلومات بھی شامل کر سکتے ہیں۔ فرض کریں کہ آپ اس مرکز کا ذکر شامل کرنا چاہتے ہیں جہاں نمونے جمع کیے گئے تھے…
R
colData(se)$center <- rep("University of Illinois", nrow(colData(se)))
colData(se)
OUTPUT
DataFrame with 22 rows and 10 columns
                sample     organism       age         sex   infection
           <character>  <character> <integer> <character> <character>
GSM2545336  GSM2545336 Mus musculus         8      Female  InfluenzaA
GSM2545337  GSM2545337 Mus musculus         8      Female NonInfected
GSM2545338  GSM2545338 Mus musculus         8      Female NonInfected
GSM2545339  GSM2545339 Mus musculus         8      Female  InfluenzaA
GSM2545340  GSM2545340 Mus musculus         8        Male  InfluenzaA
...                ...          ...       ...         ...         ...
GSM2545353  GSM2545353 Mus musculus         8      Female NonInfected
GSM2545354  GSM2545354 Mus musculus         8        Male NonInfected
GSM2545362  GSM2545362 Mus musculus         8      Female  InfluenzaA
GSM2545363  GSM2545363 Mus musculus         8        Male  InfluenzaA
GSM2545380  GSM2545380 Mus musculus         8      Female  InfluenzaA
                strain      time      tissue     mouse                 center
           <character> <integer> <character> <integer>            <character>
GSM2545336     C57BL/6         8  Cerebellum        14 University of Illinois
GSM2545337     C57BL/6         0  Cerebellum         9 University of Illinois
GSM2545338     C57BL/6         0  Cerebellum        10 University of Illinois
GSM2545339     C57BL/6         4  Cerebellum        15 University of Illinois
GSM2545340     C57BL/6         4  Cerebellum        18 University of Illinois
...                ...       ...         ...       ...                    ...
GSM2545353     C57BL/6         0  Cerebellum         4 University of Illinois
GSM2545354     C57BL/6         0  Cerebellum         2 University of Illinois
GSM2545362     C57BL/6         4  Cerebellum        20 University of Illinois
GSM2545363     C57BL/6         4  Cerebellum        12 University of Illinois
GSM2545380     C57BL/6         8  Cerebellum        19 University of Illinois
یہ ظاہر کرتا ہے کہ میٹا ڈیٹا سلاٹس دیگر ساختوں کو متاثر کیے بغیر لامحدود طور پر بڑھ سکتے ہیں!
tidySummarizedExperiment
شاید آپ سوچ رہے ہوں کہ کیا ہم SummarizedExperiment
آبجیکٹس کے ساتھ تعامل کے لیے tidyverse کمانڈز استعمال کر سکتے ہیں؟ جواب
ہے ہاں، ہم tidySummarizedExperiment پیکیج کے ذریعے ایسا کر
سکتے ہیں۔
یاد رکھیں کہ ہمارا SummarizedExperiment آبجیکٹ کیسا دکھائی دیتا ہے:
R
se
OUTPUT
class: SummarizedExperiment
dim: 1474 22
metadata(0):
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(10): sample organism ... mouse center
tidySummarizedExperiment کو لوڈ کریں اور پھر se آبجیکٹ
کو دوبارہ دیکھیں۔
R
## BiocManager::install("tidySummarizedExperiment")
library("tidySummarizedExperiment")

se
OUTPUT
class: SummarizedExperiment
dim: 1474 22
metadata(0):
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(10): sample organism ... mouse center
یہ اب بھی ایک SummarizedExperiment آبجیکٹ ہے، اس لیے یہ
اپنی موثر ساخت کو برقرار رکھتا ہے، لیکن اب ہم اسے ایک tibble کے طور پر
دیکھ سکتے ہیں۔ نوٹ کریں کہ آؤٹ پٹ کی پہلی لائن میں یہ ذکر ہے کہ یہ ایک
SummarizedExperiment-tibble ابسٹرکشن ہے۔ ہم
آؤٹ پٹ کی دوسری لائن میں ٹرانسکرپٹس اور سیمپلز کی تعداد بھی دیکھ سکتے
ہیں۔
اب ہم SummarizedExperiment آبجیکٹ کے ساتھ تعامل کرنے کے
لیے tidyverse کمانڈز استعمال کر سکتے ہیں۔
ہم کسی شرط کی بنیاد پر قطاروں کو فلٹر کرنے کے لیے filter
استعمال کر سکتے ہیں، مثلاً ایک سیمپل کی تمام قطاریں دیکھنے کے لیے۔
R
se |> filter(sample == "GSM2545336")
OUTPUT
class: SummarizedExperiment
dim: 1474 1
metadata(1): latest_filter_scope_report
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(1): GSM2545336
colData names(10): sample organism ... mouse center
R
se |> filter(sex == "Female")
OUTPUT
class: SummarizedExperiment
dim: 1474 12
metadata(1): latest_filter_scope_report
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(12): GSM2545336 GSM2545337 ... GSM2545362 GSM2545380
colData names(10): sample organism ... mouse center
ہم دیکھنے کے لیے مطلوبہ کالمز کی نشاندہی کرنے کے لیے
select استعمال کر سکتے ہیں۔
R
se |> select(sample, sex)
WARNING
Warning: `when()` was deprecated in purrr 1.0.0.
ℹ Please use `if` instead.
ℹ The deprecated feature was likely used in the tidySummarizedExperiment
  package.
  Please report the issue at
  <https://github.com/stemangiola/tidySummarizedExperiment/issues>.
This warning is displayed once per session.
Call `lifecycle::last_lifecycle_warnings()` to see where this warning was
generated.
OUTPUT
tidySummarizedExperiment says: Key columns are missing. A data frame is returned for independent data analysis.OUTPUT
# A tibble: 32,428 × 2
   sample     sex
   <chr>      <chr>
 1 GSM2545336 Female
 2 GSM2545336 Female
 3 GSM2545336 Female
 4 GSM2545336 Female
 5 GSM2545336 Female
 6 GSM2545336 Female
 7 GSM2545336 Female
 8 GSM2545336 Female
 9 GSM2545336 Female
10 GSM2545336 Female
# ℹ 32,418 more rows
ہم میٹا ڈیٹا کی معلومات شامل کرنے کے لیے mutate استعمال
کر سکتے ہیں۔
R
se |> mutate(center = "Heidelberg University")
OUTPUT
class: SummarizedExperiment
dim: 1474 22
metadata(1): latest_mutate_scope_report
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(10): sample organism ... mouse center
ہم کمانڈز کو tidyverse پائپ |> کے ذریعے بھی یکجا کر
سکتے ہیں۔ مثال کے طور پر، ہم ہر سیمپل کے لیے کل گنتیاں حاصل کرنے کے لیے
group_by اور summarise کو یکجا کر سکتے
ہیں۔
R
se |>
    group_by(.sample) |>
    summarise(total_counts=sum(counts))
OUTPUT
tidySummarizedExperiment says: A data frame is returned for independent data analysis.OUTPUT
# A tibble: 22 × 2
   .sample    total_counts
   <chr>             <int>
 1 GSM2545336      3039671
 2 GSM2545337      2602360
 3 GSM2545338      2458618
 4 GSM2545339      2500082
 5 GSM2545340      2479024
 6 GSM2545341      2413723
 7 GSM2545342      2349728
 8 GSM2545343      3105652
 9 GSM2545344      2524137
10 GSM2545345      2506038
# ℹ 12 more rows
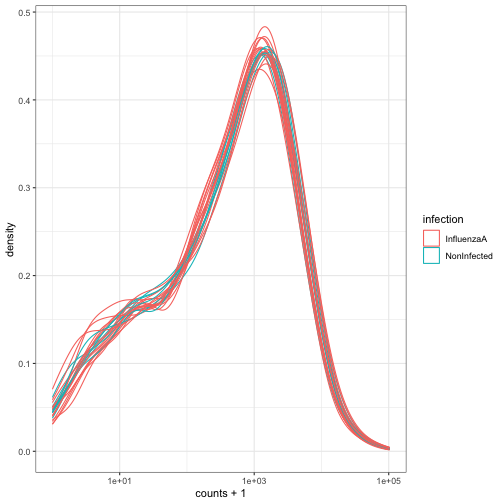
ہم tidy SummarizedExperiment آبجیکٹ کو پلوٹنگ کے لیے ایک عام tibble کے طور پر استعمال کر سکتے ہیں۔
یہاں ہم ہر نمونے کے لحاظ سے گنتیوں کی تقسیم کو پلوٹ کرتے ہیں۔
R
se |>
    ggplot(aes(counts + 1, group=.sample, color=infection)) +
    geom_density() +
    scale_x_log10() +
    theme_bw()
tidySummarizedExperiment کے بارے میں مزید معلومات کے
لیے، پیکیج کی
ویب سائٹ دیکھیں۔
اہم نکتہ
SummarizedExperimentاومکس ڈیٹا کو محفوظ کرنے اور اسے سنبھالنے کا ایک مؤثر طریقہ ہے۔انہیں بہت سے Bioconductor پیکیجز میں استعمال کیا جاتا ہے۔
اگر آپ RNA سیکوئنسنگ تجزیے پر مرکوز اگلی تربیت کا پیروی کریں گے، تو
آپ Bioconductor DESeq2 پیکیج کا استعمال کر کے کچھ ڈیفرنشل
ایکسپریشن تجزیے کرنا سیکھیں گے۔ DESeq2 پیکیج کا پورا تجزیہ
ایک SummarizedExperiment میں کیا جاتا ہے۔
- Bioconductor ایک ایسا پروجیکٹ ہے جو ہائی تھروپٹ بائیولوجی ڈیٹا کی تفہیم کے لیے معاونت اور پیکیجز فراہم کرتا ہے۔
-
SummarizedExperimentایک ایسی اشیاء کی قسم ہے جو ہائی-تھروپٹ اومکس ڈیٹا کو محفوظ کرنے اور اس کے انتظام کے لیے مفید ہے۔
Bioconductor کا آغاز رابرٹ جینٹل مین نے کیا، جو R زبان کے دو تخلیق کاروں میں سے ایک ہیں۔ Bioconductor اومکس ڈیٹا تجزیے کے لیے مخصوص ٹولز فراہم کرتا ہے۔ Bioconductor R شماریاتی پروگرامنگ زبان کا استعمال کرتا ہے اور یہ اوپن سورس اور اوپن ڈویلپمنٹ پر مبنی ہے۔↩︎