
Introducción a R
Última actualización: 2026-11-11 | Mejora esta página
Hoja de ruta
Preguntas
- Primeros comandos en R
Objetivos
- Defina los siguientes términos en relación con R: objeto, asignar, llamar, función, argumentos, opciones.
- Asignar valores a objetos en R.
- Aprenda a nombrar objetos
- Utilice comentarios para documentar el script.
- Realizar operaciones aritméticas sencillas en R.
- Llama a funciones y utiliza argumentos para cambiar sus opciones predeterminadas.
- Inspeccionar el contenido de los vectores y manipular dicho contenido.
- Seleccionar subconjuntos y extraer valores de vectores.
- Analizar vectores con datos faltantes.
Este episodio se basa en la lección Data Analysis and Visualisation in R for Ecologists de Data Carpentries.
Creación de objetos en R
Puede obtener resultados de R simplemente escribiendo matemáticas en la consola:
R
3 + 5
SALIDA
[1] 8R
12 / 7
SALIDA
[1] 1.714286Sin embargo, para hacer cosas útiles e interesantes, necesitamos
asignar valores a objetos. Para crear un objeto,
debemos darle un nombre seguido del operador de asignación
<- y el valor que queremos asignarle:
R
weight_kg <- 55
<- es el operador de asignación. Asigna valores de la
derecha a objetos de la izquierda. Por lo tanto, tras ejecutar
x <- 3, el valor de x es 3. La
flecha puede interpretarse como 3 entra en
x. Por razones históricas, también se puede usar
= para las asignaciones, pero no en todos los contextos.
Debido a las ligeras
diferencias en la sintaxis, es buena práctica utilizar siempre
<- para las asignaciones.
En RStudio, escribir Alt + - (presionar
Alt al mismo tiempo que la tecla -) escribirá
<- con un solo toque de tecla en una PC, mientras que
escribir Option + - (presionar Option
al mismo tiempo que la tecla -) hace lo mismo en una Mac.
Nombres de variables
Los objetos pueden recibir cualquier nombre, como x,
current_temperature o subject_id. Es
recomendable que los nombres de los objetos sean explícitos y no
demasiado largos. No pueden comenzar con un número (2x no
es válido, pero x2 sí). R distingue entre mayúsculas y
minúsculas (por ejemplo, weight_kg es diferente de
Weight_kg). Hay algunos nombres que no pueden utilizarse
porque son nombres de funciones fundamentales en R (por ejemplo,
if, else, for; consulte la página
del manual Palabras
reservadas en R para obtener una lista completa). En general, aunque
esté permitido, lo mejor es no utilizar otros nombres de funciones (por
ejemplo, c, T, mean,
data, df, weights). En caso de
duda, consulte la ayuda para ver si el nombre ya está en uso. También es
recomendable evitar los puntos (.) dentro del nombre de un
objeto, como en my.dataset. Hay muchas funciones en R con
puntos en sus nombres por razones históricas, pero dado que los puntos
tienen un significado especial en R (para los métodos) y en otros
lenguajes de programación, lo mejor es evitarlos. También se recomienda
utilizar sustantivos para los nombres de los objetos y verbos para los
nombres de las funciones. Es importante ser coherente en el estilo de su
código (dónde coloca los espacios, cómo nombra los objetos, etc.).
Utilizar un estilo de codificación coherente hace que su código sea más
fácil de leer tanto para usted mismo en el futuro como para sus
colaboradores. En R, algunas de las guías de estilo más populares son la
de Google,
el estilo de tidyverse y la
guía
de estilo de Bioconductor. La de tidyverse es muy exhaustiva y puede
parecer abrumadora al principio. Puede instalar el paquete lintr
para comprobar automáticamente si hay problemas en el estilo de su
código.
Objetos vs. variables: Lo que se conoce como
objectsenRse conoce comovariablesen muchos otros lenguajes de programación. Dependiendo del contexto,objectyvariablepueden tener significados drásticamente diferentes. Sin embargo, en esta lección, ambos términos se utilizan como sinónimos. Para más información, consulte aquí.
Al asignar un valor a un objeto, R no imprime nada. Puede obligar a R a imprimir el valor utilizando paréntesis o escribiendo el nombre del objeto:
R
weight_kg <- 55    # doesn't print anything
(weight_kg <- 55)  # but putting parenthesis around the call prints the value of `weight_kg`
SALIDA
[1] 55R
weight_kg # and so does typing the name of the object
SALIDA
[1] 55Ahora que R tiene weight_kg en la memoria, podemos
realizar operaciones aritméticas con él. Por ejemplo, es posible que
queramos convertir este peso a libras (el peso en libras es 2,2 veces el
peso en kg):
R
2.2 * weight_kg
SALIDA
[1] 121También podemos cambiar el valor de un objeto asignándole uno nuevo:
R
weight_kg <- 57.5
2.2 * weight_kg
SALIDA
[1] 126.5Esto significa que asignar un valor a un objeto no cambia los valores
de otros objetos. Por ejemplo, guardemos el peso del animal en libras en
un nuevo objeto, weight_lb:
R
weight_lb <- 2.2 * weight_kg
y luego cambiar weight_kg a 100.
R
weight_kg <- 100
Desafío:
¿Cuál crees que es el contenido actual del objeto
weight_lb? ¿126.5 o 220?
Comentarios
El carácter de comentario en R es #; todo lo que
aparezca a la derecha de un # en un script será ignorado
por R. Es útil dejar notas y explicaciones en sus scripts.
RStudio facilita la forma de comentar o descomentar un párrafo: después de seleccionar las líneas que desee comentar, presione simultáneamente Ctrl + Shift + C en su teclado. Si solo desea comentar una línea, puede colocar el cursor en cualquier punto de dicha línea (es decir, no es necesario seleccionar toda la línea) y luego presionar Ctrl + Shift + C.
Desafío
¿Cuáles son los valores después de cada instrucción en lo siguiente?
R
mass <- 47.5            # mass?
age  <- 122             # age?
mass <- mass * 2.0      # mass?
age  <- age - 20        # age?
mass_index <- mass/age  # mass_index?
Funciones y sus argumentos
Las funciones son “scripts predefinidos” que automatizan conjuntos de
comandos más complejos, incluyendo operaciones, asignaciones, etc.
Muchas funciones están predefinidas o pueden ponerse a disposición
importando paquetes de R (hablaremos más de esto más adelante).
Una función suele recibir una o más entradas denominadas
argumentos. Las funciones a menudo (aunque no siempre)
devuelven un valor. Un ejemplo típico sería la función
sqrt(). La entrada (el argumento) debe ser un número, y el
valor de retorno (de hecho, la salida) es la raíz cuadrada de ese
número. Ejecutar una función (‘correrla’) se denomina llamar a
la función. Un ejemplo de llamada a función es:
R
b <- sqrt(a)
Aquí, el valor de a se pasa a la función
sqrt(), la función sqrt() calcula la raíz
cuadrada y devuelve el valor, que luego se asigna al objeto
b. Esta función es muy sencilla, ya que solo acepta un
argumento.
El «valor» de retorno de una función no tiene por qué ser numérico
(como el de sqrt()), ni tiene por qué ser un único
elemento: puede ser un conjunto de elementos, o incluso un conjunto de
datos. Veremos esto cuando leyamos archivos de datos en R.
Los argumentos pueden ser cualquier cosa, no solo números o nombres de archivos, sino también otros objetos. El significado exacto de cada argumento varía según la función y debe consultarse en la documentación (ver más abajo). Algunas funciones aceptan argumentos que pueden ser especificados por el usuario o, si se omiten, asumen un valor predeterminado: estos se denominan opciones. Las opciones se utilizan habitualmente para modificar la forma en que funciona la función, como si ignora los «valores incorrectos» o qué símbolo utilizar en un gráfico. Sin embargo, si desea algo específico, puede especificar el valor de su elección, que se utilizará en lugar del predeterminado.
Probemos una función que pueda recibir múltiples argumentos:
round().
R
round(3.14159)
SALIDA
[1] 3Aquí, hemos llamado a round() con un solo argumento,
3.14159, y ha devuelto el valor 3. Esto se
debe a que el valor predeterminado es redondear al número entero más
cercano. Si queremos más dígitos, podemos ver cómo hacerlo obteniendo
información sobre la función round. Podemos usar
args(round) o consultar la ayuda de esta función mediante
?round.
R
args(round)
SALIDA
function (x, digits = 0, ...)
NULL
R
?round
Vemos que si queremos un número diferente de dígitos, podemos
escribir digits=2 o cuantos queramos.
R
round(3.14159, digits = 2)
SALIDA
[1] 3.14Si proporcionas los argumentos exactamente en el mismo orden en que están definidos, no es necesario asignarles nombres:
R
round(3.14159, 2)
SALIDA
[1] 3.14Y si se indican los nombres de los argumentos, se puede cambiar su orden:
R
round(digits = 2, x = 3.14159)
SALIDA
[1] 3.14Es una buena práctica colocar primero los argumentos obligatorios (como el número que se está redondeando) en la llamada a la función, y especificar los nombres de todos los argumentos opcionales. Si no lo haces, alguien que lea tu código podría tener que consultar la definición de una función con argumentos desconocidos para comprender qué estás haciendo. Al especificar los nombres de los argumentos, también te proteges contra posibles cambios futuros en la interfaz de la función, que podrían añadir nuevos argumentos entre los existentes.
Vectores y tipos de datos
Un vector es el tipo de dato más común y básico en R, y es
prácticamente el motor de R. Un vector se compone de una serie de
valores, como números o caracteres. Podemos asignar una serie de valores
a un vector utilizando la función c(). Por ejemplo, podemos
crear un vector de pesos de animales y asignarlo a un nuevo objeto
weight_g:
R
weight_g <- c(50, 60, 65, 82)
weight_g
SALIDA
[1] 50 60 65 82Un vector también puede contener caracteres:
R
molecules <- c("dna", "rna", "protein")
molecules
SALIDA
[1] "dna" "rna" "protein"Las comillas alrededor de “dna”, “rna”, etc., son esenciales aquí.
Sin las comillas, R asumirá que existen objetos llamados
dna, rna y protein. Como estos
objetos no existen en la memoria de R, aparecerá un mensaje de
error.
Existen muchas funciones que permiten inspeccionar el contenido de un
vector. length() indica cuántos elementos contiene un
vector determinado:
R
length(weight_g)
SALIDA
[1] 4R
length(molecules)
SALIDA
[1] 3Una característica importante de un vector es que todos los elementos
son del mismo tipo de dato. La función class() indica la
clase (el tipo de elemento) de un objeto:
R
class(weight_g)
SALIDA
[1] "numeric"R
class(molecules)
SALIDA
[1] "character"La función str() proporciona una visión general de la
estructura de un objeto y de sus elementos. Es una función útil al
trabajar con objetos grandes y complejos:
R
str(weight_g)
SALIDA
num [1:4] 50 60 65 82R
str(molecules)
SALIDA
chr [1:3] "dna" "rna" "protein"Puede utilizar la función c() para añadir otros
elementos a su vector:
R
weight_g <- c(weight_g, 90) # add to the end of the vector
weight_g <- c(30, weight_g) # add to the beginning of the vector
weight_g
SALIDA
[1] 30 50 60 65 82 90En la primera línea, tomamos el vector original
weight_g, añadimos el valor 90 al final y
guardamos el resultado de nuevo en weight_g. Luego añadimos
el valor 30 al principio, guardando nuevamente el resultado
en weight_g.
Podemos hacer esto una y otra vez para ampliar un vector o armar un conjunto de datos. A medida que programamos, esto puede resultar útil para añadir los resultados que estamos recopilando o calculando.
Un vector atómico es el tipo de
datos más sencillo de R y es un vector lineal de un único tipo.
Arriba, vimos 2 de los 6 tipos principales de vectores
atómicos que utiliza R: "character" y
"numeric" (o "double"). Estos son los
elementos básicos a partir de los cuales se construyen todos los objetos
de R. Los otros 4 tipos de vectores atómicos son:
-
"logical"paraTRUEyFALSE(el tipo de dato booleano) -
"integer"para números enteros (p. ej.,2L, elLindica a R que se trata de un número entero) -
"complex"para representar números complejos con partes real e imaginaria (p. ej.,1 + 4i) y eso es todo lo que diremos sobre ellos -
"raw"para flujos de bits que no analizaremos más adelante
Puedes comprobar el tipo de tu vector utilizando la función
typeof() y pasando tu vector como argumento.
Los vectores son una de las muchas estructuras de
datos que utiliza R. Otras importantes son las listas
(list), las matrices (matrix), las tablas de
datos (data.frame), los factores (factor) y
los arrays (array).
Desafío:
Hemos visto que los vectores atómicos pueden ser de tipo carácter, numérico (o double), entero y lógico. Pero, ¿qué sucede si intentamos mezclar estos tipos en un único vector?
R los convierte implícitamente para que tengan todos el mismo tipo
Desafío:
¿Qué pasará en cada uno de estos ejemplos? (pista: usa
class() para comprobar el tipo de datos de tus objetos y
escribe sus nombres para ver qué sucede):
R
num_char <- c(1, 2, 3, "a")
num_logical <- c(1, 2, 3, TRUE, FALSE)
char_logical <- c("a", "b", "c", TRUE)
tricky <- c(1, 2, 3, "4")
R
class(num_char)
SALIDA
[1] "character"R
num_char
SALIDA
[1] "1" "2" "3" "a"R
class(num_logical)
SALIDA
[1] "numeric"R
num_logical
SALIDA
[1] 1 2 3 1 0R
class(char_logical)
SALIDA
[1] "character"R
char_logical
SALIDA
[1] "a" "b" "c" "TRUE"R
class(tricky)
SALIDA
[1] "character"R
tricky
SALIDA
[1] "1" "2" "3" "4"Desafío:
¿Por qué crees que sucede?
Los vectores pueden tener un solo tipo de dato. R intenta convertir el contenido de este vector (mediante coerción) para encontrar un denominador común que no pierda ninguna información.
Desafío:
¿Cuántos valores en combined_logical son
"TRUE" (como cadena de caracteres) en el siguiente
ejemplo?
R
num_logical <- c(1, 2, 3, TRUE)
char_logical <- c("a", "b", "c", TRUE)
combined_logical <- c(num_logical, char_logical)
Solo uno. No hay memoria de los tipos de datos anteriores, y la
coerción ocurre la primera vez que se evalúa el vector. Por lo tanto, el
TRUE en num_logical se convierte en un
1 antes de que se convierta en un "1" en
combined_logical.
R
combined_logical
SALIDA
[1] "1" "2" "3" "1" "a" "b" "c" "TRUE"Desafío:
En R, llamamos coerción al proceso de convertir objetos de una clase a otra. Estas conversiones ocurren según una jerarquía, mediante la cual algunos tipos se convierten preferentemente a otros. ¿Puedes dibujar un diagrama que represente la jerarquía de cómo se convierten estos tipos de datos?
lógico → numérico → carácter ← lógico
Selección de subconjuntos de vectores
Si queremos extraer uno o varios valores de un vector, debemos proporcionar uno o varios índices entre corchetes. Por ejemplo:
R
molecules <- c("dna", "rna", "peptide", "protein")
molecules[2]
SALIDA
[1] "rna"R
molecules[c(3, 2)]
SALIDA
[1] "peptide" "rna" También podemos repetir los índices para crear un objeto con más elementos que el original:
R
more_molecules <- molecules[c(1, 2, 3, 2, 1, 4)]
more_molecules
SALIDA
[1] "dna" "rna" "peptide" "rna" "dna" "protein"Los índices de R comienzan en 1. Los lenguajes de programación como Fortran, MATLAB, Julia y R comienzan a contar desde 1, ya que es lo que suelen hacer los seres humanos. Los lenguajes de la familia C (incluidos C++, Java, Perl y Python) cuentan desde 0 porque es más sencillo para las computadoras.
Por último, también es posible obtener todos los elementos de un vector, excepto algunos elementos especificados, utilizando índices negativos:
R
molecules ## all molecules
SALIDA
[1] "dna" "rna" "peptide" "protein"R
molecules[-1] ## all but the first one
SALIDA
[1] "rna" "peptide" "protein"R
molecules[-c(1, 3)] ## all but 1st/3rd ones
SALIDA
[1] "rna" "protein"R
molecules[c(-1, -3)] ## all but 1st/3rd ones
SALIDA
[1] "rna" "protein"Selección condicional de subconjuntos
Otra forma común de obtener un subconjunto es utilizar un vector
lógico. TRUE seleccionará el elemento con el mismo índice,
mientras que FALSE no lo hará:
R
weight_g <- c(21, 34, 39, 54, 55)
weight_g[c(TRUE, FALSE, TRUE, TRUE, FALSE)]
SALIDA
[1] 21 39 54Por lo general, estos vectores lógicos no se escriben a mano, sino que son el resultado de otras funciones o pruebas lógicas. Por ejemplo, si quisiera seleccionar únicamente los valores superiores a 50:
R
## will return logicals with TRUE for the indices that meet
## the condition
weight_g > 50
SALIDA
[1] FALSE FALSE FALSE TRUE TRUER
## so we can use this to select only the values above 50
weight_g[weight_g > 50]
SALIDA
[1] 54 55Puede combinar múltiples pruebas utilizando & (ambas
condiciones son ciertas, Y) o | (al menos una de las
condiciones es cierta, O):
R
weight_g[weight_g < 30 | weight_g > 50]
SALIDA
[1] 21 54 55R
weight_g[weight_g >= 30 & weight_g == 21]
SALIDA
numeric(0)Aquí, < significa “menor que”, >
“mayor que”, >= “mayor o igual que” y ==
“igual a”. El doble signo de igual == es una prueba de
igualdad numérica entre el lado izquierdo y el derecho, y no debe
confundirse con el signo único =, que realiza la asignación
de variables (de manera similar a <-).
Una tarea común es buscar ciertas cadenas en un vector. Se podría
utilizar el operador “o” | para comprobar la igualdad con
múltiples valores, pero esto puede volverse rápidamente tedioso. La
función %in% permite comprobar si se encuentra alguno de
los elementos de un vector de búsqueda:
R
molecules <- c("dna", "rna", "protein", "peptide")
molecules[molecules == "rna" | molecules == "dna"] # returns both rna and dna
SALIDA
[1] "dna" "rna"R
molecules %in% c("rna", "dna", "metabolite", "peptide", "glycerol")
SALIDA
[1] TRUE TRUE FALSE TRUER
molecules[molecules %in% c("rna", "dna", "metabolite", "peptide", "glycerol")]
SALIDA
[1] "dna" "rna" "peptide"Desafío:
¿Puedes descifrar por qué "four" > "five" devuelve
TRUE?
R
"four" > "five"
SALIDA
[1] TRUEAl utilizar > o < en cadenas, R
compara su orden alfabético. En este caso, "four" aparece
después de "five" y, por lo tanto, es mayor que
este.
Nombres
Es posible asignar nombres a cada elemento de un vector. El bloque de código a continuación muestra un vector inicial sin nombres, cómo se establecen y se recuperan los nombres.
R
x <- c(1, 5, 3, 5, 10)
names(x) ## no names
SALIDA
NULLR
names(x) <- c("A", "B", "C", "D", "E")
names(x) ## now we have names
SALIDA
[1] "A" "B" "C" "D" "E"Cuando un vector tiene nombres, es posible acceder a los elementos por su nombre, además de por su índice.
R
x[c(1, 3)]
SALIDA
A C
1 3
R
x[c("A", "C")]
SALIDA
A C
1 3
Datos faltantes
Dado que R fue diseñado para analizar conjuntos de datos, incluye el
concepto de datos faltantes (algo poco común en otros lenguajes de
programación). Los datos faltantes se representan en los vectores como
NA.
Al realizar operaciones con números, la mayoría de las funciones
devolverán NA si los datos con los que se trabaja incluyen
valores faltantes. Esta característica dificulta pasar por alto los
casos en los que se manejan datos faltantes. Puede añadir el argumento
na.rm = TRUE para calcular el resultado ignorando los
valores faltantes.
R
heights <- c(2, 4, 4, NA, 6)
mean(heights)
SALIDA
[1] NAR
max(heights)
SALIDA
[1] NAR
mean(heights, na.rm = TRUE)
SALIDA
[1] 4R
max(heights, na.rm = TRUE)
SALIDA
[1] 6Si sus datos incluyen valores faltantes, es posible que desee
familiarizarse con las funciones is.na(),
na.omit() y complete.cases(). Consulte a
continuación ejemplos.
R
## Extract those elements which are not missing values.
heights[!is.na(heights)]
SALIDA
[1] 2 4 4 6R
## Returns the object with incomplete cases removed.
## The returned object is an atomic vector of type `"numeric"`
## (or `"double"`).
na.omit(heights)
SALIDA
[1] 2 4 4 6
attr(,"na.action")
[1] 4
attr(,"class")
[1] "omit"
R
## Extract those elements which are complete cases.
## The returned object is an atomic vector of type `"numeric"`
## (or `"double"`).
heights[complete.cases(heights)]
SALIDA
[1] 2 4 4 6Desafío:
- Utilizando este vector de alturas en pulgadas, crea un nuevo vector sin los valores NA.
R
heights <- c(63, 69, 60, 65, NA, 68, 61, 70, 61, 59, 64, 69, 63, 63, NA, 72, 65, 64, 70, 63, 65)
- Utilice la función
median()para calcular la mediana del vectorheights. - Utilice R para determinar cuántas personas del conjunto miden más de 67 pulgadas.
R
heights_no_na <- heights[!is.na(heights)]
## or
heights_no_na <- na.omit(heights)
R
median(heights, na.rm = TRUE)
SALIDA
[1] 64R
heights_above_67 <- heights_no_na[heights_no_na > 67]
length(heights_above_67)
SALIDA
[1] 6Generación de vectores
Constructores
Existen algunas funciones para generar vectores de diferentes tipos.
Para generar un vector de números, se puede utilizar el constructor
numeric(), proporcionando la longitud del vector de salida
como parámetro. Los valores se inicializarán con 0.
R
numeric(3)
SALIDA
[1] 0 0 0R
numeric(10)
SALIDA
[1] 0 0 0 0 0 0 0 0 0 0Téngase en cuenta que si solicitamos un vector numérico de longitud 0, obtenemos exactamente eso:
R
numeric(0)
SALIDA
numeric(0)Existen constructores similares para caracteres y valores lógicos,
denominados character() y logical(),
respectivamente.
Desafío:
¿Cuáles son los valores predeterminados para los vectores de caracteres y lógicos?
R
character(2) ## the empty character
SALIDA
[1] "" ""R
logical(2) ## FALSE
SALIDA
[1] FALSE FALSERepetir elementos
La función rep permite repetir un valor un número
determinado de veces. Si queremos inicializar un vector numérico de
longitud 5 con el valor -1, por ejemplo, podríamos hacer lo
siguiente:
R
rep(-1, 5)
SALIDA
[1] -1 -1 -1 -1 -1Del mismo modo, para generar un vector lleno de valores faltantes, lo cual suele ser una buena forma de comenzar, sin establecer supuestos sobre los datos a recolectar:
R
rep(NA, 5)
SALIDA
[1] NA NA NA NA NArep puede aceptar como entrada vectores de cualquier
longitud (en lo anterior, utilizamos vectores de longitud 1) y de
cualquier tipo. Por ejemplo, si queremos repetir los valores 1, 2 y 3
cinco veces, haríamos lo siguiente:
R
rep(c(1, 2, 3), 5)
SALIDA
[1] 1 2 3 1 2 3 1 2 3 1 2 3 1 2 3Desafío:
¿Y si quisiéramos repetir los valores 1, 2 y 3 cinco veces, pero
obtener cinco 1, cinco 2 y cinco 3 en ese orden? Hay dos posibilidades;
consulte ?rep o ?sort para obtener ayuda.
R
rep(c(1, 2, 3), each = 5)
SALIDA
[1] 1 1 1 1 1 2 2 2 2 2 3 3 3 3 3R
sort(rep(c(1, 2, 3), 5))
SALIDA
[1] 1 1 1 1 1 2 2 2 2 2 3 3 3 3 3Generación de secuencias
Otra función muy útil es seq, para generar una secuencia
de números. Por ejemplo, para generar una secuencia de enteros del 1 al
20 en pasos de 2, se utilizaría:
R
seq(from = 1, to = 20, by = 2)
SALIDA
[1] 1 3 5 7 9 11 13 15 17 19El valor predeterminado de by es 1 y, dado que la
generación de una secuencia de un valor a otro con pasos de 1 se utiliza
con frecuencia, existe un atajo:
R
seq(1, 5, 1)
SALIDA
[1] 1 2 3 4 5R
seq(1, 5) ## default by
SALIDA
[1] 1 2 3 4 5R
1:5
SALIDA
[1] 1 2 3 4 5Para generar una secuencia de números del 1 al 20 con una longitud final de 3, se utilizaría:
R
seq(from = 1, to = 20, length.out = 3)
SALIDA
[1] 1.0 10.5 20.0Muestras aleatorias y permutaciones
Un último grupo de funciones útiles son aquellas que generan datos
aleatorios. La primera, sample, genera una permutación
aleatoria de otro vector. Por ejemplo, para determinar un orden
aleatorio para el examen oral de 10 estudiantes, primero asigno a cada
estudiante un número del 1 al 10 (por ejemplo, según el orden alfabético
de su nombre) y luego:
R
sample(1:10)
SALIDA
[1] 9 4 7 1 2 5 3 10 6 8Sin argumentos adicionales, sample devolverá una
permutación de todos los elementos del vector. Si quisiera una muestra
aleatoria de un tamaño determinado, establecería este valor como segundo
argumento. A continuación, extraigo 5 letras aleatorias del alfabeto
contenido en el vector letters predefinido:
R
sample(letters, 5)
SALIDA
[1] "s" "a" "u" "x" "j"Si quisiera un resultado mayor que el vector de entrada, o poder
extraer algunos elementos varias veces, tendría que establecer el
argumento replace en TRUE:
R
sample(1:5, 10, replace = TRUE)
SALIDA
[1] 2 1 5 5 1 1 5 5 2 2Desafío:
Al probar las funciones anteriores, habrá advertido que las muestras
son, en efecto, aleatorias y que no se obtiene la misma permutación dos
veces. Para poder reproducir estos muestreos aleatorios, se puede
establecer manualmente la semilla de generación de números aleatorios
con set.seed() antes de extraer la muestra aleatoria.
Prueba esta función con tu compañero. Primero, extrae dos
permutaciones aleatorias de 1:10 de forma independiente y
observa que obtienes resultados diferentes.
Ahora establezca la semilla con, por ejemplo,
set.seed(123) y repita el muestreo aleatorio. Observe que
ahora obtiene los mismos muestreos aleatorios.
Repita estableciendo una semilla diferente.
Diferentes permutaciones
R
sample(1:10)
SALIDA
[1] 9 1 4 3 6 2 5 8 10 7R
sample(1:10)
SALIDA
[1] 4 9 7 6 1 10 8 3 2 5Mismas permutaciones con la semilla 123
R
set.seed(123)
sample(1:10)
SALIDA
[1] 3 10 2 8 6 9 1 7 5 4R
set.seed(123)
sample(1:10)
SALIDA
[1] 3 10 2 8 6 9 1 7 5 4Una semilla diferente
R
set.seed(1)
sample(1:10)
SALIDA
[1] 9 4 7 1 2 5 3 10 6 8R
set.seed(1)
sample(1:10)
SALIDA
[1] 9 4 7 1 2 5 3 10 6 8Toma de muestras de una distribución normal
La última función que veremos es rnorm, que extrae una
muestra aleatoria de una distribución normal. A continuación se muestran
dos distribuciones normales con medias 0 y 100 y desviaciones estándar 1
y 5, denotadas como N(0, 1) y N(100, 5).
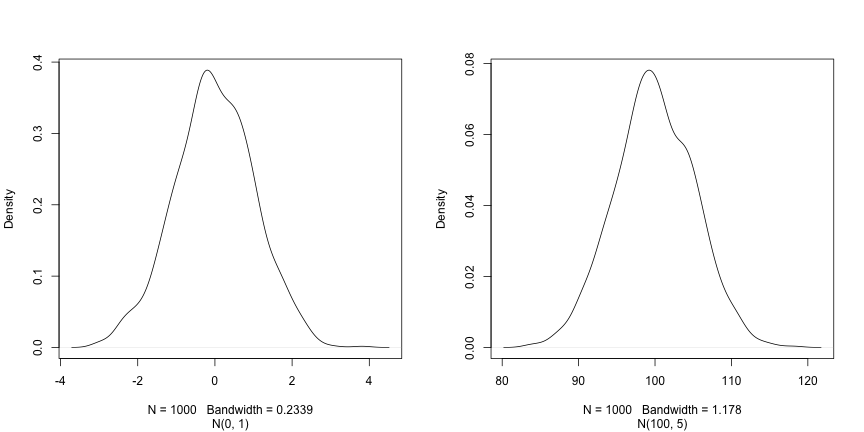
Los tres argumentos, n, mean y
sd, definen el tamaño de la muestra y los parámetros de la
distribución normal, es decir, la media y su desviación estándar. Los
valores predeterminados de estos dos parámetros son 0 y 1,
respectivamente.
R
rnorm(5)
SALIDA
[1] 0.69641761 0.05351568 -1.31028350 -2.12306606 -0.20807859R
rnorm(5, 2, 2)
SALIDA
[1] 1.3744268 -0.1164714 2.8344472 1.3690969 3.6510983R
rnorm(5, 100, 5)
SALIDA
[1] 106.45636 96.87448 95.62427 100.71678 107.12595Ahora que hemos aprendido a escribir scripts y los conceptos básicos de las estructuras de datos de R, estamos listos para empezar a trabajar con datos más extensos y aprender sobre las tablas de datos.
- Cómo interactuar con R