
Comenzando con los datos
Última actualización: 2026-11-11 | Mejora esta página
Hoja de ruta
Preguntas
- Primer análisis de datos en R
Objetivos
- Describa qué es un
data.frame. - Cargar datos externos de un archivo .csv en una tabla de datos.
- Resume el contenido de una tabla de datos.
- Describa qué es un factor.
- Convertir entre cadenas y factores.
- Reordenar y renombrar factores.
- Formatear fechas.
- Exportar y guardar datos.
Este episodio se basa en la lección Data Analysis and Visualisation in R for Ecologists de Data Carpentries.
Presentación de los datos de expresión génica
Vamos a utilizar una parte de los datos publicados por Blackmore et al. (2017), The effect of upper-respiratory infection on transcriptomic changes in the CNS. El objetivo del estudio fue determinar el efecto de una infección de las vías respiratorias superiores sobre los cambios en la transcripción de ARN que ocurren en el cerebelo y la médula espinal tras la infección. Ratones C57BL/6 de ocho semanas de edad, emparejados por sexo, fueron inoculados con solución salina o con Influenza A por vía intranasal, y los cambios transcriptómicos en los tejidos del cerebelo y de la médula espinal se evaluaron mediante RNA-seq en los días 0 (no infectados), 4 y 8.
El conjunto de datos se almacena como un archivo de valores separados por comas (CSV). Cada fila contiene información sobre una sola medición de expresión de ARN, y las once primeras columnas representan:
| Columna | Descripción |
|---|---|
| gene | El nombre del gen que se midió |
| sample | El nombre de la muestra en la que se midió la expresión génica |
| expression | El valor de la expresión génica |
| organism | El organismo/especie - aquí todos los datos provienen de ratones |
| age | La edad del ratón (aquí todos los ratones tenían 8 semanas) |
| sex | El sexo del ratón |
| infection | El estado de infección del ratón, es decir, infectado con Influenza A o no infectado. |
| strain | La cepa de Influenza A. |
| time | La duración de la infección (en días). |
| tissue | El tejido que se utilizó para el experimento de expresión génica, es decir, el cerebelo o la médula espinal. |
| mouse | El identificador único del ratón. |
Vamos a utilizar la función de R download.file() para
descargar el archivo CSV que contiene los datos de expresión génica, y
utilizaremos read.csv() para cargar en memoria el contenido
del archivo CSV como un objeto de clase data.frame. Dentro
del comando download.file, la primera entrada es una cadena
de caracteres con la URL de origen. Esta URL de origen descarga un
archivo CSV de un repositorio de GitHub. El texto después de la coma
("data/rnaseq.csv") es el destino del archivo en su máquina
local. Necesitará tener una carpeta en su máquina llamada
"data" donde descargará el archivo. Por lo tanto, este
comando descarga el archivo remoto, le asigna el nombre
"rnaseq.csv" y lo añade a una carpeta preexistente llamada
"data".
R
download.file(url = "https://github.com/carpentries-incubator/bioc-intro/raw/main/episodes/data/rnaseq.csv",
              destfile = "data/rnaseq.csv")
Ya está listo para cargar los datos:
R
rna <- read.csv("data/rnaseq.csv")
Esta instrucción no produce ninguna salida porque, como probablemente recuerde, las asignaciones no muestran nada. Si queremos comprobar que los datos se han cargado, podemos ver el contenido de la tabla de datos escribiendo su nombre:
R
rna
Vaya… fue mucha salida. Al menos significa que los datos se cargaron
correctamente. Revisemos la parte superior (las primeras 6 líneas) de
esta tabla de datos utilizando la función head():
R
head(rna)
SALIDA
     gene     sample expression     organism age    sex  infection  strain time
1     Asl GSM2545336       1170 Mus musculus   8 Female InfluenzaA C57BL/6    8
2    Apod GSM2545336      36194 Mus musculus   8 Female InfluenzaA C57BL/6    8
3 Cyp2d22 GSM2545336       4060 Mus musculus   8 Female InfluenzaA C57BL/6    8
4    Klk6 GSM2545336        287 Mus musculus   8 Female InfluenzaA C57BL/6    8
5   Fcrls GSM2545336         85 Mus musculus   8 Female InfluenzaA C57BL/6    8
6  Slc2a4 GSM2545336        782 Mus musculus   8 Female InfluenzaA C57BL/6    8
      tissue mouse ENTREZID
1 Cerebellum    14   109900
2 Cerebellum    14    11815
3 Cerebellum    14    56448
4 Cerebellum    14    19144
5 Cerebellum    14    80891
6 Cerebellum    14    20528
                                                                       product
1                               argininosuccinate lyase, transcript variant X1
2                                       apolipoprotein D, transcript variant 3
3 cytochrome P450, family 2, subfamily d, polypeptide 22, transcript variant 2
4                         kallikrein related-peptidase 6, transcript variant 2
5                Fc receptor-like S, scavenger receptor, transcript variant X1
6          solute carrier family 2 (facilitated glucose transporter), member 4
     ensembl_gene_id external_synonym chromosome_name   gene_biotype
1 ENSMUSG00000025533    2510006M18Rik               5 protein_coding
2 ENSMUSG00000022548             <NA>              16 protein_coding
3 ENSMUSG00000061740             2D22              15 protein_coding
4 ENSMUSG00000050063             Bssp               7 protein_coding
5 ENSMUSG00000015852    2810439C17Rik               3 protein_coding
6 ENSMUSG00000018566           Glut-4              11 protein_coding
                            phenotype_description
1           abnormal circulating amino acid level
2                      abnormal lipid homeostasis
3                        abnormal skin morphology
4                         abnormal cytokine level
5 decreased CD8-positive alpha-beta T cell number
6              abnormal circulating glucose level
  hsapiens_homolog_associated_gene_name
1                                   ASL
2                                  APOD
3                                CYP2D6
4                                  KLK6
5                                 FCRL2
6                                SLC2A4
R
## Try also
## View(rna)
Nota
read.csv() asume que los campos están delimitados por
comas; sin embargo, en varios países, la coma se utiliza como separador
decimal y el punto y coma (;) como delimitador de campos. Si desea leer
este tipo de archivos en R, puede utilizar la función
read.csv2(). Se comporta exactamente como
read.csv(), pero utiliza parámetros diferentes para los
separadores decimal y de campos. Si trabaja con otro formato, ambos
pueden ser especificados por el usuario. Consulte la ayuda de
read.csv() escribiendo ?read.csv para obtener
más información. También existe la función read.delim()
para leer archivos de datos separados por tabulaciones. Es importante
tener en cuenta que todas estas funciones son, en realidad, funciones
wrapper para la función principal read.table() con
argumentos diferentes. Por lo tanto, los datos anteriores también
podrían haberse cargado utilizando read.table() con el
argumento de separación como ,. El código es el
siguiente:
R
rna <- read.table(file = "data/rnaseq.csv",
                  sep = ",",
                  header = TRUE)
El argumento header debe establecerse en TRUE para poder leer los
encabezados, ya que, por defecto, read.table() tiene el
argumento header establecido en FALSE.
¿Qué son las tablas de datos?
Las tablas de datos son la estructura de datos de facto para la mayoría de los datos en formato tabular, y es lo que utilizamos para estadísticas y gráficos.
Una tabla de datos puede crearse manualmente, pero lo más común es
que se generen mediante las funciones read.csv() o
read.table(); en otras palabras, al importar hojas de
cálculo desde su disco duro (o de la web).
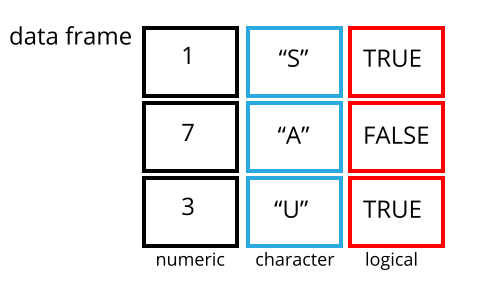
Una tabla de datos es la representación de los datos en formato de tabla, donde las columnas son vectores que tienen todos la misma longitud. Debido a que las columnas son vectores, cada columna debe contener un único tipo de dato (por ejemplo, caracteres, enteros, factores). Por ejemplo, aquí hay una figura que representa una tabla de datos compuesta por un vector numérico, uno de caracteres y uno lógico.
Podemos ver esto al inspeccionar la estructura de una tabla de
datos con la función str():
R
str(rna)
SALIDA
'data.frame':	32428 obs. of  19 variables:
 $ gene                                 : chr  "Asl" "Apod" "Cyp2d22" "Klk6" ...
 $ sample                               : chr  "GSM2545336" "GSM2545336" "GSM2545336" "GSM2545336" ...
 $ expression                           : int  1170 36194 4060 287 85 782 1619 288 43217 1071 ...
 $ organism                             : chr  "Mus musculus" "Mus musculus" "Mus musculus" "Mus musculus" ...
 $ age                                  : int  8 8 8 8 8 8 8 8 8 8 ...
 $ sex                                  : chr  "Female" "Female" "Female" "Female" ...
 $ infection                            : chr  "InfluenzaA" "InfluenzaA" "InfluenzaA" "InfluenzaA" ...
 $ strain                               : chr  "C57BL/6" "C57BL/6" "C57BL/6" "C57BL/6" ...
 $ time                                 : int  8 8 8 8 8 8 8 8 8 8 ...
 $ tissue                               : chr  "Cerebellum" "Cerebellum" "Cerebellum" "Cerebellum" ...
 $ mouse                                : int  14 14 14 14 14 14 14 14 14 14 ...
 $ ENTREZID                             : int  109900 11815 56448 19144 80891 20528 97827 118454 18823 14696 ...
 $ product                              : chr  "argininosuccinate lyase, transcript variant X1" "apolipoprotein D, transcript variant 3" "cytochrome P450, family 2, subfamily d, polypeptide 22, transcript variant 2" "kallikrein related-peptidase 6, transcript variant 2" ...
 $ ensembl_gene_id                      : chr  "ENSMUSG00000025533" "ENSMUSG00000022548" "ENSMUSG00000061740" "ENSMUSG00000050063" ...
 $ external_synonym                     : chr  "2510006M18Rik" NA "2D22" "Bssp" ...
 $ chromosome_name                      : chr  "5" "16" "15" "7" ...
 $ gene_biotype                         : chr  "protein_coding" "protein_coding" "protein_coding" "protein_coding" ...
 $ phenotype_description                : chr  "abnormal circulating amino acid level" "abnormal lipid homeostasis" "abnormal skin morphology" "abnormal cytokine level" ...
 $ hsapiens_homolog_associated_gene_name: chr  "ASL" "APOD" "CYP2D6" "KLK6" ...
Inspección de objetos data.frame
Ya vimos cómo las funciones head() y str()
pueden ser útiles para comprobar el contenido y la estructura de una
tabla de datos. Aquí tienes una lista no exhaustiva de funciones para
hacerte una idea del contenido/estructura de los datos.
¡Probémoslas!
Tamaño:
-
dim(rna)- devuelve un vector con el número de filas como primer elemento y el número de columnas como segundo elemento (las dimensiones del objeto). -
nrow(rna)- devuelve el número de filas. -
ncol(rna)- devuelve el número de columnas.
Contenido:
-
head(rna)- muestra las primeras 6 filas. -
tail(rna)- muestra las últimas 6 filas.
Nombres:
-
names(rna)- devuelve los nombres de las columnas (sinónimo decolnames()para objetosdata.frame). -
rownames(rna)- devuelve los nombres de las filas.
Resumen:
-
str(rna)- estructura del objeto e información sobre la clase, la longitud y el contenido de cada columna. -
summary(rna)- estadísticas resumidas para cada columna.
Nota: la mayoría de estas funciones son “genéricas”; pueden
utilizarse con otros tipos de objetos además de
data.frame.
Desafío:
Basándote en la salida de str(rna), ¿puedes responder a
las siguientes preguntas?
- ¿Cuál es la clase del objeto
rna? - ¿Cuántas filas y cuántas columnas tiene este objeto?
- clase: tabla de datos
- cuántas filas: 32428, cuántas columnas: 19
Indexación y selección de subconjuntos de tablas de datos
Nuestra tabla de datos rna tiene filas y columnas (tiene
2 dimensiones); si queremos extraer algunos datos específicos de ella,
necesitamos especificar las “coordenadas” que deseamos. Los números de
fila vienen primero, seguidos de los números de columna. No obstante,
tenga en cuenta que las diferentes formas de especificar estas
coordenadas dan lugar a resultados con clases distintas.
R
# first element in the first column of the data frame (as a vector)
rna[1, 1]
# first element in the 6th column (as a vector)
rna[1, 6]
# first column of the data frame (as a vector)
rna[, 1]
# first column of the data frame (as a data.frame)
rna[1]
# first three elements in the 7th column (as a vector)
rna[1:3, 7]
# the 3rd row of the data frame (as a data.frame)
rna[3, ]
# equivalent to head_rna <- head(rna)
head_rna <- rna[1:6, ]
head_rna
: es una función especial que crea vectores numéricos de
enteros en orden creciente o decreciente; pruebe 1:10 y
10:1, por ejemplo. Consulte la sección sobre la generación de
vectores para obtener más detalles.
También puede excluir ciertos índices de una tabla de datos
utilizando el signo “-”:
R
rna[, -1]          ## The whole data frame, except the first column
rna[-c(7:66465), ] ## Equivalent to head(rna)
Se pueden seleccionar subconjuntos de las tablas de datos mediante sus índices (como se mostró anteriormente), pero también usando directamente los nombres de sus columnas:
R
rna["gene"]       # Result is a data.frame
rna[, "gene"]     # Result is a vector
rna[["gene"]]     # Result is a vector
rna$gene          # Result is a vector
En RStudio, puede utilizar la función de autocompletado para obtener los nombres completos y correctos de las columnas.
Desafío
Crea un
data.frame(rna_200) que contenga únicamente los datos de la fila 200 del conjunto de datosrna.¿Observas cómo
nrow()te dio el número de filas de undata.frame?
Utilice ese número para extraer únicamente esa última fila de la tabla de datos inicial
rna.Compáralo con lo que ves como la última fila usando
tail()para asegurarte de que coincide con lo esperado.Extraiga esa última fila utilizando
nrow()en lugar del número de fila.Crea una nueva tabla de datos (
rna_last) a partir de esa última fila.
Utilice
nrow()para extraer la fila que se encuentra en el centro de la tabla de datosrna. Guarde el contenido de esta fila en un objeto llamadorna_middle.Combina
nrow()con la notación-anterior para reproducir el comportamiento dehead(rna), manteniendo únicamente las filas del 1 al 6 del conjunto de datos rna.
R
## 1.
rna_200 <- rna[200, ]
## 2.
## Saving `n_rows` to improve readability and reduce duplication
n_rows <- nrow(rna)
rna_last <- rna[n_rows, ]
## 3.
rna_middle <- rna[n_rows / 2, ]
## 4.
rna_head <- rna[-(7:n_rows), ]
Factores
Los factores representan datos categóricos. Se almacenan como enteros asociados a etiquetas y pueden ser ordenados o no ordenados. Aunque los factores parecen (y a menudo se comportan) como vectores de caracteres, R los trata en realidad como vectores de enteros. Por lo tanto, es necesario tener mucho cuidado al tratarlos como cadenas.
Una vez creados, los factores solo pueden contener un conjunto de valores predefinidos, conocidos como niveles. Por defecto, R siempre ordena los niveles alfabéticamente. Por ejemplo, si tiene un factor con 2 niveles:
R
sex <- factor(c("male", "female", "female", "male", "female"))
R asignará 1 al nivel "female" y
2 al nivel "male" (ya que f
precede a m, a pesar de que el primer elemento de este
vector es "male"). Puede comprobar esto utilizando la
función levels() y puede encontrar el número de niveles
usando nlevels():
R
levels(sex)
SALIDA
[1] "female" "male" R
nlevels(sex)
SALIDA
[1] 2A veces, el orden de los factores no es relevante; en otras
ocasiones, es posible que desee especificar el orden porque tiene un
significado (por ejemplo, “bajo”, “medio”, “alto”), mejora la
visualización o es necesario para un tipo particular de análisis. En
este caso, una forma de reordenar nuestros niveles en el vector
sex sería:
R
sex ## current order
SALIDA
[1] male   female female male   female
Levels: female male
R
sex <- factor(sex, levels = c("male", "female"))
sex ## after re-ordering
SALIDA
[1] male   female female male   female
Levels: male female
En la memoria de R, estos factores se representan mediante enteros
(1, 2, 3), pero son más informativos que estos porque se describen a sí
mismos: las etiquetas "female" y "male" son
más descriptivas que 1 y 2. ¿Cuál de los
enteros corresponde a “male” (macho)? No se puede saber solo a partir de
los valores enteros. Los factores, en cambio, incluyen esa información.
Esto resulta especialmente útil cuando hay muchos niveles (como el
biotipo génico en nuestro conjunto de datos de ejemplo).
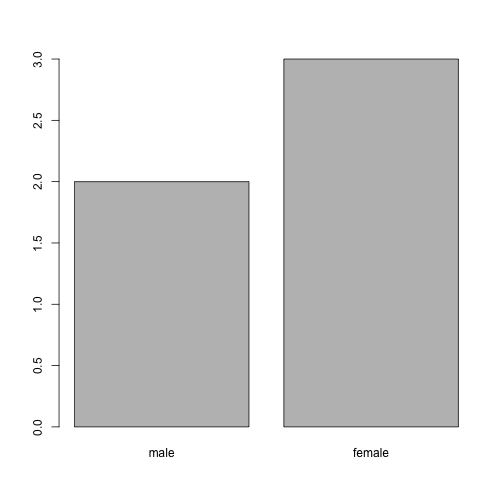
Cuando sus datos se almacenan como un factor, puede utilizar la
función plot() para obtener una vista rápida del número de
observaciones representadas por cada nivel del factor. Veamos el número
de machos y hembras en nuestros datos.
R
plot(sex)
Conversión a carácter
Si necesita convertir un factor a un vector de caracteres, utilice
as.character(x).
R
as.character(sex)
SALIDA
[1] "male" "female" "female" "male" "female"Renombrar factores
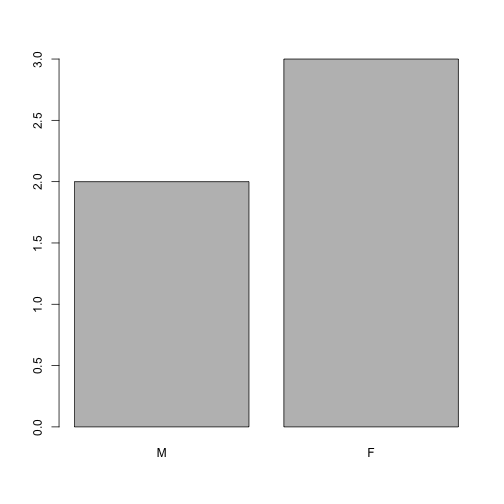
Si queremos renombrar este factor, basta con cambiar sus niveles:
R
levels(sex)
SALIDA
[1] "male" "female"R
levels(sex) <- c("M", "F")
sex
SALIDA
[1] M F F M F
Levels: M F
R
plot(sex)
Desafío:
- Cambiar el nombre de “F” y “M” a “Female” y “Male”, respectivamente.
R
levels(sex)
SALIDA
[1] "M" "F"R
levels(sex) <- c("Male", "Female")
Desafío:
Hemos visto cómo se crean las tablas de datos al usar
read.csv(), pero también pueden crearse manualmente con la
función data.frame(). Hay algunos errores en esta
data.frame creada a mano. ¿Puedes detectarlos y
corregirlos? ¡No dudes en experimentar!
- faltan comillas alrededor de los nombres de los animales
- falta un registro en la columna “feel” (probablemente de uno de los animales peludos)
- falta una coma en la columna de peso
Desafío:
¿Puedes predecir la clase de cada una de las columnas en el siguiente ejemplo?
Verifica tus conjeturas usando str(country_climate):
¿Son lo que esperabas? ¿Por qué? ¿Por qué no?
Inténtalo de nuevo añadiendo
stringsAsFactors = TRUEdespués de la última variable al crear la tabla de datos. ¿Qué está pasando ahora? También se puede establecerstringsAsFactorsal leer hojas de cálculo basadas en texto en R utilizandoread.csv().
R
country_climate <- data.frame(
       country = c("Canada", "Panama", "South Africa", "Australia"),
       climate = c("cold", "hot", "temperate", "hot/temperate"),
       temperature = c(10, 30, 18, "15"),
       northern_hemisphere = c(TRUE, TRUE, FALSE, "FALSE"),
       has_kangaroo = c(FALSE, FALSE, FALSE, 1)
       )
R
country_climate <- data.frame(
       country = c("Canada", "Panama", "South Africa", "Australia"),
       climate = c("cold", "hot", "temperate", "hot/temperate"),
       temperature = c(10, 30, 18, "15"),
       northern_hemisphere = c(TRUE, TRUE, FALSE, "FALSE"),
       has_kangaroo = c(FALSE, FALSE, FALSE, 1)
       )
str(country_climate)
SALIDA
'data.frame':	4 obs. of  5 variables:
 $ country            : chr  "Canada" "Panama" "South Africa" "Australia"
 $ climate            : chr  "cold" "hot" "temperate" "hot/temperate"
 $ temperature        : chr  "10" "30" "18" "15"
 $ northern_hemisphere: chr  "TRUE" "TRUE" "FALSE" "FALSE"
 $ has_kangaroo       : num  0 0 0 1
La conversión automática del tipo de datos a veces es una ventaja y a veces una molestia. Tenga en cuenta que existe, aprenda las reglas y verifique dos veces que los datos que importa en R sean del tipo correcto dentro de su tabla de datos. Si no es así, utilícelo para detectar errores que pudieron haberse introducido durante la entrada de datos (por ejemplo, una letra en una columna que solo debería contener números).
Más información en este tutorial de RStudio
Matrices
Antes de continuar, ahora que hemos aprendido sobre las tablas de
datos, repasemos la instalación de paquetes y conozcamos un nuevo tipo
de dato: el matrix. Al igual que el
data.frame, una matriz tiene dos dimensiones, filas y
columnas. Pero la diferencia principal es que todas las celdas de una
matrix deben ser del mismo tipo: numeric,
character, logical, … En ese sentido, las
matrices se asemejan más a un vector que a un
data.frame.
El constructor predeterminado para una matriz es matrix.
Recibe un vector de valores para llenar la matriz y el número de filas
y/o columnas1. Los valores se colocan por columnas, como
se ilustra a continuación.
R
m <- matrix(1:9, ncol = 3, nrow = 3)
m
SALIDA
     [,1] [,2] [,3]
[1,]    1    4    7
[2,]    2    5    8
[3,] 3 6 9Desafío:
Utilizando la función installed.packages(), crea una
matriz character que contenga la información sobre todos
los paquetes actualmente instalados en tu computadora. Explórala.
R
## create the matrix
ip <- installed.packages()
head(ip)
## try also View(ip)
## number of package
nrow(ip)
## names of all installed packages
rownames(ip)
## type of information we have about each package
colnames(ip)
A menudo resulta útil crear matrices de datos aleatorias de gran
tamaño como datos de prueba. El siguiente ejercicio le pide que cree
dicha matriz con datos aleatorios extraídos de una distribución normal
de media 0 y desviación estándar 1, lo cual puede hacerse con la función
rnorm().
Desafío:
Construya una matriz de dimensiones 1000 por 3 con datos normalmente distribuidos (media 0, desviación estándar 1)
R
set.seed(123)
m <- matrix(rnorm(3000), ncol = 3)
dim(m)
SALIDA
[1] 1000 3R
head(m)
SALIDA
            [,1]        [,2]       [,3]
[1,] -0.56047565 -0.99579872 -0.5116037
[2,] -0.23017749 -1.03995504  0.2369379
[3,]  1.55870831 -0.01798024 -0.5415892
[4,]  0.07050839 -0.13217513  1.2192276
[5,]  0.12928774 -2.54934277  0.1741359
[6,]  1.71506499  1.04057346 -0.6152683
Formato de fechas
Uno de los problemas más comunes que presentan los usuarios nuevos (¡y experimentados!) de R es convertir la información de fecha y hora en una variable adecuada y utilizable durante los análisis.
Nota sobre las fechas en programas de hojas de cálculo
Las fechas en las hojas de cálculo suelen almacenarse en una sola columna. Aunque esto parece la forma más natural de registrar las fechas, en realidad no es la mejor práctica. Una aplicación de hojas de cálculo mostrará las fechas de una manera aparentemente correcta (para un observador humano), pero la forma en que realmente gestiona y almacena las fechas puede resultar problemática. A menudo es mucho más seguro almacenar las fechas con el AÑO, el MES y el DÍA en columnas separadas, o como el AÑO y el DÍA DEL AÑO en columnas separadas.
Los programas de hojas de cálculo como LibreOffice, Microsoft Excel, OpenOffice, Gnumeric, … tienen formas diferentes (y a menudo incompatibles) de codificar las fechas (incluso dentro del mismo programa entre versiones y sistemas operativos). Además, Excel puede convertir elementos que no son fechas en fechas ( Zeeberg et al. (2004) ), por ejemplo, nombres o identificadores como MAR1, DEC1, OCT4. Por lo tanto, si se evita el formato de fecha en general, es más sencillo identificar estos problemas.
La sección Dates as data de la lección de Data Carpentry ofrece información adicional sobre los peligros de las fechas en las hojas de cálculo.
Vamos a utilizar la función ymd() del paquete
lubridate (que pertenece a
tidyverse; obtenga más información en el
sitio web de tidyverse).
lubridate se instala como parte de la
instalación de tidyverse. Cuando carga el
tidyverse
(library(tidyverse)), se cargan los paquetes principales
(los paquetes utilizados en la mayoría de los análisis de datos).
lubridate, sin embargo, no pertenece al
tidyverse principal, por lo que debe cargarlo explícitamente con
library(lubridate).
Comience cargando el paquete necesario:
R
library("lubridate")
ymd() acepta un vector que representa el año, el mes y
el día, y lo convierte en un vector Date. Date
es una clase de datos que R reconoce como una fecha y que puede
manipularse como tal. El argumento que requiere la función es flexible,
pero, como buena práctica, es un vector de caracteres formateado como
“YYYY-MM-DD”.
Creemos un objeto de fecha y examinemos su estructura:
R
my_date <- ymd("2015-01-01")
str(my_date)
SALIDA
Date[1:1], format: "2015-01-01"Ahora concatenemos el año, el mes y el día, proporcionados por separado: obtenemos el mismo resultado:
R
# sep indicates the character to use to separate each component
my_date <- ymd(paste("2015", "1", "1", sep = "-"))
str(my_date)
SALIDA
Date[1:1], format: "2015-01-01"Ahora familiaricémonos con un flujo de trabajo típico para manipular
fechas. El pequeño conjunto de datos que aparece a continuación almacena
las fechas en columnas separadas: year, month
y day.
R
x <- data.frame(year = c(1996, 1992, 1987, 1986, 2000, 1990, 2002, 1994, 1997, 1985),
                month = c(2,  3,  3, 10,  1,  8,  3,  4,  5,  5),
                day = c(24,  8,  1,  5,  8, 17, 13, 10, 11, 24),
                value = c(4,  5,  1,  9,  3,  8, 10,  2,  6,  7))
x
SALIDA
   year month day value
1  1996     2  24     4
2  1992     3   8     5
3  1987     3   1     1
4  1986    10   5     9
5  2000     1   8     3
6  1990     8  17     8
7  2002     3  13    10
8  1994     4  10     2
9  1997     5  11     6
10 1985     5  24     7
Ahora aplicamos esta función al conjunto de datos x.
Primero creamos un vector de caracteres a partir de las columnas
year, month y day de
x utilizando paste():
R
paste(x$year, x$month, x$day, sep = "-")
SALIDA
 [1] "1996-2-24" "1992-3-8"  "1987-3-1"  "1986-10-5" "2000-1-8"  "1990-8-17"
 [7] "2002-3-13" "1994-4-10" "1997-5-11" "1985-5-24"
Este vector de caracteres puede utilizarse como argumento para
ymd():
R
ymd(paste(x$year, x$month, x$day, sep = "-"))
SALIDA
 [1] "1996-02-24" "1992-03-08" "1987-03-01" "1986-10-05" "2000-01-08"
 [6] "1990-08-17" "2002-03-13" "1994-04-10" "1997-05-11" "1985-05-24"
El vector Date resultante puede añadirse a
x como una nueva columna llamada date:
R
x$date <- ymd(paste(x$year, x$month, x$day, sep = "-"))
str(x) # notice the new column, with 'date' as the class
SALIDA
'data.frame':	10 obs. of  5 variables:
 $ year : num  1996 1992 1987 1986 2000 ...
 $ month: num  2 3 3 10 1 8 3 4 5 5
 $ day  : num  24 8 1 5 8 17 13 10 11 24
 $ value: num  4 5 1 9 3 8 10 2 6 7
 $ date : Date, format: "1996-02-24" "1992-03-08" ...
Asegurémonos de que todo haya funcionado correctamente. Una forma de
inspeccionar la nueva columna es utilizar summary():
R
summary(x$date)
SALIDA
        Min.      1st Qu.       Median         Mean      3rd Qu.         Max.
"1985-05-24" "1988-01-11" "1993-03-24" "1993-03-18" "1997-01-20" "2002-03-13"
Tenga en cuenta que ymd() requiere que el año, el mes y
el día estén en ese orden. Si, por ejemplo, dispone del día, el mes y el
año, necesitaría dmy().
R
dmy(paste(x$day, x$month, x$year, sep = "-"))
SALIDA
 [1] "1996-02-24" "1992-03-08" "1987-03-01" "1986-10-05" "2000-01-08"
 [6] "1990-08-17" "2002-03-13" "1994-04-10" "1997-05-11" "1985-05-24"
lubdridate cuenta con numerosas funciones para gestionar
todas las variaciones de fecha.
Resumen de los objetos de R
Hasta ahora, hemos visto varios tipos de objetos de R que varían en el número de dimensiones y en si podían almacenar un único tipo de dato o múltiples tipos de datos:
-
vector: una dimensión (tienen una longitud), un único tipo de dato. -
matrix: dos dimensiones, un único tipo de dato. -
data.frame: dos dimensiones, un tipo por columna.
Listas
Las listas son un tipo de datos que aún no hemos visto, pero que resulta útil conocer y que se desprende del resumen que acabamos de ver:
-
list: una dimensión, cada elemento puede ser de un tipo de dato diferente.
A continuación, creemos una lista que contenga un vector de números, caracteres, una matriz, una tabla de datos y otra lista:
R
l <- list(1:10, ## numeric
          letters, ## character
          installed.packages(), ## a matrix
          cars, ## a data.frame
          list(1, 2, 3)) ## a list
length(l)
SALIDA
[1] 5R
str(l)
SALIDA
List of 5
 $ : int [1:10] 1 2 3 4 5 6 7 8 9 10
 $ : chr [1:26] "a" "b" "c" "d" ...
 $ : chr [1:261, 1:17] "litedown" "metabolomicsWorkbenchR" "mgcv" "MultiAssayExperiment" ...
  ..- attr(*, "dimnames")=List of 2
  .. ..$ : chr [1:261] "litedown" "metabolomicsWorkbenchR" "mgcv" "MultiAssayExperiment" ...
  .. ..$ : chr [1:17] "Package" "LibPath" "Version" "Priority" ...
 $ :'data.frame':	50 obs. of  2 variables:
  ..$ speed: num [1:50] 4 4 7 7 8 9 10 10 10 11 ...
  ..$ dist : num [1:50] 2 10 4 22 16 10 18 26 34 17 ...
 $ :List of 3
  ..$ : num 1
  ..$ : num 2
  ..$ : num 3
La selección de subconjuntos de una lista se realiza utilizando
[] para obtener una nueva sublista o [[]] para
extraer un único elemento de esa lista (mediante índices o nombres, si
sus elementos tienen nombre).
R
l[[1]] ## first element
SALIDA
[1] 1 2 3 4 5 6 7 8 9 10R
l[1:2] ## a list of length 2
SALIDA
[[1]]
 [1]  1  2  3  4  5  6  7  8  9 10

[[2]]
 [1] "a" "b" "c" "d" "e" "f" "g" "h" "i" "j" "k" "l" "m" "n" "o" "p" "q" "r" "s"
[20] "t" "u" "v" "w" "x" "y" "z"
R
l[1] ## a list of length 1
SALIDA
[[1]]
 [1]  1  2  3  4  5  6  7  8  9 10
Exportación y guardado de datos tabulares
Hemos visto cómo leer una hoja de cálculo basada en texto en R
utilizando la familia de funciones read.table. Para
exportar un data.frame a una hoja de cálculo basada en
texto, podemos utilizar el conjunto de funciones
write.table (write.csv,
write.delim, …). Todas ellas reciben la variable a exportar
y el archivo al que se desea exportar. Por ejemplo, para exportar los
datos rna al archivo my_rna.csv en el
directorio data_output, ejecutaríamos:
R
write.csv(rna, file = "data_output/my_rna.csv")
Ahora se puede compartir este nuevo archivo CSV con otros
colaboradores que no estén familiarizados con R. Tenga en cuenta que,
aunque haya comas en algunos de los campos de data.frame
(véase, por ejemplo, la columna “product”), R encerrará cada campo entre
comillas por defecto y, por lo tanto, podremos leerlo correctamente en
R, a pesar de que también se utilicen comas como separadores de
columnas.
- Datos en tabla en R
Basta con indicar el número de filas o el de columnas, ya que la otra dimensión se puede deducir de la longitud del vector de valores. Pruebe qué ocurre si la cantidad de valores y el número de filas/columnas no son compatibles.↩︎