
Próximos pasos
Última actualización: 2026-11-11 | Mejora esta página
Hoja de ruta
Preguntas
- ¿Qué es un
SummarizedExperiment? - ¿Qué es Bioconductor?
Objetivos
- Presentar el proyecto Bioconductor.
- Presentar el concepto de contenedores de datos.
- Proporcione una visión general del
SummarizedExperiment, ampliamente utilizado en análisis ómicos.
Próximos pasos
Los datos en bioinformática suelen ser complejos. Para abordar esto, los desarrolladores definen contenedores de datos especializados (denominados clases) que coinciden con las propiedades de los datos que necesitan manejar.
Este aspecto es fundamental para el proyecto Bioconductor1, que utiliza la misma infraestructura de datos central en todos sus paquetes. Esto ciertamente contribuyó al éxito de Bioconductor. Se recomienda a los desarrolladores de paquetes de Bioconductor que hagan uso de la infraestructura existente para proporcionar coherencia, interoperabilidad y estabilidad al proyecto en su conjunto.
Para ilustrar dicho contenedor de datos ómicos, presentaremos la
clase SummarizedExperiment.
SummarizedExperiment
La siguiente figura representa la estructura de la clase SummarizedExperiment.

Los objetos de la clase SummarizedExperiment contienen:
Uno o varios ensayos que contienen los datos ómicos cuantitativos (datos de expresión), cada uno almacenado como un objeto similar a una matriz. Las características (genes, transcritos, proteínas, …) se definen a lo largo de las filas y las muestras a lo largo de las columnas.
Una ranura de metadatos de muestras que contiene covariables de las muestras, almacenada como una tabla de datos. Las filas de esta tabla representan las muestras (las filas coinciden exactamente con las columnas de los datos de expresión).
Una ranura de metadatos de características que contiene covariables de características, almacenada como una tabla de datos. Las filas de esta tabla de datos coinciden exactamente con las filas de los datos de expresión.
La naturaleza coordinada de SummarizedExperiment
garantiza que las dimensiones de los distintos componentes coincidan
siempre durante la manipulación de datos (es decir, las columnas de los
datos de expresión con las filas de los metadatos de las muestras, y las
filas de los datos de expresión con las filas de los metadatos de las
características). Por ejemplo, si tuviéramos que excluir una muestra del
ensayo, esta se eliminaría automáticamente de los metadatos de las
muestras en la misma operación.
Los slots de metadatos pueden ampliarse con covariables (columnas) adicionales sin afectar a las otras estructuras.
Creación de un SummarizedExperiment
Para crear un SummarizedExperiment, crearemos los
componentes individuales, es decir, la matriz de conteos y los metadatos
de muestras y genes a partir de archivos csv. Por lo general, así es
como se proporcionan los datos de RNA-Seq (una vez procesados los datos
brutos).
-
Una matriz de expresión: cargamos la matriz de
conteos, especificando que la primera columna contiene los nombres de
las filas/genes, y convertimos el
data.frameen unamatrix. Puede descargarla haciendo clic en este enlace.
R
count_matrix <- read.csv("data/count_matrix.csv",
                         row.names = 1) |>
    as.matrix()

count_matrix[1:5, ]
SALIDA
        GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
Asl           1170        361        400        586        626        988
Apod         36194      10347       9173      10620      13021      29594
Cyp2d22       4060       1616       1603       1901       2171       3349
Klk6           287        629        641        578        448        195
Fcrls           85        233        244        237        180         38
        GSM2545342 GSM2545343 GSM2545344 GSM2545345 GSM2545346 GSM2545347
Asl            836        535        586        597        938       1035
Apod         24959      13668      13230      15868      27769      34301
Cyp2d22       3122       2008       2254       2277       2985       3452
Klk6           186       1101        537        567        327        233
Fcrls           68        375        199        177         89         67
        GSM2545348 GSM2545349 GSM2545350 GSM2545351 GSM2545352 GSM2545353
Asl            494        481        666        937        803        541
Apod         11258      11812      15816      29242      20415      13682
Cyp2d22       1883       2014       2417       3678       2920       2216
Klk6           742        881        828        250        798        710
Fcrls          300        233        231         81        303        285
        GSM2545354 GSM2545362 GSM2545363 GSM2545380
Asl            473        748        576       1192
Apod         11088      15916      11166      38148
Cyp2d22       1821       2842       2011       4019
Klk6           894        501        598        259
Fcrls          248        179        184         68
R
dim(count_matrix)
SALIDA
[1] 1474 22- Una tabla que describe las muestras, disponible en este enlace.
R
sample_metadata <- read.csv("data/sample_metadata.csv")
sample_metadata
SALIDA
       sample     organism age    sex   infection  strain time     tissue mouse
1  GSM2545336 Mus musculus   8 Female  InfluenzaA C57BL/6    8 Cerebellum    14
2  GSM2545337 Mus musculus   8 Female NonInfected C57BL/6    0 Cerebellum     9
3  GSM2545338 Mus musculus   8 Female NonInfected C57BL/6    0 Cerebellum    10
4  GSM2545339 Mus musculus   8 Female  InfluenzaA C57BL/6    4 Cerebellum    15
5  GSM2545340 Mus musculus   8   Male  InfluenzaA C57BL/6    4 Cerebellum    18
6  GSM2545341 Mus musculus   8   Male  InfluenzaA C57BL/6    8 Cerebellum     6
7  GSM2545342 Mus musculus   8 Female  InfluenzaA C57BL/6    8 Cerebellum     5
8  GSM2545343 Mus musculus   8   Male NonInfected C57BL/6    0 Cerebellum    11
9  GSM2545344 Mus musculus   8 Female  InfluenzaA C57BL/6    4 Cerebellum    22
10 GSM2545345 Mus musculus   8   Male  InfluenzaA C57BL/6    4 Cerebellum    13
11 GSM2545346 Mus musculus   8   Male  InfluenzaA C57BL/6    8 Cerebellum    23
12 GSM2545347 Mus musculus   8   Male  InfluenzaA C57BL/6    8 Cerebellum    24
13 GSM2545348 Mus musculus   8 Female NonInfected C57BL/6    0 Cerebellum     8
14 GSM2545349 Mus musculus   8   Male NonInfected C57BL/6    0 Cerebellum     7
15 GSM2545350 Mus musculus   8   Male  InfluenzaA C57BL/6    4 Cerebellum     1
16 GSM2545351 Mus musculus   8 Female  InfluenzaA C57BL/6    8 Cerebellum    16
17 GSM2545352 Mus musculus   8 Female  InfluenzaA C57BL/6    4 Cerebellum    21
18 GSM2545353 Mus musculus   8 Female NonInfected C57BL/6    0 Cerebellum     4
19 GSM2545354 Mus musculus   8   Male NonInfected C57BL/6    0 Cerebellum     2
20 GSM2545362 Mus musculus   8 Female  InfluenzaA C57BL/6    4 Cerebellum    20
21 GSM2545363 Mus musculus   8   Male  InfluenzaA C57BL/6    4 Cerebellum    12
22 GSM2545380 Mus musculus   8 Female  InfluenzaA C57BL/6    8 Cerebellum    19
R
dim(sample_metadata)
SALIDA
[1] 22 9- Una tabla que describe los genes, disponible en este enlace.
R
gene_metadata <- read.csv("data/gene_metadata.csv")
gene_metadata[1:10, 1:4]
SALIDA
      gene ENTREZID
1      Asl   109900
2     Apod    11815
3  Cyp2d22    56448
4     Klk6    19144
5    Fcrls    80891
6   Slc2a4    20528
7     Exd2    97827
8     Gjc2   118454
9     Plp1    18823
10    Gnb4    14696
                                                                         product
1                                 argininosuccinate lyase, transcript variant X1
2                                         apolipoprotein D, transcript variant 3
3   cytochrome P450, family 2, subfamily d, polypeptide 22, transcript variant 2
4                           kallikrein related-peptidase 6, transcript variant 2
5                  Fc receptor-like S, scavenger receptor, transcript variant X1
6            solute carrier family 2 (facilitated glucose transporter), member 4
7                                          exonuclease 3'-5' domain containing 2
8                            gap junction protein, gamma 2, transcript variant 1
9                           proteolipid protein (myelin) 1, transcript variant 1
10 guanine nucleotide binding protein (G protein), beta 4, transcript variant X2
      ensembl_gene_id
1  ENSMUSG00000025533
2  ENSMUSG00000022548
3  ENSMUSG00000061740
4  ENSMUSG00000050063
5  ENSMUSG00000015852
6  ENSMUSG00000018566
7  ENSMUSG00000032705
8  ENSMUSG00000043448
9  ENSMUSG00000031425
10 ENSMUSG00000027669
R
dim(gene_metadata)
SALIDA
[1] 1474 9Crearemos un SummarizedExperiment a partir de estas
tablas:
La matriz de conteos que se utilizará como el
assayLa tabla que describe las muestras se utilizará como la ranura metadatos de la muestra
La tabla que describe los genes se utilizará como la ranura de metadatos de características
Para ello, podemos unir las diferentes partes utilizando el
constructor SummarizedExperiment:
R
## BiocManager::install("SummarizedExperiment")
library("SummarizedExperiment")
Primero, nos aseguramos de que las muestras estén en el mismo orden en la matriz de conteos y en la anotación de muestras, y lo mismo ocurra con los genes en la matriz de conteos y en la anotación de genes.
R
stopifnot(rownames(count_matrix) == gene_metadata$gene)
stopifnot(colnames(count_matrix) == sample_metadata$sample)
R
se <- SummarizedExperiment(assays = list(counts = count_matrix),
                           colData = sample_metadata,
                           rowData = gene_metadata)
se
SALIDA
class: SummarizedExperiment
dim: 1474 22
metadata(0):
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(9): sample organism ... tissue mouse
Guardar datos
Exportar datos a una hoja de cálculo, como hicimos en un episodio
anterior, presenta varias limitaciones, tales como las descritas en el
primer capítulo (posibles inconsistencias con , y
. como separadores decimales y la falta de definiciones de
tipos de variables). Además, exportar datos a una hoja de cálculo solo
es relevante para datos rectangulares, como las tablas de datos y las
matrices.
Una forma más general de guardar datos, específica de R y que
garantiza que funcione en cualquier sistema operativo, es utilizar la
función saveRDS. Guardar objetos de este modo generará una
representación binaria en el disco (utilizando aquí la extensión de
archivo rds), que puede cargarse de nuevo en R mediante la
función readRDS.
R
saveRDS(se, file = "data_output/se.rds")
rm(se)
se <- readRDS("data_output/se.rds")
head(se)
Para concluir, cuando se trata de guardar datos desde R que serán
cargados nuevamente en R, el método preferido es guardar y cargar con
saveRDS y readRDS. Si los datos en formato
tabular deben compartirse con alguien que no utilice R, exportarlos a
una hoja de cálculo basada en texto es una buena alternativa.
Utilizando esta estructura de datos, podemos acceder a la matriz de
expresión con la función assay:
R
head(assay(se))
SALIDA
        GSM2545336 GSM2545337 GSM2545338 GSM2545339 GSM2545340 GSM2545341
Asl           1170        361        400        586        626        988
Apod         36194      10347       9173      10620      13021      29594
Cyp2d22       4060       1616       1603       1901       2171       3349
Klk6           287        629        641        578        448        195
Fcrls           85        233        244        237        180         38
Slc2a4         782        231        248        265        313        786
        GSM2545342 GSM2545343 GSM2545344 GSM2545345 GSM2545346 GSM2545347
Asl            836        535        586        597        938       1035
Apod         24959      13668      13230      15868      27769      34301
Cyp2d22       3122       2008       2254       2277       2985       3452
Klk6           186       1101        537        567        327        233
Fcrls           68        375        199        177         89         67
Slc2a4         528        249        266        357        654        693
        GSM2545348 GSM2545349 GSM2545350 GSM2545351 GSM2545352 GSM2545353
Asl            494        481        666        937        803        541
Apod         11258      11812      15816      29242      20415      13682
Cyp2d22       1883       2014       2417       3678       2920       2216
Klk6           742        881        828        250        798        710
Fcrls          300        233        231         81        303        285
Slc2a4         271        304        349        715        513        320
        GSM2545354 GSM2545362 GSM2545363 GSM2545380
Asl            473        748        576       1192
Apod         11088      15916      11166      38148
Cyp2d22       1821       2842       2011       4019
Klk6           894        501        598        259
Fcrls          248        179        184         68
Slc2a4         248        350        317        796
R
dim(assay(se))
SALIDA
[1] 1474 22Podemos acceder a los metadatos de la muestra utilizando la función
colData:
R
colData(se)
SALIDA
DataFrame with 22 rows and 9 columns
                sample     organism       age         sex   infection
           <character>  <character> <integer> <character> <character>
GSM2545336  GSM2545336 Mus musculus         8      Female  InfluenzaA
GSM2545337  GSM2545337 Mus musculus         8      Female NonInfected
GSM2545338  GSM2545338 Mus musculus         8      Female NonInfected
GSM2545339  GSM2545339 Mus musculus         8      Female  InfluenzaA
GSM2545340  GSM2545340 Mus musculus         8        Male  InfluenzaA
...                ...          ...       ...         ...         ...
GSM2545353  GSM2545353 Mus musculus         8      Female NonInfected
GSM2545354  GSM2545354 Mus musculus         8        Male NonInfected
GSM2545362  GSM2545362 Mus musculus         8      Female  InfluenzaA
GSM2545363  GSM2545363 Mus musculus         8        Male  InfluenzaA
GSM2545380  GSM2545380 Mus musculus         8      Female  InfluenzaA
                strain      time      tissue     mouse
           <character> <integer> <character> <integer>
GSM2545336     C57BL/6         8  Cerebellum        14
GSM2545337     C57BL/6         0  Cerebellum         9
GSM2545338     C57BL/6         0  Cerebellum        10
GSM2545339     C57BL/6         4  Cerebellum        15
GSM2545340     C57BL/6         4  Cerebellum        18
...                ...       ...         ...       ...
GSM2545353     C57BL/6         0  Cerebellum         4
GSM2545354     C57BL/6         0  Cerebellum         2
GSM2545362     C57BL/6         4  Cerebellum        20
GSM2545363     C57BL/6         4  Cerebellum        12
GSM2545380     C57BL/6         8  Cerebellum        19
R
dim(colData(se))
SALIDA
[1] 22 9También podemos acceder a los metadatos de las características
utilizando la función rowData:
R
head(rowData(se))
SALIDA
DataFrame with 6 rows and 9 columns
               gene  ENTREZID                product    ensembl_gene_id
        <character> <integer>            <character>        <character>
Asl             Asl    109900 argininosuccinate ly.. ENSMUSG00000025533
Apod           Apod     11815 apolipoprotein D, tr.. ENSMUSG00000022548
Cyp2d22     Cyp2d22     56448 cytochrome P450, fam.. ENSMUSG00000061740
Klk6           Klk6     19144 kallikrein related-p.. ENSMUSG00000050063
Fcrls         Fcrls     80891 Fc receptor-like S, .. ENSMUSG00000015852
Slc2a4       Slc2a4     20528 solute carrier famil.. ENSMUSG00000018566
        external_synonym chromosome_name   gene_biotype  phenotype_description
             <character>     <character>    <character>            <character>
Asl        2510006M18Rik               5 protein_coding abnormal circulating..
Apod                  NA              16 protein_coding abnormal lipid homeo..
Cyp2d22             2D22              15 protein_coding abnormal skin morpho..
Klk6                Bssp               7 protein_coding abnormal cytokine le..
Fcrls      2810439C17Rik               3 protein_coding decreased CD8-positi..
Slc2a4            Glut-4              11 protein_coding abnormal circulating..
        hsapiens_homolog_associated_gene_name
                                  <character>
Asl                                       ASL
Apod                                     APOD
Cyp2d22                                CYP2D6
Klk6                                     KLK6
Fcrls                                   FCRL2
Slc2a4                                 SLC2A4
R
dim(rowData(se))
SALIDA
[1] 1474 9Selección de subconjuntos de un SummarizedExperiment
SummarizedExperiment puede utilizarse para obtener subconjuntos al igual que con las tablas de datos, mediante valores numéricos, cadenas de caracteres o valores lógicos.
A continuación, creamos una nueva instancia de la clase SummarizedExperiment que contiene únicamente las 5 primeras características de las 3 primeras muestras.
R
se1 <- se[1:5, 1:3]
se1
SALIDA
class: SummarizedExperiment
dim: 5 3
metadata(0):
assays(1): counts
rownames(5): Asl Apod Cyp2d22 Klk6 Fcrls
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(3): GSM2545336 GSM2545337 GSM2545338
colData names(9): sample organism ... tissue mouse
R
colData(se1)
SALIDA
DataFrame with 3 rows and 9 columns
                sample     organism       age         sex   infection
           <character>  <character> <integer> <character> <character>
GSM2545336  GSM2545336 Mus musculus         8      Female  InfluenzaA
GSM2545337  GSM2545337 Mus musculus         8      Female NonInfected
GSM2545338  GSM2545338 Mus musculus         8      Female NonInfected
                strain      time      tissue     mouse
           <character> <integer> <character> <integer>
GSM2545336     C57BL/6         8  Cerebellum        14
GSM2545337     C57BL/6         0  Cerebellum         9
GSM2545338     C57BL/6         0  Cerebellum        10
R
rowData(se1)
SALIDA
DataFrame with 5 rows and 9 columns
               gene  ENTREZID                product    ensembl_gene_id
        <character> <integer>            <character>        <character>
Asl             Asl    109900 argininosuccinate ly.. ENSMUSG00000025533
Apod           Apod     11815 apolipoprotein D, tr.. ENSMUSG00000022548
Cyp2d22     Cyp2d22     56448 cytochrome P450, fam.. ENSMUSG00000061740
Klk6           Klk6     19144 kallikrein related-p.. ENSMUSG00000050063
Fcrls         Fcrls     80891 Fc receptor-like S, .. ENSMUSG00000015852
        external_synonym chromosome_name   gene_biotype  phenotype_description
             <character>     <character>    <character>            <character>
Asl        2510006M18Rik               5 protein_coding abnormal circulating..
Apod                  NA              16 protein_coding abnormal lipid homeo..
Cyp2d22             2D22              15 protein_coding abnormal skin morpho..
Klk6                Bssp               7 protein_coding abnormal cytokine le..
Fcrls      2810439C17Rik               3 protein_coding decreased CD8-positi..
        hsapiens_homolog_associated_gene_name
                                  <character>
Asl                                       ASL
Apod                                     APOD
Cyp2d22                                CYP2D6
Klk6                                     KLK6
Fcrls                                   FCRL2
También podemos utilizar la función colData() para
filtrar por algún elemento de los metadatos de las muestras o la
rowData() para filtrar por algún elemento de los metadatos
de las características. Por ejemplo, aquí solo conservamos los miRNAs y
las muestras no infectadas:
R
se1 <- se[rowData(se)$gene_biotype == "miRNA",
          colData(se)$infection == "NonInfected"]
se1
SALIDA
class: SummarizedExperiment
dim: 7 7
metadata(0):
assays(1): counts
rownames(7): Mir1901 Mir378a ... Mir128-1 Mir7682
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(7): GSM2545337 GSM2545338 ... GSM2545353 GSM2545354
colData names(9): sample organism ... tissue mouse
R
assay(se1)
SALIDA
         GSM2545337 GSM2545338 GSM2545343 GSM2545348 GSM2545349 GSM2545353
Mir1901          45         44         74         55         68         33
Mir378a          11          7          9          4         12          4
Mir133b           4          6          5          4          6          7
Mir30c-2         10          6         16         12          8         17
Mir149            1          2          0          0          0          0
Mir128-1          4          1          2          2          1          2
Mir7682           2          0          4          1          3          5
         GSM2545354
Mir1901          60
Mir378a           8
Mir133b           3
Mir30c-2         15
Mir149            2
Mir128-1          1
Mir7682           5
R
colData(se1)
SALIDA
DataFrame with 7 rows and 9 columns
                sample     organism       age         sex   infection
           <character>  <character> <integer> <character> <character>
GSM2545337  GSM2545337 Mus musculus         8      Female NonInfected
GSM2545338  GSM2545338 Mus musculus         8      Female NonInfected
GSM2545343  GSM2545343 Mus musculus         8        Male NonInfected
GSM2545348  GSM2545348 Mus musculus         8      Female NonInfected
GSM2545349  GSM2545349 Mus musculus         8        Male NonInfected
GSM2545353  GSM2545353 Mus musculus         8      Female NonInfected
GSM2545354  GSM2545354 Mus musculus         8        Male NonInfected
                strain      time      tissue     mouse
           <character> <integer> <character> <integer>
GSM2545337     C57BL/6         0  Cerebellum         9
GSM2545338     C57BL/6         0  Cerebellum        10
GSM2545343     C57BL/6         0  Cerebellum        11
GSM2545348     C57BL/6         0  Cerebellum         8
GSM2545349     C57BL/6         0  Cerebellum         7
GSM2545353     C57BL/6         0  Cerebellum         4
GSM2545354     C57BL/6         0  Cerebellum         2
R
rowData(se1)
SALIDA
DataFrame with 7 rows and 9 columns
                gene  ENTREZID        product    ensembl_gene_id
         <character> <integer>    <character>        <character>
Mir1901      Mir1901 100316686  microRNA 1901 ENSMUSG00000084565
Mir378a      Mir378a    723889  microRNA 378a ENSMUSG00000105200
Mir133b      Mir133b    723817  microRNA 133b ENSMUSG00000065480
Mir30c-2    Mir30c-2    723964 microRNA 30c-2 ENSMUSG00000065567
Mir149        Mir149    387167   microRNA 149 ENSMUSG00000065470
Mir128-1    Mir128-1    387147 microRNA 128-1 ENSMUSG00000065520
Mir7682      Mir7682 102466847  microRNA 7682 ENSMUSG00000106406
         external_synonym chromosome_name gene_biotype  phenotype_description
              <character>     <character>  <character>            <character>
Mir1901          Mirn1901              18        miRNA                     NA
Mir378a           Mirn378              18        miRNA abnormal mitochondri..
Mir133b          mir 133b               1        miRNA no abnormal phenotyp..
Mir30c-2        mir 30c-2               1        miRNA                     NA
Mir149            Mirn149               1        miRNA increased circulatin..
Mir128-1          Mirn128               1        miRNA no abnormal phenotyp..
Mir7682      mmu-mir-7682               1        miRNA                     NA
         hsapiens_homolog_associated_gene_name
                                   <character>
Mir1901                                     NA
Mir378a                                MIR378A
Mir133b                                MIR133B
Mir30c-2                               MIR30C2
Mir149                                      NA
Mir128-1                              MIR128-1
Mir7682                                     NA
Desafío
Extraiga los niveles de expresión génica de los tres primeros genes en las muestras al tiempo 0 y al tiempo 8.
R
assay(se)[1:3, colData(se)$time != 4]
SALIDA
        GSM2545336 GSM2545337 GSM2545338 GSM2545341 GSM2545342 GSM2545343
Asl           1170        361        400        988        836        535
Apod         36194      10347       9173      29594      24959      13668
Cyp2d22       4060       1616       1603       3349       3122       2008
        GSM2545346 GSM2545347 GSM2545348 GSM2545349 GSM2545351 GSM2545353
Asl            938       1035        494        481        937        541
Apod         27769      34301      11258      11812      29242      13682
Cyp2d22       2985       3452       1883       2014       3678       2216
        GSM2545354 GSM2545380
Asl            473       1192
Apod         11088      38148
Cyp2d22       1821       4019
R
# Equivalent to
assay(se)[1:3, colData(se)$time == 0 | colData(se)$time == 8]
SALIDA
        GSM2545336 GSM2545337 GSM2545338 GSM2545341 GSM2545342 GSM2545343
Asl           1170        361        400        988        836        535
Apod         36194      10347       9173      29594      24959      13668
Cyp2d22       4060       1616       1603       3349       3122       2008
        GSM2545346 GSM2545347 GSM2545348 GSM2545349 GSM2545351 GSM2545353
Asl            938       1035        494        481        937        541
Apod         27769      34301      11258      11812      29242      13682
Cyp2d22       2985       3452       1883       2014       3678       2216
        GSM2545354 GSM2545380
Asl            473       1192
Apod         11088      38148
Cyp2d22       1821       4019
Desafío
Verifique que obtenga los mismos valores utilizando la tabla
rna en formato largo.
R
rna |>
    filter(gene %in% c("Asl", "Apod", "Cyd2d22")) |>
    filter(time != 4) |>
    select(expression)
SALIDA
# A tibble: 28 × 1
   expression
        <dbl>
 1       1170
 2      36194
 3        361
 4      10347
 5        400
 6       9173
 7        988
 8      29594
 9        836
10      24959
# ℹ 18 more rows
La tabla en formato largo y el SummarizedExperiment
contienen la misma información, pero están simplemente estructurados de
manera diferente. Cada enfoque tiene sus propias ventajas: el primero es
adecuado para los paquetes tidyverse, mientras que el
segundo es la estructura preferida para muchos pasos de bioinformática y
procesamiento estadístico. Por ejemplo, un análisis típico de RNA-Seq
utilizando el paquete DESeq2.
Añadir variables a los metadatos
También podemos añadir información a los metadatos. Supongamos que quieres añadir el centro donde se recolectaron las muestras…
R
colData(se)$center <- rep("University of Illinois", nrow(colData(se)))
colData(se)
SALIDA
DataFrame with 22 rows and 10 columns
                sample     organism       age         sex   infection
           <character>  <character> <integer> <character> <character>
GSM2545336  GSM2545336 Mus musculus         8      Female  InfluenzaA
GSM2545337  GSM2545337 Mus musculus         8      Female NonInfected
GSM2545338  GSM2545338 Mus musculus         8      Female NonInfected
GSM2545339  GSM2545339 Mus musculus         8      Female  InfluenzaA
GSM2545340  GSM2545340 Mus musculus         8        Male  InfluenzaA
...                ...          ...       ...         ...         ...
GSM2545353  GSM2545353 Mus musculus         8      Female NonInfected
GSM2545354  GSM2545354 Mus musculus         8        Male NonInfected
GSM2545362  GSM2545362 Mus musculus         8      Female  InfluenzaA
GSM2545363  GSM2545363 Mus musculus         8        Male  InfluenzaA
GSM2545380  GSM2545380 Mus musculus         8      Female  InfluenzaA
                strain      time      tissue     mouse                 center
           <character> <integer> <character> <integer>            <character>
GSM2545336     C57BL/6         8  Cerebellum        14 University of Illinois
GSM2545337     C57BL/6         0  Cerebellum         9 University of Illinois
GSM2545338     C57BL/6         0  Cerebellum        10 University of Illinois
GSM2545339     C57BL/6         4  Cerebellum        15 University of Illinois
GSM2545340     C57BL/6         4  Cerebellum        18 University of Illinois
...                ...       ...         ...       ...                    ...
GSM2545353     C57BL/6         0  Cerebellum         4 University of Illinois
GSM2545354     C57BL/6         0  Cerebellum         2 University of Illinois
GSM2545362     C57BL/6         4  Cerebellum        20 University of Illinois
GSM2545363     C57BL/6         4  Cerebellum        12 University of Illinois
GSM2545380     C57BL/6         8  Cerebellum        19 University of Illinois
¡Esto ilustra que los slots de los metadatos pueden crecer indefinidamente sin afectar a las otras estructuras!
tidySummarizedExperiment
Quizás se pregunte si podemos usar comandos de tidyverse para
interactuar con los objetos SummarizedExperiment. La
respuesta es sí, podemos hacerlo con el paquete
tidySummarizedExperiment.
Recuerde cómo es nuestro objeto SummarizedExperiment:
R
se
SALIDA
class: SummarizedExperiment
dim: 1474 22
metadata(0):
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(10): sample organism ... mouse center
Carga tidySummarizedExperiment y luego mira de nuevo el
objeto se.
R
## BiocManager::install("tidySummarizedExperiment")
library("tidySummarizedExperiment")

se
SALIDA
class: SummarizedExperiment
dim: 1474 22
metadata(0):
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(10): sample organism ... mouse center
Sigue siendo un objeto SummarizedExperiment, por lo que
mantiene la estructura eficiente, pero ahora podemos verlo como un
tibble. Observa que la primera línea de la salida indica esto: es una
abstracción SummarizedExperiment-tibble.
También podemos ver en la segunda línea de la salida el número de
transcritos y muestras.
Ahora podemos utilizar comandos de tidyverse para interactuar con el
objeto SummarizedExperiment.
Podemos usar filter para filtrar filas según una
condición, por ejemplo, para ver todas las filas de una muestra.
R
se |> filter(sample == "GSM2545336")
SALIDA
class: SummarizedExperiment
dim: 1474 1
metadata(1): latest_filter_scope_report
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(1): GSM2545336
colData names(10): sample organism ... mouse center
R
se |> filter(sex == "Female")
SALIDA
class: SummarizedExperiment
dim: 1474 12
metadata(1): latest_filter_scope_report
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(12): GSM2545336 GSM2545337 ... GSM2545362 GSM2545380
colData names(10): sample organism ... mouse center
Podemos usar select para especificar las columnas que
queremos ver.
R
se |> select(sample, sex)
ADVERTENCIA
Warning: `when()` was deprecated in purrr 1.0.0.
ℹ Please use `if` instead.
ℹ The deprecated feature was likely used in the tidySummarizedExperiment
  package.
  Please report the issue at
  <https://github.com/stemangiola/tidySummarizedExperiment/issues>.
This warning is displayed once per session.
Call `lifecycle::last_lifecycle_warnings()` to see where this warning was
generated.
SALIDA
tidySummarizedExperiment says: Key columns are missing. A data frame is returned for independent data analysis.SALIDA
# A tibble: 32,428 × 2
   sample     sex
   <chr>      <chr>
 1 GSM2545336 Female
 2 GSM2545336 Female
 3 GSM2545336 Female
 4 GSM2545336 Female
 5 GSM2545336 Female
 6 GSM2545336 Female
 7 GSM2545336 Female
 8 GSM2545336 Female
 9 GSM2545336 Female
10 GSM2545336 Female
# ℹ 32,418 more rows
Podemos usar mutate para añadir información de
metadatos.
R
se |> mutate(center = "Heidelberg University")
SALIDA
class: SummarizedExperiment
dim: 1474 22
metadata(1): latest_mutate_scope_report
assays(1): counts
rownames(1474): Asl Apod ... Lmx1a Pbx1
rowData names(9): gene ENTREZID ... phenotype_description
  hsapiens_homolog_associated_gene_name
colnames(22): GSM2545336 GSM2545337 ... GSM2545363 GSM2545380
colData names(10): sample organism ... mouse center
También podemos combinar comandos con el pipe de tidyverse
|>. Por ejemplo, podríamos combinar
group_by y summarise para obtener los
recuentos totales de cada muestra.
R
se |>
    group_by(.sample) |>
    summarise(total_counts=sum(counts))
SALIDA
tidySummarizedExperiment says: A data frame is returned for independent data analysis.SALIDA
# A tibble: 22 × 2
   .sample    total_counts
   <chr>             <int>
 1 GSM2545336      3039671
 2 GSM2545337      2602360
 3 GSM2545338      2458618
 4 GSM2545339      2500082
 5 GSM2545340      2479024
 6 GSM2545341      2413723
 7 GSM2545342      2349728
 8 GSM2545343      3105652
 9 GSM2545344      2524137
10 GSM2545345      2506038
# ℹ 12 more rows
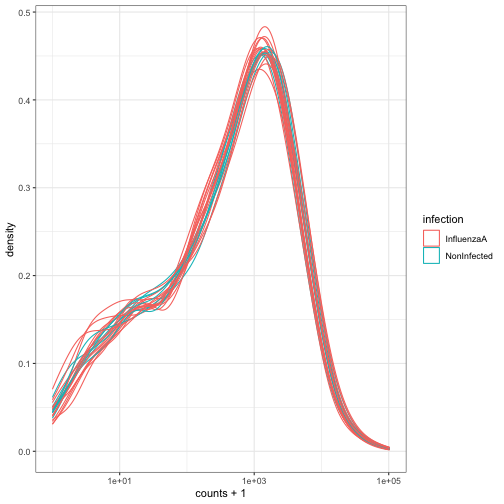
Podemos tratar el objeto tidy SummarizedExperiment como un tibble normal para realizar gráficos.
Aquí representamos la distribución de los recuentos por muestra.
R
se |>
    ggplot(aes(counts + 1, group=.sample, color=infection)) +
    geom_density() +
    scale_x_log10() +
    theme_bw()
Para obtener más información sobre
tidySummarizedExperiment, consulte el sitio web
del paquete.
Mensaje clave
SummarizedExperimentrepresenta una forma eficiente de almacenar y manejar datos ómicos.Se utilizan en muchos paquetes de Bioconductor.
Si sigue el siguiente entrenamiento centrado en el análisis de
secuenciación de ARN, aprenderá a utilizar el paquete
DESeq2 de Bioconductor para realizar algunos análisis de
expresión diferencial. Todo el análisis del paquete DESeq2
se gestiona en un SummarizedExperiment.
- Bioconductor es un proyecto que proporciona soporte y paquetes para la comprensión de datos biológicos de alto rendimiento.
- Un
SummarizedExperimentes un tipo de objeto útil para almacenar y gestionar datos ómicos de alto rendimiento.
Bioconductor fue iniciado por Robert Gentleman, uno de los dos creadores del lenguaje R. Bioconductor proporciona herramientas dedicadas al análisis de datos ómicos. Bioconductor utiliza el lenguaje de programación estadístico R y es de código abierto y desarrollo abierto.↩︎